AIXX Pedia › Fiche modèle › Superpuce GB200
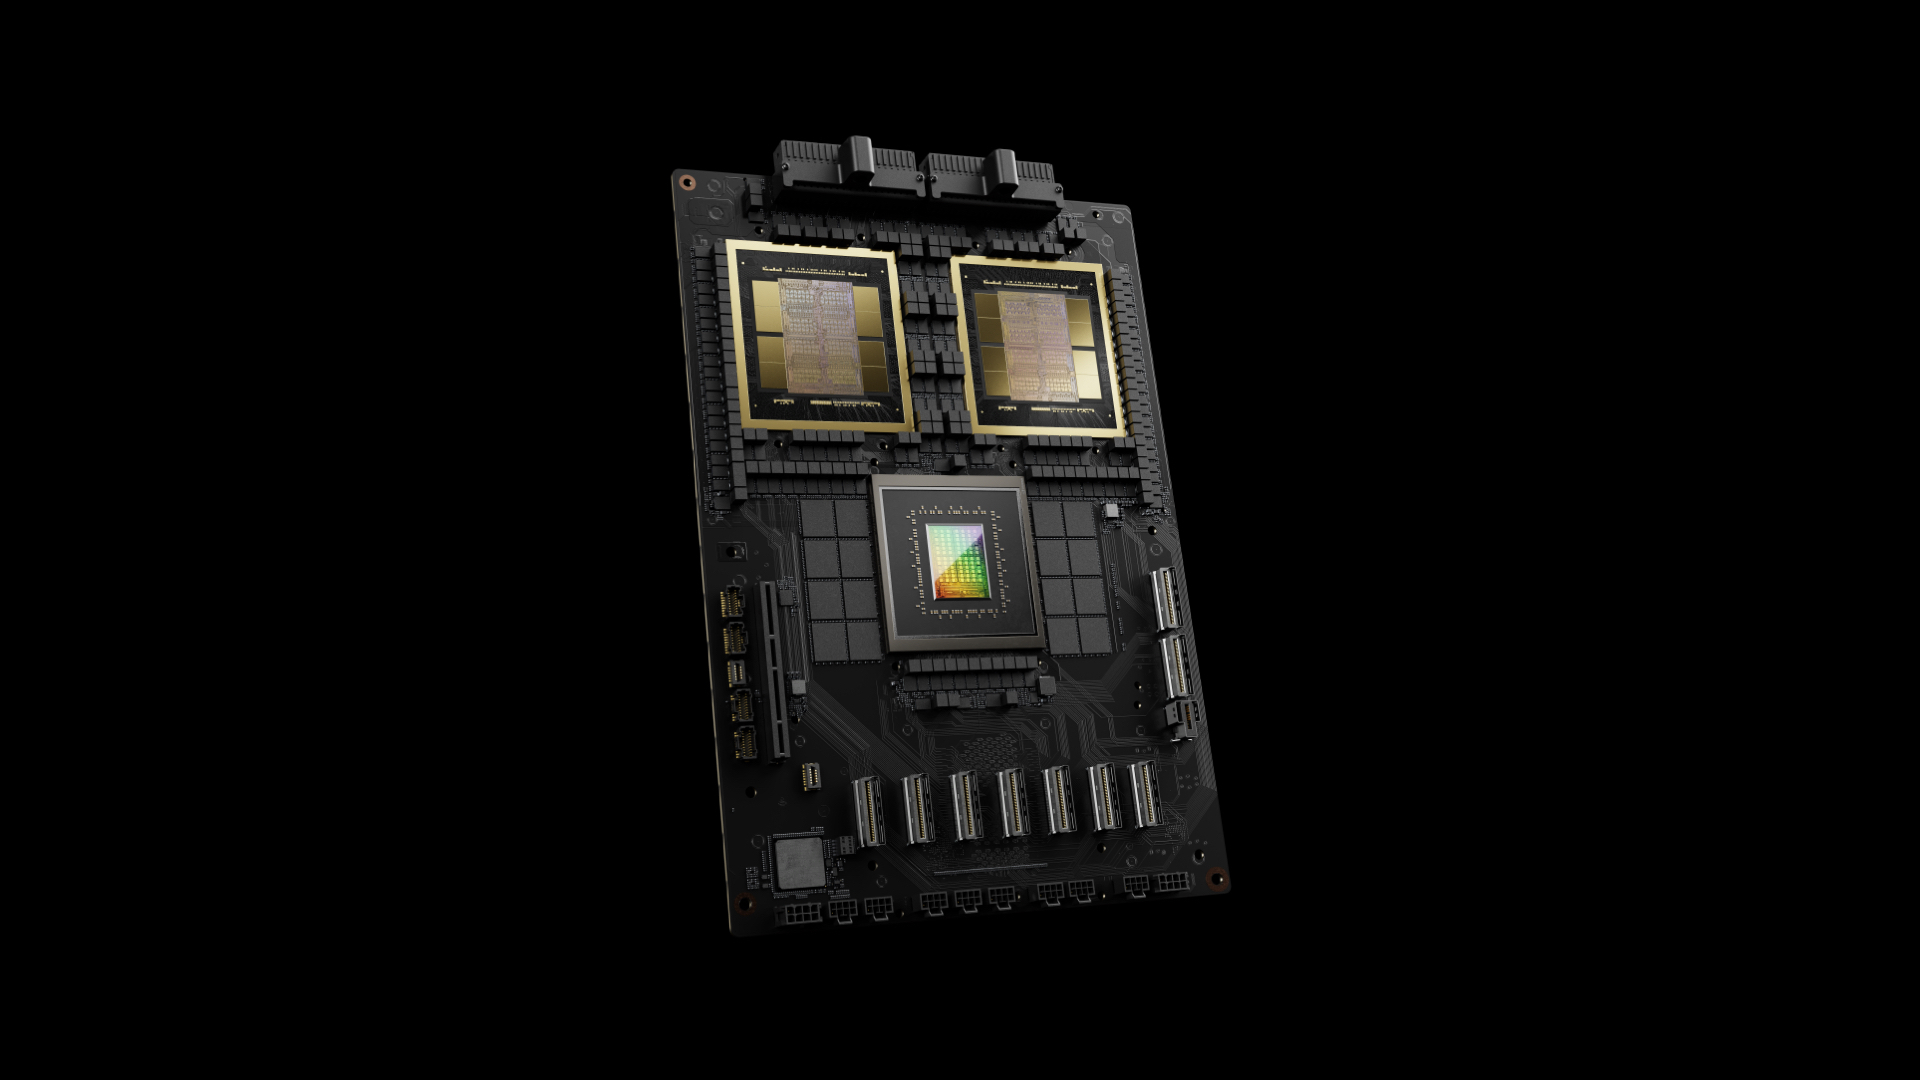
Superpuce GB200
Vue d'ensemble OVERVIEW
Superpuce GB200 (Grace Blackwell Superchip) est la combinaison CPU+GPU encapsulée de NVIDIA : 2 GPU Blackwell B200 et 1 CPU Grace (72 cœurs Armv9) forment au niveau carte mère l'unité de calcul minimale — selon le périmètre par puce Caractéristiques : NVFP4 40 PFLOPS (sparse) / 20 (dense), 372 Go de HBM3E (2×186 Go), bande passante mémoire de 16 To/s, 480 Go de LPDDR5X côté Grace, NVLink inter-chipset de 3,6 To/s (selon le tableau officiel à double colonne de NVIDIA et la datasheet Blackwell[1]).
Sa relation avec le rack GB200 NVL72 doit être clarifiée : le rack NVL72 se compose de 18 plateaux de calcul, chaque plateau contenant 2 superpuces GB200 (soit 4 B200+2 Grace) — la superpuce est la brique du rack . La circulation à l'unité ou au niveau plateau existe sur le marché secondaire ainsi qu'en forme intégrée MGX (NVL4), la livraison en rack complet restant le canal principal (voir la fiche GB200 NVL72).
Sur le marché du spot en 2026, la superpuce GB200 circule principalement en plateaux et systèmes MGX complets : recherche, projets cloud et pièces démontées coexistent. L'acceptation se concentre sur la liaison C2C et le périmètre mémoire (372/384 Go présentés honnêtement côte à côte). Cette fiche ne comporte pas de bande de prix — le prix réel est soumis au devis du vendeur.
Cas d'usage FIT
AIXX Index (0–100) : pondéré selon les scénarios de coopération CPU-GPU (périmètre spécifique aux superpuces).
Historique HISTORY
Le 18 mars 2024 , la plateforme Blackwell est dévoilée au GTC : le superchip GB200 fait son apparition comme unité d'encapsulation de la génération Grace Blackwell, aux côtés du rack GB200 NVL72 — la combinaison 2×B200 + 1×Grace définit la « brique élémentaire du superchip » (présentation GTC et tableau officiel à double colonne[1]).
2024–2025 , montée en volume au niveau rack : déploiements mondiaux du GB200 NVL72, la superpuce étant livrée en granularité plateau de calcul avec le rack — dans l'architecture 18 plateaux de calcul × 9 plateaux NVSwitch, chaque plateau embarque 2 superpuces.
2025-2026 , diversification multi-formes : les systèmes intégrés MGX (NVL4) coexistent avec les livraisons DGX — après la relève par la génération GB300 (superpuce Blackwell Ultra), la superpuce GB200 passe en circulation de stock et d'accompagnement rack (voir la fiche GB300 pour le périmètre générationnel). La réglementation sur les flux transfrontaliers évolue encore ; cette base restitue les informations publiques et ne constitue pas un avis juridique.
Spécifications techniques SPECIFICATIONS
| Élément | Spécifications (superpuce GB200 · tableau de spécifications officiel à deux colonnes) |
|---|---|
| Composition | 2× GPU Blackwell B200 + 1× CPU Grace (72 cœurs Armv9) |
| Puissance GPU | NVFP4 40 PFLOPS (sparse) / 20 PFLOPS (dense) |
| Mémoire vidéo (double périmètre honnête) | 372 Go HBM3E / 16 To/s (périmètre actuel) · périmètre au lancement 384 Go / 2×192 Go[1] |
| Mémoire CPU | 480 Go LPDDR5X ECC (côté Grace) |
| Interconnexion inter-chip | NVLink-C2C 3,6 To/s (bande passante de cohérence intra-chip) |
| PCIe | Jusqu'à 4× PCIe Gen5 x16 (granularité superpuce) |
| Rôle dans le rack | GB200 NVL72 : 18 plateaux de calcul × (2 Grace + 4 B200 = 2 superpuces) |
| Note sur le double périmètre mémoire | 372 Go actuels (2×186 Go) vs 384 Go au lancement (2×192 Go) — deux documents officiels présentés côte à côte, le contrat précise la ligne de produit |
Les spécifications font foi selon le tableau officiel à double colonne de NVIDIA et la datasheet Blackwell (instantané officiel d'octobre 2026[1]) ; les légères divergences entre documents officiels, 30,5/30,2 To pour la mémoire rapide, sont toutes deux mentionnées telles quelles.
Spectre de granularité SCALE LADDER
| Granularité | Format | Détails |
|---|---|---|
| Superpuce à l'unité | Encapsulation 2×B200 + 1×Grace | Cette fiche |
| Plateau de calcul | 2 superpuces par plateau (4 B200 + 2 Grace) | Fiche GB200 NVL72 |
| NVL4 MGX | Format serveur MGX 4 GPU | Section « Formes de livraison » de cette fiche |
| Rack NVL72 | 18 plateaux + 9 NVSwitch en rack complet | Fiche GB200 NVL72 |
Membres de la famille FAMILY
La famille des superpuces se décline par génération ; la GB200 est l'unité encapsulée de la génération Blackwell :
Refroidissement et déploiement COOLING
Le refroidissement de la superpuce GB200 dépend de la forme : Plateau de calcul (dans le rack NVL72) par cold plates refroidi par liquide en contact direct (boucle CDU du rack, comme la fiche GB200) ; Serveur intégré MGX NVL4 en compatibilité double refroidi par air / refroidi par liquide au niveau baie. Trois vérifications avant déploiement : santé de la liaison C2C (l'élément vital de la superpuce), inventaire de la pile logicielle Arm côté Grace (comme la fiche Grace), calcul des profils de consommation (même périmètre que la fiche GB200).
Circulation au niveau plateau sur le marché secondaire : un plateau isolé (2 superpuces) peut servir de source de calcul en forme NVL4/MGX — mais l'intégrité de l'accompagnement C2C et NVSwitch détermine s'il peut atteindre les performances nominales (périmètre compilé par cette base).
Adéquation aux cas d'usage WORKLOAD FIT
| Charge de travail | Périmètres de la superpuce GB200 | AIXX Index |
|---|---|---|
| Pipeline de données d'entraînement | Prétraitement côté Grace + alimentation directe du GPU via C2C — le pipeline de données n'est plus le goulot | 85 |
| Recherche vectorielle / RAG | Pool cohérent de 480 Go LPDDR5X — couche de données chaudes vectorielles | 85 |
| Nœud d'inférence FP4 | NVFP4 40 PFLOPS (sparse) — débit d'inférence sur la précision phare de Blackwell | 86 |
| Migration x86 généraliste | Inventaire de l'écosystème Arm au préalable (même périmètre que la fiche Grace) | 40 |
Galerie GALLERY
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| CUDA | Génération Blackwell (architecture de calcul 10.x) — supporté par CUDA 12.8+ (informations publiques) |
| Mémoire cohérente | Modèle de programmation mémoire unifiée NVLink-C2C — même périmètre que la fiche Grace |
| Pile Arm | Distributions Linux Arm grand public + support natif de la pile complète NVIDIA |
| Rappel d'inventaire | Vérification un à un des versions Arm des outils internes d'entreprise (même périmètre que la fiche Grace) |
Achat et réception PROCUREMENT
Points de contrôle à l'achat d'une superpuce GB200 (plateau/unité) (trois points) :
Aide-mémoire de réception QUICK CHECK
Vérification rapide de la superpuce GB200 en quatre étapes :
Transport et livraison LOGISTICS
Fiches terminologie GLOSSARY
Superchip
Format produit à encapsulation CPU+GPU : GB200 = 2×B200+1×Grace — l'interconnexion C2C intra-encapsulation transforme la « copie entre périphériques » en « accès mémoire cohérent » (même périmètre que la fiche Grace).
Plateau de calcul
La brique du rack NVL72 : chaque plateau embarque 2 superpuces GB200 (4 B200 + 2 Grace) — 18 plateaux forment le domaine 72 GPU du rack ; la circulation au niveau plateau est la granularité dominante du marché secondaire.
NVL4 MGX
Format serveur MGX 4 GPU : l'implémentation intégrée à petite granularité de la superpuce GB200 — une option de déploiement Blackwell d'un cran en dessous du rack NVL72.
Double périmètre mémoire
Les deux périmètres officiels de la mémoire GB200 : 372 Go actuels (2×186 Go) et 384 Go au lancement (2×192 Go) — deux documents officiels coexistent ; le contrat d'achat précise le périmètre et la ligne de produit.
Limites et controverses LIMITS
- Positionnement de la forme à l'unité : l'unité de calcul minimale de la superpuce est la « brique de rack » — le positionnement des performances change hors de l'accompagnement NVSwitch (même périmètre que la fiche GB200 au niveau plateau) ; l'achat à l'unité exige la confirmation de la forme d'accompagnement.
- Risque contractuel du double périmètre mémoire : coexistence 372/384 Go — le contrat précise le périmètre (discipline de cette base, comme la fiche GB200).
- Inventaire de la pile logicielle Arm : même périmètre que la fiche Grace — vérification un à un des versions Arm des outils internes d'entreprise.
- Conformité de la circulation transfrontalière : modèle sensible aux contrôles à l'export (même périmètre que la fiche GB200) — évaluation préalable du risque de conformité ; cette base ne constitue pas un avis juridique.
Notes de marché MARKET NOTE
La superpuce GB200 circule en plateaux et systèmes MGX complets ; le périmètre mémoire et l'intégrité de l'accompagnement créent de forts écarts de prix — Principe d'honnêteté de cette fiche : pas de bande de marché, le prix est soumis au devis réel du vendeur (au niveau rack, voir la fiche GB200 NVL72).
Recherche des offres : AIXX Exchange Hall › (mise en relation sans commission, d'où la neutralité des données).
Chronologie des jalons de prix MILESTONES
FAQ FAQ
La relation brique/produit fini : la superpuce (2 B200+1 Grace) est l'unité encapsulée du rack NVL72 — 18 superpuces + 9 plateaux NVSwitch composent un NVL72. Circulant à l'unité ou au plateau, hors de l'accompagnement du rack, la valeur du domaine NVLink doit être réévaluée.
Une frontière d'échelle et d'ingénierie : le niveau plateau/unité convient aux équipes disposant de capacités d'intégration propres et à la forme MGX ; le rack complet convient pour un passage direct à l'échelle « AI factory ». Le niveau intermédiaire : le système intégré MGX NVL4.
Deux périmètres officiels coexistent : 372 Go actuels (2×186 Go) et 384 Go au lancement (2×192 Go) — le contrat précise le périmètre et la ligne de produit, vérification par test à la réception.
Quatre étapes : double identification (Grace 72 cœurs + 2×B200) → contrôle ponctuel de la bande passante C2C → benchmark NVFP4 (≥80 % Conforme, selon notre méthodologie de calcul) → Test de burn-in par palier de consommation. Inventaire de la pile logicielle Arm en préalable.
Fiches liées SEE ALSO
Comparaison et choix de machines COMPARE
Références REFERENCES
- Site officiel NVIDIA — page produit GB200 NVL72, tableau de spécifications en deux colonnes (GB200 Superchip comme granularité principale, vérifié C6 en 2026-10) https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- NVIDIA officiel — Blackwell Datasheet (version 4204213.Oct25, double vérification C5/C6) https://www.nvidia.com/en-us/data-center/hgx/
- Reportage de tests à l'échelle du tray de calcul GB200 NVL72 (18 trays × 2 super-puces) https://www.servethehome.com/
- Recherche des offres en vente — AIXX Exchange (Mise en relation sans commission ; aucun instantané de marché pour le GB200 Superchip pour le moment, Le prix réel est soumis au devis du vendeur) https://www.aixx.vip/hall.html?model=GB200