AIXX Pedia › Verbete de infraestrutura › Storage NVMe all-flash
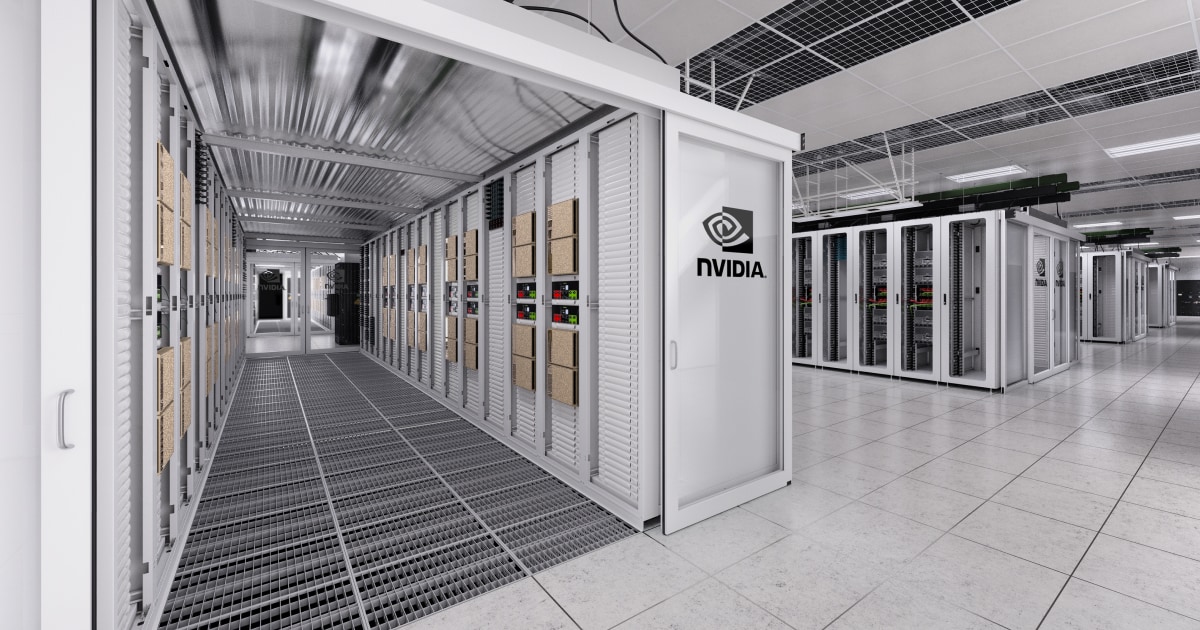
Storage NVMe all-flash
Visão geral OVERVIEW
Storage NVMe all-flash É a "terceira perna" dos clusters de IA: além da computação (GPUs) e da rede (NVLink/fabric), todo o pipeline de dados de treinamento e inferência — escrita e leitura de checkpoints, throughput de datasets de treinamento, hierarquização do KV cache — repousa sobre a camada de armazenamento. O protocolo NVMe (SSDs ligados diretamente ao PCIe, contornando os controladores tradicionais SAS/SATA) + arrays all-flash + rede NVMe-oF + GPUDirect Storage (Os dados vão do armazenamento direto à memória da GPU, contornando a cópia pela CPU, segundo a documentação oficial da NVIDIA[3]) — peça fundamental da stack moderna de armazenamento para IA.
Por que se tornou indispensável nos clusters de IA: checkpoints de clusters com milhares de GPUs chegam facilmente a dezenas de TB, e os datasets de treinamento contam-se em centenas de TB — a vazão de discos mecânicos ou arrays híbridos não alimenta as GPUs, e cada segundo em que a GPU espera por dados é dinheiro de placa queimado. NVMe-oF estende o desempenho all-flash à rede (acesso direto via RDMA[1]), e o GPUDirect Storage remove a CPU do caminho dos dados — essas duas coisas determinam se a camada de armazenamento é aceleradora ou gargalo.
Este verbete é um verbete de seleção de categoria : aborda a arquitetura de armazenamento sob a ótica de clusters de IA, parâmetros de seleção e aceitação de compra; não trata de um produto específico. Armazenamento não tem preço de mercado unificado; o preço real está sujeito à cotação do vendedor.
Cenários de uso FIT
AIXX Index (0–100): estimativa ponderada pela adequação ao cenário. 90+ nível flagship · 75+ Excelente · 60+ utilizável · abaixo de 60, não recomendado.
Histórico HISTORY
2011 , lançamento da especificação NVMe 1.0: o protocolo feito para SSDs ligados diretamente ao PCIe e nativo de flash substitui o caminho SAS/SATA — a base de protocolo dos arrays all-flash (fonte pública do setor).
2016-2020 , mainstreamização dos arrays all-flash: a especificação NVMe-oF estende o NVMe à rede (acesso direto via RDMA), e arrays all-flash de Dell/NetApp/Pure tornaram-se o novo padrão de armazenamento corporativo; clusters de GPU passaram a adotar all-flash como base de armazenamento (segundo o setor[1]).
2020 , a NVIDIA lança o GPUDirect Storage : os dados de armazenamento chegam via RDMA direto à memória da GPU, contornando a CPU (segundo o blog de desenvolvedores e a documentação oficial da NVIDIA[2][3]) — o último quilômetro do armazenamento para IA está aberto, e o ecossistema CUDA avança mais um passo.
2023-2026 , padronização nos clusters de IA: as demandas de checkpoint e vazão de dados do treinamento de grandes modelos empurraram o armazenamento para o centro da infraestrutura — a arquitetura em três camadas «object lake (frio) + cache all-flash (quente) + passagem direta GPUDirect» tornou-se a arquitetura de referência para armazenamento de IA (segundo arquiteturas de referência do setor[4]).
Parâmetros de seleção SELECTION GUIDE
| Parâmetro | O que observar | Notas de escopo |
|---|---|---|
| Throughput (GB/s) | Correspondência entre a largura de banda agregada de leitura/escrita e a velocidade de consumo das GPUs | Deduzir o throughput a partir do "volume de dados consumido pelo cluster por hora", com 30% de folga (estimativa) |
| IOPS e latência | Cenários de IO pequeno (metadados de checkpoints, hierarquização do KV cache) olham IOPS e latência P99 | Alto throughput ≠ baixa latência; avalie as duas classes de carga separadamente |
| Suporte a NVMe-oF | Extensão via rede com transporte RDMA (RoCE/IB) | Alinhe com a rota do fabric do cluster: rede IB com IB-RDMA, Ethernet com RoCE |
| GPUDirect Storage | Array/sistema de arquivos presente na lista de compatibilidade do GDS da NVIDIA | conforme a lista oficial de compatibilidade (segundo a documentação da NVIDIA[3]) — soluções fora da lista exigem desenvolvimento adicional para a passagem direta |
| Sistema de arquivos paralelo | Lustre/família GPFS/FS paralelos proprietários | Múltiplos nós de GPU lendo o mesmo dataset concorrentemente: o throughput paralelo é decisivo |
| Hierarquização de capacidade | Três camadas: quente (NVMe) / morna (híbrido) / fria (objeto/fita) | All-flash só para dados quentes — o custo de capacidade é contido pela hierarquização |
| Proteção de dados | Erasure coding/replicação, snapshots, recuperação de desastre remota | O seguro dos datasets de treinamento e checkpoints; dimensione conforme o valor dos dados |
Os critérios de seleção são uma compilação desta biblioteca com base em documentos públicos de arquitetura (dados de out/2026)[1][3][4]; para detalhes, prevalecem a documentação do fabricante e testes de estresse reais.
Arquitetura de armazenamento de IA em três camadas TIERING
| Camada | Mídia/forma | O que abriga | Métricas-chave |
|---|---|---|---|
| Camada quente | Array all-flash NVMe / NVMe distribuído | Dataset de treinamento ativo, checkpoints, hierarquização do KV cache | Throughput + passagem direta GPUDirect |
| Camada morna | Híbrido / NVMe de alta capacidade | Versões recentes de datasets, produtos intermediários de pré-processamento | Custo-benefício de capacidade |
| Camada fria | Armazenamento de objetos / fita | Lago de dados bruto, arquivamento histórico | Custo por unidade de capacidade |
A arquitetura de três camadas é uma compilação desta biblioteca com base em arquiteturas de referência públicas[4]; a estratégia de camadas deve ser personalizada conforme o ciclo de vida dos dados de cada negócio.
Ecossistema e panorama de fornecedores VENDORS
Os três tipos de player do armazenamento de IA (compilação desta biblioteca; não constitui recomendação de compra):
| Campo | Representantes | Posicionamento e características |
|---|---|---|
| Arrays all-flash corporativos | Dell PowerStore/PowerScale, NetApp AFF, Pure FlashArray//FlashBlade, Huawei OceanStor, série AS da Inspur | Proteção de dados corporativa e stack operacional completos; a adequação à IA depende da compatibilidade com GPUDirect e do throughput paralelo (fonte pública de linhas de produto) |
| Armazenamento nativo de IA | VAST Data, WEKA, VDURA e outros fabricantes de nova geração de FS paralelos | Feito para clusters de GPU: FS paralelo + camadas NVMe + adaptação profunda ao GDS (segundo arquitetura de referência[4]) |
| Autogerenciado/código aberto | Lustre, Ceph, JuiceFS e outras soluções próprias | Para clusters muito grandes, o autogerenciado dá mais controle; o custo é a equipe de operações (fonte pública do ecossistema) |
As informações de fornecedores são uma compilação de linhas de produto públicas; o definitivo são os materiais oficiais de cada fabricante; o lado dos SSDs (unidades NVMe corporativas de Samsung/Solidigm/Western Digital) é outra camada da cadeia de suprimentos, já incluída na compra do array.
Galeria GALLERY
Fotos reais dos equipamentos serão publicadas conforme os lotes de inspeção; imagens geradas por IA não são apresentadas como fotos reais.
Implantação e integração DEPLOYMENT
Os três passos para colocar o armazenamento em produção: Alinhar o fabric (rede de armazenamento na mesma rota do fabric de computação: cluster IB com rede de armazenamento IB-RDMA, Ethernet com RoCE — rotas mistas exigem gateway, e latência e throughput degradam); Habilitar o GDS (com componentes implantados conforme a documentação oficial do GDS da NVIDIA[3], presumindo que o array esteja na lista de compatibilidade); Testar e classificar (teste de estresse de throughput de dados com tarefas reais de treinamento — specs de papel não valem; só o teste revela se a GPU espera ou não).
Dica de operação: monitore as métricas da camada de armazenamento (throughput/IOPS/latência P99/nível de capacidade) na mesma tela do monitoramento do cluster de GPUs — "utilização da GPU anormalmente baixa" tem como primeiro ponto de investigação a velocidade de alimentação do armazenamento (experiência operacional desta biblioteca).
Aquisição e aceitação PROCUREMENT
Pontos de aceitação na compra de armazenamento de IA (três itens):
Os seis critérios completos de aceitação estão neste verbete. «Como aceitar» desta ficha.
Como fazer a aceitação ACCEPTANCE TEST
Seis critérios de aceitação (framework de aceitação de armazenamento de IA): conferência de recebimento → throughput básico → passagem direta GPUDirect → leitura concorrente → exercícios de falha → ajuste conjunto de longa duração.
Transporte e entrega LOGISTICS
Cartões de terminologia GLOSSARY
NVMe
Protocolo de storage criado para a memória flash: SSD conectado diretamente ao barramento PCIe, alta profundidade de filas e baixa latência — em comparação, os protocolos SAS/SATA limitam a velocidade da flash. O SSD NVMe é o bloco básico dos arrays all-flash.
NVMe-oF
NVMe over Fabrics: estende o protocolo NVMe à rede (transporte RDMA, sobre IB ou RoCE) — o servidor acessa o array all-flash remoto como se fosse um disco local, com perda mínima de desempenho (segundo o setor[1]).
GPUDirect Storage(GDS)
Tecnologia de passagem direta de armazenamento da NVIDIA: os dados do NVMe/array chegam via RDMA direto à memória da GPU, contornando a cópia pela CPU — tecnologia-chave para acelerar o carregamento de dados de treinamento e a leitura/escrita de checkpoints (segundo a documentação oficial[3]).
Sistema de arquivos paralelo
Arquitetura de storage em que múltiplos nós acessam concorrentemente o mesmo sistema de arquivos (sistemas da família Lustre/GPFS etc.): distribui os dados em striping por vários nós de storage agregando throughput — só um file system paralelo aguenta mil GPUs lendo o dataset de treino simultaneamente.
Checkpoint
Pontos de salvamento do processo de treino: gravação periódica dos pesos do modelo + estado do otimizador — checkpoints de grandes modelos giram na casa das dezenas de TB; escrita lenta atrasa o treino e perdas comprometem todo o progresso. O throughput de checkpoint é a primeira prova do storage para IA.
Tercelização do KV cache
Solução para o estouro de memória nos serviços de inferência: o KV cache que não cabe na HBM da GPU vai para a camada NVMe — troca capacidade de memória por banda NVMe, componente das arquiteturas de inferência com contextos longos e alta concorrência em lote.
Limitações e controvérsias LIMITS
- Ilusão de throughput O throughput anunciado pelo fabricante é um valor de laboratório em condições ideais — sob cargas reais de treino (mistura de IOs pequenos, concorrência multinó), a taxa de cumprimento costuma cair à metade; o teste de carga com tarefa real é o único espelho verdadeiro (critério de inspeção desta base).
- Fragmentação de compatibilidade com GDS : «suportar NVMe-oF» não significa «estar na lista de compatibilidade do NVIDIA GDS» — soluções fora da lista exigem desenvolvimento próprio para a passagem direta, e esse custo oculto precisa ser contabilizado (segundo a documentação oficial[3]).
- Armadilha de custo do all-flash Colocar também dados frios em all-flash é um buraco negro de orçamento — a arquitetura de três camadas (quente/morno/frio) é a disciplina de custos; o all-flash deve servir apenas os dados quentes (critério de organização desta base).
- Resíduos de dados em arrays de storage usados A segurança dos dados anteriores de um array usado é um risco de nível jurídico — o registro de apagamento seguro deve ser condição prévia da transação (critério de inspeção desta base).
- Vendor lock-in Os file systems paralelos estão profundamente atrelados à stack de gerenciamento do array, e migrar de marca no meio do caminho é caro — na escolha, trate 'a dificuldade de tirar os dados de lá' como um parâmetro (critério de organização desta base).
Notas de mercado MARKET NOTE
O storage para IA é adquirido predominantemente por projeto (grandes variações de configuração/capacidade/stack de software) e arrays usados ainda precisam passar pelo crivo de segurança de dados — não há snapshot de mercado uniforme verificável por enquanto. Princípio de honestidade da AIXX Pedia: sem faixa de mercado; o preço está sujeito à cotação do vendedor 。
Busca de ofertas: Salão da AIXX Exchange › (intermediação sem comissão, sem participação nas transações; sem acesso nem especulação sobre preços fechados, o que mantém os dados neutros). Assim que o acúmulo de snapshots for suficiente, esta seção migrará para a faixa de cotações padrão.
Marcos históricos de preço MILESTONES
Perguntas frequentes FAQ
Três pontos de diferença: escala de throughput (alimentar um cluster de mil GPUs dezenas de vezes uma carga corporativa comum), arquitetura de acesso direto (GPUDirect Storage contorna a CPU) e padrão de concorrência (múltiplos nós de GPU lendo o mesmo dataset em paralelo) — NAS comum e arrays híbridos não conseguem acompanhar nesses três pontos.
Fortemente recomendado: os dados chegam direto à memória da GPU sem passar pela CPU, reduzindo simultaneamente latência e uso de CPU no carregamento de dados de treino e na leitura/escrita de checkpoints (conforme documentação oficial); soluções sem GDS funcionam, mas o teto de throughput com intermediação da CPU é baixo e a movimentação de dados consome os recursos do host.
Checkpoints de grandes modelos giram na casa das dezenas de TB e a escrita é frequente: escrita lenta atrasa o treino (a GPU espera o disco), e a interrupção da escrita compromete todo o progresso — throughput e confiabilidade do checkpoint são a linha divisória entre storage para IA e storage comum.
Sim, mas é preciso passar por três crivos: segurança de dados (o registro de apagamento seguro dos dados anteriores é condição da transação), saúde (exportação completa de vida útil de escrita/SMART dos SSDs NVMe) e licenciamento (as licenças de capacidade e recursos são transferidas junto com o hardware). Storage é a casa dos dados, e o padrão de aceitação deve ser alto, nunca baixo.
Recomenda-se a mesma tecnologia com camadas distintas: cluster IB com rede de storage IB-RDMA, cluster Ethernet com RoCE — misturar tecnologias exige conversão por gateway, com queda simultânea de latência e throughput. No plano de tráfego, a rede de storage e a de computação podem ser isoladas física ou logicamente, evitando que a escrita de checkpoints impacte a comunicação do treino.
Entradas relacionadas SEE ALSO
Guia comparativo e extensões COMPARE
Referências REFERENCES
- Introl — AI-Optimized Storage: NVMe-oF, GPUDirect & Parallel File Systems (revisão de arquitetura, 2025) https://introl.com/blog/ai-optimized-storage-nvme-gpudirect-…
- NVIDIA Developer Blog — NVIDIA GPUDirect Storage (comunicado de lançamento, 2020) https://developer.nvidia.com/blog/gpudirect-storage/
- Documentação oficial NVIDIA — GPUDirect Storage Overview Guide (critérios de implantação e compatibilidade) https://docs.nvidia.com/gpudirect-storage/overview-guide/ind…
- VDURA — AI Storage Reference Design (critério de arquitetura de referência all-flash) https://www.vdura.com/resources/reference-architecture/ai-st…
- Busca de ofertas — AIXX Exchange (intermediação sem comissão; storage para IA sem snapshot de mercado por enquanto, o preço real está sujeito à cotação do vendedor) https://www.aixx.vip/hall.html