AIXX 백과사전 › 인프라 항목 › NVMe 올플래시 스토리지
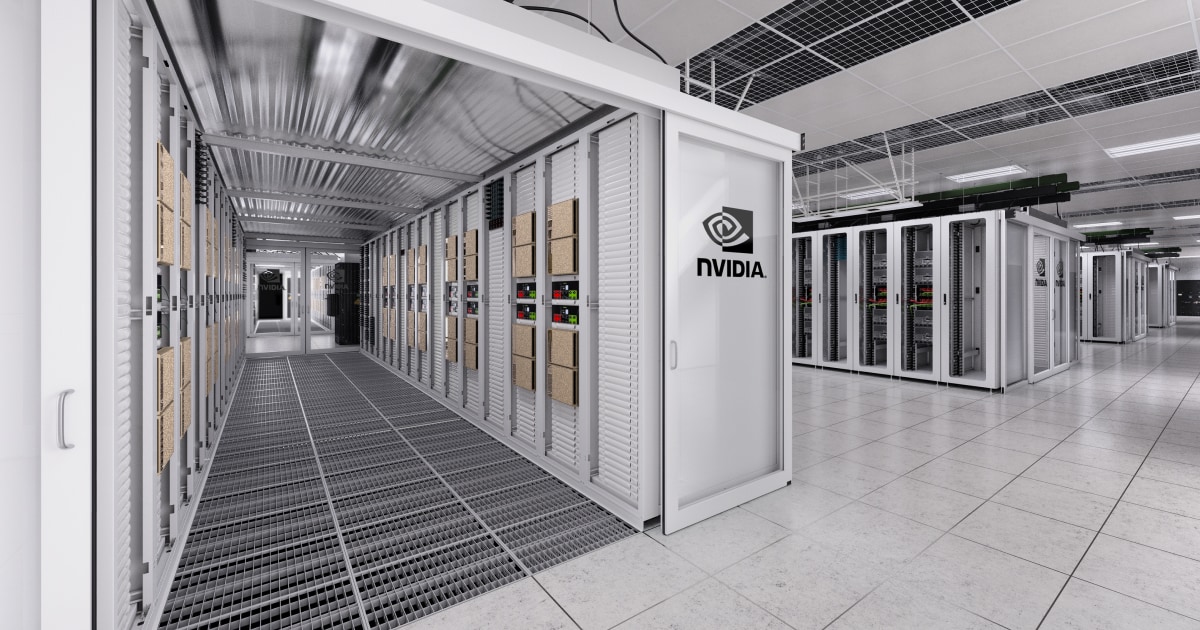
NVMe 올플래시 스토리지
개요OVERVIEW
NVMe 올플래시 스토리지AI 클러스터의 '세 번째 축'입니다: 연산(GPU), 네트워크(NVLink/fabric) 외에, 학습과 추론의 데이터 파이프라인—checkpoint 쓰기·읽기, 학습 데이터셋 처리량, KV cache 계층화—모두 스토리지 계층에 집중됩니다. NVMe 프로토콜(SSD의 PCIe 직접 연결, 기존 SAS/SATA 컨트롤러 우회) + 올플래시 어레이 + NVMe-oF 네트워크 + GPUDirect Storage(스토리지에서 GPU 메모리로 데이터가 직접 전송되어 CPU 복사를 우회, NVIDIA 공식 문서 기준[3]) 현대 AI 스토리지의 표준 조각으로 자리 잡았다.
AI 클러스터에서 필수 요건이 된 이유: 천 단위 GPU 클러스터의 체크포인트는 수십 TB에 달하고 학습 데이터셋은 수백 TB 단위다. HDD나 하이브리드 플래시 어레이의 처리량으로는 GPU를 충분히 못 먹이고, GPU가 데이터를 기다리는 매 초는 카드 비용이 그대로 낭비된다. NVMe-oF가 올플래시 성능을 네트워크로 확장(RDMA 직접 전송[1])하고, GPUDirect Storage가 데이터 경로에서 CPU를 제거한다. 이 두 가지가 스토리지 계층이 가속기가 될지 병목이 될지를 결정한다.
본 항목은품류 선정 항목: AI 클러스터 관점의 스토리지 아키텍처, 선택 기준 파라미터와 구매 검수를 다루며, 특정 제품을 대상으로 하지 않습니다. 스토리지는 통일된 시세가 없으며, 실제 가격은 판매자 제시가 기준입니다.
적용 시나리오FIT
AIXX Index(0–100): 시나리오 적합도 가중치 기반 추정치. 90+ 플래그십급 · 75+ 우수 · 60+ 사용 가능 · 60 미만 부적합.
연혁HISTORY
2011년, NVMe 1.0 규격 발표: SSD의 PCIe 직접 연결, 플래시를 위해 설계된 프로토콜이 SAS/SATA 채널을 대체—올플래시 어레이의 프로토콜 토대(업계 공개 기준).
2016–2020년, 올플래시 어레이 주류화: NVMe-oF 규격이 NVMe를 네트워크로 확장(RDMA 직접 전송)하면서 Dell/NetApp/Pure 등 벤더의 올플래시 어레이가 엔터프라이즈 스토리지의 새 표준으로 부상했고, GPU 클러스터가 올플래시를 스토리지 기반으로 채택하기 시작했다(업계 기준[1]).
2020년, NVIDIA 발표 GPUDirect Storage: 스토리지 데이터가 RDMA로 GPU 메모리에 직접 전송되어 CPU 중계를 우회(NVIDIA 개발자 블로그 및 공식 문서 기준[2][3]) — AI 스토리지의 퍼스트 마일이 개통되며 CUDA 생태계가 한 수 더 앞서나갔다.
2023-2026년, AI 클러스터 표준화: 대규모 모델 학습의 체크포인트와 데이터 처리량 수요가 스토리지를 인프라의 중심으로 밀어 올렸다 — '오브젝트 레이크(콜드) + 올플래시 캐시(핫) + GPUDirect 직통' 3단 구성이 AI 스토리지 참조 아키텍처로 자리 잡았다(업계 참조 아키텍처 기준[4]).
선정 파라미터SELECTION GUIDE
| 파라미터 | 확인 포인트 | 기준 설명 |
|---|---|---|
| 처리량(GB/s) | GPU 소비 속도에 대한 집계 읽기/쓰기 대역폭의 적합성 | '클러스터의 시간당 데이터 소비량' 기준으로 스토리지 처리량을 역산하고 30% 여유 확보(추정 기준) |
| IOPS 및 지연 시간 | 소규모 IO 시나리오(checkpoint 메타데이터, KV cache 계층화)에서는 IOPS와 P99 지연 시간 확인 | 대용량 처리량 ≠ 낮은 지연, 두 종류의 워크로드는 분리해서 봐야 함 |
| NVMe-oF 지원 | RDMA 전송(RoCE/IB) 기반의 네트워크 확장 | 클러스터 fabric 경로와 대조: IB 네트워크엔 IB-RDMA, 이더넷엔 RoCE |
| GPUDirect Storage | 스토리지 어레이/파일 시스템의 NVIDIA GDS 호환 목록 등재 여부 | 공식 호환 목록을 기준으로 한다(NVIDIA 문서 기준[3]) — 목록에 없는 솔루션은 직통을 위해 별도 개발이 필요하다 |
| 병렬 파일 시스템 | Lustre/GPFS 계열/벤더 자체 개발 병렬 FS | 다수 GPU 노드가 동일 데이터셋을 동시 읽기할 때 병렬 처리량이 핵심 |
| 용량 계층화 | 핫(NVMe)/웜(하이브리드)/콜드(오브젝트/테이프) 3계층 | 올플래시에는 핫 데이터만 배치—용량 비용은 계층화로 절감 |
| 데이터 보호 | Erasure Coding/복제본, 스냅샷, 재해 복구 | 학습 데이터셋과 checkpoint의 안전장치, 데이터 가치에 따라 등급 설정 |
선정 기준은 본 라이브러리가 공개 아키텍처 문서를 바탕으로 정리한 것(2026-10 기준)[1][3][4]; 구체적인 사항은 벤더 제품 문서와 실제 스트레스 테스트 기준.
3단계 AI 스토리지 아키텍처TIERING
| 계층 | 미디어/형태 | 저장 대상 | 핵심 지표 |
|---|---|---|---|
| 핫 계층 | NVMe 올플래시 어레이 / 분산 NVMe | 활성 학습 데이터셋, checkpoint, KV cache 계층화 | 처리량 + GPUDirect 직통 |
| 웜 계층 | 하이브리드 / 대용량 NVMe | 최근 데이터셋 버전, 전처리 중간 산출물 | 용량 가성비 |
| 콜드 계층 | 오브젝트 스토리지 / 테이프 | 원본 데이터 레이크, 역사적 아카이브 | 단위 용량당 비용 |
3계층 아키텍처는 본 라이브러리가 공개 참조 아키텍처를 바탕으로 정리한 기준[4]; 계층화 전략은 비즈니스 데이터 라이프사이클에 맞춰 커스터마이징한다.
생태계 및 벤더 구도VENDORS
AI 스토리지의 세 종류 플레이어(본 라이브러리 정리 기준, 구매 권고가 아님):
| 진영 | 대표 | 포지션과 특징 |
|---|---|---|
| 엔터프라이즈 올플래시 어레이 | Dell PowerStore/PowerScale, NetApp AFF, Pure FlashArray//FlashBlade, Huawei OceanStor, Inspur AS 시리즈 | 엔터프라이즈급 데이터 보호와 운영 체계가 완비됨; AI 적합성은 GPUDirect 호환성과 병렬 처리량에 좌우됨(공개 제품군 기준) |
| AI 네이티브 스토리지 | VAST Data, WEKA, VDURA 등 신세대 병렬 파일 시스템 벤더 | GPU 클러스터를 위해 설계: 병렬 FS + NVMe 계층화 + GDS 깊이 있는 최적화(참조 아키텍처 기준[4]) |
| 자체 구축/오픈소스 | Lustre, Ceph, JuiceFS 등 자체 구축 솔루션 | 초대형 클러스터 자체 구축은 통제력이 높지만 운영 인력이 비용(공개 생태계 기준) |
벤더 정보는 공개 제품군 정리이며, 구체적 사항은 각 벤더 공식 자료를 기준으로 합니다; SSD 낸드 측면(Samsung/Solidigm/Western Digital 엔터프라이즈 NVMe 드라이브)은 별도의 공급망 계층이며, 어레이 구매 시 이미 포함됩니다.
갤러리GALLERY
스토리지 장비 실물 사진은 검수 배치에 따라 업로드 보완됩니다; AI 생성 이미지는 실물 사진으로 표기하지 않습니다.
배포 및 통합DEPLOYMENT
스토리지 상선의 3단계 체크리스트:fabric 대조(스토리지 네트워크와 컴퓨팅 fabric의 경로 일치: IB 클러스터는 IB-RDMA 스토리지 네트워크, 이더넷은 RoCE—경로 혼용 시 게이트웨이가 필요하고 지연과 처리량 모두 저하됨);GDS 구현(NVIDIA 공식 GDS 문서에 따라 컴포넌트 배포[3], 어레이가 호환 목록 내에 있다는 전제);스트레스 테스트로 등급 확정(실제 학습 작업의 데이터 처리량 스트레스 테스트—paper specs로는 부족하며, GPU가 기다려주지 않는다는 것은 스트레스 테스트로만 알 수 있습니다).
운영 팁: 스토리지 계층의 모니터링 지표(처리량/IOPS/지연 P99/용량 수위)를 GPU 클러스터 모니터링과 같은 화면에서 확인하세요—'GPU 사용률 이상 저하'의 첫 번째 점검 항목이 스토리지 공급 속도입니다(본 라이브러리 운영 경험 기준).
구매 및 검수PROCUREMENT
AI 스토리지 구매 검수 포인트(3가지):
전체 6항 검수 판례는 본 항목 참조'검수 방법'절 참조.
검수 방법ACCEPTANCE TEST
6개 항목 검수 기준(AI 스토리지 검수 프레임워크): 개봉 점검 → 기본 처리량 → GPUDirect 직통 → 동시 읽기 → 장애 훈련 → 장기 안정성 연동 테스트.
운송과 납품LOGISTICS
용어 카드GLOSSARY
NVMe
플래시를 위해 태어난 스토리지 프로토콜: SSD가 PCIe 버스에 직결되고, 큐 깊이는 높으며, 지연은 낮다——SAS/SATA 프로토콜 대비 플래시의 속도를 완전히 끌어낸다. NVMe SSD는 올플래시 어레이의 기본 구성 블록이다.
NVMe-oF
NVMe over Fabrics: NVMe 프로토콜을 네트워크로 확장(RDMA 전송, IB 또는 RoCE 상에서 구동) — 서버가 로컬 디스크처럼 원격 올플래시 어레이에 접근하며, 성능 손실이 극히 적다(업계 기준[1]).
GPUDirect Storage(GDS)
NVIDIA의 스토리지 직통 기술: 데이터가 NVMe/어레이에서 RDMA로 GPU 메모리에 직접 전송되어 CPU 중계 복사를 우회 — 학습 데이터 로딩과 체크포인트 읽기/쓰기 효율화의 핵심 기술(공식 문서 기준[3]).
병렬 파일 시스템
여러 노드가 동일 파일시스템에 동시 접근하는 스토리지 아키텍처(Lustre/GPFS 계열 등): 데이터를 여러 스토리지 노드에 스트라이핑해 처리량을 집계한다——천 단위 GPU 클러스터가 동시에 학습 데이터셋을 읽으려면 병렬 FS만 견딘다.
Checkpoint
학습 과정의 저장 지점: 모델 가중치+옵티마이저 상태를 주기적으로 디스크에 기록——대형 모델의 checkpoint는 수십 TB에 달하며, 쓰기가 느리면 학습 리듬이 끊기고 유실되면 한 차례 진행 전체가 물거품이 된다. checkpoint 처리량은 AI 스토리지의 첫 번째 시험대다.
KV 캐시 계층화
추론 서비스의 GPU 메모리 초과 대응 방안: GPU HBM에 담지 못한 KV 캐시를 NVMe 계층으로 이관——NVMe 대역폭으로 메모리 용량을 확보하며, 긴 컨텍스트와 대량 배치 동시 처리를 위한 추론 아키텍처 구성 요소다.
한계와 논쟁점LIMITS
- 처리량 환상제조사 공칭 처리량은 이상적 조건의 실험실 수치——실제 학습 부하(소규모 IO 혼합, 다중 노드 동시 접근)에서는 달성률이 절반 이하로 떨어지는 경우가 흔하다. 실제 작업 부하 테스트만이 유일한 감별 도구(본 백과 검수 경험 기준).
- GDS 호환성 격차: 'NVMe-oF 지원'이 'NVIDIA GDS 호환 목록 등재'와 같지 않다 — 목록에 없는 솔루션은 직통을 위해 자체 개발이 필요하며, 숨은 비용까지 계산해야 한다(공식 문서 기준[3]).
- 올플래시 용량 비용 함정콜드 데이터까지 올플래시에 두는 것은 예산 블랙홀이다——핫/웜/콜드 3계층 아키텍처가 비용 규율이며, 올플래시는 핫 데이터만 담당해야 한다(본 백과 정리 기준).
- 중고 스토리지 어레이의 데이터 잔존중고 어레이의 이전 데이터 보안은 법적 수준의 리스크다——보안 삭제 기록이 거래의 전제 조건이어야 한다(본 백과 검수 경험 기준).
- 벤더 종속병렬 파일시스템과 어레이의 관리 스택 결합이 깊어 중도에 브랜드를 바꾸면 마이그레이션 비용이 크다——선정 시 '데이터를 빼내는 난이도'도 파라미터로 볼 것(본 백과 정리 기준).
시세 안내MARKET NOTE
AI 스토리지는 프로젝트형 조달이 주류(구성/용량/소프트웨어 스택 차이가 큼)이고, 중고 어레이는 데이터 보안 관문까지 통과해야 한다——검증 가능한 통일된 시세 스냅샷은 아직 없다,본 백과의 정직 원칙: 시세 밴드를 만들지 않으며, 가격은 판매자 제시가 기준。
재고 검색: AIXX Exchange 쇼룸 › (수수료 0% 매칭, 거래에 참여하지 않으며 체결가를 알거나 추측하지 않으므로 데이터가 중립적입니다). 시세 스냅샷이 충분히 축적되면 이 섹션은 표준 시세 밴드로 전환됩니다.
가격 주요 이벤트MILESTONES
자주 묻는 질문FAQ
세 가지 차이점: 처리량 규모(천 단위 GPU 클러스터의 데이터 공급은 일반 엔터프라이즈 부하의 수십 배), 다이렉트 아키텍처(GPUDirect Storage가 CPU 우회), 동시성 형태(다중 GPU 노드가 동일 데이터셋을 병렬로 읽음)——일반 NAS/하이브리드 플래시 어레이는 이 세 조건 앞에서 모두 뒤처진다.
적극 권장한다: 데이터가 CPU를 우회해 GPU 메모리로 직행하며, 학습 데이터 로딩과 checkpoint 읽기·쓰기의 지연과 CPU 사용량이 동시에 감소한다(공식 문서 기준). GDS 미지원 솔루션도 동작은 하지만, CPU 경유의 처리량 상한이 낮고 호스트 자원이 데이터 이동에 소모된다.
대형 모델 checkpoint는 수십 TB 규모에 쓰기가 잦다: 쓰기가 느리면 학습 리듬이 끊기고(GPU가 디스크 기록을 대기), 쓰기가 중단되면 한 차례 진행 전체가 유실——checkpoint 처리량과 신뢰성이 AI 스토리지와 일반 스토리지를 가르는 기준선이다.
가능하되 세 관문을 통과해야 한다: 데이터 보안 관문(이전 데이터의 보안 삭제 기록이 거래 전제), 건강 관문(NVMe 디스크 쓰기 수명/SMART 전량 내보내기), 라이선스 관문(용량·기능 라이선스가 하드웨어와 함께 이전되는지). 스토리지는 데이터의 보금자리이므로 검수 기준은 높게 잡는다.
동일 계열 내 계층화를 권장한다: IB 클러스터에는 IB-RDMA 스토리지 네트워크, 이더넷 클러스터에는 RoCE——이기종 계열은 게이트웨이 변환이 필요하고 지연·처리량이 모두 깎인다. 트래픽 층면에서 스토리지 네트워크와 컴퓨트 네트워크는 물리적/논리적으로 격리해 checkpoint 쓰기가 학습 통신에 미치는 충격을 피한다.
관련 항목SEE ALSO
선택 기준 비교와 확장COMPARE
참고 자료REFERENCES
- Introl — AI-Optimized Storage: NVMe-oF, GPUDirect & Parallel File Systems(2025 아키텍처 총람) https://introl.com/blog/ai-optimized-storage-nvme-gpudirect-…
- NVIDIA Developer Blog — NVIDIA GPUDirect Storage(2020 발표 글) https://developer.nvidia.com/blog/gpudirect-storage/
- NVIDIA 공식 문서 — GPUDirect Storage Overview Guide(배포 및 호환성 기준) https://docs.nvidia.com/gpudirect-storage/overview-guide/ind…
- VDURA — AI Storage Reference Design(올플래시 레퍼런스 아키텍처 기준) https://www.vdura.com/resources/reference-architecture/ai-st…
- 판매 중 검색 — AIXX 거래소(0 수수료 중개; AI 스토리지는 아직 시세 스냅샷 없음, 가격은 화주 견적 기준) https://www.aixx.vip/hall.html