AIXX 百科 › インフラ項目 › NVMe オールフラッシュストレージ
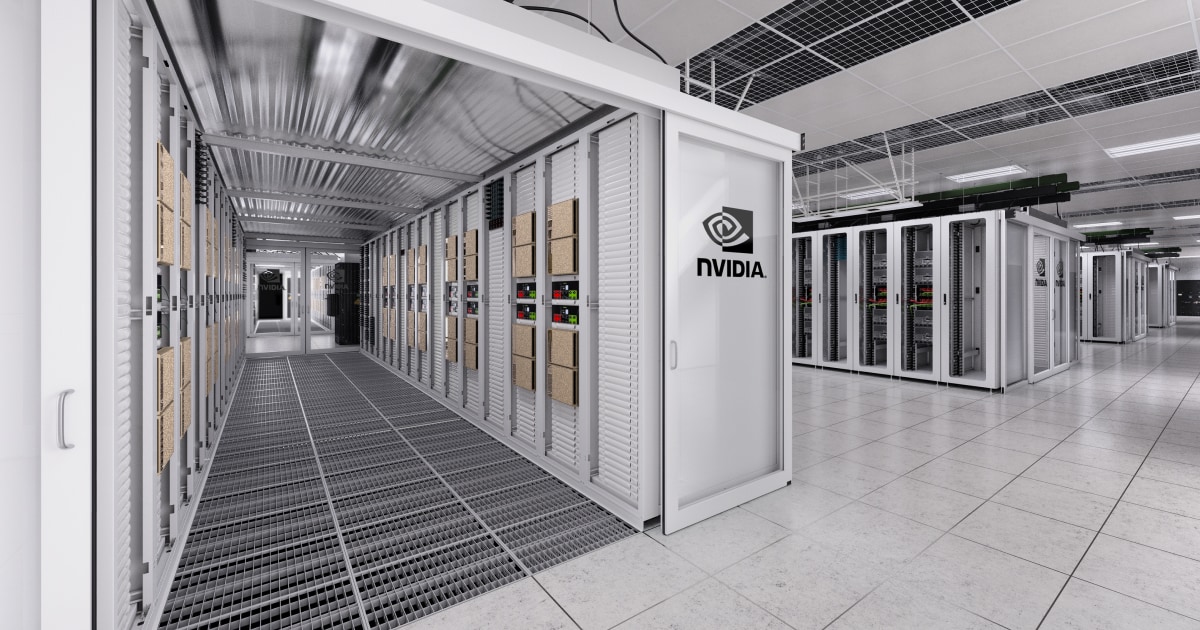
NVMe オールフラッシュストレージ
概要OVERVIEW
NVMe オールフラッシュストレージAI クラスターの「第三の足」:算力(GPU)、ネットワーク(NVLink/fabric)に次ぐ第三の柱が、学習と推論のデータパイプライン——checkpoint の書き込み・読み出し、学習データセットのスループット、KV cache の階層化は、すべてストレージ層に載る。NVMe プロトコル(SSD を PCIe 直結とし、従来の SAS/SATA コントローラを経由しない)+ オールフラッシュアレイ + NVMe-oF ネットワーク + GPUDirect Storage(データがストレージから GPU メモリへ直接転送され、CPU 経由のコピーをバイパスする、NVIDIA 公式ドキュメントの見解[3])という構成が、現代の AI ストレージの標準的なピースとなっている。
なぜ AI クラスタで必須要件になったのか:千基規模のクラスタにおける checkpoint は容易に数十 TB、学習データセットは数百 TB 単位に達する。HDD やハイブリッドフラッシュアレイのスループットでは GPU を満たせず、GPU がデータを待つ 1 秒 1 秒が無駄なコストになる。NVMe-oF はオールフラッシュの性能をネットワークへ拡張し(RDMA 直結[1])、GPUDirect Storage はデータパスから CPU を外す——この 2 点が、ストレージ層がアクセラレータになるかボトルネックになるかを決める。
本項目はカテゴリ選定型の項目:AI クラスター視点でのストレージアーキテクチャ、選定パラメータ、購入時の検収について解説。特定製品は対象としない。ストレージには統一された相場がなく、実際の価格は出品者の提示価格によります。
適用シーンFIT
AIXX Index(0–100):ユースケースとの適合度を重み付けして算出。90+ フラッグシップ級 · 75+ 優秀 · 60+ 実用可 · 60 未満は不適。
沿革HISTORY
2011 年NVMe 1.0 仕様が発表:SSD を PCIe 直結とし、フラッシュのために設計されたプロトコルが SAS/SATA 通道を置き換え——オールフラッシュアレイのプロトコル的土台(業界公開情報)。
2016-2020 年、オールフラッシュアレイの主流化:NVMe-oF 規格が NVMe をネットワークへ拡張し(RDMA 直結)、Dell/NetApp/Pure などのベンダーのオールフラッシュアレイがエンタープライズストレージの新標準となり、GPU クラスタはオールフラッシュをストレージ基盤とし始めた(業界の見解[1])。
2020 年NVIDIA が発表 GPUDirect Storage:ストレージデータが RDMA 経由で GPU メモリへ直接転送され、CPU の中継をバイパスする(NVIDIA 開発者ブログおよび公式ドキュメントの見解[2][3])——AI ストレージのラストワンマイルが開通し、CUDA エコシステムがさらに地歩を固めた。
2023〜2026 年、AI クラスタでの標準装備化:大規模モデル学習の checkpoint とデータスループット需要が、ストレージをインフラの中心へと押し上げた——「オブジェクトレイク(コールド)+オールフラッシュキャッシュ(ホット)+GPUDirect 直通」の 3 層構成が AI ストレージのリファレンスアーキテクチャとなっている(業界リファレンスアーキテクチャの見解[4])。
選定パラメータSELECTION GUIDE
| パラメータ | 見るべきポイント | 基準の説明 |
|---|---|---|
| スループット(GB/s) | 集約読み書き帯域が GPU の消費速度と整合するか | 「クラスターの1時間あたりデータ消費量」から逆算し、30% のマージンを確保(推定基準) |
| IOPS とレイテンシ | 小容量 IO のユースケース(checkpoint のメタデータ、KV cache の階層化)では IOPS と P99 レイテンシを重視 | 高スループット≠低レイテンシ。2種類のワークロードは分けて評価する |
| NVMe-oF 対応 | RDMA 伝送(RoCE/IB)によるネットワーク拡張 | クラスターの fabric 路線と照合:IB ネットワークには IB-RDMA、イーサネットには RoCE を組み合わせる |
| GPUDirect Storage | ストレージアレイ/ファイルシステムが NVIDIA GDS 互換リストに登録されているか | 公式の互換性リストを基準とすること(NVIDIA ドキュメントの見解[3])——リスト外のソリューションで直通を実現するには追加開発が必要 |
| 並列ファイルシステム | Lustre/GPFS 系/ベンダー独自の並列 FS | 複数 GPU ノードが同一データセットを並列読み込みする際、並列スループットが鍵 |
| 容量の階層化 | ホット(NVMe)/ウォーム(ハイブリッド)/コールド(オブジェクト/テープ)の3層 | オールフラッシュはホットデータのみに配置——容量コストは階層化で抑える |
| データ保護 | イレイジャーコーディング/レプリカ、スナップショット、遠隔地ディザスタリカバリ | 学習データセットと checkpoint の保険。データの価値に応じて等級を設定 |
選定基準は本ライブラリが公開アーキテクチャドキュメントに基づき整理したもの(2026-10 時点)[1][3][4];詳細はベンダーの製品ドキュメントおよび実測ストレステストによる。
三段構成の AI ストレージアーキテクチャTIERING
| 層 | 媒体/形態 | 配置するデータ | 重要指標 |
|---|---|---|---|
| ホット層 | NVMe オールフラッシュアレイ / 分散 NVMe | アクティブな学習データセット、checkpoint、KV cache の階層化 | スループット + GPUDirect 直通 |
| ウォーム層 | ハイブリッド / 大容量 NVMe | 直近のデータセットバージョン、前処理の中間生成物 | 容量コスパ |
| コールド層 | オブジェクトストレージ / テープ | オリジナルのデータレーク、過去アーカイブ | 単位容量あたりコスト |
3 層アーキテクチャは本ライブラリが公開リファレンスアーキテクチャに基づき整理したもの[4];層ごとの戦略は業務データのライフサイクルに応じてカスタマイズする。
エコシステムとベンダー構図VENDORS
AI ストレージの3種類のプレイヤー(本ライブラリの整理基準。購入推奨を構成するものではない):
| 陣営 | 代表例 | 位置づけと特徴 |
|---|---|---|
| エンタープライズオールフラッシュアレイ | Dell PowerStore/PowerScale、NetApp AFF、Pure FlashArray//FlashBlade、Huawei OceanStor、Inspur AS 系 | エンタープライズ級のデータ保護と運用体制が充実。AI 適合性は GPUDirect 互換性と並列スループットで判断(公開製品ラインの情報) |
| AI ネイティブストレージ | VAST Data、WEKA、VDURA など新世代並列ファイルシステムベンダー | GPU クラスタのために生まれた:並列 FS+NVMe 階層化+GDS の深い適合(リファレンスアーキテクチャの見解[4]) |
| 自社構築/オープンソース | Lustre、Ceph、JuiceFS などの自社構築方式 | 超大型クラスターの自社構築は制御性が高いが、運用人件費がコストになる(公開エコシステムの情報) |
ベンダー情報は公開製品ラインからの整理であり、詳細は各ベンダーの公式資料を優先。SSD 素子側(Samsung/Solidigm/Western Digital のエンタープライズ NVMe ドライブ)はもう一層のサプライチェーンであり、アレイ購入時に含まれる。
ギャラリーGALLERY
ストレージ機器の実機写真は検収ロットごとに順次追加掲載。AI 生成画像を実写と偽らない。
導入と統合DEPLOYMENT
ストレージ稼働開始までの3ステップ照合:fabric の照合(ストレージネットワークとコンピュート fabric は同一路線に:IB クラスターには IB-RDMA のストレージ網、イーサネットには RoCE——路線を混在させるとゲートウェイが必要になり、レイテンシもスループットも低下);GDS の開通(NVIDIA 公式 GDS ドキュメントに従ってコンポーネントをデプロイ[3]、アレイが互換性リスト内にあることが前提);圧力テストでの等級判定(実際の学習タスクによるデータスループット検証——カタログスペックは当てにならず、GPU が待たされないかは圧力テストでしか分からない)。
運用のヒント:ストレージ層の監視指標(スループット/IOPS/レイテンシ P99/容量水位)は GPU クラスターの監視と同じ画面で確認する——「GPU 使用率が異常に低い」際の最初の調査箇所はストレージの供給速度(本ライブラリの運用経験に基づく見解)。
調達と検収PROCUREMENT
AI ストレージ購入時の検収ポイント(3項目):
6 項目の完全な検収判例は本項目を参照「検収方法」節を参照。
検収の方法ACCEPTANCE TEST
六項目の検収基準(AI ストレージ検収フレームワーク):開梱検品 → 基本スループット → GPUDirect 直通 → 並列読み込み → 障害訓練 → 長時間安定性の連結検証。
輸送と納品LOGISTICS
用語カードGLOSSARY
NVMe
フラッシュのために生まれたストレージプロトコル:SSD を PCIe バスに直接接続、高キュー深度、低レイテンシ——SAS/SATA プロトコルと比べてフラッシュの速度を解放する。NVMe SSD はオールフラッシュアレイの基本的な構成要素。
NVMe-oF
NVMe over Fabrics:NVMe プロトコルをネットワークへ拡張する(RDMA 伝送、IB または RoCE 上で動作)——サーバーがローカルディスクと同じようにリモートのオールフラッシュアレイへアクセスでき、性能劣化は極めて小さい(業界の見解[1])。
GPUDirect Storage(GDS)
NVIDIA のストレージ直通技術:データが NVMe/アレイから RDMA 経由で GPU メモリへ直接転送され、CPU の中継コピーをバイパスする——学習データのロードと checkpoint の読み書きを高速化するキーテクノロジー(公式ドキュメントの見解[3])。
並列ファイルシステム
複数ノードから同一ファイルシステムへ同時アクセスするストレージアーキテクチャ(Lustre/GPFS 系など):データを複数のストレージノードへストライピングしてスループットを集約——千規模 GPU クラスタが同時に学習データセットを読むのは並列 FS しか支えられない。
Checkpoint
学習プロセスのセーブポイント:モデル重み+オプティマイザ状態の周期的なディスク書き込み——大規模モデルの checkpoint は数十 TB 規模に達し、書き込みが遅いと学習のテンポを損ない、失えば進捗全体を失う。checkpoint スループットは AI ストレージの第一の試金石。
KV キャッシュの階層化
推論サービスの VRAM 不足対策:GPU HBM に収まらない KV キャッシュを NVMe 層に配置——NVMe 帯域を VRAM 容量の代替とし、長いコンテキストと大バッチ同時実行の推論アーキテクチャ構成要素。
限界と論点LIMITS
- スループットの幻想:メーカー公称スループットは理想条件下のラボ値——実際の学習ワークロード(小 IO の混合、マルチノード同時アクセス)では達成率が半分になることが多い。実際のタスクでの負荷テストが唯一の鏡(本ライブラリの検品経験に基づく見解)。
- GDS 互換性の分化:「NVMe-oF 対応」は「NVIDIA GDS 互換性リスト登録」とイコールではない——リスト外のソリューションで直通を実現するには自前開発が必要で、隠れたコストも織り込んで計算すること(公式ドキュメントの見解[3])。
- オールフラッシュ容量コストの罠:コールドデータまでオールフラッシュに置くのは予算のブラックホール——3層階層アーキテクチャ(ホット/ウォーム/コールド)がコスト規律であり、オールフラッシュはホットデータのみに使う(本ライブラリの整理に基づく見解)。
- 中古ストレージアレイの残存データ:中古アレイの前オーナーのデータセキュリティは法的リスクレベル——セキュア消去の記録を取引の前提条件にすべき(本ライブラリの検品経験に基づく見解)。
- ベンダーロックイン:並列ファイルシステムとアレイの管理スタックの結合が深く、途中でブランドを変えると移行コストが高い——選定時は「データを取り出す難易度」もパラメータとして見るべき(本ライブラリの整理に基づく見解)。
相場情報MARKET NOTE
AI ストレージはプロジェクトベースの調達が主流(構成/容量/ソフトウェアスタックの差が大きく)、中古アレイにはデータセキュリティの関門もある——現時点で検証可能な統一市況スナップショットはなし、本ライブラリの誠実さの原則:相場帯を設けず、価格は出品者の実際の提示価格によります。
販売検索:AIXX 取引所ロビー ›(手数料ゼロのマッチング、取引には関与せず、成約価格も把握・推測しないため、データは中立的です)。相場スナップショットの蓄積が十分になった時点で、本セクションは標準相場帯に切り替わります。
価格イベント年表MILESTONES
よくある質問FAQ
3つの違い:スループット規模(千規模 GPU クラスタへのデータ供給は一般企業負荷の数十倍)、ダイレクトアーキテクチャ(GPUDirect Storage が CPU をバイパス)、同時アクセス形態(複数 GPU ノードが同一データセットを並列読み込み)——一般の NAS/ハイブリッドフラッシュアレイはこの3点に追いつけない。
強く推奨:データが CPU をバイパスして GPU メモリへ直行し、学習データのロードと checkpoint の読み書きでレイテンシと CPU 負荷がともに低下(公式ドキュメント基準);GDS 非対応のソリューションでも動作は可能だが、CPU 経由ではスループットの天井が低く、ホストリソースがデータ転送に浪費される。
大規模モデルの checkpoint は数十 TB 規模で書き込み頻度も高い:書き込みが遅いと学習のテンポを損ない(GPU がディスク書き込みを待つ)、書き込みが中断すれば進捗全体を失う——checkpoint のスループットと信頼性は AI ストレージと一般ストレージの分水嶺。
可能だが3つの関門を通る必要がある:データセキュリティ(前オーナーのデータのセキュア消去記録が取引の前提)、健全性(NVMe ドライブの書き込み寿命/SMART の全量エクスポート)、ライセンス(容量と機能ライセンスがハードウェアとともに移転するか)。ストレージはデータの家であり、検収基準は厳しくあるべき。
同一路線での階層化を推奨:IB クラスタには IB-RDMA ストレージネットワーク、イーサネットクラスタには RoCE——路線を混在させるとゲートウェイ変換が必要で、レイテンシとスループットがともに低下。トラフィック面ではストレージ網と計算網を物理的/論理的に分離し、checkpoint 書き込みが学習通信に与える影響を避ける。
関連項目SEE ALSO
選定対照と関連情報COMPARE
参考文献REFERENCES
- Introl — AI-Optimized Storage: NVMe-oF, GPUDirect & Parallel File Systems(2025 アーキテクチャ総覧) https://introl.com/blog/ai-optimized-storage-nvme-gpudirect-…
- NVIDIA Developer Blog — NVIDIA GPUDirect Storage(2020 発表記事) https://developer.nvidia.com/blog/gpudirect-storage/
- NVIDIA 公式ドキュメント — GPUDirect Storage Overview Guide(デプロイと互換性の基準) https://docs.nvidia.com/gpudirect-storage/overview-guide/ind…
- VDURA — AI Storage Reference Design(オールフラッシュリファレンスアーキテクチャ基準) https://www.vdura.com/resources/reference-architecture/ai-st…
- 出品検索 — AIXX Exchange(手数料ゼロのマッチング;AI ストレージは現時点で市況スナップショットなし、実際の価格は出品者の提示価格によります) https://www.aixx.vip/hall.html