AIXX Pedia › Fiche infrastructure › Stockage full-flash NVMe
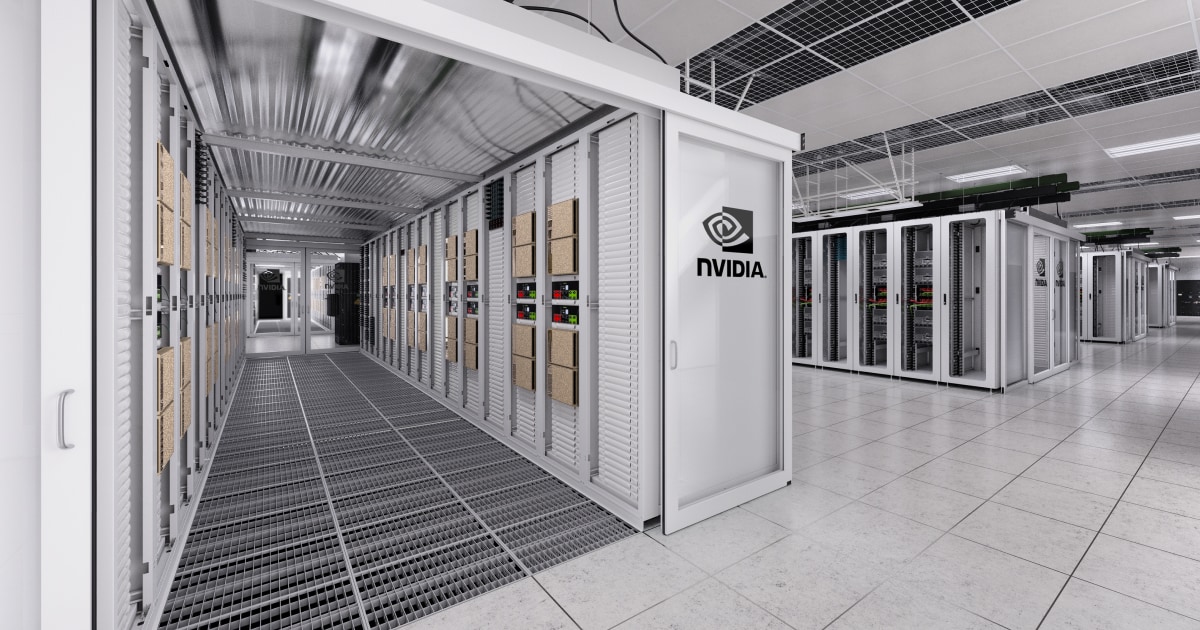
Stockage full-flash NVMe
Vue d'ensemble OVERVIEW
Stockage full-flash NVMe C'est la « troisième jambe » des clusters IA : au-delà de la puissance de calcul (GPU) et du réseau (NVLink/fabric), c'est toute la chaîne de données de l'entraînement et de l'inférence — écriture/lecture des checkpoints, débit des jeux de données d'entraînement, hiérarchisation du KV cache — qui repose entièrement sur la couche de stockage. Protocole NVMe (SSD directement reliés en PCIe, sans passer par les contrôleurs SAS/SATA traditionnels) + baies full flash + réseau NVMe-oF + GPUDirect Storage (Données transférées du stockage directement en mémoire GPU, sans copie via le CPU, d'après la documentation officielle NVIDIA[3]) constituent une pièce maîtresse du stockage moderne pour l'IA.
Pourquoi c'est devenu une nécessité dans les clusters IA : les checkpoints d'un cluster à milliers de GPU atteignent facilement des dizaines de To, les jeux de données d'entraînement se comptent en centaines de To — le débit des disques mécaniques ou des baies hybrides ne suffit plus à alimenter les GPU, et chaque seconde d'attente GPU est de l'argent brûlé. NVMe-oF étend la performance full flash au réseau (accès RDMA direct[1]), et GPUDirect Storage retire le CPU du chemin des données — ces deux points déterminent si la couche stockage est un accélérateur ou un goulot d'étranglement.
Cette fiche est une fiche de sélection de catégorie : cet article aborde l'architecture de stockage sous l'angle des clusters IA, les critères de sélection et la réception à l'achat, sans cibler un produit particulier. Le stockage n'a pas de cours unifié ; le prix réel est soumis au devis du vendeur.
Cas d'usage FIT
AIXX Index (0–100) : estimation pondérée selon l'adéquation au scénario. 90+ niveau fleuron · 75+ Excellent · 60+ utilisable · en dessous de 60, non adapté.
Historique HISTORY
En 2011 , publication de la spécification NVMe 1.0 : le protocole né pour la flash, reliant les SSD directement en PCIe, remplace les canaux SAS/SATA — la fondation protocolaire des baies full flash (consensus sectoriel public).
2016-2020 , banalisation des baies full flash : la spécification NVMe-oF étend le NVMe au réseau (accès RDMA direct), les baies full flash de Dell/NetApp/Pure deviennent le nouveau standard du stockage d'entreprise, et les clusters GPU adoptent le full flash comme socle de stockage (selon les sources du secteur[1]).
En 2020 , NVIDIA publie GPUDirect Storage : les données du stockage transitent par RDMA directement en mémoire GPU, sans relais CPU (d'après le blog développeurs et la documentation officielle NVIDIA[2][3]) — le dernier kilomètre du stockage IA est franchi, un succès de plus pour l'écosystème CUDA.
2023-2026 , standard des clusters IA : les besoins en checkpoints et en débit de données de l'entraînement des grands modèles propulsent le stockage au cœur de l'infrastructure — l'architecture en trois étages « lac d'objets (froid) + cache full flash (chaud) + accès direct GPUDirect » devient l'architecture de référence du stockage IA (d'après les architectures de référence du secteur[4]).
Paramètres de sélection SELECTION GUIDE
| Paramètre | Ce qu'il faut regarder | Référence d'interprétation |
|---|---|---|
| Débit (GB/s) | Adéquation de la bande passante agrégée en lecture/écriture à la vitesse de consommation des GPU | Déduire le débit de stockage de « la quantité de données consommée par heure par le cluster », avec 30 % de marge (estimation) |
| IOPS et latence | Pour les scénarios à petits IO (métadonnées de checkpoints, hiérarchisation du KV cache), regarder IOPS et latence P99 | Haut débit ≠ faible latence : examiner séparément les deux types de charge |
| Support NVMe-oF | Extension réseau via transport RDMA (RoCE/IB) | À aligner sur la fabric du cluster : réseau IB avec IB-RDMA, Ethernet avec RoCE |
| GPUDirect Storage | Baies/filesystems dans la liste de compatibilité GDS de NVIDIA | se référer à la liste de compatibilité officielle (d'après la documentation NVIDIA[3]) — les solutions hors liste nécessitent un développement spécifique pour l'accès direct |
| Filesystem parallèle | Lustre/systèmes GPFS/FS parallèles propriétaires | Lecture concurrente du même jeu de données par plusieurs nœuds GPU : le débit parallèle est déterminant |
| Hiérarchisation de la capacité | Trois niveaux : chaud (NVMe) / tiède (hybride) / froid (objet/bande) | Le full flash ne porte que les données chaudes — le coût de la capacité se comprime par la hiérarchisation |
| Protection des données | Erasure coding/réplication, snapshots, reprise à distance | Corde de sécurité des jeux de données d'entraînement et des checkpoints ; calibrer selon la valeur des données |
Critères de sélection établis par cette base à partir des documents d'architecture publics (au 2026-10)[1][3][4] ; se référer aux documentations produits des fabricants et aux tests de charge réels.
Architecture de stockage IA en trois temps TIERING
| Couche | Média/forme | Contenu | Indicateurs clés |
|---|---|---|---|
| Couche chaude | Baie NVMe full flash / NVMe distribué | Jeux d'entraînement actifs, checkpoints, hiérarchisation du KV cache | Débit + passage direct GPUDirect |
| Couche tiède | Hybride flash / NVMe grande capacité | Versions récentes des jeux de données, produits intermédiaires de prétraitement | Rapport capacité/prix |
| Couche froide | Stockage objet / bande | Lac de données brut, archives historiques | Coût par unité de capacité |
L'architecture à trois étages est une synthèse de cette base à partir d'architectures de référence publiques[4] ; la stratégie de répartition des couches s'adapte au cycle de vie des données métier.
Écosystème et paysage des fournisseurs VENDORS
Les trois familles d'acteurs du stockage IA (compilation de cette fiche, ne constitue pas une recommandation d'achat) :
| Camp | Représentants | Positionnement et caractéristiques |
|---|---|---|
| Baies full flash d'entreprise | Dell PowerStore/PowerScale, NetApp AFF, Pure FlashArray//FlashBlade, Huawei OceanStor, gamme AS d'Inspur | Protection des données et outillage d'exploitation de niveau entreprise complets ; l'adaptation IA se juge sur la compatibilité GPUDirect et le débit parallèle (référence publique des gammes produits) |
| Stockage IA natif | VAST Data, WEKA, VDURA et autres fournisseurs de nouvelle génération de filesystems parallèles | Conçu pour les clusters GPU : FS parallèle + tiering NVMe + intégration approfondie de GDS (d'après les architectures de référence[4]) |
| Autofinancé/open source | Solutions auto-hébergées comme Lustre, Ceph, JuiceFS | Contrôlabilité forte pour les très grands clusters, mais la main-d'œuvre d'exploitation est un coût (référence écosystème public) |
Informations fournisseurs compilées à partir des gammes produits publiques ; se référer aux documentations officielles de chaque fabricant. Côté puces SSD (disques NVMe entreprise Samsung/Solidigm/Western Digital), c'est une autre couche de chaîne d'approvisionnement, déjà incluse dans l'achat de la baie.
Galerie GALLERY
Les photos réelles d'équipements de stockage sont ajoutées au fil des lots de réception ; les images générées par IA ne se font pas passer pour des photos réelles.
Déploiement et intégration DEPLOYMENT
La mise en production du stockage en trois étapes de vérification : Alignement fabric (le réseau de stockage suit la même voie que la fabric de calcul : clusters IB avec réseau de stockage IB-RDMA, Ethernet avec RoCE — mixer les voies impose une passerelle, avec latence et débit dégradés) ; Mise en place GDS (déploiement des composants selon la documentation officielle GDS de NVIDIA[3], en supposant que la baie figure dans la liste de compatibilité) ; Test de charge et calibrage (test de débit de données avec de vraies tâches d'entraînement — les specs papier ne comptent pas, seul le test de charge révèle si les GPU attendent).
Conseil d'exploitation : suivre les métriques de la couche de stockage (débit/IOPS/latence P99/niveau de capacité) sur le même écran que la supervision du cluster GPU — un « taux d'utilisation GPU anormalement bas » a pour premier poste de diagnostic la vitesse d'alimentation du stockage (retour d'expérience d'exploitation de cette fiche).
Achat et réception PROCUREMENT
Les points de réception d'un achat de stockage IA (trois points) :
Les six critères complets de réception figurent dans cette fiche « Comment réceptionner » de cette entrée.
Comment réceptionner ACCEPTANCE TEST
Cadre de réception en six points (cadre de validation du stockage IA) : inventaire à l'ouverture → débit de base → passage direct GPUDirect → lecture concurrente → exercices de panne → rodage de longue durée.
Transport et livraison LOGISTICS
Fiches terminologie GLOSSARY
NVMe
Protocole de stockage conçu pour la mémoire flash : connexion directe des SSD au bus PCIe, profondeur de file élevée, faible latence — par rapport à SAS/SATA, il libère tout le potentiel de vitesse de la mémoire flash. Les SSD NVMe sont la brique de base des baies full flash.
NVMe-oF
NVMe over Fabrics : extension du protocole NVMe au réseau (transport RDMA, sur IB ou RoCE) — le serveur accède à une baie full flash distante comme à un disque local, avec une perte de performance minimale (selon les sources du secteur[1]).
GPUDirect Storage(GDS)
Technologie d'accès direct au stockage de NVIDIA : les données passent du NVMe/de la baie par RDMA directement en mémoire GPU, sans copie via le CPU — technologie clé pour accélérer le chargement des données d'entraînement et les lectures/écritures de checkpoints (d'après la documentation officielle[3]).
Filesystem parallèle
Architecture de stockage à accès concurrent multi-nœuds à un même système de fichiers (Lustre/GPFS, etc.) : striping des données sur plusieurs nœuds de stockage pour agréger le débit — seuls les systèmes de fichiers parallèles tiennent la charge lorsqu'un cluster de milliers de GPU lit simultanément le jeu d'entraînement.
Checkpoint
Points de sauvegarde du processus d'entraînement : écriture périodique sur disque des poids du modèle et de l'état de l'optimiseur — les checkpoints des grands modèles se comptent en dizaines de To ; une écriture lente ralentit le rythme d'entraînement, une perte anéantit tout un cycle. Le débit des checkpoints est la première épreuve du stockage IA.
Hiérarchisation du cache KV
Solution de débordement mémoire pour les services d'inférence : le cache KV qui ne tient pas dans la HBM des GPU est déporté vers la couche NVMe — échange de bande passante NVMe contre capacité mémoire, composant d'architecture d'inférence pour contextes longs et forte concurrence par lots.
Limites et controverses LIMITS
- Illusion de débit : le débit annoncé par les fabricants est une valeur de laboratoire en conditions idéales — en charge d'entraînement réelle (petits IO mixtes, accès concurrents multi-nœuds), le taux d'atteinte est souvent divisé par deux ; seul un test de charge en conditions réelles fait la lumière (référence : expérience de contrôle de la base).
- Fragmentation de la compatibilité GDS : « supporte NVMe-oF » ne signifie pas « figure dans la liste de compatibilité NVIDIA GDS » — les solutions hors liste exigent un développement maison pour l'accès direct, un coût caché à prendre en compte (d'après la documentation officielle[3]).
- Piège du coût des capacités full flash : stocker aussi les données froides en full flash est un trou noir budgétaire — l'architecture à trois niveaux (chaud/tiède/froid) est une discipline de coûts, le full flash ne sert que les données chaudes (référence : synthèse de la base).
- Résidus de données sur les baies de stockage d'occasion : la sécurité des données antérieures d'une baie d'occasion est un risque de niveau juridique — le certificat d'effacement sécurisé doit être une condition préalable à la transaction (référence : expérience de contrôle de la base).
- Verrouillage fournisseur : les systèmes de fichiers parallèles sont profondément liés à la pile de gestion des baies, et la migration vers une autre marque en cours d'exploitation coûte cher — au moment du choix, considérez aussi « la difficulté à faire sortir les données » comme un paramètre (référence : synthèse de la base).
Notes de marché MARKET NOTE
Le stockage IA s'achète essentiellement en mode projet (grandes différences de configuration/capacité/pile logicielle), et les baies d'occasion doivent encore franchir l'étape sécurité des données — aucune cotation de marché unifiée vérifiable pour le moment, Principe d'honnêteté de cette fiche : pas de bande de marché, le prix est soumis au devis réel du vendeur 。
Recherche des offres : AIXX Exchange Hall › (mise en relation sans commission, sans participation aux transactions, sans connaissance ni spéculation sur les prix de conclusion, d'où la neutralité des données). Cette section passera à la fourchette de marché standard une fois les données suffisamment accumulées.
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Trois points de différence : échelle de débit (des dizaines de fois la charge d'entreprise classique pour alimenter un cluster de milliers de GPU), architecture de contournement (GPUDirect Storage qui évite le CPU), mode de concurrence (plusieurs nœuds GPU lisant en parallèle le même jeu de données) — ni un NAS ni une baie hybride flash/HDD ne suivent sur ces trois plans.
Fortement recommandé : les données vont directement du stockage à la mémoire GPU sans passer par le CPU, réduisant à la fois la latence du chargement des données d'entraînement et de la lecture/écriture des checkpoints et l'occupation du CPU (référence : documentation officielle) ; les solutions sans GDS fonctionnent aussi, mais le plafond de débit du relais CPU est bas et les ressources de l'hôte sont accaparées par le transport des données.
Les checkpoints des grands modèles se comptent en dizaines de To et s'écrivent fréquemment : une écriture lente ralentit l'entraînement (les GPU attendent), une écriture interrompue fait perdre tout un cycle — le débit et la fiabilité des checkpoints marquent la frontière entre stockage IA et stockage classique.
Oui, mais trois étapes s'imposent : sécurité des données (le certificat d'effacement sécurisé des données antérieures est une condition préalable), santé matérielle (export complet de la durée de vie d'écriture / SMART des SSD NVMe), licences (les licences de capacité et de fonctionnalités se transfèrent-elles avec le matériel ?). Le stockage est la maison des données, les critères de réception doivent être exigeants, pas l'inverse.
Recommandé : même technologie mais réseaux séparés — cluster IB avec réseau de stockage IB-RDMA, cluster Ethernet avec RoCE — les technologies mixtes exigent une conversion passerelle qui divise latence et débit. Au niveau du trafic, les deux réseaux peuvent être isolés physiquement ou logiquement, afin d'éviter que l'écriture des checkpoints ne perturbe les communications d'entraînement.
Fiches liées SEE ALSO
Tableau de sélection et prolongements COMPARE
Références REFERENCES
- Introl — AI-Optimized Storage : NVMe-oF, GPUDirect & Parallel File Systems (synthèse architecturale 2025) https://introl.com/blog/ai-optimized-storage-nvme-gpudirect-…
- NVIDIA Developer Blog — NVIDIA GPUDirect Storage (communiqué de lancement 2020) https://developer.nvidia.com/blog/gpudirect-storage/
- Documentation officielle NVIDIA — GPUDirect Storage Overview Guide (référence de déploiement et de compatibilité) https://docs.nvidia.com/gpudirect-storage/overview-guide/ind…
- VDURA — AI Storage Reference Design (référence d'architecture full flash) https://www.vdura.com/resources/reference-architecture/ai-st…
- Recherche des offres en vente — AIXX (Mise en relation sans commission ; pas de cotation de marché pour le stockage IA, le prix réel est soumis au devis du vendeur) https://www.aixx.vip/hall.html