AIXX Pedia › Infrastruktur-Eintrag › NVMe All-Flash-Speicher
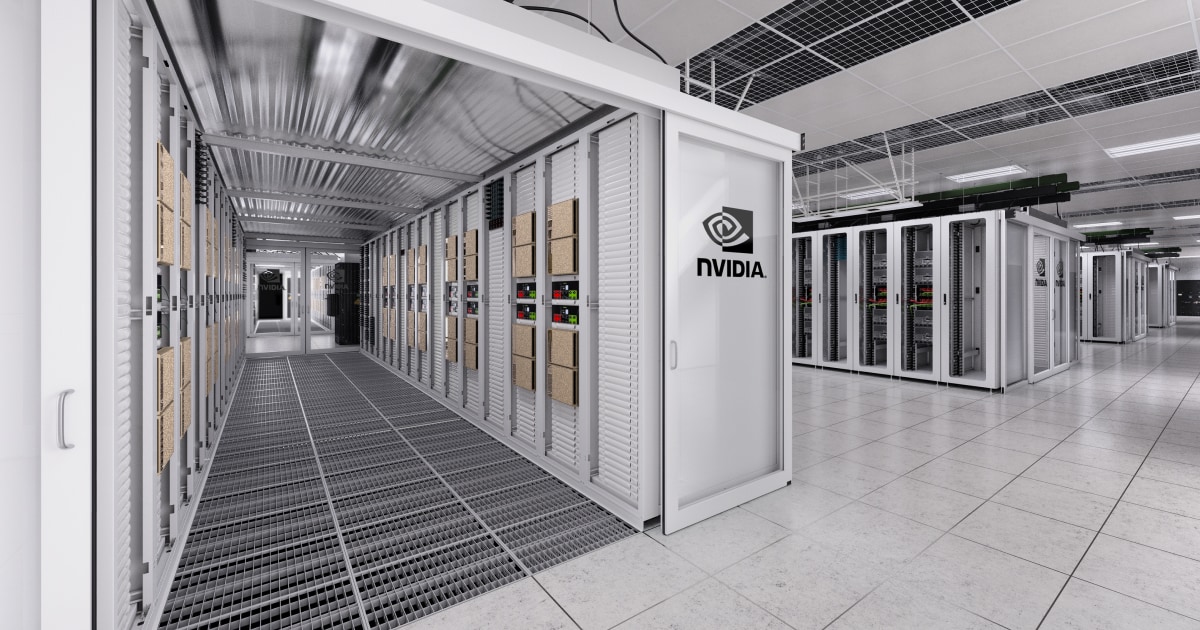
NVMe All-Flash-Speicher
Überblick OVERVIEW
NVMe All-Flash-Speicher Sie ist das „dritte Standbein“ des AI-Clusters: Neben Rechenleistung (GPUs) und Netzwerk (NVLink/Fabric) liegt die gesamte Datenpipeline für Training und Inferenz — Checkpoint-Schreib-/Lesezugriffe, Trainingsdatensatz-Durchsatz, KV-Cache-Tiering — vollständig auf der Speicherschicht. Das NVMe-Protokoll (SSDs direkt am PCIe-Bus, ohne klassische SAS/SATA-Controller) + All-Flash-Arrays + NVMe-oF-Netzwerk + GPUDirect Storage (Daten gelangen direkt vom Speicher in den GPU-Speicher, ohne Kopiervorgang über die CPU, laut offizieller NVIDIA-Dokumentation[3]) – ein Standardbaustein moderner KI-Speicherarchitekturen.
Warum es in KI-Clustern zum Muss wird: Checkpoints in Tausender-GPU-Clustern bewegen sich schnell im Bereich mehrerer Dutzend TB, Trainingsdatensätze liegen im Hundert-TB-Bereich – der Durchsatz von Festplatten oder Hybrid-Arrays reicht nicht aus, um die GPUs zu füttern, und jede Sekunde, in der eine GPU auf Daten wartet, ist verbranntes Geld. NVMe-oF bringt die All-Flash-Performance ins Netzwerk (RDMA-Direktzugriff[1]), GPUDirect Storage nimmt die CPU aus dem Datenpfad – diese beiden Faktoren entscheiden, ob die Speicherschicht Beschleuniger oder Flaschenhals ist.
Dieser Eintrag ist ein Auswahl-Eintrag für die Produktkategorie : Behandelt Speicherarchitekturen aus AI-Cluster-Perspektive, Auswahlkriterien sowie Einkauf und Abnahme — nicht produktspezifisch. Für Speicher gibt es keinen einheitlichen Marktpreis; der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers.
Einsatzszenarien FIT
AIXX Index (0–100): gewichtete Schätzung der Szenenpassung. 90+ Flaggschiff-Niveau · 75+ Ausgezeichnet · 60+ brauchbar · unter 60 nicht geeignet.
Historie HISTORY
2011 : Veröffentlichung der NVMe-1.0-Spezifikation: SSDs direkt am PCIe-Bus, ein für Flash geborenes Protokoll verdrängt SAS/SATA-Pfade — das protokolltechnische Fundament der All-Flash-Arrays (öffentliche Branchenangaben).
2016–2020 , All-Flash-Arrays werden zum Mainstream: Die NVMe-oF-Spezifikation bringt NVMe ins Netzwerk (RDMA-Direktzugriff), All-Flash-Arrays von Anbietern wie Dell/NetApp/Pure werden zum neuen Standard im Enterprise-Speicher, und GPU-Cluster basieren zunehmend auf All-Flash als Speicherfundament (Branchenangaben[1]).
2020 : NVIDIA veröffentlicht GPUDirect Storage : Speicherdaten gelangen per RDMA direkt in den GPU-Speicher, ohne Umweg über die CPU (laut NVIDIA-Entwicklerblog und offizieller Dokumentation[2][3]) – die letzte Meile beim KI-Speicher ist geschlossen, das CUDA-Ökosystem legt ein weiteres Stück nach.
2023–2026 , Standard in KI-Clustern: Die Checkpoint- und Datendurchsatz-Anforderungen des Trainings großer Modelle schieben den Speicher ins Zentrum der Infrastruktur – „Objektspeicher (kalt) + All-Flash-Cache (heiß) + GPUDirect-Durchleitung“ als dreistufige KI-Speicher-Referenzarchitektur (laut Branchen-Referenzarchitektur[4]).
Auswahlparameter SELECTION GUIDE
| Parameter | Worauf achten | Erläuterung der Messgrößen |
|---|---|---|
| Durchsatz (GB/s) | Abgleich der aggregierten Lese-/Schreibbandbreite mit der GPU-Verbrauchsgeschwindigkeit | Rückrechnung des Speicherthroughputs aus dem „Cluster-Datenverbrauch pro Stunde“ mit 30 % Reserve (Schätzansatz) |
| IOPS und Latenz | Bei kleinen IOs (Checkpoint-Metadaten, KV-Cache-Tiering) zählen IOPS und P99-Latenz | Hoher Durchsatz ≠ niedrige Latenz — beide Lastarten getrennt betrachten |
| NVMe-oF-Unterstützung | Netzwerkerweiterung über RDMA-Transport (RoCE/IB) | Abgleich mit der Cluster-Fabric: IB-Netzwerk mit IB-RDMA, Ethernet mit RoCE |
| GPUDirect Storage | Stehen Speicherarray/Dateisystem auf der NVIDIA-GDS-Kompatibilitätsliste? | maßgeblich ist die offizielle Kompatibilitätsliste (laut NVIDIA-Dokumentation[3]) – für Lösungen außerhalb der Liste muss die Durchleitungsanbindung separat entwickelt werden |
| Paralleles Dateisystem | Lustre/GPFS-Familie/herstellerspezifische parallele Dateisysteme | Wenn mehrere GPU-Knoten denselben Datensatz parallel lesen, ist paralleler Durchsatz entscheidend |
| Kapazitäts-Tiering | Drei Ebenen: heiß (NVMe) / warm (Hybrid) / kalt (Objekt/Band) | All-Flash nur für heiße Daten — die Kapazitätskosten werden über Tiering gedrückt |
| Datenschutz | Erasure Coding/Replikate, Snapshots, standortübergreifende Disaster Recovery | Das Sicherheitsnetz für Trainingsdatensätze und Checkpoints — Ausgestaltung nach Datenwert |
Die Auswahlangaben basieren auf der Aufbereitung öffentlicher Architekturdokumentationen durch diese Datenbank (Stand 10/2026)[1][3][4]; maßgeblich sind die Produktdokumentation des Herstellers und tatsächliche Lasttests.
Dreistufige AI-Speicherarchitektur TIERING
| Ebene | Medium/Form | Inhalt | Kennzahlen |
|---|---|---|---|
| Heiße Ebene | NVMe-All-Flash-Array / verteiltes NVMe | Aktive Trainingsdatensätze, Checkpoints, KV-Cache-Tiering | Durchsatz + GPUDirect-Durchleitung |
| Warme Ebene | Hybrid-Flash / hochkapazitives NVMe | Aktuelle Datensatzversionen, Preprocessing-Zwischenprodukte | Kapazitäts-Kosten-Nutzen |
| Kalte Ebene | Objektspeicher / Band | Rohdaten-Lake, historische Archive | Kosten pro Kapazitätseinheit |
Die Drei-Schicht-Architektur basiert auf der Aufbereitung öffentlicher Referenzarchitekturen durch diese Datenbank[4]; die Schichtungsstrategie wird an den Lebenszyklus der Geschäftsdaten angepasst.
Ökosystem und Herstellerlandschaft VENDORS
Drei Spielertypen im AI-Speicher (eigene Zusammenfassung, keine Kaufermpfehlung):
| Lager | Vertreter | Positionierung und Merkmale |
|---|---|---|
| Enterprise-All-Flash-Arrays | Dell PowerStore/PowerScale, NetApp AFF, Pure FlashArray//FlashBlade, Huawei OceanStor, Inspur AS-Serie | Vollständige Enterprise-Datenschutz- und Betriebsstrukturen; AI-Eignung hängt von GPUDirect-Kompatibilität und parallelem Durchsatz ab (öffentliche Produktlinienangaben) |
| AI-nativer Speicher | VAST Data, WEKA, VDURA u. a. neue Generation paralleler Dateisysteme | Für GPU-Cluster gebaut: paralleles Dateisystem + NVMe-Tiering + tiefe GDS-Integration (laut Referenzarchitektur[4]) |
| Eigenbau/Open Source | Eigenlösungen wie Lustre, Ceph, JuiceFS | Bei sehr großen Clustern hohe Kontrolle durch Eigenbau; der Personalbedarf für den Betrieb ist der Kostenfaktor (öffentliche Ökosystemangaben) |
Herstellerinformationen sind eine Zusammenstellung öffentlicher Produktlinien; maßgeblich sind die offiziellen Angaben der jeweiligen Hersteller. Die SSD-Komponentenseite (Samsung/Solidigm/WD Enterprise-NVMe-Laufwerke) ist eine separate Lieferkette und beim Array-Kauf bereits enthalten.
Bildergalerie GALLERY
Fotos der Speicherhardware werden nach Prüflieferung nachgereicht; KI-generierte Bilder werden nicht als Echtbilder ausgegeben.
Deployment und Integration DEPLOYMENT
Dreipunkt-Checkliste für den Speicher-Go-Live: Fabric-Abgleich (Speichernetz und Compute-Fabric auf derselben Route: IB-Cluster mit IB-RDMA-Speichernetz, Ethernet mit RoCE — gemischte Routen erfordern Gateways und kosten Latenz wie Durchsatz); GDS-Anbindung (Komponenten gemäß offizieller NVIDIA-GDS-Dokumentation[3] installiert, unter der Voraussetzung, dass das Array auf der Kompatibilitätsliste steht); Stresstest und Einstufung (Durchsatztest mit realen Trainingslasten — Paper-Specs zählen nicht; ob die GPU warten muss, erfahren Sie nur aus dem Stresstest).
Betriebshinweis: Die Monitoring-Kennzahlen der Speicherschicht (Durchsatz/IOPS/P99-Latenz/Kapazitätsfüllstand) sollten auf einem Bildschirm mit dem GPU-Cluster-Monitoring laufen — die erste Anlaufstelle bei „auffällig niedriger GPU-Auslastung“ ist die Zuführgeschwindigkeit des Speichers (eigene Betriebserfahrung).
Beschaffung und Abnahme PROCUREMENT
Abnahmepunkte beim AI-Speichereinkauf (drei Punkte):
Vollständige Sechs-Punkte-Abnahmeurteile siehe in diesem Eintrag «Wie nimmt man ab?» dieses Eintrags.
Abnahme-Verfahren ACCEPTANCE TEST
Sechs Abnahmekriterien (Abnahmerahmen für AI-Speicher): Auspacken und Bestandsaufnahme → Basis-Durchsatz → GPUDirect-Durchleitung → Parallel-Lesen → Fehlerübungen → Langzeit-Abstimmung.
Versand & Auslieferung LOGISTICS
Glossarkarten GLOSSARY
NVMe
Ein für Flash entwickeltes Speicherprotokoll: SSDs direkt am PCIe-Bus, hohe Queue-Depth, niedrige Latenz – im Vergleich zu SAS/SATA holt das Protokoll die volle Flash-Geschwindigkeit heraus. NVMe SSDs sind die Grundbausteine von All-Flash-Arrays.
NVMe-oF
NVMe over Fabrics: bringt das NVMe-Protokoll ins Netzwerk (RDMA-Transport über IB oder RoCE) – Server greifen auf entfernte All-Flash-Arrays zu wie auf lokale Datenträger, mit minimalem Leistungsverlust (Branchenangaben[1]).
GPUDirect Storage(GDS)
NVIDIA-Technologie zur Speicher-Durchleitung: Daten gelangen von NVMe/Array per RDMA direkt in den GPU-Speicher, ohne Kopiervorgang über die CPU – eine Schlüsseltechnologie zur Effizienzsteigerung beim Trainingsdaten-Laden sowie beim Checkpoint-Schreiben und -Lesen (laut offizieller Dokumentation[3]).
Paralleles Dateisystem
Speicherarchitektur für parallelen Multi-Node-Zugriff auf dasselbe Dateisystem (Lustre/GPFS-Familie u. ä.): Daten werden auf mehrere Storage-Nodes gestrippt und die Durchsätze aggregiert – wenn tausend GPUs gleichzeitig das Trainingsset lesen, hält nur ein paralleles Dateisystem durch.
Checkpoint
Sicherungspunkte des Trainings: periodisches Schreiben von Modellgewichten plus Optimizer-Status auf den Speicher – Checkpoints großer Modelle bewegen sich im Zehn-TB-Bereich; zu langsames Schreiben bremst das Training, ein Verlust kostet den gesamten Fortschritt. Checkpoint-Durchsatz ist die erste Prüffrage für AI-Storage.
KV-Cache-Tiering
Lösung für knappen GPU-Speicher im Inferenzbetrieb: KV-Cache, der nicht mehr in den GPU-HBM passt, wandert auf die NVMe-Ebene – NVMe-Bandbreite ersetzt Speicherkapazität; eine Architekturkomponente für lange Kontexte und hohe Batch-Concurrency.
Grenzen & Kontroversen LIMITS
- Durchsatz-Illusion Der angegebene Herstellerdurchsatz gilt für Laborbedingungen – unter realen Trainingslasten (kleine gemischte IOs, Multi-Node-Concurrency) wird die Zielmarke oft halbiert; nur ein Benchmark mit echten Workloads zeigt die Wahrheit (Erfahrungswerte aus der Prüfung dieses Bestands).
- GDS-Kompatibilitätslücke : „NVMe-oF-Unterstützung“ ist nicht gleichzusetzen mit „Aufnahme in die NVIDIA-GDS-Kompatibilitätsliste“ – für Lösungen außerhalb der Liste muss die Durchleitungsanbindung selbst entwickelt werden; versteckte Kosten einplanen (laut offizieller Dokumentation[3]).
- Kostenfalle All-Flash-Kapazität Auch kalte Daten auf All-Flash zu legen ist ein Budget-Schlund – ein dreistufiges Tiering (Hot/Warm/Cold) ist Kostendisziplin; All-Flash dient ausschließlich heißen Daten (Erfassung dieses Bestands).
- Datenreste bei gebrauchten Storage-Arrays Die Datensicherheit der Vornutzung ist bei gebrauchten Arrays ein rechtliches Risiko – Nachweise über Secure Erase müssen als Transaktionsvoraussetzung gelten (Erfahrungswerte aus der Prüfung dieses Bestands).
- Vendor Lock-in Parallele Dateisysteme sind eng mit dem Management-Stack des Arrays verzahnt; ein Markenwechsel zur Halbzeit ist teuer – bei der Auswahl auch die „Schwierigkeit des Datenauszugs“ als Parameter bewerten (Erfassung dieses Bestands).
Marktlage MARKET NOTE
AI-Storage wird überwiegend projektförmig beschafft (große Unterschiede bei Konfiguration, Kapazität und Software-Stack), gebrauchte Arrays müssen zudem die Datensicherheitsprüfung bestehen – derzeit kein überprüfbarer, einheitlicher Marktdatensnapshot, Ehrlichkeitsprinzip dieser Datenbank: kein Marktdatenband; der Preis richtet sich nach dem tatsächlichen Angebot des Verkäufers 。
Angebotssuche: AIXX Markthalle › (Provisionsfreie Vermittlung, keine eigene Handelstätigkeit, keine Kenntnis und keine Vermutung von Abschlusspreisen – die Daten bleiben daher neutral). Sobald ausreichend Marktdaten vorliegen, wird dieser Abschnitt auf das Standard-Marktdatenband umgestellt.
Wichtige Preisereignisse MILESTONES
FAQ FAQ
Drei Unterschiede: Durchsatzgrößenordnung (das Füttern eines Tausend-GPU-Clusters ist ein Vielfaches normaler Enterprise-Lasten), Durchreichungsarchitektur (GPUDirect Storage umgeht die CPU), Concurrency-Muster (mehrere GPU-Nodes lesen denselben Datensatz parallel) – normales NAS oder Hybrid-Flash-Arrays kommen an diesen drei Punkten nicht mit.
Dringend empfohlen: Daten umgehen die CPU und erreichen direkt den GPU-Speicher, wodurch Latenz und CPU-Last beim Trainingsdaten-Laden und Checkpoint-Schreiben gleichermaßen sinken (laut offizieller Dokumentation); Lösungen ohne GDS laufen ebenfalls, aber der Durchsatz über die CPU hat eine niedrige Obergrenze und die Host-Ressourcen werden vom Datentransport aufgefressen.
Checkpoints großer Modelle bewegen sich im Zehn-TB-Bereich und werden häufig geschrieben: zu langsames Schreiben bremst das Training (GPUs warten aufs Speichern), ein Schreibabbruch kostet den gesamten Fortschritt – Checkpoint-Durchsatz und -Zuverlässigkeit trennen AI-Storage von gewöhnlichem Storage.
Ja, aber drei Hürden sind zu nehmen: Datensicherheit (Nachweis der Secure Erase der Vornutzung ist Transaktionsvoraussetzung), Gesundheit (vollständiger Export der Schreiblebensdauer/SMART-Werte der NVMe-Laufwerke), Lizenzen (wandern Kapazitäts- und Feature-Lizenzen mit der Hardware mit?). Storage ist das Zuhause der Daten – bei den Abnahmekriterien gilt: lieber strenger als nachsichtig.
Gleiche Technologie mit logischer Schichtung wird empfohlen: IB-Cluster mit IB-RDMA-Storage-Netz, Ethernet-Cluster mit RoCE – gemischte Technologien erfordern Gateway-Konvertierung und kosten Latenz wie Durchsatz. Auf Traffic-Ebene lassen sich Storage- und Compute-Netz physisch/logisch trennen, damit Checkpoint-Schreibvorgänge die Trainingskommunikation nicht beeinträchtigen.
Verwandte Einträge SEE ALSO
Auswahlvergleich und Weiterführendes COMPARE
Quellen REFERENCES
- Introl — AI-Optimized Storage: NVMe-oF, GPUDirect & Parallel File Systems (Architekturübersicht 2025) https://introl.com/blog/ai-optimized-storage-nvme-gpudirect-…
- NVIDIA Developer Blog — NVIDIA GPUDirect Storage (Ankündigung 2020) https://developer.nvidia.com/blog/gpudirect-storage/
- NVIDIA offizielle Dokumentation — GPUDirect Storage Overview Guide (Deployment- und Kompatibilitätsangaben) https://docs.nvidia.com/gpudirect-storage/overview-guide/ind…
- VDURA — AI Storage Reference Design (Angaben zur All-Flash-Referenzarchitektur) https://www.vdura.com/resources/reference-architecture/ai-st…
- Angebotsuche — AIXX Börse (provisionsfreie Vermittlung; für AI-Storage derzeit kein Marktsnapshot, der Preis richtet sich nach dem Angebot des Verkäufers) https://www.aixx.vip/hall.html