AIXX 백과사전 › 모델 항목 › MI350X / MI355X
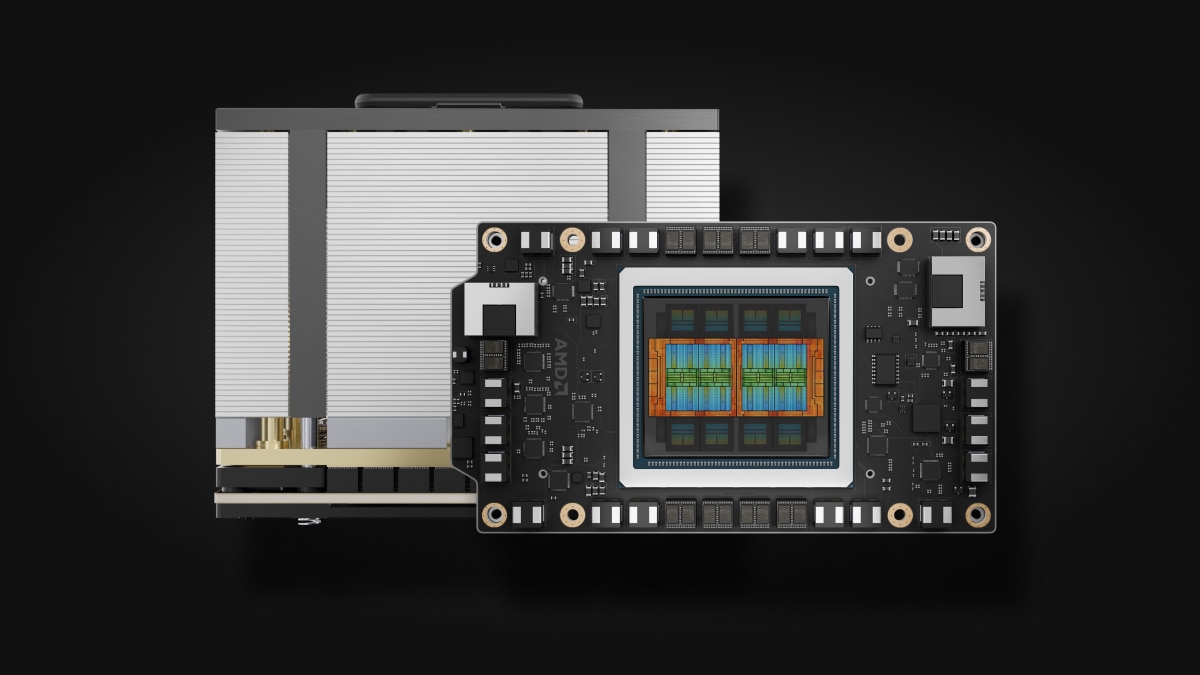
MI350X / MI355X
개요OVERVIEW
MI350X / MI355XAMD Instinct 시리즈의CDNA4 아키텍처 플래그십(2025년 6월 12일 출시): 카드당 288GB HBM3E 메모리, 8TB/s 대역폭, 3nm 공정의 185억 트랜지스터—듀얼 모델이 동일 칩을 사용하면서도 냉각과 전력 소비에서 차별화됩니다:MI350X 1000W 공랭 (Passive OAM)、MI355X 1400W 수랭 지원MXFP4 연산 성능은 각각 9.2/10.1 PFLOPS(AMD 공식 2페이지 사양표 기준[1]).
이 카드는 MI325X의 직계 후속 모델메모리는 동일하게 288GB 등급이지만 대역폭은 8TB/s(MI325X는 6TB/s), 아키텍처도 CDNA3에서 CDNA4로 승격, FP4/FP6 신규 정밀도 네이티브 지원까지 갖췄다. '1년에 한 세대'라는 메모리·아키텍처 동시 업그레이드 약속의 결실(AMD 공식 세대 기준[2]). 공식 B200 비교에 사용한 메모리 기준은 현행 180GB/7.7TB/s 등급이며, 288GB라는 용량 차이가 AMD 진영의 플래그십 셀링 포인트다(공식 비교 기준, 본 데이터베이스 B200 항목과 동일).
2026년 현물 시장에서 MI350 시리즈는 8카드 OAM 완제품으로 유통되며 공급이 증가하고 있습니다: ROCm 6.x+의 CDNA4 지원 매트릭스 성숙도, MI300X/MI325X 재고와의 가격 차이 관계가 구매 3대 질문의 핵심입니다. 본 항목은 시세 데이터를 포함하지 않습니다—가격은 판매자 실제 제시가 기준입니다.
적용 시나리오FIT
AIXX Index(0–100): 본 라이브러리는 공개 스펙 기반 가중 추정 — 메모리 40% + 상호연결 30% + 생태계 30%.
연혁HISTORY
2025년 6월 12일MI350X/MI355X 정식 출시(공식 Launch Date 기준[1]): CDNA4 아키텍처, 3nm, 185억 트랜지스터, 288GB HBM3E/8TB/s. MI325X(256GB/6TB/s) 대비 메모리와 대역폭이 한 단계 더 올라갔고, MXFP4/FP6 신규 정밀도도 네이티브 추가됐다.
2025-2026년듀얼 모델로 분화 출하: MI355X 수랭 형태(1400W/2400MHz)는 수랭 데이터센터와 상위 클라우드 사업자용, MI350X 공랭 OAM(1000W/2200MHz)은 공랭 AI 데이터센터를 커버. 서로 다른 데이터센터 환경을 이중 라인으로 대응한다(공식 2페이지 사양 기준[1]).
2026년, 현물 공급 증가: 8카드 OAM 완제품 유통 확대, ROCm 6.x+의 CDNA4 지원 매트릭스가 지속적으로 성숙—MI350 시리즈는 AMD 진영의 현역 플래그십이 되었습니다 (NVIDIA B300 세대와 비교). 국경 간 유통 정책은 여전히 진화 중이며, 구매 시에는 규제 기관의 정책과 전문가 의견을 기준으로 합니다 (공개 보도 기준).
기술 사양SPECIFICATIONS
| 항목 | MI350X | MI355X |
|---|---|---|
| 아키텍처 / 공정 | CDNA4 · TSMC 3nm · 185억 트랜지스터 | |
| 메모리 | 288GB HBM3E · 8TB/s (듀얼 모델 동일) | |
| 최대 클럭 | 2200 MHz | 2400 MHz |
| MXFP4 연산 성능 | 9.2 PFLOPS | 10.1 PFLOPS |
| 전력 소비 (TBP) | 1000W | 1400W |
| 냉각 | Passive OAM (공랭) | Passive & Active (수랭 지원) |
| 공통 사양 | Infinity Fabric 8 링크 · PCIe Gen5 · OAM 모듈 · SR-IOV | |
사양은 AMD 공식 2페이지 사양표 기준(2026-10 공식 스냅샷[1], C5/C6 두 세대 스카우트 교차 검증), Launch Date 2025/6/12는 공식 표기.
AMD 플래그십 3세대 동시 존재THREE GEN
| 항목 | MI300X | MI325X | MI350X/MI355X |
|---|---|---|---|
| 아키텍처 | CDNA3 | CDNA3 (파인튜닝) | CDNA4 |
| 메모리 | 192GB HBM3 | 256GB HBM3E | 288GB HBM3E |
| 대역폭 | 5.3TB/s | 6TB/s | 8TB/s |
| 새로운 정밀도 | FP8 | FP8 | MXFP4 / FP6 |
| 소비 전력 | 750W | 1000W | 1000W / 1400W |
| 선택 한 줄 요약 | 기존 재고 가성비 | 과도기 등급 | 현역 플래그십 |
3세대 비교는 각각의 공식 스냅샷 기준 (MI300X/MI325X는 각 항목 참조); CDNA4의 MXFP4/FP6는 새로운 정밀도 세대 기능입니다.
패밀리 라인업FAMILY
Instinct 제품군은 세대별로 등급이 나뉘며, MI350 시리즈는 CDNA4 현역 플래그십입니다:
냉각 및 배치COOLING
MI350 시리즈의 배포 경계는냉각 형태에 있습니다: MI350X는 Passive OAM 공랭 (1000W)으로 공랭 AI 컴퓨팅 센터에 도입 가능; MI355X는수랭(1400W), 수랭 데이터센터의 밀도 최적 선택. 8장 OAM 통합 시스템(UBB 기판)이 표준 출하 형태이며, 1000W/1400W×8=8-11kW급 랙 냉각과 전원 공급(54V 버스바)은 통합적으로 설계해야 한다(공식 2페이지 사양 기준[1]).
MI325X (동일 OAM)와의 배포 차이: CDNA4의 전력 밀도 상승으로 인해수랭이 선택 사항에서 MI355X의 필수 사항으로 변경되었습니다—공랭 데이터센터에서는 MI350X를, 수랭 데이터센터에서는 밀도에 따라 MI355X를 선택—「데이터센터 조건을 먼저 정한 후 모델을 결정」하는 선택 순서는 변하지 않습니다 (본 라이브러리 정리 기준).
모델 호환성MODEL FIT
| 모델 / 시나리오 | VRAM 요구 사항 | MI350 시리즈 배포 기준 | AIXX Index |
|---|---|---|---|
| DeepSeek R1 풀 스펙 (671B) | FP8 약 690GB | 8카드 2.3TB로 수용 가능하며 여유 충분—MXFP4 추론 경로는 ROCm 프레임워크 지원에 따름 | 88 |
| 초장문맥 추론 | KV cache는 길이에 비례 | 카드당 288GB의 KV 캐시 공간은 MI 시리즈 중 최대 | 91 |
| 대형 모델 학습 / 파인튜닝 | 8카드 IF 네트워킹 | CDNA4 훈련 스택은 ROCm의 성숙에 따름—튜닝 인건비를 계산에 포함 | 82 |
| FP64 HPC | 공식 스냅샷 기준 | CDNA4의 FP64 사양은 공식 사양표 기준—본 표에 미기재=미검증 | — |
메모리는 FP16 기준 파라미터 수 × 2바이트로 추정(추정 기준). FP4/FP6 경로는 ROCm 프레임워크의 실제 지원 여부 기준(공식 기준[1]).
갤러리GALLERY
소프트웨어와 에코시스템ECOSYSTEM
| 항목 | 요구 사항 / 현황 |
|---|---|
| 소프트웨어 스택 | ROCm 6.x+ (CDNA4 지원 매트릭스는 공식 문서 기준, ROCm 항목 기준과 동일) |
| 프레임워크 | PyTorch ROCm 버전 / vLLM / SGLang—MI350 시리즈 지원은 버전의 성숙에 따름 |
| 가상화 | SR-IOV 지원(공식 스펙 스냅샷 기준[1]) |
| 모니터링 | rocm-smi / amd-smi |
| 대조 | CUDA 생태계 대조는 ROCm 항목의 전환 프레임워크 참조 |
생태계 정보는 공개 기준 정리; 버전은 시간에 따라 진화하며 AMD 공식 발표를 따른다.
구매 및 검수PROCUREMENT
MI350 시리즈 구매 검수 포인트 (3가지):
검수 퀵 가이드QUICK CHECK
MI350 시리즈 4단계 빠른 점검:
운송과 납품LOGISTICS
용어 카드GLOSSARY
CDNA4와 MXFP4/FP6
AMD의 4세대 데이터센터 아키텍처: MXFP4/FP6 마이크로 스케일 부동 소수점 정밀도 추가—대규모 모델 추론의 메모리와 대역폭 비용을 추가로 절감 (NVIDIA의 FP4 경로와 비교), CDNA4가 CDNA3 대비 가지는 세대 기능 차이입니다.
MI350X vs MI355X
동일 칩 듀얼 모델: MI350X는 1000W 공랭 OAM(2200MHz/MXFP4 9.2PF), MI355X는 1400W 수랭 지원(2400MHz/MXFP4 10.1PF). 메모리는 공통 288GB/8TB/s이며, 데이터센터 냉각 환경과 밀도 요구에 따라 선택(공식 2페이지 기준[1]).
288GB HBM3E / 8TB/s
MI350 시리즈의 메모리 사양: 카드당 288GB, 전체 시스템 대역폭 8TB/s—MI 시리즈 「메모리 군비」 경로의 현역 정점 (MI325X 256GB/6TB/s, MI300X 192GB/5.3TB/s와 비교).
OAM과 UBB
OAM 모듈 + UBB 베이스보드의 8카드 완제품은 MI350 시리즈의 표준 출하 형태입니다—54V 전원 버스와 IF 상호 연결의 캐리어; 베이스보드에서 분리된 「단품 모듈」은 독립적으로 사용할 수 없습니다.
한계와 논쟁점LIMITS
- ROCm 생태계 전환 비용: 동일 MI 시리즈 프레임워크—CUDA 재고 파이프라인은 인건비(인월)로 총비용 계산 (ROCm 항목 기준), MI350 시리즈는 비교적 신제품이므로 CDNA4를 지원하는 프레임워크의 성숙도를 항목별로 검증해야 합니다.
- MI355X의 수랭 장벽: 1400W 전력 소비+수랭 형태—수랭 데이터센터의 개조 예산과 운영 능력이 선행 조건이며, 공랭 데이터센터에서는 MI350X를 선택 (본 라이브러리 정리 기준).
- 중고 시장 기준 미성립: MI350 시리즈는 2025년 중반에야 출하되어 중고 검수 실무 경험이 제한적입니다—메모리 건강 상태와 IF 링크 상태가 검수의 초점입니다 (본 라이브러리 검수 경험 기준).
- B200 비교 기준: AMD 공식 비교는 B200의 180GB/7.7TB/s 현재 기준을 사용합니다—진영 간 비교 시 양측의 각 기준 선택에 유의하세요 (본 라이브러리 정리 기준).
- 국경 간 유통 정책 변수: AMD 고급 카드 역시 규제 맥락에 놓여 있다(공개 보도 기준) — 국경 간 조달 컴플라이언스는 전문가 의견을 따르며, 본 라이브러리는 법적 의견을 구성하지 않는다.
시세 안내MARKET NOTE
MI350 시리즈는 주로 8카드 OAM 완제품으로 유통되며, 듀얼 모델+냉각 형태 차이로 인해 가격 이산도가 큽니다—현재 검증 가능한 통일된 시세 스냅샷이 없으며,본 백과의 정직 원칙: 시세 밴드를 만들지 않으며, 가격은 판매자 제시가 기준。
재고 검색: AIXX Exchange 쇼룸 ›(수수료 0% 매칭, 데이터는 이에 따라 중립적).
가격 주요 이벤트MILESTONES
자주 묻는 질문FAQ
데이터센터 냉각 조건이 모델을 결정합니다: 공랭 AI 컴퓨팅 센터는 MI350X (1000W 공랭 OAM)를; 수랭 데이터센터 또는 고밀도 요구는 MI355X (1400W 수랭, 더 높은 클럭과 MXFP4 연산 성능)를 선택—메모리는 동일 288GB/8TB/s.
신규 구매 예산이 충분하다면 MI350 시리즈를 선택: 아키텍처 세대 차이 (CDNA4의 MXFP4/FP6)+메모리 대역폭 (8TB/s vs 6TB/s); MI325X 재고는 가격 차이가 유리하지만 새로운 정밀도가 없습니다—훈련 파이프라인은 CDNA4를 직접 권장합니다.
FP8 기준으로 가능합니다: R1 풀 버전 FP8은 약 690GB로, 8카드 2.3TB 메모리에 수용 가능하며 여유도 충분합니다—추론 스택은 vLLM/SGLang의 ROCm 버전을 사용하며, 배포 전에 벤치마크 검증을 먼저 실행하세요.
4단계: rocm-smi 신원 확인 (모델/288GB/시리얼 번호) → 8TB/s 메모리 대역폭 실측 → 8카드 rccl-tests 인터커넥트 → 전력 등급별 풀 로드 번인 테스트 (MI355X 수랭은 수랭 절차에 따름). ROCm 지원 매트릭스 확인은 구매 전 필수 항목입니다.
생태계와 용량의 딜레마: MI350 시리즈의 288GB 메모리는 B200의 192GB급 (현재 기준)에 비해 우위이지만, B200은 CUDA 생태계를 기반으로 합니다—오픈소스 스택 신규 파이프라인은 MI350 시리즈를 평가할 수 있으며, CUDA 재고 파이프라인 마이그레이션은 총비용으로 계산하세요 (ROCm 항목 프레임워크).
관련 항목SEE ALSO
모델 비교 및 선택COMPARE
참고 자료REFERENCES
- AMD 공식 웹사이트 — Instinct MI350X 제품 페이지 (공식 듀얼 페이지 사양표, C6 공식 스냅샷 기준 2026-10) https://www.amd.com/en/products/accelerators/instinct/mi350/…
- AMD 공식 웹사이트 — Instinct MI355X 제품 페이지 (수랭 고급형 기준) https://www.amd.com/en/products/accelerators/instinct/mi350/…
- MI355X 예고 및 MI350P PCIe 변형 보도 (제3자 교차) https://www.servethehome.com/
- AMD 공식 문서 — ROCm 문서 사이트(지원 매트릭스 기준) https://rocm.docs.amd.com/
- 판매 검색 — AIXX 거래소 (수수료 0% 매칭; MI350 시리즈는 현재 시세 스냅샷 없음, 가격은 판매자 제시가 기준) https://www.aixx.vip/hall.html?model=MI350