AIXX 百科 › 機種項目 › MI350X / MI355X
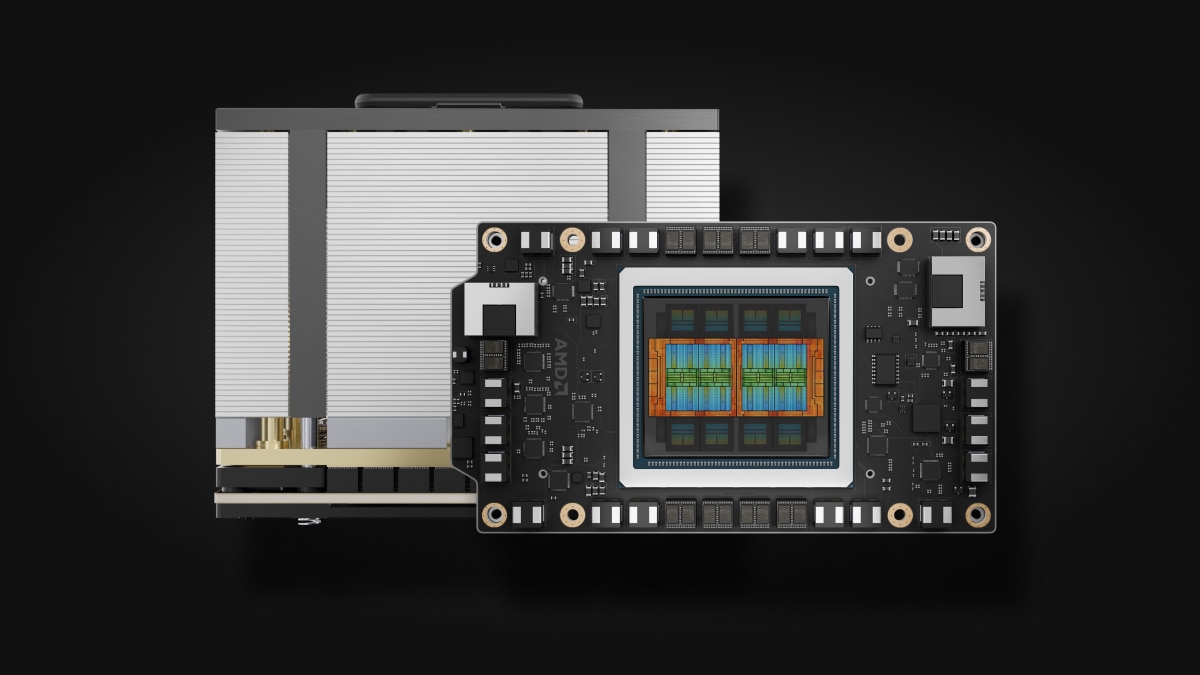
MI350X / MI355X
概要OVERVIEW
MI350X / MI355XAMD Instinct 系のCDNA4 アーキテクチャのフラッグシップ(2025 年 6 月 12 日発表):288GB HBM3E の 1 枚あたり搭載メモリ、8TB/s の帯域幅、185 億トランジスタの 3nm プロセス——両モデルは同一ダイで、冷却と消費電力に差がつく構成:MI350X 1000W 空冷(Passive OAM)、MI355X 1400W 液冷対応、MXFP4 演算性能はそれぞれ 9.2/10.1 PFLOPS(AMD 公式2ページ仕様書の数値[1])。
GB300 世代サーバーの MI325X の直系後継:メモリは同じく 288GB クラスながら帯域幅が 8TB/s(MI325X は 6TB/s)、アーキテクチャは CDNA3 から CDNA4 へ刷新、FP4/FP6 の新精度をネイティブサポート——「一年ごとの世代交代」におけるメモリとアーキテクチャの同時進化を果たした作品(AMD 公式世代区分の数値[2])。公式が B200 と比較する際に用いるメモリスペックは現行の 180GB/7.7TB/s クラス——288GB の容量差が AMD 阵営のフラッグシップにおける強み(公式比較基準の数値、当データベースの B200 項目と同様)。
2026 年の現物市場では、MI350 シリーズは 8 基搭載 OAM システムで流通し、供給が拡大中:ROCm 6.x+ の CDNA4 サポートマトリクスの成熟度、MI300X/MI325X 在庫との価格差が調達判断の三本柱。本項目は相場帯を掲載しない——価格は出品者の提示価格によります。
適用シーンFIT
AIXX Index(0–100):本データベースは公開スペックに基づく加重推定——メモリ 40% + インターコネクト 30% + エコシステム 30%。
沿革HISTORY
2025 年 6 月 12 日、MI350X/MI355X 正式発表(公式 Launch Date の数値[1]):CDNA4 アーキテクチャ、3nm、185 億トランジスタ、288GB HBM3E/8TB/s——メモリと帯域幅は MI325X(256GB/6TB/s)からさらに一段上へ、MXFP4/FP6 の新精度もネイティブ対応。
2025〜2026 年、2モデルに分かれた展開:MI355X 液冷モデル(1400W/2400MHz)は液冷データセンターや大手クラウド事業者向け、MI350X 空冷 OAM(1000W/2200MHz)は空冷AIデータセンターをカバー——異なるデータセンター環境に両ラインで対応(公式2ページ仕様の数値[1])。
2026 年、現物供給拡大:8 基 OAM システムの流通量が増加し、ROCm 6.x+ の CDNA4 サポートマトリクスも継続的に成熟——MI350 シリーズは AMD 陣営の現役フラッグシップに(NVIDIA B300 世代との比較)。越境流通の政策は依然変化中であり、調達時は主管部門の政策と専門意見を参照(公開報道基準)。
技術仕様SPECIFICATIONS
| 項目 | MI350X | MI355X |
|---|---|---|
| アーキテクチャ / プロセス | CDNA4 · TSMC 3nm · 185 億トランジスタ | |
| メモリ | 288GB HBM3E · 8TB/s(両モデル共通) | |
| ピーククロック | 2200 MHz | 2400 MHz |
| MXFP4 演算性能 | 9.2 PFLOPS | 10.1 PFLOPS |
| 消費電力(TBP) | 1000W | 1400W |
| 冷却 | Passive OAM(空冷) | Passive & Active(液冷対応) |
| 共通仕様 | Infinity Fabric 8 リンク · PCIe Gen5 · OAM モジュール · SR-IOV | |
スペックは AMD 公式2ページ仕様書に準拠(2026-10 公式数値スナップショット[1]、C5/C6 の2世代リサーチ担当によるクロスチェック);Launch Date 6/12/2025 は公式表記。
AMD フラッグシップ 3 世代THREE GEN
| 項目 | MI300X | MI325X | MI350X/MI355X |
|---|---|---|---|
| アーキテクチャ | CDNA3 | CDNA3(微調整) | CDNA4 |
| メモリ | 192GB HBM3 | 256GB HBM3E | 288GB HBM3E |
| 帯域幅 | 5.3TB/s | 6TB/s | 8TB/s |
| 新精度 | FP8 | FP8 | MXFP4 / FP6 |
| 消費電力 | 750W | 1000W | 1000W / 1400W |
| 選定を一言で | 既存在り・コスパ重視 | 過渡期 | 現役フラッグシップ |
3 世代比較はそれぞれの公式スナップショット基準(MI300X/MI325X の詳細は各項目参照);CDNA4 の MXFP4/FP6 は新精度の世代的能力。
ファミリー構成FAMILY
Instinct ファミリーは世代別に区分。MI350 シリーズは CDNA4 の現役フラッグシップ:
冷却と導入COOLING
MI350 シリーズの導入分岐点は冷却形態:MI350X は Passive OAM 空冷(1000W)で、空冷 AI データセンターに導入可能;MI355X は液冷(1400W)、液冷データセンターでの密度最適解。8枚構成 OAM システム(UBB 基板)が標準提供形態——1000W/1400W×8=8〜11kW クラスのラック冷却と給電(54V バスバー)は全体設計が必要(公式2ページ仕様の数値[1])。
MI325X(同じく OAM)との導入差分:CDNA4 の消費電力密度の上昇により、液冷は選択肢から MI355X の必須要件へ——空冷施設なら MI350X、液冷施設は密度に応じて MI355X を。「先に施設条件を確定してからモデルを選ぶ」選定手順は不変(当ライブラリ整理基準)。
モデル対応MODEL FIT
| モデル / シナリオ | VRAM 要件 | MI350 シリーズ導入の基準 | AIXX Index |
|---|---|---|---|
| DeepSeek R1 フルスペック(671B) | FP8 約 690GB | 8 基で 2.3TB となり余裕を持って収容可能——MXFP4 推論パスは ROCm フレームワークのサポートに伴い | 88 |
| 超ロングコンテキスト推論 | KV cache は長さに比例 | 288GB シングルカードの KV cache 空間は MI シリーズ最大 | 91 |
| 大規模モデル トレーニング / ファインチューニング | 8 基 IF ネットワーク | CDNA4 学習スタックは ROCm と共に成熟——チューニングの人件費を算入 | 82 |
| FP64 HPC | 公式スナップショットによる | CDNA4 の FP64 基準は公式仕様表による——本表未記載=未検証 | — |
メモリは FP16 重みで ≈ パラメータ数 × 2 バイトと概算(推定の数値);FP4/FP6 対応は ROCm フレームワークの実際のサポート状況に準じる(公式の数値[1])。
ギャラリーGALLERY
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| ソフトウェアスタック | ROCm 6.x+(CDNA4 サポートマトリクスは公式ドキュメントによる。ROCm 項目と同一基準) |
| フレームワーク | PyTorch ROCm 版 / vLLM / SGLang——MI350 シリーズ対応はバージョンと共に成熟 |
| 仮想化 | SR-IOV対応(公式スペック_snapshot の情報による[1]) |
| モニタリング | rocm-smi / amd-smi |
| 比較 | CUDA エコシステムとの比較は ROCm 項目の移行フレームワークを参照 |
エコシステム情報は公開情報に基づく整理;バージョンは時間とともに変化するため、AMD 公式発表によるものとする。
調達と検品PROCUREMENT
MI350 シリーズ調達の検収ポイント(三項目):
検収クイックリファレンスQUICK CHECK
MI350 シリーズ 4 ステップ簡易チェック:
輸送と納品LOGISTICS
用語カードGLOSSARY
CDNA4 と MXFP4/FP6
AMD 第 4 世代データセンターアーキテクチャ:MXFP4/FP6 の微縮浮動小数点精度を新規追加——大規模モデル推論のメモリ・帯域幅コストを一段引き下げ(NVIDIA の FP4 路線との比較)、CDNA4 の CDNA3 に対する世代的能力差。
MI350X vs MI355X
同一チップの2モデル:MI350X は 1000W 空冷 OAM(2200MHz/MXFP4 9.2PF)、MI355X は 1400W 液冷対応(2400MHz/MXFP4 10.1PF)——メモリはいずれも 288GB/8TB/s、データセンターの冷却条件と密度要件に応じて選定(公式2ページの数値[1])。
288GB HBM3E / 8TB/s
MI350 シリーズのメモリ仕様:シングルカード 288GB、システム全体の帯域幅 8TB/s——MI シリーズ「メモリ軍拡」路線の現役頂点(MI325X 256GB/6TB/s、MI300X 192GB/5.3TB/s との比較)。
OAM と UBB
OAM モジュール + UBB ベースの 8 基システムが MI350 シリーズの標準出荷形態——54V 給電バスバーと IF インターコネクトの担い手。ベースから外れた「バラモジュール」は単独では使用不可。
限界と論点LIMITS
- ROCm エコシステムの移行コスト:MI シリーズ共通のフレームワーク——CUDA 在庫パイプラインは人月で総コスト算出(ROCm 項目基準)。MI350 シリーズは比較的新しく、CDNA4 対応フレームワークの成熟度は項目ごとに検証が必要。
- MI355X の液冷ハードル:1400W 消費電力+液冷形態——液冷サーバールームの改造予算と運用能力が前提条件。空冷施設なら MI350X を(当ライブラリ整理基準)。
- 中古市場の価格基準が未成熟:MI350 シリーズは 2025 年半ばに流通開始したばかりで、中古検収の実践経験の蓄積が限定的——メモリの健康状態と IF リンク状態が検収重点(当ライブラリ検収経験基準)。
- B200 対標の基準:AMD 公式の対標は B200 の 180GB/7.7TB/s 現行基準を使用——陣営横断比較では双方の基準選択に注意(当ライブラリ整理基準)。
- 越境流通の政策変数:AMD のハイエンドカードも規制の文脈にある(公開報道基準)——越境調達のコンプライアンスは専門家の意見によるものとし、本データベースは法的意見を構成しない。
相場情報MARKET NOTE
MI350 シリーズは 8 基 OAM システムでの流通が中心で、2 モデル+冷却形態の差により価格のばらつきが大きい——現時点で検証可能な統一相場スナップショットなし、本ライブラリの誠実さの原則:相場帯を設けず、価格は出品者の実際の提示価格によります。
販売検索:AIXX 取引所ロビー ›(手数料ゼロのマッチング、データは中立)。
価格イベント年表MILESTONES
よくある質問FAQ
サーバールームの冷却条件でモデル決定:空冷 AI データセンターなら MI350X(1000W 空冷 OAM);液冷サーバールームや高密度ニーズなら MI355X(1400W 液冷、クロックと MXFP4 演算性能がより高い)——メモリは共に 288GB/8TB/s。
新規購入で予算に余裕があれば MI350 シリーズ:アーキテクチャの世代差(CDNA4 の MXFP4/FP6)+メモリ帯域幅(8TB/s 対 6TB/s);MI325X 在庫は価格差が優位だが新精度なし——学習パイプラインは CDNA4 を直接推奨。
FP8 基準なら可能:R1 フル版 FP8 は約 690GB、8 基 2.3TB のメモリに余裕を持って収容——推論スタックは vLLM/SGLang の ROCm 版、デプロイ前にベンチマーク検証を実施を。
4 ステップ:rocm-smi による識別(モデル/288GB/シリアル番号)→ 8TB/s メモリ帯域幅の実測 → 8 基 rccl-tests のインターコネクト → 電力階級別フルロードでの焼き込みテスト(MI355X 液冷は液冷フローによる)。ROCm サポートマトリクスの確認は調達の前提事項。
エコシステムと容量のジレンマ:MI350 シリーズの 288GB メモリは B200 の 192GB クラス(現行基準)に対し優位だが、B200 は CUDA エコシステムに支えられる——オープンソーススタックの新規パイプラインなら MI350 シリーズを評価可能、CUDA 在庫パイプラインの移行は総コストで判断(ROCm 項目フレームワーク)。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- AMD 公式サイト — Instinct MI350X 製品ページ(公式 2 ページ仕様表、C6 公式スナップショット 2026-10) https://www.amd.com/en/products/accelerators/instinct/mi350/…
- AMD 公式サイト — Instinct MI355X 製品ページ(液冷高仕様基準) https://www.amd.com/en/products/accelerators/instinct/mi350/…
- MI355X 予告と MI350P PCIe 変種の報道(第三者クロスチェック) https://www.servethehome.com/
- AMD 公式ドキュメント — ROCm ドキュメントサイト(対応マトリクスの情報) https://rocm.docs.amd.com/
- 在庫検索 — AIXX 取引所(手数料ゼロのマッチング;MI350 シリーズは現時点で相場スナップショットなし、価格は出品者の提示価格によります) https://www.aixx.vip/hall.html?model=MI350