AIXX Pedia › Fiche modèle › MI350X / MI355X
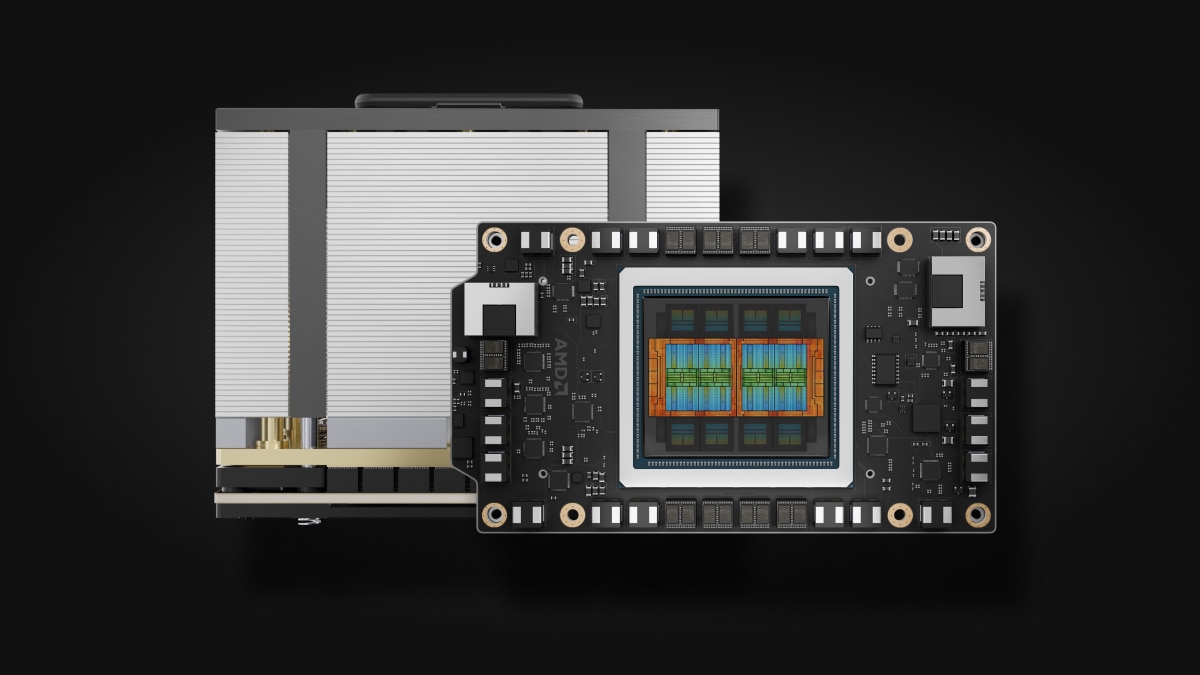
MI350X / MI355X
Vue d'ensemble OVERVIEW
MI350X / MI355X C'est la Le fleuron de l'architecture CDNA4 (Annoncés le 12 juin 2025) : 288 Go de mémoire HBM3E par carte, 8 To/s de bande passante, 185 milliards de transistors gravés en 3 nm — les deux modèles partagent la même puce et se distinguent par le refroidissement et la consommation : MI350X 1000 W refroidi par air (Passive OAM) 、 MI355X 1400 W avec prise en charge du refroidissement par liquide ,La puissance de calcul MXFP4 est respectivement de 9.2/10.1 PFLOPS (selon la fiche technique officielle AMD en deux pages[1]).
C'est le Le successeur direct du MI325X : mémoire vidéo dans la même gamme de 288 Go mais avec une bande passante de 8 To/s (le MI325X étant à 6 To/s), passage de l'architecture CDNA3 à CDNA4, prise en charge native des nouvelles précisions FP4/FP6 — l'aboutissement d'un cycle « une génération par an » avec double mise à niveau mémoire et architecture (selon la nomenclature officielle des générations AMD[2]). Pour la comparaison officielle face au B200, AMD retient la configuration mémoire actuelle de 180 Go/7,7 To/s — l'écart de capacité vers 288 Go constitue l'argument phare du camp AMD (base de comparaison officielle, identique à l'entrée B200 de cette base de connaissances).
Sur le marché du spot en 2026, la gamme MI350 circule principalement en machines 8 cartes OAM, en montée en volume : la maturité de la matrice de support ROCm 6.x+ pour CDNA4 et l'écart de prix avec le parc MI300X/MI325X existant sont au cœur des trois questions d'achat. Cette fiche ne publie pas de fourchette de marché — le prix réel est soumis au devis du vendeur.
Cas d'usage FIT
AIXX Index (0–100) : estimation pondérée par cette base à partir des spécifications publiques — mémoire 40 % + interconnexion 30 % + écosystème 30 %.
Historique HISTORY
Le 12 juin 2025 , lancement officiel des MI350X/MI355X (date officielle de lancement[1]) : architecture CDNA4, gravure 3 nm, 185 milliards de transistors, 288 Go de HBM3E/8 To/s — un nouveau palier en mémoire et bande passante par rapport au MI325X (256 Go/6 To/s), avec ajout natif des nouvelles précisions MXFP4/FP6.
2025-2026 , livraison différenciée en deux modèles : le MI355X en version refroidi par liquide (1400 W/2400 MHz) pour les salles liquides et les grands fournisseurs de cloud, le MI350X en OAM refroidi par air (1000 W/2200 MHz) pour les centres de calcul IA à air — double ligne couvrant des conditions de salle différentes (fiche officielle en deux pages[1]).
En 2026 , montée en volume sur le spot : circulation croissante des machines 8 cartes OAM, matrice de support ROCm 6.x+ pour CDNA4 en maturation continue — la gamme MI350 devient le fleuron en activité du camp AMD (face à la génération NVIDIA B300). Les politiques de circulation transfrontalière évoluent encore ; pour tout achat, se référer aux politiques des autorités compétentes et à un avis professionnel (selon les sources publiques).
Spécifications techniques SPECIFICATIONS
| Élément | MI350X | MI355X |
|---|---|---|
| Architecture / gravure | CDNA4 · TSMC 3nm · 185 milliards de transistors | |
| Mémoire vidéo | 288 Go HBM3E · 8 To/s (identique sur les deux modèles) | |
| Fréquence crête | 2200 MHz | 2400 MHz |
| Puissance MXFP4 | 9.2 PFLOPS | 10.1 PFLOPS |
| Consommation (TBP) | 1000W | 1400W |
| Refroidissement | Passive OAM (refroidi par air) | Passive & Active (refroidissement par liquide pris en charge) |
| Spécifications communes | Infinity Fabric 8 liens · PCIe Gen5 · modules OAM · SR-IOV | |
Les spécifications font foi selon la fiche technique officielle AMD en deux pages (instantané officiel d'octobre 2026[1], vérification croisée par les éclaireurs des générations C5/C6) ; la date de lancement du 12/06/2025 est la mention officielle.
Trois générations de fleurons AMD côte à côte THREE GEN
| Élément | MI300X | MI325X | MI350X/MI355X |
|---|---|---|---|
| Architecture | CDNA3 | CDNA3 (ajusté) | CDNA4 |
| Mémoire vidéo | 192GB HBM3 | 256GB HBM3E | 288GB HBM3E |
| Bande passante | 5.3TB/s | 6TB/s | 8TB/s |
| Nouvelles précisions | FP8 | FP8 | MXFP4 / FP6 |
| TDP | 750W | 1000W | 1000W / 1400W |
| Recommandation en une phrase | Rapport performance/prix en stock | Palier de transition | Fleuron en activité |
La comparaison des trois générations repose sur leurs instantanés officiels respectifs (MI300X/MI325X : voir leurs fiches) ; MXFP4/FP6 sur CDNA4 constitue la capacité de nouvelle génération en précision.
Membres de la famille FAMILY
La famille Instinct se décline par génération ; la gamme MI350 est le fleuron CDNA4 en activité :
Refroidissement et déploiement COOLING
La ligne de déploiement de la gamme MI350 se situe au niveau de la forme de refroidissement : le MI350X est un Passive OAM refroidi par air (1000 W), déployable dans les centres de calcul IA refroidis par air ; le MI355X prend en charge le refroidissement par liquide (1400 W), le choix privilégié pour la densité des salles refroidies par liquide. Le serveur 8 cartes OAM (plateforme UBB) est la forme de livraison standard — la dissipation et l'alimentation en baie de l'ordre de 1000 W/1400 W × 8 = 8-11 kW (bus 54 V) doivent être planifiées globalement (fiche officielle en deux pages[1]).
Différences de déploiement avec le MI325X (lui aussi en OAM) : la densité de puissance de CDNA4 fait que le refroidissement par liquide passe d'option à obligation pour le MI355X — salles refroidies par air : MI350X ; salles liquides : MI355X selon la densité — l'ordre de sélection « d'abord les conditions de salle, ensuite le modèle » reste inchangé (selon cette base).
Compatibilité des modèles MODEL FIT
| Modèle / scénario | Besoin en VRAM | Repères de déploiement de la gamme MI350 | AIXX Index |
|---|---|---|---|
| DeepSeek R1 complet (671B) | environ 690 Go en FP8 | 2,3 To sur 8 cartes suffisent avec une bonne marge — chemin d'inférence MXFP4 via le support ROCm | 88 |
| Inférence à contexte ultra-long | KV cache croissant linéairement avec la longueur | L'espace de KV cache par carte de 288 Go est le plus grand de la gamme MI | 91 |
| Entraînement / fine-tuning de grands modèles | Maillage IF 8 cartes | La pile d'entraînement CDNA4 murit avec ROCm — comptabiliser le coût en ingénierie de tuning | 82 |
| FP64 HPC | Se référer à l'instantané officiel | Les chiffres FP64 de CDNA4 selon la fiche officielle — absent du tableau = non vérifié | — |
La mémoire vidéo est estimée selon FP16 poids ≈ nombre de paramètres × 2 octets (estimation) ; les chemins FP4/FP6 dépendent de la prise en charge effective par le framework ROCm (selon les données officielles[1]).
Galerie GALLERY
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| Stack logicielle | ROCm 6.x+ (la matrice de support CDNA4 selon la documentation officielle, comme pour la fiche ROCm) |
| Frameworks | PyTorch ROCm / vLLM / SGLang — le support de la gamme MI350 mûrit au fil des versions |
| Virtualisation | Prise en charge SR-IOV (d'après les spécifications officielles[1]) |
| Observabilité | rocm-smi / amd-smi |
| Comparaison | Pour le comparatif avec l'écosystème CUDA, voir le cadre de migration de la fiche ROCm |
Informations écosystème compilées à partir de sources publiques ; les versions évoluent dans le temps, faire foi : les publications officielles AMD.
Achat et réception PROCUREMENT
Les trois points de contrôle à la réception d'un achat de la gamme MI350 :
Aide-mémoire de réception QUICK CHECK
Vérification de la gamme MI350 en quatre étapes :
Transport et livraison LOGISTICS
Fiches terminologie GLOSSARY
CDNA4 et MXFP4/FP6
Quatrième architecture datacenter d'AMD : ajout des précisions en virgule flottante micro-échelle MXFP4/FP6 — réduction supplémentaire du coût mémoire et bande passante de l'inférence de grands modèles (en regard de la voie FP4 de NVIDIA), c'est l'écart générationnel de CDNA4 face à CDNA3.
MI350X vs MI355X
Deux modèles sur la même puce : MI350X 1000 W OAM refroidi par air (2200 MHz/MXFP4 9,2 PF), MI355X 1400 W avec refroidissement par liquide (2400 MHz/MXFP4 10,1 PF) — mémoire identique de 288 Go/8 To/s, le choix se fait selon les conditions de refroidissement de la salle et les besoins de densité (fiche officielle en deux pages[1]).
288GB HBM3E / 8TB/s
Spécifications mémoire de la gamme MI350 : 288 Go par carte, 8 To/s de bande passante système — le sommet actuel de la voie « course à la mémoire » de la gamme MI (face au MI325X 256 Go/6 To/s et au MI300X 192 Go/5,3 To/s).
OAM et UBB
La machine 8 cartes composée de modules OAM + board UBB est la forme de livraison standard de la gamme MI350 — le support de l'alimentation 54 V et de l'interconnexion IF ; un « module nu » séparé de sa board n'est pas utilisable seul.
Limites et controverses LIMITS
- L'addition de la migration vers l'écosystème ROCm Migration : comme le reste de la gamme MI — les pipelines CUDA existants se comptent en hommes-mois (selon la fiche ROCm) ; la gamme MI350 étant récente, la maturité de chaque framework supportant CDNA4 doit être vérifiée point par point.
- Le seuil du refroidissement par liquide du MI355X : 1400 W + forme liquide — le budget de transformation de la salle liquide et les capacités d'exploitation sont des prérequis ; les salles refroidies par air choisiront le MI350X (selon cette base).
- L'étalon du marché de l'occasion n'est pas encore formé : la gamme MI350 n'est distribuée que depuis mi-2025, le retour d'expérience de contrôle sur l'occasion reste limité — la santé de la mémoire et l'état des liens IF sont les points clés du contrôle (selon l'expérience de cette base).
- La base de comparaison face au B200 : AMD se compare officiellement aux chiffres actuels du B200, 180 Go/7,7 To/s — attention au choix de base de chacun dans les comparaisons inter-camps (selon cette base).
- Variable des politiques transfrontalières : les cartes haut de gamme d'AMD sont également visées par le cadre de contrôle (couverture publique) — pour la conformité des achats transfrontaliers, s'en remettre à un avis professionnel ; cette base ne constitue pas un avis juridique.
Notes de marché MARKET NOTE
La gamme MI350 circule surtout en machines 8 cartes OAM ; la différenciation des deux modèles et des formes de refroidissement entraîne une forte dispersion des prix — pas d'instantané de marché uniforme et vérifiable pour l'instant, Principe d'honnêteté de cette fiche : pas de bande de marché, le prix est soumis au devis réel du vendeur 。
Recherche des offres : AIXX Exchange Hall › (mise en relation sans commission, d'où la neutralité des données).
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Les conditions de refroidissement de la salle déterminent le modèle : centre de calcul IA refroidi par air → MI350X (1000 W, OAM refroidi par air) ; salle liquide ou besoins de haute densité → MI355X (1400 W liquide, fréquences et puissance MXFP4 supérieures) — même mémoire de 288 Go/8 To/s.
Avec un budget suffisant pour du neuf, choisir la gamme MI350 : écart d'architecture (MXFP4/FP6 sur CDNA4) + bande passante mémoire (8 To/s contre 6 To/s) ; l'écart de prix du parc MI325X existant est attractif mais sans nouvelles précisions — pour un pipeline d'entraînement, CDNA4 directement.
Oui en FP8 : R1 complet en FP8 pèse environ 690 Go, ce qui tient avec une bonne marge dans les 2,3 To des 8 cartes — stack d'inférence vLLM/SGLang en version ROCm, avec un benchmark de validation avant déploiement.
Quatre étapes : identification rocm-smi (modèle/288 Go/numéro de série) → mesure de bande passante mémoire 8 To/s → interconnexion 8 cartes via rccl-tests → burn-in en pleine charge selon le palier de consommation (procédure liquide pour le MI355X). La vérification de la matrice de support ROCm est un préalable à l'achat.
Le dilemme écosystème vs capacité : les 288 Go de la gamme MI350 l'emportent sur les ~192 Go du B200 (chiffres actuels), mais le B200 s'appuie sur l'écosystème CUDA — les nouveaux pipelines open source peuvent évaluer la gamme MI350, la migration des pipelines CUDA existants se chiffre en coût global (cadre de la fiche ROCm).
Fiches liées SEE ALSO
Comparaison et choix de machines COMPARE
Références REFERENCES
- Site officiel AMD — page produit Instinct MI350X (fiche officielle des deux modèles, instantané officiel C6 d'octobre 2026) https://www.amd.com/en/products/accelerators/instinct/mi350/…
- Site officiel AMD — page produit Instinct MI355X (version haute refroidie par liquide) https://www.amd.com/en/products/accelerators/instinct/mi350/…
- Annonce du MI355X et reportage sur la variante PCIe MI350P (source tierce, contre-vérifiée) https://www.servethehome.com/
- Documentation officielle AMD — Site de documentation ROCm (matrice de prise en charge) https://rocm.docs.amd.com/
- Recherche de ventes — Bourse AIXX (mise en relation sans commission ; pas d'instantané de marché pour la gamme MI350, le prix réel est soumis au devis du vendeur) https://www.aixx.vip/hall.html?model=MI350