AIXX Pedia › Ficha de modelo › H200 NVL
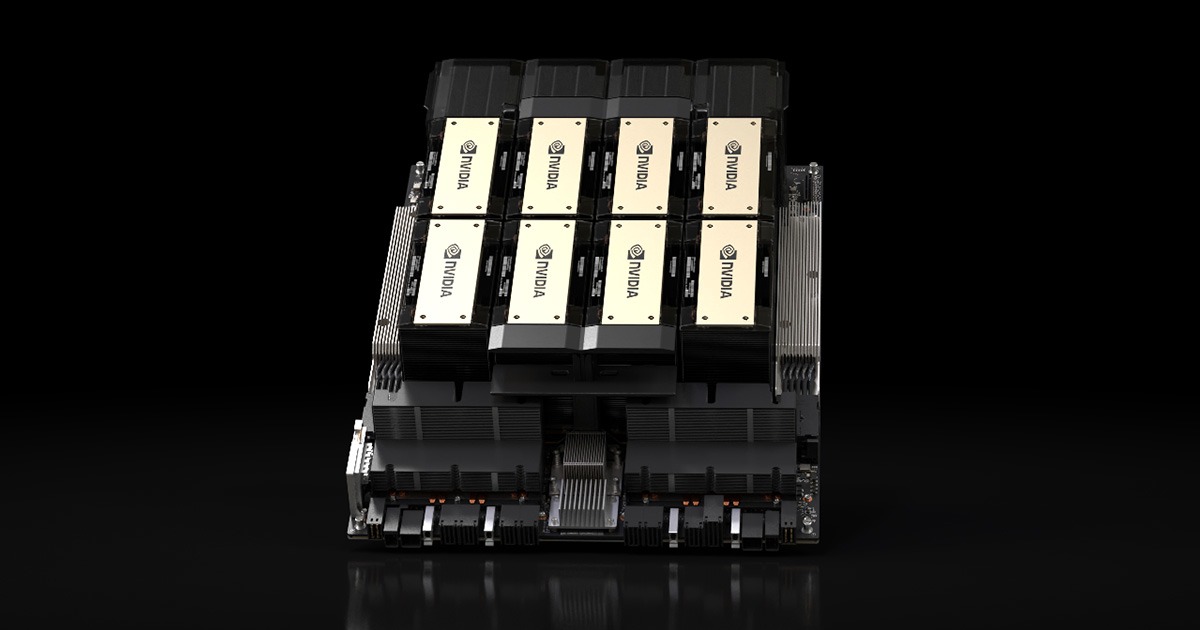
H200 NVL
Visão geral OVERVIEW
H200 NVL é a variante do NVIDIA H200 Formato PCIe de duplo slot refrigerado a ar : 141GB de memória HBM3e por placa, FP8 com 3.341 TFLOPS, FP64 Tensor com 60 TFLOPS, consumo configurável até 600W, NVLink bridge 2/4-way a 900GB/s — o suporte a Confidential Computing é o seu cartão de visitas corporativo (conforme a captura oficial de especificações [1]).
Relação com a versão em baseboard HGX H200 (SXM): mesmo chip, formatos diferentes — a versão NVL é uma placa PCIe de dois slots refrigerada a ar (plug-and-play em servidores rack/torre), enquanto a versão em baseboard HGX é um sistema completo SXM refrigerado a líquido/ar (4/8 GPUs com NVLink full mesh). Para compradores: a barreira de implantação PCIe é um nível mais baixa ——não requer um chassi dedicado; instala-se diretamente em um servidor x86 padrão (conforme a captura oficial de especificações [1]).
Comparação com a H100 NVL: memória de 141GB contra 94GB (+50%), largura de banda de 4,8TB/s contra 3,9TB/s, FP8 igual em 3.341 TFLOPS — o H200 NVL é a evolução direta do H100 NVL em memória , a escolha de melhor custo-benefício para cenários de inferência (conforme o comparativo oficial [1]). Esta entrada não traz tabela de cotações — o preço real está sujeito à cotação do vendedor.
Cenários de uso FIT
AIXX Index (0–100): estimativa ponderada por este guia com base em especificações públicas — memória 40% + interconexão 30% + ecossistema 30%.
Histórico HISTORY
Em 2024 , lançamento do H200 NVL: o flagship PCIe de inferência da geração Hopper — a forma PCIe de duas slots refrigerado a ar das especificações do H200 (141 GB HBM3e/FP8 3.341), com suporte a confidential computing (conforme a captura oficial de especificações [1]).
2024–2025 , ramp-up de inferência: explosão da demanda por inferência online de grandes modelos — o formato PCIe plug-and-play + 141GB de memória tornaram o H200 NVL uma das principais forças em volume no lado da inferência (compilação interna da AIXX Pedia).
2025-2026 , transição para Blackwell: lançamento da série RTX PRO 6000 Blackwell/B300 — o H200 NVL passa a circular como estoque existente e em paralelo (compilação interna da AIXX Pedia). As políticas de circulação transfronteiriça seguem em evolução; a AIXX Pedia se baseia em reportagens públicas e não constitui parecer jurídico.
Especificações técnicas SPECIFICATIONS
| Item | Especificações (H200 NVL · dados oficiais) |
|---|---|
| Arquitetura | NVIDIA Hopper |
| Memória de vídeo por placa | 141GB HBM3e |
| Largura de banda de memória | 4.8TB/s |
| FP8 / INT8 | 3,341 TFLOPS / 3,341 TOPS |
| FP16 | 1,671 TFLOPS |
| FP64 / FP64 Tensor | 30 / 60 TFLOPS |
| FP32 | 60 TFLOPS |
| Interconexão | NVLink bridge 2/4-way: 900GB/s | PCIe Gen5: 128GB/s |
| Computação confidencial | Suporte (Confidential Computing) |
| MIG | Até 7 instâncias @ 16,5GB |
| Codecs | 7 NVDEC | 7 JPEG |
| Consumo | Até 600W (configurável) |
| Forma | PCIe de duplo slot refrigerado a ar |
As especificações seguem o retrato oficial da NVIDIA (dados de 10/2026[1], verificados item a item com a Ficha técnica).
Comparativo entre os dois formatos da família H200 TWO FORMS
| Item | H200 NVL(PCIe) | H200 SXM (baseboard HGX) |
|---|---|---|
| Memória | 141GB HBM3e | 141GB HBM3e |
| Interconexão | NVLink bridge 900GB/s (2/4 GPUs) | NVLink 900GB/s (full mesh multi-GPU) |
| Implantação | Servidor x86 padrão, plug-and-play | Sistema completo com baseboard HGX |
| Recomendação em uma frase | Inferência / instalação em máquina única | Clusters de treinamento em larga escala |
Membros da família FAMILY
A família H200 é dividida por formato; a versão NVL é a bandeira PCIe de inferência:
Refrigeração e implantação COOLING
O H200 NVL é placa PCIe de duplo slot refrigerado a ar (até 600W configurável) — plug-and-play em servidores x86 padrão, não exige o sistema completo com baseboard HGX (conforme o retrato oficial de especificações[1]). Três tabelas para a implantação: Alimentação (a faixa de 600W exige PSU e cabeamento com margem adequada), conexão direta PCIe Gen5 (x16 direto à CPU, sem switch para não perder banda), fluxo de ar (a pressão térmica de dois slots a 600W em carga máxima é maior que a da faixa de 300W — controle da temperatura de entrada).
Implantação de Confidential Computing: o CC requer ativação em três camadas — BIOS/driver/framework — em cenários regulatórios de finanças/governo recomenda-se verificação camada por camada na entrega (compilação interna da AIXX Pedia).
Compatibilidade de modelos MODEL FIT
| Modelo / cenário | Requisitos de memória (estimativa em FP16) | Critérios de implantação do H200 NVL | AIXX Index |
|---|---|---|---|
| Inferência nível 70B (FP16) | Cerca de 140GB | Instalação direta no limiar de 141GB por placa + KV cache bem dimensionado — após quantização INT8/FP8, folga ampla | 88 |
| Inferência de grandes modelos (FP8) | Pesos FP8 de cerca de 70GB (70B) | Folga ampla por placa + divisão multi-tenant via MIG | 90 |
| Inferência de contexto longo | KV cache cresce linearmente com o comprimento | Espaço de KV cache dos 141GB — superior à faixa de 80GB em cenários de contexto longo | 86 |
| Treinamento de grandes modelos | — | Interconexão PCIe limitada — para treinamento em larga escala, veja a linha HGX SXM | 60 |
Galeria GALLERY
Software e ecossistema ECOSYSTEM
| Item | Requisitos / situação atual |
|---|---|
| CUDA | Geração Hopper (compute capability 9.0) — suportada desde o CUDA 11.8 |
| Framework | Suporte total a PyTorch / TensorFlow / vLLM / TensorRT |
| Computação confidencial | Confidential Computing — verificação item a item do suporte na camada de framework (compilação interna da AIXX Pedia) |
| Driver | Linha de drivers de data center NVIDIA (compartilhada com a H100) |
Aquisição e inspeção PROCUREMENT
Pontos de inspeção na compra do H200 NVL (três itens):
Consulta rápida de verificação QUICK CHECK
Verificação rápida do H200 NVL em quatro passos:
Transporte e entrega LOGISTICS
Cartões de terminologia GLOSSARY
Confidential Computing
Proteção de dados em hardware: os dados na memória da GPU são criptografados durante o processamento — mesmo se a memória do sistema for comprometida, modelos e dados na memória da GPU permanecem protegidos. Argumento corporativo para setores regulados como finanças, governo e saúde (dados do snapshot oficial de especificações).
Nomenclatura NVL
Nos produtos NVIDIA, o sufixo NVL = formato de placa PCIe com bridge NVLink — o H200 NVL atinge 900GB/s de interconexão GPU-GPU via bridge NVLink 2/4-way (não é o full mesh do baseboard SXM).
MIG(Multi-Instance GPU)
Uma placa, várias instâncias: o H200 NVL suporta até 7 instâncias (versão 80GB: 10GB/instância, versão 94GB: 12GB/instância, H200 NVL: 16,5GB/instância) — base de hardware para pooling de inferência multi-tenant.
Limitações e controvérsias LIMITS
- Teto da interconexão PCIe : o bridge NVLink se limita a 2/4 GPUs (dados oficiais de 900GB/s) — a densidade de interconexão para treinamento em larga escala é bem inferior à do baseboard HGX SXM (compilação interna da AIXX Pedia).
- FP64 não é o foco : FP64 com 30 TFLOPS — em cenários HPC de dupla precisão, comparar com a A100 (19,5 TFLOPS FP32, não FP64) exige avaliação item a item.
- Posicionamento treinamento vs inferência : formato PCIe + sem domínio NVLink — para treinamento em larga escala, veja a série HGX SXM; o ponto forte do H200 NVL está em inferência e conformidade.
- Planejamento do consumo configurável : até 600W configurável — a faixa de consumo exige flexibilidade considerável da infraestrutura elétrica e de refrigeração do data center; registre a faixa de consumo no contrato de compra.
- Variável de política de circulação internacional : o H200 foi aprovado para o mercado chinês em 2025-12 (reportagem pública, ver ficha do H200) — o status de aprovação do H200 NVL evolui com as políticas; prevalece o parecer especializado.
Notas de mercado MARKET NOTE
O H200 NVL em estoque convive com unidades novas de fábrica e desmontadas de sistemas completos — Princípio de honestidade da AIXX Pedia: sem faixa de mercado; o preço está sujeito à cotação do vendedor 。
Busca de ofertas: Salão da AIXX Exchange › (Intermediação sem comissão; dados, portanto, neutros).
Marcos históricos de preço MILESTONES
Perguntas frequentes FAQ
A fronteira está no formato de implantação: para plug-and-play PCIe (servidor x86 padrão/torre), escolha a NVL — o sistema com baseboard HGX (4/8 GPUs NVLink full mesh) é adequado a clusters de treinamento em larga escala. Ambos têm a mesma faixa de 141GB de memória.
Upgrade direto em memória: 141GB vs 94GB (+50%), banda de 4,8TB/s vs 3,9TB/s, FP8 na mesma faixa — em inferência, o custo por memória do H200 NVL é mais vantajoso.
Criptografia do processo de cálculo na memória da GPU — requisito essencial em cenários com forte exigência regulatória (finanças/governo/saúde); em inferência comum pode ficar desativado (a ativação traz leve overhead, cerca de 5% segundo dados do setor). A conformidade orienta a escolha.
Quatro passos: identificação (nvidia-smi, 141GB/ECC) → teste de burn-in em carga máxima na faixa de 600W (temperatura/zero erros ECC) → benchmark de FP8 (≥80% Aprovado, critério estimado) → teste prático da divisão em 7 instâncias MIG.
O H200 foi aprovado para o mercado chinês em 2025-12 (reportagem pública, ver ficha do H200) — para o status de aprovação do formato PCIe do H200 NVL, prevalecem as políticas mais recentes e o parecer especializado; a AIXX Pedia não constitui parecer jurídico.
Entradas relacionadas SEE ALSO
Comparação e escolha de modelos COMPARE
Referências REFERENCES
- NVIDIA oficial — snapshot de especificações do H200 NVL (verificado item a item com a Ficha técnica, dados de 2026-10) https://www.nvidia.com/en-us/data-center/h200/
- Site oficial NVIDIA — linha de produtos H200 (dados comparativos da família) https://www.nvidia.com/en-us/data-center/h200/
- Busca de ofertas — AIXX Exchange (Intermediação sem comissão; sem snapshot de mercado para o H200 NVL, O preço real está sujeito à cotação do vendedor) https://www.aixx.vip/hall.html?model=H200%20NVL