H200 NVL
개요OVERVIEW
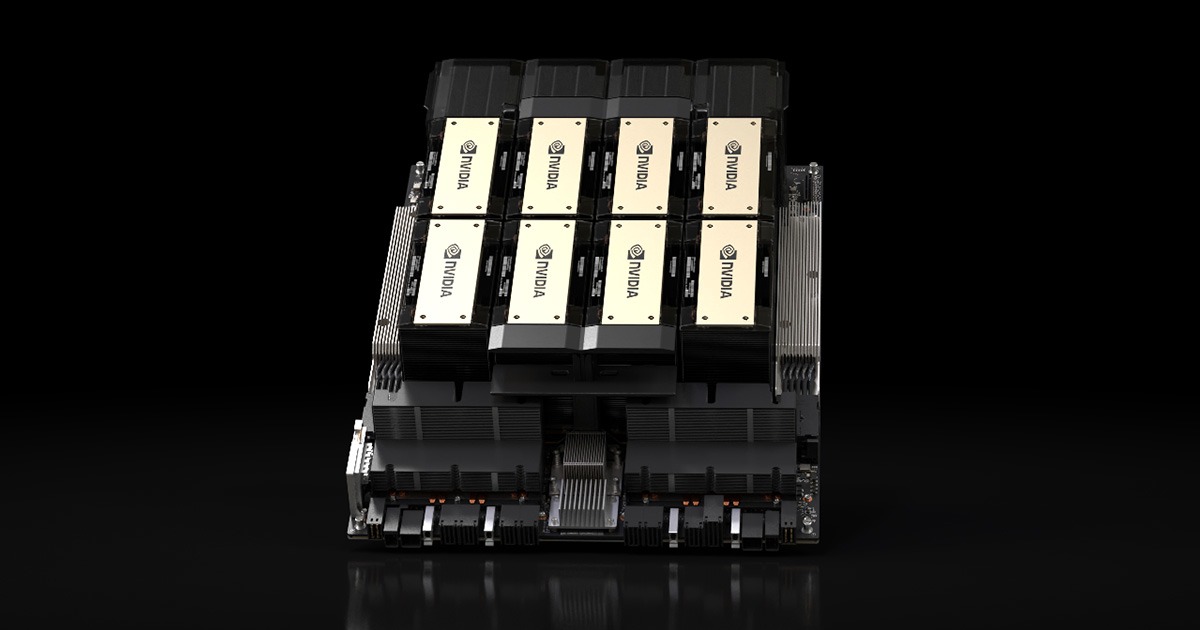
H200 NVLNVIDIA H200의 PCIe 듀얼 슬롯 공랭 폼팩터입니다: 싱글 카드 141GB HBM3e 메모리, FP8 3,341 TFLOPS, FP64 Tensor 60 TFLOPS, 소비전력 최대 600W까지 구성 가능, 2/4-way NVLink 브리지 900GB/s — 기밀 컴퓨팅(Confidential Computing) 지원기업용 라인업의 대표 카드(공식 사양 스냅샷 기준[1]).
HGX H200 베이스판(SXM)과의 관계: 같은 칩, 다른 폼팩터 — NVL 판은 PCIe 2슬롯 공랭 카드(랙/타워 서버에 직접 장착), HGX 베이스판은 SXM 수랭/공랭 풀시스템(4/8카드 NVLink 풀 인터커넥트)입니다. 구매자 관점에서는: PCIe 배포 진입 장벽이 한 단계 낮음——베이스플레이트 통합 시스템 없이 표준 x86 서버에 바로 장착 가능(공식 사양 스냅샷 기준[1]).
H100 NVL 비교: 메모리 141GB 대 94GB(+50%), 대역폭 4.8TB/s 대 3.9TB/s, FP8은 동일하게 3,341 TFLOPS — H200 NVL은 H100 NVL의 메모리 직계 상위 모델추론 시나리오에서 가성비 좋은 선택(공식 비교 기준[1]). 본 항목에는 시세 정보가 포함되지 않습니다——실제 가격은 판매자 제시가 기준.
적용 시나리오FIT
AIXX Index(0–100): 본 라이브러리는 공개 스펙 기반 가중 추정 — 메모리 40% + 상호연결 30% + 생태계 30%.
연혁HISTORY
2024년H200 NVL 출시: Hopper 세대의 PCIe 추론 플래그십——H200 코어 사양(141GB HBM3e/FP8 3,341)을 듀얼 슬롯 공랭 PCIe 폼팩터로 구현, 기밀 컴퓨팅 지원(공식 사양 스냅샷 기준[1]).
2024-2025년, 추론 수요 확대: 대형 모델 온라인 추론 수요 폭발 — PCIe 즉시 장착 + 141GB 대용량 메모리로 H200 NVL은 추론 측 주력 물량 카드 중 하나로 자리매김(본 DB 정리 기준).
2025-2026년, Blackwell 교체: RTX PRO 6000 Blackwell/B300 계열 출시 — H200 NVL은 기존 재고 및 병행 유통으로 전환(본 DB 정리 기준). 대중국 유통 정책은 진행 중이며, 본 DB 서술은 공개 보도 기준이며 법률 자문이 아닙니다.
기술 사양SPECIFICATIONS
| 항목 | 스펙(H200 NVL · 공식 기준) |
|---|---|
| 아키텍처 | NVIDIA Hopper |
| 보드당 메모리 | 141GB HBM3e |
| 메모리 대역폭 | 4.8TB/s |
| FP8 / INT8 | 3,341 TFLOPS / 3,341 TOPS |
| FP16 | 1,671 TFLOPS |
| FP64 / FP64 Tensor | 30 / 60 TFLOPS |
| FP32 | 60 TFLOPS |
| 인터커넥트 | NVLink 브리지 2/4-way: 900GB/s | PCIe Gen5: 128GB/s |
| 기밀 컴퓨팅 | 지원(Confidential Computing) |
| MIG | 최대 7 인스턴스 @ 16.5GB |
| 코덱 | 7 NVDEC | 7 JPEG |
| 소비 전력 | 최대 600W(구성 가능) |
| 폼팩터 | PCIe 듀얼 슬롯 공랭 |
스펙은 NVIDIA 공식 스냅샷 기준(2026-10 기준[1], 스펙 카드와 항목별 대조 검증 완료).
H200 패밀리 두 폼팩터 비교TWO FORMS
| 항목 | H200 NVL(PCIe) | H200 SXM(HGX 베이스) |
|---|---|---|
| 메모리 | 141GB HBM3e | 141GB HBM3e |
| 인터커넥트 | NVLink 브리지 900GB/s(2/4카드) | NVLink 900GB/s(다카드 풀 인터커넥트) |
| 배포 | 표준 x86 서버 직접 장착 | HGX 베이스 풀시스템 |
| 선택 한 줄 요약 | 추론/단일 서버 직접 장착 | 대규모 학습 클러스터 |
패밀리 라인업FAMILY
H200 패밀리는 폼팩터별 구분; NVL 판은 PCIe 추론 플래그십:
냉각 및 배치COOLING
H200 NVL은 PCIe 듀얼 슬롯 공랭 카드(최대 600W 구성 가능) — 표준 x86 서버에 바로 장착 가능하며, HGX 베이스플레이트 통합 시스템 불필요(공식 스펙 스냅샷 기준[1]). 도입 체크리스트:전원(600W 구성 시 충분한 용량의 PSU와 전원 케이블 필요), PCIe Gen5 직결(x16 CPU 직결, 스위치 경유 시 대역폭 손실),에어플로우(600W 풀 로드의 2슬롯 카드는 300W 구간보다 공기역학 부담이 큼 — 흡기 온도 관리).
기밀 컴퓨팅 배포: Confidential Computing은 BIOS/드라이버/프레임워크 세 계층에서 활성화 필요 — 금융/공공 컴플라이언스 시나리오는 인수 시 계층별 실측 권장(본 DB 정리 기준).
모델 호환성MODEL FIT
| 모델 / 시나리오 | 메모리 수요(FP16 추정) | H200 NVL 배포 기준 | AIXX Index |
|---|---|---|---|
| 70B급 추론(FP16) | 약 140GB | 단일 카드 141GB 임계 직장재 + KV cache 정밀 운용 — INT8/FP8 양자화 후 여유 충분 | 88 |
| 대형 모델 추론(FP8) | FP8 가중치 약 70GB(70B) | 카드당 여유 충분 + MIG 분할 멀티테넌트 | 90 |
| 롱 컨텍스트 추론 | KV cache는 길이에 비례 | 141GB의 KV cache 공간 — 롱 컨텍스트 시나리오에서 80GB급 대비 우위 | 86 |
| 대규모 모델 훈련 | — | PCIe 인터커넥트 제약 — 대규모 학습은 HGX SXM 계열로 | 60 |
갤러리GALLERY
소프트웨어와 에코시스템ECOSYSTEM
| 항목 | 요구 사항 / 현황 |
|---|---|
| CUDA | Hopper 세대(컴퓨트 커페빌리티 9.0) — CUDA 11.8부터 지원 |
| 프레임워크 | PyTorch / TensorFlow / vLLM / TensorRT 전면 지원 |
| 기밀 컴퓨팅 | Confidential Computing — 프레임워크 계층 지원 항목별 검증(본 DB 정리 기준) |
| 드라이버 | NVIDIA 데이터센터 드라이버 라인(H100과 공용) |
구매 및 검수PROCUREMENT
H200 NVL 구매 검수 포인트(3가지):
검수 퀵 가이드QUICK CHECK
H200 NVL 4단계 스피드 체크:
운송과 납품LOGISTICS
용어 카드GLOSSARY
기밀 컴퓨팅(Confidential Computing)
하드웨어 수준 데이터 보호: GPU 메모리 내 데이터가 연산 과정에서 암호화 — 시스템 메모리가 침해되더라도 GPU 메모리의 모델과 데이터는 보호됩니다. 금융/공공/의료 등 컴플라이언스 민감 산업의 엔터프라이즈 셀링포인트(공식 스펙 스냅샷 기준).
NVL 명명
NVIDIA 제품에서 NVL 접미사 = NVLink 브리지 탑재 PCIe 카드 폼팩터 — H200 NVL은 2/4-way NVLink 브리지로 900GB/s GPU 간 인터커넥트 구현(SXM 베이스 풀 인터커넥트 아님).
MIG(Multi-Instance GPU)
단일 카드 멀티 인스턴스 분할: H200 NVL 최대 7 인스턴스(80GB판 10GB/인스턴스, 94GB판 12GB/인스턴스, H200 NVL 16.5GB/인스턴스) — 멀티테넌트 추론 풀링의 하드웨어 기반.
한계와 논쟁점LIMITS
- PCIe 인터커넥트 상한: NVLink 브리지는 2/4카드로 제한(900GB/s 브리지 기준) — 대규모 학습의 인터커넥트 밀도는 HGX SXM 베이스 대비 훨씬 낮음(본 DB 정리 기준).
- FP64는 주력 아님: FP64 30 TFLOPS — 배정밀 HPC 시나리오는 A100(19.5 TFLOPS FP32, FP64 아님 기준) 대비 항목별 평가 필요.
- 학습 vs 추론 포지셔닝: PCIe 폼팩터 + NVLink 도메인 없음 — 대규모 학습은 HGX SXM 계열 확인, H200 NVL의 최적 영역은 추론과 컴플라이언스.
- 전력 설정의 계획: 최대 600W 구성 가능 — 전력 구성 단계는 데이터센터 전원 및 냉각의 유연성 요구가 높음, 구매 계약에 전력 단계 명시.
- 국경 간 유통 정책 변수: H200은 2025-12 대중국 승인 획득(공개 보도 기준, H200 항목과 동일) — H200 NVL의 승인 상태는 정책에 따라 변동, 전문가 의견 기준.
시세 안내MARKET NOTE
H200 NVL 유통은 원주 신제품과 시스템 해체품이 병행 — 본 백과의 정직 원칙: 시세 밴드를 만들지 않으며, 가격은 판매자 제시가 기준。
재고 검색: AIXX Exchange 쇼룸 ›(수수료 0% 매칭, 데이터는 이에 따라 중립적).
가격 주요 이벤트MILESTONES
자주 묻는 질문FAQ
배포 폼팩터 구분: PCIe 직접 장착(표준 x86 서버/타워)은 NVL 선택 — HGX 베이스 풀시스템(4/8카드 NVLink 풀 인터커넥트)은 대규모 학습 클러스터에 적합. 양측 모두 141GB 메모리 동급.
메모리 직계 업그레이드: 141GB 대 94GB(+50%), 대역폭 4.8TB/s 대 3.9TB/s, FP8 연산 동급 — 추론 시나리오에서 H200 NVL의 단위 메모리 비용이 더 유리.
GPU 메모리 연산 과정 암호화 — 금융/공공/의료 컴플라이언스 요구가 강한 시나리오는 필수, 일반 추론은 비활성화 가능(활성화 시 경미한 성능 오버헤드, 업계 기준 약 5% 이내). 컴플라이언스 요구가 선택을 좌우.
4단계: 식별(nvidia-smi 141GB/ECC) → 600W 구성 풀 로드 번인 테스트(온도/ECC 에러 제로) → FP8 연산 벤치마크(≥80% 합격, 추정 기준) → MIG 7 인스턴스 분할 실측.
H200은 2025-12 대중국 승인 획득(공개 보도 기준, H200 항목과 동일) — H200 NVL의 PCIe 폼팩터 승인 상태는 최신 정책과 전문가 의견 기준 권장, 본 DB는 법률 자문이 아닙니다.
관련 항목SEE ALSO
모델 비교 및 선택COMPARE
참고 자료REFERENCES
- NVIDIA 공식 — H200 NVL 스펙 스냅샷(스펙 카드와 항목별 대조 일치, 2026-10 기준) https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA 공식 사이트 — H200 제품 라인(패밀리 비교 기준) https://www.nvidia.com/en-us/data-center/h200/
- 판매 검색 — AIXX 거래소(수수료 0% 매칭; H200 NVL 시세 스냅샷 없음, 실제 가격은 판매자 제시가 기준) https://www.aixx.vip/hall.html?model=H200%20NVL