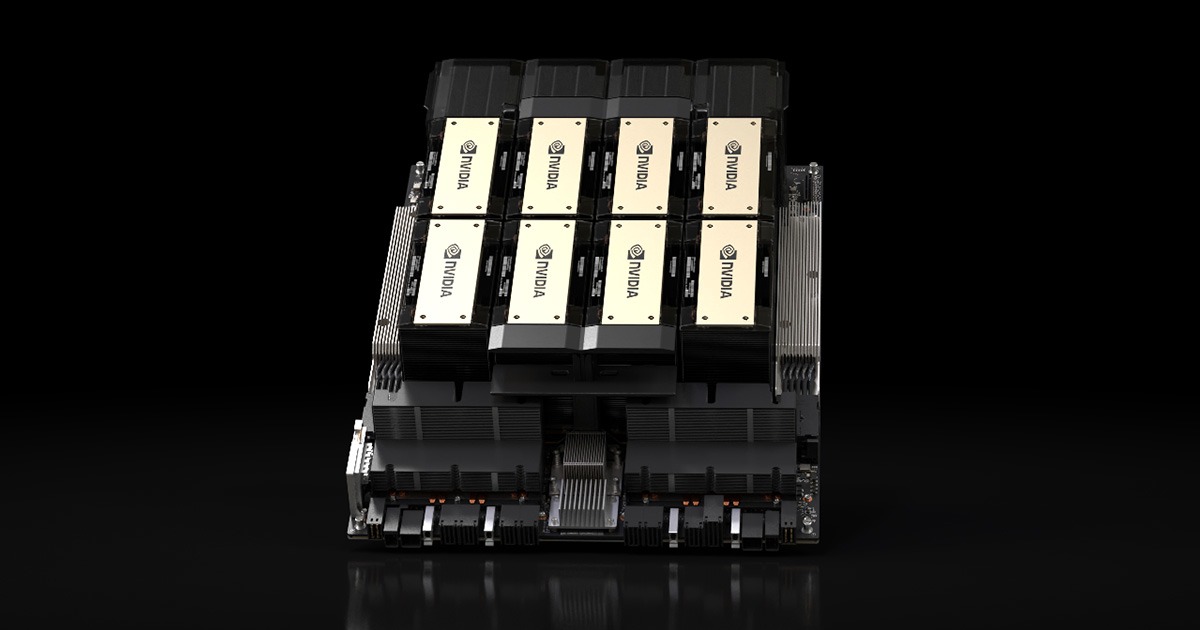
H200 NVL
概要OVERVIEW
H200 NVLNVIDIA H200の PCIe 2スロット空冷フォームファクタ:141GB HBM3eのシングルカードVRAM、FP8 3,341 TFLOPS、FP64 Tensor 60 TFLOPS、消費電力は600Wまで設定可能、2/4-way NVLinkブリッジで900GB/s——機密コンピューティング(Confidential Computing)対応エンタープライズ向けの証となる存在(公式仕様スナップショットに基づく表記[1])。
HGX H200ベースボード版(SXM)との関係:同一チップでフォームファクタが違う——NVL版はPCIeの2スロット空冷カード(ラック/タワー型サーバーに直接搭載)、HGXベースボード版はSXM液冷/空冷の完成機(4/8カードNVLinkフルインターコネクト)です。調達担当者へのポイント:PCIeは導入ハードルが一段低い——ベースボード一体型システムは不要で、標準的なx86サーバーに直接挿すだけで使える(公式仕様スナップショットに基づく表記[1])。
H100 NVLとの比較:VRAM 141GB対94GB(+50%)、帯域4.8TB/s対3.9TB/s、FP8はともに3,341 TFLOPS——H200 NVLはH100 NVLのVRAM直接後継推論シーンにおけるコストパフォーマンスの選択肢(公式比較に基づく表記[1])。本項目では相場情報を扱わない——実際の価格は出品者の提示価格によります。
適用シーンFIT
AIXX Index(0–100):本データベースは公開スペックに基づく加重推定——メモリ 40% + インターコネクト 30% + エコシステム 30%。
沿革HISTORY
2024 年、H200 NVL登場:Hopper世代のPCIe推論フラッグシップ——H200のコア仕様(141GB HBM3e/FP8 3,341)を2スロット空冷のPCIeフォームファクタに収め、コンフィデンシャルコンピューティングにも対応(公式仕様スナップショットに基づく表記[1])。
2024〜2025 年、推論需要の拡大:大規模モデルのオンライン推論需要が急増——PCIeのプラグアンドプレイ+141GBの大容量VRAMにより、H200 NVLは推論側の量産主力の一つに(本ライブラリ整理の記載)。
2025〜2026 年、Blackwellへの世代交代:RTX PRO 6000 Blackwell/B300系が登場——H200 NVLは在庫・並行流通へ移行(本ライブラリ整理の記載)。越境流通政策はなお推移中であり、本ライブラリの記述は公開報道ベースであり法的助言を構成しません。
技術仕様SPECIFICATIONS
| 項目 | スペック(H200 NVL · 公式記載) |
|---|---|
| アーキテクチャ | NVIDIA Hopper |
| 単体メモリ | 141GB HBM3e |
| メモリ帯域幅 | 4.8TB/s |
| FP8 / INT8 | 3,341 TFLOPS / 3,341 TOPS |
| FP16 | 1,671 TFLOPS |
| FP64 / FP64 Tensor | 30 / 60 TFLOPS |
| FP32 | 60 TFLOPS |
| インターコネクト | NVLinkブリッジ 2/4-way:900GB/s | PCIe Gen5:128GB/s |
| コンフィデンシャルコンピューティング | 対応(Confidential Computing) |
| MIG | 最大7インスタンス @ 16.5GB |
| コーデック | 7 NVDEC | 7 JPEG |
| 消費電力 | 最大600W(設定可能) |
| フォームファクター | PCIe 2スロット空冷 |
スペックは NVIDIA 公式スナップショットに準拠(2026-10 時点[1]、スペックカードと全項目照合済み)。
H200ファミリー2形態の比較TWO FORMS
| 項目 | H200 NVL(PCIe) | H200 SXM(HGXベースボード) |
|---|---|---|
| メモリ | 141GB HBM3e | 141GB HBM3e |
| インターコネクト | NVLinkブリッジ900GB/s(2/4カード) | NVLink 900GB/s(複数カードフルインターコネクト) |
| デプロイ | 標準x86サーバーに直接搭載 | HGXベースボード完成機 |
| 選定を一言で | 推論/1台直挿し | 大規模学習クラスター |
ファミリー構成FAMILY
H200ファミリーは形態で分かれます。NVL版はPCIe推論フラッグシップ:
冷却と導入COOLING
H200 NVLは PCIe 2スロット空冷カード(最大600W設定可能)——標準x86サーバーに直接挿して即使用可能、HGXベースボード搭載機は不要(公式スペックスナップショット基準[1])。導入時のチェックポイント:電源(600W設定には十分な容量のPSUと電源ケーブルが必要)、PCIe Gen5直結(x16でCPUに直結、スイッチ経由は帯域をロス)、エアフロー(600Wフルロード時の2スロットカードの風路負荷は300W級より大きい——吸気温度管理)。
機密コンピューティングのデプロイ:Confidential ComputingはBIOS/ドライバー/フレームワークの3層で有効化が必要——金融/行政のコンプライアンス要件では検収時に各層で実測確認を推奨(本ライブラリ整理の記載)。
モデル対応MODEL FIT
| モデル / シナリオ | メモリ需要(FP16 推計) | H200 NVL デプロイの目安 | AIXX Index |
|---|---|---|---|
| 70B 級推論(FP16) | 約 140GB | シングルカード141GBでギリギリ直載 + KV cacheを精緻に配分——INT8/FP8の量子化後は余裕あり | 88 |
| 大規模モデル推論(FP8) | FP8重みは約70GB(70B) | シングルカードで十分な余裕 + MIG分割によるマルチテナント | 90 |
| ロングコンテキスト推論 | KV cache は長さに比例 | 141GBのKV cache領域——長コンテキスト用途で80GB級より有利 | 86 |
| 大規模モデル学習 | — | PCIeインターコネクトに制限——大規模学習はHGX SXM系を見よ | 60 |
ギャラリーGALLERY
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| CUDA | Hopper世代(コンピュートCapability 9.0)——CUDA 11.8以降で対応 |
| フレームワーク | PyTorch / TensorFlow / vLLM / TensorRT 完全対応 |
| コンフィデンシャルコンピューティング | Confidential Computing——フレームワーク層の対応を個別に検証(本ライブラリ整理の記載) |
| ドライバー | NVIDIAデータセンター向けドライバーライン(H100と共通) |
調達と検品PROCUREMENT
H200 NVL購入時の検品ポイント(3項目):
検収クイックリファレンスQUICK CHECK
H200 NVLの4ステップ速見チェック:
輸送と納品LOGISTICS
用語カードGLOSSARY
機密コンピューティング(Confidential Computing)
ハードウェアレベルのデータ保護:GPU VRAM上のデータを演算プロセス中も暗号化——システムメモリが侵害されても、GPU VRAM上のモデルとデータは保護されます。金融/行政/医療などコンプライアンスが重視される業界でのエンタープライズ向けの武器(公式スペックカードの記載)。
NVLという命名
NVIDIA製品でNVL接尾辞=NVLinkブリッジ付きPCIeカードの形態——H200 NVLは2/4-way NVLinkブリッジで900GB/sのGPU間インターコネクトを実現(SXMベースボードのフルインターコネクトではない)。
MIG(Multi-Instance GPU)
シングルカードの複数インスタンス化:H200 NVLは最大7インスタンス(80GB版10GB/インスタンス、94GB版12GB/インスタンス、H200 NVL 16.5GB/インスタンス)——マルチテナント推論プールのハードウェア基盤。
限界と論点LIMITS
- PCIeインターコネクトの上限:NVLinkブリッジは2/4カードまで(900GB/sブリッジの基準)——大規模トレーニングのインターコネクト密度はHGX SXMベースボードに大幅に劣る(本ライブラリ整理の記載)。
- FP64は主眼ではない:FP64 30 TFLOPS——倍精度HPC用途ではA100(19.5 TFLOPS FP32、FP64の基準ではない)と一項目ずつ比較評価が必要。
- 学習 vs 推論の位置づけ:PCIe形態+NVLinkドメインなし——大規模トレーニングはHGX SXM系、H200 NVLの適材は推論とコンプライアンス。
- 消費電力設定の計画:最大600W設定可——消費電力設定は機房の給電・冷却への柔軟性が求められ、調達契約には消費電力設定を明記すること。
- 越境流通の政策変数:H200は2025-12に中国市場向け特別仕様として承認済み(公開報道の記載、H200項目と同様)——H200 NVLの承認状態は政策の推移に伴い変動し、専門意見に従うこと。
相場情報MARKET NOTE
H200 NVLの現物は原厂新品と整机取外し品が並行流通——本ライブラリの誠実さの原則:相場帯を設けず、価格は出品者の実際の提示価格によります。
販売検索:AIXX 取引所ロビー ›(手数料ゼロのマッチング、データは中立)。
価格イベント年表MILESTONES
よくある質問FAQ
デプロイ形態の分かれ目:PCIe直挿し(標準x86サーバー/タワー型)ならNVL——HGXベースボード完成機(4/8カードNVLinkフルインターコネクト)は大規模トレーニングクラスタ向け。両者とも141GB VRAMは同級。
VRAMの直接後継:141GB対94GB(+50%)、帯域4.8TB/s対3.9TB/s、FP8演算性能は同水準——推論シーンではH200 NVLの単位VRAMコストがより優位。
GPU VRAMの演算プロセスを暗号化——金融/行政/医療などコンプライアンス要件が強いシーンでは必須、通常の推論では無効でも可(有効化すると軽微な性能オーバーヘッドあり、業界基準で約5%以内)。コンプライアンス要件が選定を左右します。
4ステップ:識別確認(nvidia-smi 141GB/ECC)→ 600W設定フルロードの焼き込みテスト(温度/ECCエラーゼロ)→ FP8演算性能ベンチ(≥80%で合格、推算基準)→ MIG 7インスタンス分割の実測。
H200は2025-12に中国市場向け特別仕様として承認済み(公開報道の記載、H200項目と同様)——H200 NVLのPCIe形態の承認状態は最新政策と専門意見に従うことを推奨、本ライブラリは法的助言を構成しません。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- NVIDIA公式 — H200 NVLスペックカード(スペックカードと一項目ずつ照合済み、2026-10時点) https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA公式サイト — H200製品ライン(ファミリー比較の基準) https://www.nvidia.com/en-us/data-center/h200/
- 出品検索 — AIXX取引所(手数料ゼロのマッチング;H200 NVLの市況スナップショットはまだなし、実際の価格は出品者の提示価格によります) https://www.aixx.vip/hall.html?model=H200%20NVL