AIXX Pedia › Fiche modèle › H200 NVL
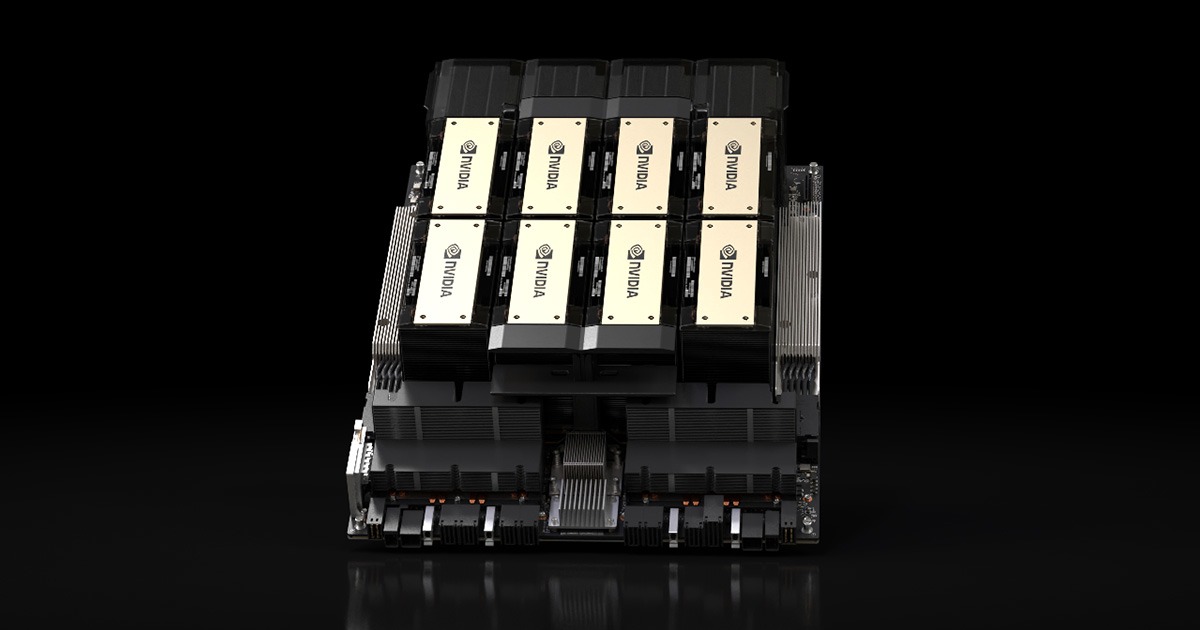
H200 NVL
Vue d'ensemble OVERVIEW
H200 NVL est la version de la NVIDIA H200 Format PCIe double slot refroidi par air : 141GB HBM3e de mémoire par carte, FP8 3 341 TFLOPS, FP64 Tensor 60 TFLOPS, TDP configurable jusqu'à 600W, pont NVLink 2/4-way à 900GB/s — la prise en charge du Confidential Computing est sa carte de visite entreprise (d'après la fiche officielle des spécifications [1]).
Relation avec la version HGX H200 sur substrat (SXM) : même puce, format différent — la version NVL est une carte PCIe double slot refroidi par air (insertion directe dans serveurs rack/tour), tandis que la version HGX sur substrat est un système complet SXM refroidi par liquide/par air (4/8 cartes en full mesh NVLink). Pour les acheteurs : le déploiement PCIe est plus accessible — pas besoin d'un châssis spécial, s'insère directement dans un serveur x86 standard (d'après la fiche officielle des spécifications [1]).
Comparaison avec la H100 NVL : mémoire 141GB contre 94GB (+50 %), bande passante 4,8TB/s contre 3,9TB/s, FP8 identique à 3 341 TFLOPS — le H200 NVL est la montée en gamme mémoire directe du H100 NVL un choix rentable pour l'inférence (selon la comparaison officielle [1]). Cette fiche ne contient pas de données de marché — le prix réel est soumis au devis du vendeur.
Cas d'usage FIT
AIXX Index (0–100) : estimation pondérée par cette base à partir des spécifications publiques — mémoire 40 % + interconnexion 30 % + écosystème 30 %.
Historique HISTORY
2024 lancement du H200 NVL : le fleuron PCIe d'inférence de la génération Hopper — les spécifications clés du H200 (141 Go HBM3e/FP8 3 341) dans un format PCIe bi-slot refroidi par air, avec support de l'informatique confidentielle (d'après la fiche officielle des spécifications [1]).
2024–2025 , montée en puissance de l'inférence : explosion de la demande d'inférence en ligne pour les grands modèles — le format PCIe plug-and-play et les 141GB de mémoire font du H200 NVL l'un des fers de lance volumiques de l'inférence (selon la base AIXX Pedia).
2025-2026 , relève de Blackwell : sortie des séries RTX PRO 6000 Blackwell/B300 — le H200 NVL passe en stock et circulation parallèle (selon la base AIXX Pedia). La politique de circulation transfrontalière évolue encore ; cette base reflète les reportages publics et ne constitue pas un avis juridique.
Spécifications techniques SPECIFICATIONS
| Élément | Spécifications (H200 NVL · source officielle) |
|---|---|
| Architecture | NVIDIA Hopper |
| Mémoire par carte | 141GB HBM3e |
| Bande passante mémoire | 4.8TB/s |
| FP8 / INT8 | 3,341 TFLOPS / 3,341 TOPS |
| FP16 | 1,671 TFLOPS |
| FP64 / FP64 Tensor | 30 / 60 TFLOPS |
| FP32 | 60 TFLOPS |
| Interconnexion | Pont NVLink 2/4-way : 900GB/s | PCIe Gen5 : 128GB/s |
| Calcul confidentiel | Pris en charge (Confidential Computing) |
| MIG | Jusqu'à 7 instances @ 16,5GB |
| Codecs | 7 NVDEC | 7 JPEG |
| TDP | Jusqu'à 600W (configurable) |
| Format | PCIe double slot refroidi par air |
Les spécifications font foi selon l'instantané officiel NVIDIA (données d'octobre 2026 [1], vérifiées point par point avec la fiche technique).
Comparatif des deux formats de la famille H200 TWO FORMS
| Élément | H200 NVL(PCIe) | H200 SXM (substrat HGX) |
|---|---|---|
| Mémoire vidéo | 141GB HBM3e | 141GB HBM3e |
| Interconnexion | Pont NVLink 900GB/s (2/4 cartes) | NVLink 900GB/s (full mesh multi-cartes) |
| Déploiement | Insertion directe en serveur x86 standard | Système complet sur substrat HGX |
| Recommandation en une phrase | Inférence / insertion directe mono-serveur | Clusters d'entraînement à grande échelle |
Membres de la famille FAMILY
La famille H200 se décline par format ; la version NVL est le flagship d'inférence PCIe :
Refroidissement et déploiement COOLING
Le H200 NVL est une carte PCIe double slot refroidie par air (jusqu'à 600W configurable) — insertion directe en serveur x86 standard, pas besoin d'un serveur HGX complet (selon l'instantané officiel des spécifications [1]). Les trois tableaux à consulter avant tout déploiement : Alimentation (le palier 600W exige un PSU et des câbles d'alimentation suffisants), PCIe Gen5 en liaison directe (x16 directement relié au CPU, sans passer par un switch qui bride la bande passante), flux d'air (à pleine charge 600W, la pression sur le flux d'air d'une carte double slot dépasse celle du segment 300W — contrôle de la température d'entrée d'air).
Déploiement du Confidential Computing : CC doit être activé à trois niveaux — BIOS/pilote/framework — pour les scénarios finance/secteur public, il est recommandé de tester niveau par niveau à la réception (selon la base AIXX Pedia).
Compatibilité des modèles MODEL FIT
| Modèle / scénario | Besoins mémoire (estimation FP16) | Repères de déploiement du H200 NVL | AIXX Index |
|---|---|---|---|
| Inférence 70B (FP16) | environ 140 Go | Installation directe limite à 141GB par carte + gestion fine du KV cache — marge confortable après quantification INT8/FP8 | 88 |
| Inférence grands modèles (FP8) | Poids FP8 d'environ 70GB (70B) | Marge par carte confortable + découpe multi-locataires via MIG | 90 |
| Inférence à long contexte | KV cache croissant linéairement avec la longueur | 141GB pour le KV cache — supérieur au segment 80GB pour les longs contextes | 86 |
| Entraînement de grands modèles | — | Interconnexion PCIe limitée — pour l'entraînement à grande échelle, voir la série HGX SXM | 60 |
Galerie GALLERY
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| CUDA | Génération Hopper (compute capability 9.0) — supporté depuis CUDA 11.8 |
| Frameworks | PyTorch / TensorFlow / vLLM / TensorRT entièrement supportés |
| Calcul confidentiel | Confidential Computing — vérification point par point au niveau framework (selon la base AIXX Pedia) |
| Pilotes | Ligne de pilotes datacenter NVIDIA (commune avec la H100) |
Achat et réception PROCUREMENT
Points de contrôle à la réception d'un H200 NVL (trois items) :
Aide-mémoire de réception QUICK CHECK
Le H200 NVL en quatre étapes rapides :
Transport et livraison LOGISTICS
Fiches terminologie GLOSSARY
Confidential Computing
Protection des données au niveau matériel : les données en mémoire GPU sont chiffrées pendant le calcul — même si la mémoire système est compromise, modèles et données en mémoire GPU restent protégés. Argument entreprise pour les secteurs sensibles : finance, secteur public, santé (selon l'instantané officiel des spécifications).
Nomenclature NVL
Chez NVIDIA, le suffixe NVL désigne une carte PCIe avec pont NVLink — le H200 NVL atteint 900GB/s d'interconnexion GPU-GPU via pont NVLink 2/4-way (pas le full mesh SXM sur substrat).
MIG(Multi-Instance GPU)
Découpe multi-instances : jusqu'à 7 instances pour le H200 NVL (10GB/instance version 80GB, 12GB/instance version 94GB, 16,5GB/instance pour le H200 NVL) — base matérielle de la mutualisation d'inférence multi-locataires.
Limites et controverses LIMITS
- Plafond de l'interconnexion PCIe : le pont NVLink est limité à 2/4 cartes (900GB/s via pont) — densité d'interconnexion très inférieure au substrat HGX SXM pour le training à grande échelle (selon la base AIXX Pedia).
- FP64 n'est pas la cible : FP64 30 TFLOPS — face à l'A100 pour le HPC double précision (19,5 TFLOPS FP32, pas FP64), une évaluation item par item s'impose.
- Positionnement entraînement vs inférence : format PCIe sans domaine NVLink — pour le training à grande échelle, voir la série HGX SXM ; le sweet spot du H200 NVL est l'inférence et la conformité.
- Planification de la consommation configurable : jusqu'à 600W configurable — le palier de consommation impose une forte exigence d'alimentation et de refroidissement du datacenter ; précisez le palier au contrat.
- Variable des politiques transfrontalières : le H200 a été approuvé pour le marché chinois en 2025-12 (selon les reportages publics, cf. fiche H200) — le statut d'approbation du H200 NVL évolue avec la politique ; référez-vous à un avis professionnel.
Notes de marché MARKET NOTE
Le marché du H200 NVL en stock se partage entre produits neufs d'origine et cartes issues de serveurs démontés — Principe d'honnêteté de cette fiche : pas de bande de marché, le prix est soumis au devis réel du vendeur 。
Recherche des offres : AIXX Exchange Hall › (mise en relation sans commission, d'où la neutralité des données).
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Frontière de format : insertion PCIe directe (serveur x86 standard/tour) → NVL — le système HGX sur substrat (4/8 cartes full mesh NVLink) convient aux clusters de training à grande échelle. Les deux offrent 141GB de mémoire au même palier.
Mise à niveau directe de la VRAM : 141 Go contre 94 Go (+50 %), bande passante 4,8 To/s contre 3,9 To/s, puissance FP8 équivalente à même gamme — en inférence, le coût par Go de VRAM du H200 NVL est plus avantageux.
Chiffrement du calcul en mémoire GPU — indispensable pour la finance, le secteur public, la santé en forte exigence de conformité ; facultatif pour l'inférence classique (léger surcoût de performance une fois activé, environ 5 % selon la branche). La conformité guide le choix.
Quatre étapes : identification (nvidia-smi 141GB/ECC) → test de burn-in pleine charge palier 600W (température/zéro erreur ECC) → benchmark FP8 (≥80 % conforme, estimation) → test réel de découpe MIG en 7 instances.
Le H200 a été approuvé pour le marché chinois en 2025-12 (selon les reportages publics, cf. fiche H200) — pour le statut d'approbation du format PCIe du H200 NVL, référez-vous aux dernières politiques et à un avis professionnel ; cette base ne constitue pas un avis juridique.
Fiches liées SEE ALSO
Comparaison et choix de machines COMPARE
Références REFERENCES
- NVIDIA officiel — Instantané des spécifications du H200 NVL (vérifié ligne à ligne avec la fiche technique, source 2026-10) https://www.nvidia.com/en-us/data-center/h200/
- Site NVIDIA — Gamme H200 (cadre comparatif famille) https://www.nvidia.com/en-us/data-center/h200/
- Recherche en vente — AIXX Exchange (Mise en relation sans commission ; pas d'instantané de cotation pour le H200 NVL, le prix réel est soumis au devis du vendeur) https://www.aixx.vip/hall.html?model=H200%20NVL