AIXX Pedia › Ficha de modelo › H200 NVL
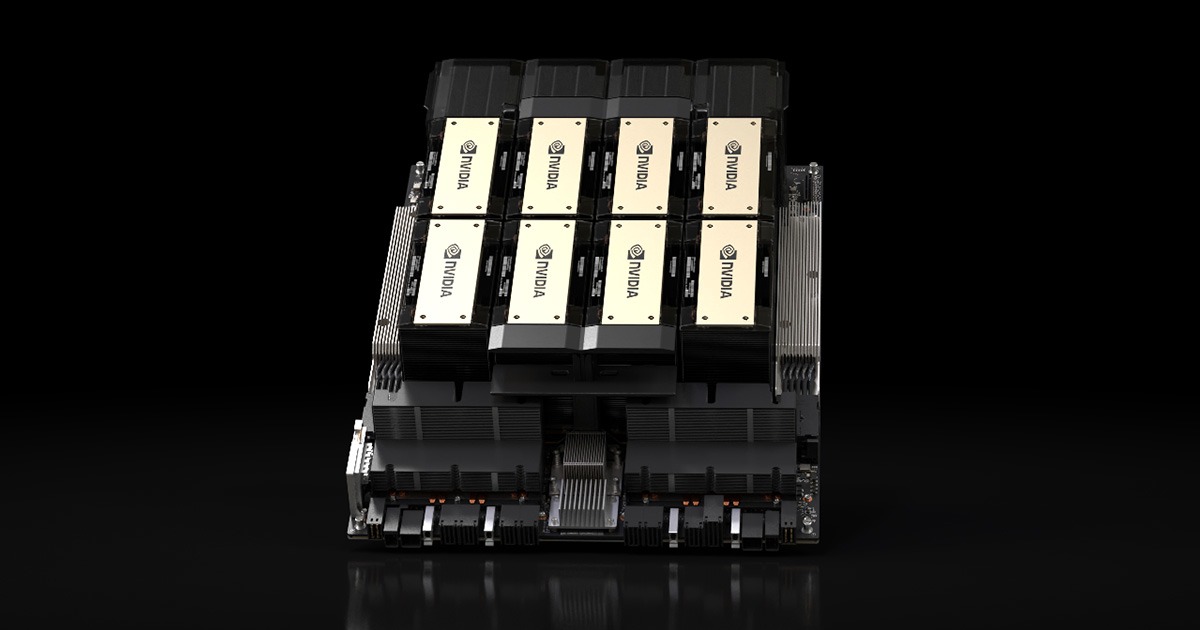
H200 NVL
Resumen OVERVIEW
H200 NVL es la Formato PCIe de doble ranura y refrigerado por aire de la NVIDIA H200: 141GB HBM3e de VRAM por tarjeta, 3,341 TFLOPS en FP8, 60 TFLOPS en FP64 Tensor, TDP configurable hasta 600W y puente NVLink 2/4-way a 900GB/s—— soporte de Confidential Computing (computación confidencial) Es su carta de presentación para el sector empresarial (según la ficha técnica oficial [1]).
Su relación con la versión en base HGX H200 (SXM): el mismo chip, formatos distintos ——la versión NVL es una tarjeta PCIe de doble ranura refrigerada por aire (instalación directa en servidores rack/torre), mientras que la versión en base HGX es un sistema completo SXM refrigerado por líquido/aire (4/8 GPUs con NVLink full mesh). Para compradores: la barrera de despliegue PCIe es un escalón más baja —No requiere un chasis especializado: se conecta directamente a un servidor x86 estándar (según la ficha técnica oficial [1]).
Comparación con la H100 NVL: 141GB frente a 94GB de VRAM (+50%), 4.8TB/s frente a 3.9TB/s de ancho de banda, ambos con 3,341 TFLOPS en FP8—— el H200 NVL es la actualización directa del H100 NVL en memoria , la opción con mejor relación coste-rendimiento para inferencia (según la comparativa oficial [1]). Esta entrada no incluye indicadores de mercado: el precio real está sujeto a la cotización del vendedor.
Casos de uso FIT
AIXX Index (0–100): estimación ponderada de esta biblioteca según especificaciones públicas — memoria 40% + interconexión 30% + ecosistema 30%.
Historia HISTORY
En 2024 , presentación del H200 NVL: el buque insignia PCIe de inferencia de la generación Hopper, la forma PCIe de doble ranura refrigerado por aire con las especificaciones principales del H200 (141 GB HBM3e / 3,341 FP8), con soporte de computación confidencial (según la ficha técnica oficial [1]).
2024-2025: , expansión de la inferencia: explosión de la demanda de inferencia online de grandes modelos——PCIe plug-and-play + 141GB de VRAM convierten al H200 NVL en uno de los motores de volumen en inferencia (según esta base de datos).
2025-2026 , Blackwell toma el relevo: lanzamiento de la serie RTX PRO 6000 Blackwell/B300——el H200 NVL pasa a circular como stock existente y en paralelo (según esta base de datos). Las políticas de comercio transfronterizo siguen evolucionando; esta base se basa en información pública y no constituye asesoría legal.
Especificaciones técnicas SPECIFICATIONS
| Concepto | Especificaciones (H200 NVL · cifras oficiales) |
|---|---|
| Arquitectura | NVIDIA Hopper |
| Memoria por tarjeta | 141GB HBM3e |
| Ancho de banda de memoria | 4.8TB/s |
| FP8 / INT8 | 3,341 TFLOPS / 3,341 TOPS |
| FP16 | 1,671 TFLOPS |
| FP64 / FP64 Tensor | 30 / 60 TFLOPS |
| FP32 | 60 TFLOPS |
| Interconexión | Puente NVLink 2/4-way: 900GB/s | PCIe Gen5: 128GB/s |
| Computación confidencial | Soportado (Confidential Computing) |
| MIG | Hasta 7 instancias @ 16.5GB |
| Códecs | 7 NVDEC | 7 JPEG |
| Consumo | Hasta 600W (configurable) |
| Formato | PCIe de doble ranura, refrigerado por aire |
Las especificaciones siguen la ficha oficial de NVIDIA (cifras de 2026-10 [1], verificadas punto por punto contra la Ficha técnica).
Comparativa de las dos formas del H200 TWO FORMS
| Concepto | H200 NVL(PCIe) | H200 SXM (base HGX) |
|---|---|---|
| Memoria | 141GB HBM3e | 141GB HBM3e |
| Interconexión | Puente NVLink 900GB/s (2/4 GPUs) | NVLink 900GB/s (full mesh multi-GPU) |
| Despliegue | Instalación directa en servidores x86 estándar | Sistema completo en base HGX |
| Selección en una frase | Inferencia / inserción directa en un solo equipo | Clústeres de entrenamiento a gran escala |
Miembros de la familia FAMILY
La familia H200 se divide por formato; la versión NVL es el buque insignia PCIe de inferencia:
Refrigeración y despliegue COOLING
El H200 NVL es tarjeta PCIe de doble ranura refrigerada por aire (hasta 600W configurable)——instalación directa en servidores x86 estándar, No requiere chasis con sustrato HGX (según la ficha técnica oficial [1]). Tabla de despliegue en tres pasos: Alimentación (la configuración de 600W requiere una fuente de alimentación y cableado suficientes) y conexión directa PCIe Gen5 (x16 directa a la CPU, sin pasar por switch para no perder ancho de banda), flujo de aire (el flujo de aire en doble ranura a 600W de plena carga presiona más que el segmento de 300W——control de la temperatura de entrada).
Despliegue de Confidential Computing: requiere activación en tres capas (BIOS/driver/framework)——en escenarios de cumplimiento financiero/gubernamental se recomienda verificar capa por capa en la aceptación (según esta base de datos).
Adaptación de modelos MODEL FIT
| Modelo / escenario | Requisitos de memoria (estimación FP16) | Criterios de despliegue del H200 NVL | AIXX Index |
|---|---|---|---|
| Inferencia 70B (FP16) | unos 140GB | Instalación directa con 141GB límite + ajuste fino del KV cache——holgura amplia tras cuantización INT8/FP8 | 88 |
| Inferencia de grandes modelos (FP8) | Pesos FP8 ≈ 70GB (70B) | Holgura por tarjeta + división multiusuario con MIG | 90 |
| Inferencia con contexto largo | El KV cache crece linealmente con la longitud | Espacio de KV cache de 141GB——superior a la gama de 80GB en contextos largos | 86 |
| Entrenamiento de grandes modelos | — | Interconexión PCIe limitada — para entrenamiento a gran escala, la serie HGX SXM | 60 |
Galería GALLERY
Software y ecosistema ECOSYSTEM
| Concepto | Requisito / Situación actual |
|---|---|
| CUDA | Generación Hopper (capacidad de cómputo 9.0) — compatible desde CUDA 11.8 |
| Frameworks | Soporte completo de PyTorch / TensorFlow / vLLM / TensorRT |
| Computación confidencial | Confidential Computing——verificación item por item en la capa de framework (según esta base de datos) |
| Driver | Línea de drivers de datacenter de NVIDIA (compartida con la H100) |
Compra e inspección PROCUREMENT
Puntos de inspección al comprar un H200 NVL (tres):
Guía rápida de aceptación QUICK CHECK
Verificación rápida del H200 NVL en cuatro pasos:
Transporte y entrega LOGISTICS
Fichas de términos GLOSSARY
Computación confidencial (Confidential Computing)
Protección de datos a nivel de hardware: los datos en la VRAM de la GPU se cifran durante el cómputo——incluso si la memoria del sistema se ve comprometida, el modelo y los datos en la VRAM permanecen protegidos. Argumento empresarial clave en sectores con requisitos de cumplimiento como finanzas/gobierno/salud (según la ficha técnica oficial).
Nomenclatura NVL
En los productos NVIDIA, el sufijo NVL = tarjeta PCIe con puente NVLink——el H200 NVL logra una interconexión GPU-GPU de 900GB/s mediante puente NVLink 2/4-way (no el full mesh de la base SXM).
MIG(Multi-Instance GPU)
Una tarjeta, múltiples instancias: el H200 NVL soporta hasta 7 instancias (versión 80GB: 10GB/instancia, versión 94GB: 12GB/instancia, H200 NVL: 16.5GB/instancia)——la base de hardware para el pooling de inferencia multiusuario.
Limitaciones y controversias LIMITS
- Techo de la interconexión PCIe : el puente NVLink está limitado a 2/4 GPUs (cifra de puente de 900GB/s)——la densidad de interconexión para entrenamiento a gran escala es muy inferior a la de la base HGX SXM (según esta base de datos).
- FP64 no es su fuerte : 30 TFLOPS en FP64——para escenarios HPC de doble precisión, comparar con la A100 (19.5 TFLOPS FP32, no FP64) requiere evaluación item por item.
- Posicionamiento entrenamiento vs. inferencia : formato PCIe sin dominio NVLink——para entrenamiento a gran escala, mirar la serie HGX SXM; el punto óptimo del H200 NVL está en inferencia y cumplimiento.
- Planificación del consumo configurable : hasta 600W configurable——el nivel de consumo exige flexibilidad en alimentación y refrigeración del centro de datos; especificar el nivel de consumo en el contrato de compra.
- Variable política del comercio transfronterizo : el H200 fue aprobado para China en diciembre de 2025 (según reportes públicos, ver ficha H200)——el estado de aprobación del H200 NVL evoluciona con las políticas; prevalece la asesoría profesional.
Notas de mercado MARKET NOTE
El stock del H200 NVL combina unidades nuevas de fábrica y recicladas de sistemas completos—— Principio de honestidad de este repositorio: no publicamos bandas de mercado; el precio real está sujeto a la cotización del vendedor 。
Búsqueda de unidades en venta: AIXX Exchange Hall › (intermediación sin comisión, por eso los datos son neutros).
Hitos de precios MILESTONES
Preguntas frecuentes FAQ
Frontera por formato de despliegue: para instalación directa PCIe (servidor x86 estándar/torre), elegir NVL——el sistema completo en base HGX (4/8 GPUs con NVLink full mesh) es ideal para clústeres de entrenamiento a gran escala. Ambos comparten la gama de 141GB de VRAM.
Actualización directa de memoria: 141GB frente a 94GB (+50 %), ancho de banda de 4,8TB/s frente a 3,9TB/s, potencia FP8 en la misma categoría — en inferencia, el coste por GB de memoria del H200 NVL es más favorable.
Cifrado del proceso de cómputo en la VRAM de la GPU——es imprescindible en escenarios con fuertes requisitos de cumplimiento (finanzas/gobierno/salud); la inferencia ordinaria puede prescindir de ella (activarla conlleva una ligera sobrecarga de rendimiento, inferior al 5% según el sector). Los requisitos de cumplimiento guían la elección.
Cuatro pasos: identificación (nvidia-smi 141GB/ECC) → prueba de burn-in a plena carga a 600W (temperatura/cero errores ECC) → benchmark de cómputo FP8 (≥80% Aprobado, criterio estimado) → prueba real de división MIG en 7 instancias.
El H200 fue aprobado para China en diciembre de 2025 (según reportes públicos, ver ficha H200)——para el estado de aprobación del formato PCIe del H200 NVL, se recomienda consultar las políticas más recientes y asesoría profesional; esta base no constituye asesoría legal.
Entradas relacionadas SEE ALSO
Comparativa y elección de modelos COMPARE
Referencias REFERENCES
- NVIDIA oficial — Ficha técnica del H200 NVL (coincide item por item con la ficha técnica, cifras de octubre 2026) https://www.nvidia.com/en-us/data-center/h200/
- Sitio web de NVIDIA — Línea de productos H200 (criterio de comparativa familiar) https://www.nvidia.com/en-us/data-center/h200/
- Búsqueda en el mercado — AIXX Exchange (Intermediación sin comisión; el H200 NVL aún no tiene instantánea de mercado, El precio real está sujeto a la cotización del vendedor) https://www.aixx.vip/hall.html?model=H200%20NVL