AIXX Pedia › Modelleintrag › H200 NVL
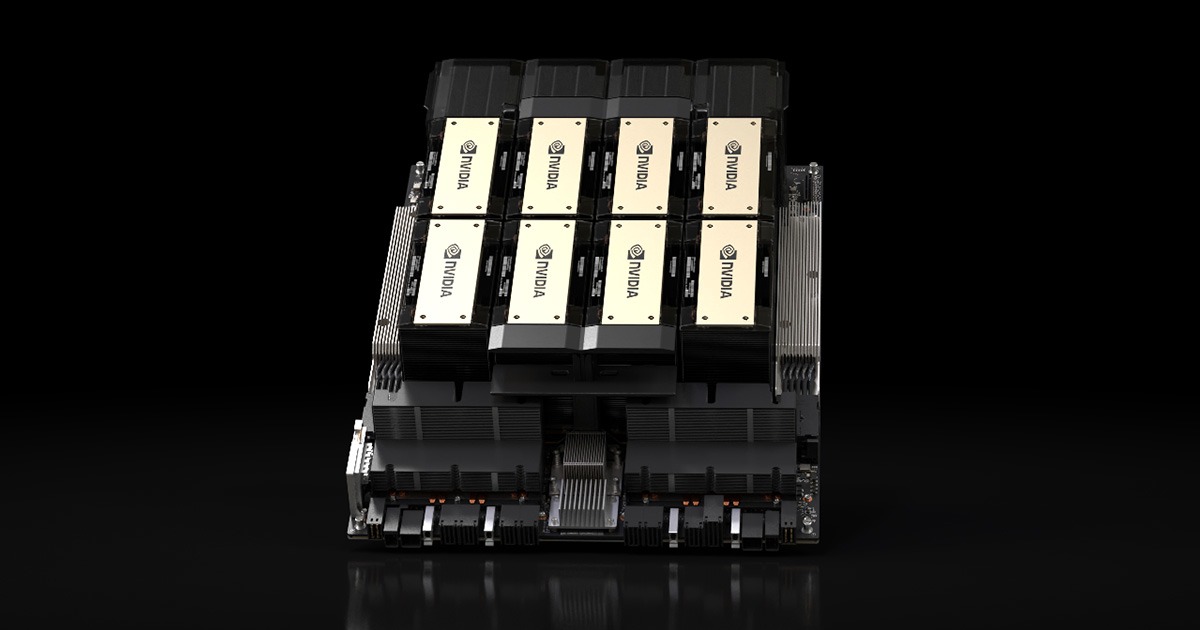
H200 NVL
Überblick OVERVIEW
H200 NVL ist die PCIe im Dual-Slot-Luftkühlungsformat der NVIDIA H200: 141GB HBM3e Speicher pro Karte, FP8 3.341 TFLOPS, FP64 Tensor 60 TFLOPS, Leistung konfigurierbar bis 600W, 2/4-way NVLink-Bridge mit 900GB/s — Confidential-Computing-Unterstützung ist seine Visitenkarte im Enterprise-Segment (lt. offiziellem Spezifikations-Snapshot [1]).
Verhältnis zur HGX-H200-Basismodul-Version (SXM): gleicher Chip, anderes Format — Die NVL-Version ist eine Dual-Slot-PCIe-Karte mit Luftkühlung (direkt steckbar in Rack-/Tower-Servern), die HGX-Basismodul-Version ein SXM-Komplettsystem mit flüssigkeitsgekühlter/luftgekühlter Full-Mesh-Vernetzung von 4/8 GPUs über NVLink. Für Einkäufer: die PCIe-Einstiegshürde ist eine Stufe niedriger – kein Baseboard-System erforderlich, lässt sich direkt inStandard-x86-Servern einsetzen (lt. offiziellem Spezifikations-Snapshot [1]).
Vergleich mit der H100 NVL: Speicher 141GB vs. 94GB (+50 %), Bandbreite 4,8TB/s vs. 3,9TB/s, FP8 identisch mit 3.341 TFLOPS — die H200 NVL ist das direkte Speicher-Upgrade der H100 NVL – die preiswerte Wahl für Inferenz-Szenarien (lt. offiziellem Vergleichsmaßstab [1]). Dieser Eintrag enthält keine Marktdaten – Der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers.
Einsatzszenarien FIT
AIXX Index (0–100): Das Archiv gewichtet öffentliche Spezifikationen — Speicher 40% + Interconnect 30% + Ökosystem 30%.
Historie HISTORY
2024 – Vorstellung des H200 NVL: das PCIe-Inferenz-Flaggschiff der Hopper-Generation – die H200-Kernspezifikationen (141 GB HBM3e/FP8 3.341) in luftgekühlter PCIe-Dual-Slot-Bauform, mit Confidential-Computing-Unterstützung (lt. offiziellem Spezifikations-Snapshot [1]).
2024–2025 : Inferenz-Boom — die Nachfrage nach Online-Inferenz großer Modelle explodiert; Plug-and-Play-PCIe plus 141GB großer Speicher machen die H200 NVL zu einer der Volumen-Stützen im Inferenzbereich (Erfassung dieser Datenbank).
2025–2026 : Blackwell übernimmt — Launch der RTX PRO 6000 Blackwell-/B300-Serie; die H200 NVL geht in Bestands- und Parallelhandel über (Erfassung dieser Datenbank). Die Politik zum grenzüberschreitenden Handel befindet sich noch in Entwicklung; diese Angaben beruhen auf öffentlichen Berichten und stellen keine Rechtsberatung dar.
Technische Daten SPECIFICATIONS
| Position | Spezifikationen (H200 NVL · offizielle Basis) |
|---|---|
| Architektur | NVIDIA Hopper |
| Speicher pro Karte | 141GB HBM3e |
| VRAM-Bandbreite | 4.8TB/s |
| FP8 / INT8 | 3,341 TFLOPS / 3,341 TOPS |
| FP16 | 1,671 TFLOPS |
| FP64 / FP64 Tensor | 30 / 60 TFLOPS |
| FP32 | 60 TFLOPS |
| Interconnect | NVLink-Bridge 2/4-way: 900GB/s | PCIe Gen5: 128GB/s |
| Confidential Computing | Unterstützung (Confidential Computing) |
| MIG | Bis zu 7 Instanzen à 16,5GB |
| Codecs | 7 NVDEC | 7 JPEG |
| Verbrauch | Bis zu 600W (konfigurierbar) |
| Formfaktor | PCIe Dual-Slot, luftgekühlt |
Spezifikationen gemäß offiziellem NVIDIA-Snapshot (Stand 2026-10[1], vollständig mit dem Spec-Card abgeglichen).
Vergleich der beiden H200-Familienvarianten TWO FORMS
| Position | H200 NVL(PCIe) | H200 SXM (HGX-Basismodul) |
|---|---|---|
| Speicher | 141GB HBM3e | 141GB HBM3e |
| Interconnect | NVLink-Bridge 900GB/s (2/4 Karten) | NVLink 900GB/s (Multi-GPU-Full-Mesh) |
| Deployment | Direkt in Standard-x86-Servern | HGX-Basismodul-Komplettsystem |
| Auswahl in einem Satz | Inferenz / direkter Einbau | Großes Trainingscluster |
Familienmitglieder FAMILY
Die H200-Familie gliedert sich nach Formfaktor; die NVL-Version ist das PCIe-Inferenz-Flaggschiff:
Kühlung und Deployment COOLING
Die H200 NVL ist PCIe-Dual-Slot-Karte mit Luftkühlung (bis zu 600W konfigurierbar) — direkt in Standard-x86-Servern einsetzbar, kein HGX-Basistray-Gesamtsystem nötig (gemäß offiziellem Spec-Snapshot[1]). Checkliste für den Einsatz: Stromversorgung (die 600W-Stufe erfordert ausreichend dimensioniertes PSU und Stromkabel), PCIe Gen5 direkt (x16 direkt an die CPU; über einen Switch leidet die Bandbreite), Luftführung (der Luftdurchsatz durch zwei Slots bei 600W Volllast stellt höhere Anforderungen als die 300W-Klasse — Zulufttemperatur kontrollieren).
Confidential-Computing-Deployment: CC muss auf drei Ebenen aktiviert werden — BIOS, Treiber, Framework. In konformitätskritischen Umgebungen (Finanzen/Behörden) empfiehlt sich bei der Abnahme eine schichtweise Prüfung (Erfassung dieser Datenbank).
Modellkompatibilität MODEL FIT
| Modell / Szenario | Speicherbedarf (FP16-Schätzung) | Deployment-Basis H200 NVL | AIXX Index |
|---|---|---|---|
| Einsatzszenarien der MI325X | 70B-Klasse-Inferenz (FP16) | 141GB pro Karte: direkte Installation am Limit plus sparsame KV-Cache-Planung — nach INT8/FP8-Quantisierung ausreichend Reserve | 88 |
| Große-Modell-Inferenz (FP8) | FP8-Gewichte ca. 70GB (70B) | Ausreichende Reserve pro Karte + MIG-Aufteilung auf mehrere Tenants | 90 |
| Inferenz mit langem Kontext | Inferenz mit sehr langen Kontexten | 141GB für KV-Cache — bei langen Kontexten der 80GB-Klasse überlegen | 86 |
| 256GB KV-Cache-Raum sind die Stärke der MI-Serie | — | PCIe-Interconnect limitiert — für großes Training die HGX-SXM-Serie ansehen | 60 |
Bildergalerie GALLERY
Software & Ökosystem ECOSYSTEM
| Position | Anforderung / Status |
|---|---|
| CUDA | Hopper-Generation (Compute Capability 9.0) — ab CUDA 11.8 unterstützt |
| Frameworks | PyTorch / TensorFlow / vLLM / TensorRT vollständig unterstützt |
| Confidential Computing | Confidential Computing — schichtweise Verifikation der Framework-Unterstützung (Erfassung dieser Datenbank) |
| Treiber | NVIDIA-Datacenter-Treiberlinie (gemeinsam mit H100) |
Beschaffung und Warenprüfung PROCUREMENT
Abnahme-Prüfpunkte beim Kauf der H200 NVL (drei Punkte):
Abnahme-Schnellübersicht QUICK CHECK
H200 NVL in vier Schritten prüfen:
Versand & Auslieferung LOGISTICS
Glossarkarten GLOSSARY
Confidential Computing
Hardwarebasierte Datenverschlüsselung: Daten im GPU-Speicher werden während der Berechnung verschlüsselt — selbst bei Kompromittierung des Systemspeichers bleiben Modell und Daten im GPU-Speicher geschützt. Enterprise-Argument für compliance-sensible Branchen wie Finanzen, Behörden und Gesundheitswesen (Stand des offiziellen Spezifikations-Snapshots).
NVL-Bezeichnung
Bei NVIDIA-Produkten bedeutet der Zusatz NVL: PCIe-Karte mit NVLink-Bridge — die H200 NVL erreicht über die 2/4-way-NVLink-Bridge 900GB/s GPU-zu-GPU-Interconnect (keine SXM-Full-Mesh-Vernetzung).
MIG(Multi-Instance GPU)
Mehrere Instanzen pro Karte: Die H200 NVL unterstützt bis zu 7 Instanzen (80GB-Version 10GB/Instanz, 94GB-Version 12GB/Instanz, H200 NVL 16,5GB/Instanz) — die Hardware-Grundlage für Multi-Tenant-Inferenz-Pooling.
Grenzen & Kontroversen LIMITS
- PCIe-Interconnect-Grenze : NVLink-Bridge auf 2/4 Karten begrenzt (Basis 900GB/s-Bridge) — die Interconnect-Dichte reicht für großes Training deutlich nicht an ein HGX-SXM-Basismodul heran (Erfassung dieser Datenbank).
- FP64 nicht der Fokus : FP64 30 TFLOPS — für Double-Precision-HPC ist ein Einzelvergleich mit der A100 (19,5 TFLOPS FP32, nicht FP64-Basis) nötig.
- Training vs. Inferenz-Positionierung : PCIe-Form ohne NVLink-Domain — für großes Training gilt die HGX-SXM-Serie; der Sweet Spot der H200 NVL liegt bei Inferenz und Compliance.
- Planung des konfigurierbaren Verbrauchs : bis zu 600W konfigurierbar — die Leistungsstufe stellt hohe Anforderungen an Stromversorgung und Kühlung des Rechenzentrums; die Stufe im Kaufvertrag festhalten.
- Politische Variablen des grenzüberschreitenden Handels : Die H200 erhielt im Dezember 2025 die Freigabe für China (Stand öffentlicher Berichte, siehe H200-Eintrag) — der Freigabestatus der H200 NVL entwickelt sich mit der Politik weiter; maßgeblich ist eine professionelle Beratung.
Marktlage MARKET NOTE
Beim H200-NVL-Spotbestand laufen Originalware und aus Systemen ausgebaute Karten parallel — Ehrlichkeitsprinzip dieser Datenbank: kein Marktdatenband; der Preis richtet sich nach dem tatsächlichen Angebot des Verkäufers 。
Angebotssuche: AIXX Markthalle › (Provisionsfreie Vermittlung, dadurch neutrale Daten).
Wichtige Preisereignisse MILESTONES
FAQ FAQ
Grenze der Deployment-Form: Für PCIe-Direktinstallation (Standard-x86-Server/Tower) die NVL — HGX-Basismodul-Systeme (4/8-Karten-NVLink-Full-Mesh) passen zu großen Trainingsclustern. Beide haben dieselbe 141GB-Speicherstufe.
Direktes Speicherupgrade: 141GB gegenüber 94GB (+50 %), Bandbreite 4,8 TB/s vs. 3,9 TB/s, FP8 auf gleichem Niveau — bei Inferenz ist die Speicherkosten-Effizienz der H200 NVL besser.
Verschlüsselung der Berechnung im GPU-Speicher — in stark regulierten Bereichen wie Finanzen, Behörden und Gesundheitswesen Pflicht, bei normaler Inferenz verzichtbar (bei Aktivierung leichter Leistungseinbußen, branchenüblich unter ca. 5 %). Die Compliance-Anforderung treibt die Auswahl.
Vier Schritte: Identifikation (nvidia-smi 141GB/ECC) → Burn-in-Test auf der 600W-Stufe (Temperatur/null ECC-Fehler) → FP8-Rechenleistungs-Benchmark (≥80 % Bestanden, Kalkulationsbasis) → praktische MIG-Aufteilung in 7 Instanzen.
Die H200 erhielt im Dezember 2025 die Freigabe für China (Stand öffentlicher Berichte, siehe H200-Eintrag) — zum Freigabestatus der PCIe-Variante H200 NVL sollten aktuelle Politik und professionelle Beratung maßgeblich sein; diese Datenbank stellt keine Rechtsberatung dar.
Verwandte Einträge SEE ALSO
Modellvergleich und Auswahl COMPARE
Quellen REFERENCES
- NVIDIA offiziell — H200-NVL-Spezifikations-Snapshot (punktuell deckungsgleich mit der Spec-Card, Stand 10/2026) https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA-Website — H200-Produktlinie (Familienvergleichsbasis) https://www.nvidia.com/en-us/data-center/h200/
- Angebotsuche — AIXX Börse (provisionsfreie Vermittlung; für die H200 NVL liegt kein Marktsnapshot vor, der Preis richtet sich nach dem Angebot des Verkäufers) https://www.aixx.vip/hall.html?model=H200%20NVL