AIXX Pedia › Verbete de hardware › Grace CPU
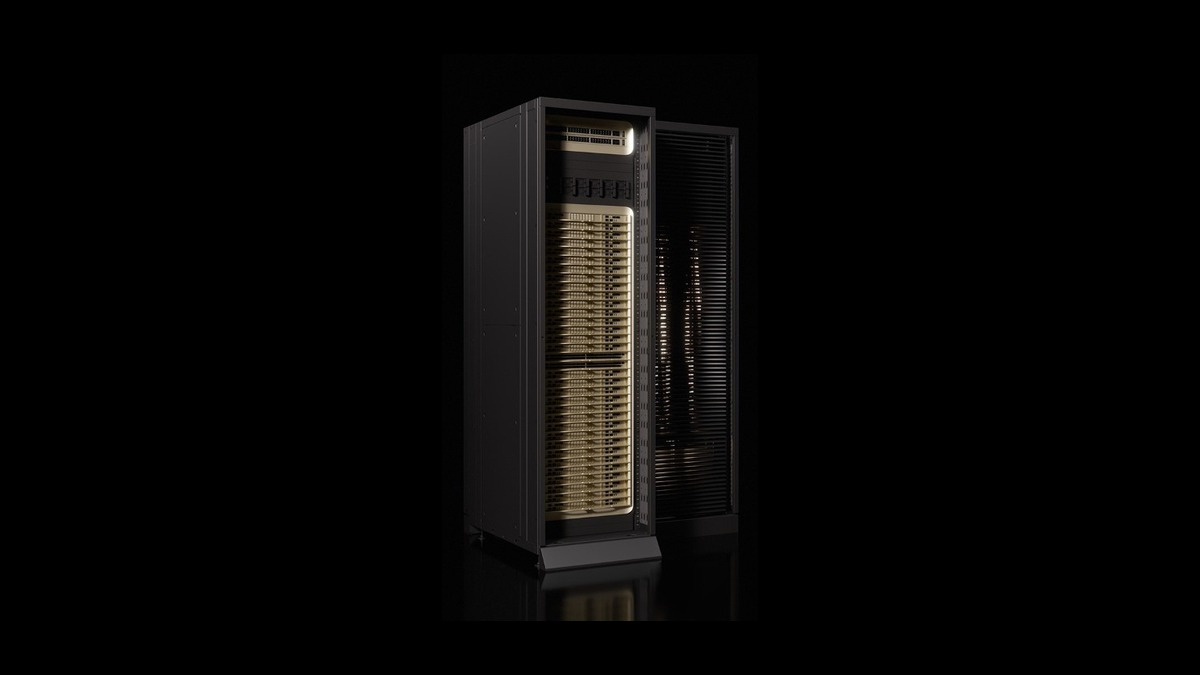
Grace CPU
Visão geral OVERVIEW
Grace é a Marcas de CPUs de data center ——A primeira CPU desenvolvida pela própria NVIDIA: um processador de 72 núcleos baseado nos núcleos Arm Neoverse V2, projetado para o enorme throughput de memória exigido por IA e HPC (segundo a página oficial da NVIDIA[1]). Raramente aparece sozinha: seu papel principal é como superchips Grace Hopper (GH200) e Grace Blackwell (GB200/GB300) —interligada à GPU pelo interconect entre chips NVLink-C2C, formando um superchip «CPU+GPU» integrado.
O sentido da sua existência é refazer a relação entre CPU e GPU : nas arquiteturas tradicionais, CPU e GPU estão separadas pelo PCIe, com dados sendo copiados de um lado para o outro; entre a Grace e a GPU há a interconexão coerente NVLink-C2C (na casa dos 900 GB/s segundo o GB200[2]) — pela ótica do software, a memória da CPU e a memória da GPU formam um conjunto único. Bancos de dados vetoriais, processamento de dados e gerenciamento de KV cache, tarefas tipicamente "do lado da CPU", passam a usufruir diretamente de largura de banda nível GPU.
No mercado de pronta entrega de 2026, a Grace circula como componente dos racks GB200/GB300 (36 unidades por rack); a forma independente (Grace CPU Superchip vendida isoladamente) é rara. Este verbete não traz faixa de preços—o preço real está sujeito à cotação do vendedor.
Cenários de uso FIT
AIXX Index (0–100): ponderado pelo grau de adequação a cenários de cooperação CPU-GPU (critério especializado em conceitos de software).
Histórico HISTORY
Abril de 2021 , a Grace é anunciada na GTC: a NVIDIA declara sua entrada no mercado de CPUs — uma CPU de data center voltada para IA e HPC construída sobre núcleos Arm Neoverse, com nome em homenagem à pioneira da arquitetura de computadores Grace Hopper (segundo a página oficial da NVIDIA e o anúncio na GTC[1]).
2022-2023 , o superchip se torna realidade: o Grace Hopper (GH200, Grace+H100 via NVLink-C2C) é o primeiro a ser enviado, e o kernel Linux e as principais distribuições completam a adaptação ao ecossistema Arm — a "memória coerente CPU+GPU" sai do papel e vira produto (segundo a página oficial[1]).
2024–2025 : a geração GB ganha escala: a Grace Blackwell (GB200) e a GB300 levam a Grace ao papel de protagonista em nível de rack—a GB200 NVL72 tem 36 Grace por rack abastecendo 72 B200, e o grande pool de LPDDR5X se torna a «segunda camada de VRAM» do rack (critério do verbete GB200).
Em 2026 : posicionamento no mercado de pronta entrega—a Grace circula com os racks da série GB, e a forma independente é rara. O campo das CPUs de data center Arm (Grace/AWS Graviton/Ampere etc.) cresce no conjunto, mas na corrida dos superchips de IA a Grace segue sendo caso único de «CPU desenvolvida por um grande fabricante de GPUs». As políticas de circulação transfronteiriça de chips de data center ainda evoluem; na compra, prevalecem as políticas dos órgãos reguladores e parecer profissional (critério de reportagens públicas).
Especificações técnicas SPECIFICATIONS
| Item | Especificações (NVIDIA Grace CPU Superchip · dados oficiais) |
|---|---|
| Núcleo | 72 núcleos Arm Neoverse V2 (por superchip) |
| Memória | LPDDR5X ECC—memória de alta banda orientada à eficiência energética (capacidade conforme configuração) |
| Interconect | NVLink-C2C — interconexão coerente CPU↔GPU (na casa dos 900 GB/s segundo o GB200[2]) |
| Formato de superchip | Grace Hopper(GH200:Grace+H100)· Grace Blackwell(GB200:2×B200+1×Grace) |
| Papel no rack | GB200/GB300 NVL72: 36 Grace por rack (72 núcleos ×36 = 2592 núcleos/rack) |
| Ecossistema de software | Linux (versões Arm das principais distribuições) · suporte nativo à pilha completa NVIDIA |
| Lançamento | Marca anunciada no GTC de 2021-04 · GH200 embarcada em 2023 · GB200 anunciada em 2024-03 |
As especificações seguem a página oficial da NVIDIA (dados de 2026-10)[1]; detalhes de clocks/consumo/capacidade de memória devem ser confirmados na configuração do superchip e do sistema correspondente — o que não consta nesta tabela não foi verificado, e não inventamos.
O lugar da Grace nos racks da série GB IN THE RACK
| Camada | Componente | Relação com a Grace |
|---|---|---|
| Nível de chip | Superchip Grace Blackwell (2 B200 + 1 Grace) | Interconect coerente NVLink-C2C—memória da CPU e VRAM da GPU unificadas na visão do software |
| Nível de bandeja | Bandeja de computação (4 GPUs + 2 Grace por bandeja) | A Grace cuida do processamento e da orquestração no nível da bandeja |
| Nível rack | GB200/GB300 NVL72 | 36 Grace por rack · pool de memória de até 17TB LPDDR5X (critério de rack) |
O critério de camadas é o mesmo do verbete GB200 NVL72; a configuração da Grace na GB300 deve seguir a documentação do fabricante do servidor.
Membros da família FAMILY
A família Grace se divide por combinação de superchip; a Grace é o corpo do lado CPU da série GB:
Refrigeração e implantação COOLING
A Grace não é implantada como servidor independente—ela vem soldada nos superchips e bandejas de computação, com refrigeração definida pelo projeto do servidor (a série GB é toda refrigerado a líquido). Na visão de implantação, a Grace é um problema de pilha de software : a arquitetura Arm exige confirmar a disponibilidade de versões Arm de todo o software hospedeiro (agentes de monitoramento, componentes de segurança, toolchains próprias)—as principais distribuições Linux e a pilha completa NVIDIA já têm suporte nativo, mas o software de cauda longa dentro das empresas precisa ser inventariado um a um (critério de organização desta base).
Itens de verificação do lado Grace na aceitação de racks usados: as 36 CPUs identificadas e no lugar, saúde dos links NVLink-C2C (verificada no mesmo lote da aceitação do domínio NVLink), e capacidade/configuração da memória LPDDR5X conferida com a documentação de remessa—a manutenção em nível de bandeja em caso de falha da Grace depende do canal do fabricante; confirme o caminho de garantia na compra.
Adequação de cenários WORKLOAD FIT
| Carga de trabalho | Critérios de desempenho da Grace | AIXX Index |
|---|---|---|
| Pipeline de dados de treinamento | Pré-processamento/aumento/tokenização no lado CPU consumindo diretamente a banda do NVLink-C2C para alimentar a GPU | 86 |
| Banco vetorial / busca | Grande pool de memória + interconect coerente: ajuste natural para a camada de dados quentes da busca vetorial | 83 |
| Escalonamento de KV cache na inferência | O grande pool de LPDDR5X como camada de estouro da VRAM da GPU (critério do verbete GB200) | 83 |
| Portabilidade de aplicações x86 genéricas | Viável no ecossistema Arm, mas não é o propósito—siga o critério de «substituição genérica» na tabela acima | 45 |
As faixas de carga são compilações desta base a partir de especificações públicas (estimativas, não constituem promessa de desempenho).
Galeria GALLERY
Fotos reais continuam sendo adicionadas conforme os lotes de inspeção; imagens geradas por IA não são apresentadas como fotos reais.
Software e ecossistema ECOSYSTEM
| Item | Requisitos / situação atual |
|---|---|
| Sistema operacional | Versões Arm das principais distribuições Linux (linha Ubuntu/RHEL etc., critério de suporte oficial) |
| Pilha completa NVIDIA | CUDA/drivers/NCCL etc. com suporte nativo à Grace—pilhas de software entregues integradas nos racks da série GB |
| Framework | Rodas Arm disponíveis para frameworks de IA como PyTorch/TensorFlow, com componentes de dados (DALI etc.) junto à stack NVIDIA |
| Containerização | Ecossistema de imagens de contêiner Arm maduro (imagens multiarquitetura já são padrão do setor) |
| Alerta de inventário | Confirmar caso a caso a disponibilidade de versões Arm das ferramentas próprias/agentes de segurança da empresa—o principal ponto de atrito da migração (critério de organização desta base) |
O ecossistema Arm de data center amadureceu com anos de cultivo por produtos como o AWS Graviton; as versões evoluem com o tempo—prevalecem os anúncios oficiais da NVIDIA.
Aquisição e aceitação PROCUREMENT
Três pontos de aceitação para compras relacionadas à Grace (junto com racks da série GB):
Consulta rápida de verificação QUICK CHECK
Verificação rápida do lado Grace em quatro passos (executar na aceitação dos racks da série GB):
Transporte e entrega LOGISTICS
Cartões de terminologia GLOSSARY
NVLink-C2C
Interconect chip a chip: o interconect coerente de alta velocidade entre a Grace e a GPU (na casa dos 900GB/s no caso da GB200)—une a memória da CPU e a VRAM da GPU na visão do software, e é o que diferencia a Grace de uma «CPU externa».
LPDDR5X
Versão de baixo consumo da memória LPDDR5: a escolha de memória da Grace—orientada à eficiência energética e de alta banda, a serviço do posicionamento de «grande pool de memória do lado CPU alimentando a GPU» (pool de memória na casa dos 17TB no rack GB200).
Superchip
A combinação empacotada Grace+GPU: Grace Hopper (GH200), Grace Blackwell (série GB200)—comprime a «relação de placa-mãe entre CPU e GPU» numa «relação de encapsulamento de chip», reconstruindo por completo a banda de interconexão e as restrições de coerência.
Neoverse V2
O IP de núcleos de data center da Arm: os 72 núcleos Neoverse V2 adotados pela Grace—a mesma linhagem Arm de data center do AWS Graviton3/Ampere One, com toolchains de ecossistema compartilhadas.
Vera CPU
A próxima geração de CPU no roteiro público da NVIDIA (revelada junto com a plataforma Vera Rubin)—a sucessora da Grace; o critério do roteiro prevalece conforme os anúncios oficiais da NVIDIA.
Limitações e controvérsias LIMITS
- Forma independente rara : a Grace circula quase exclusivamente nos superchips da série GB—projetos que queiram um «servidor Grace» isolado devem confirmar se o fabricante tem uma solução correspondente (critério de organização desta base).
- Custo de inventário da pilha de software Arm : a disponibilidade de versões Arm do software de cauda longa da empresa precisa ser confirmada caso a caso—distribuições principais e a stack NVIDIA já têm suporte nativo; o atrito está nas ferramentas próprias e no software legado (critério de organização desta base).
- Limites de compatibilidade com o ecossistema x86 : alguns binários/drivers exclusivos de x86 (como ferramentas de firmware de certas placas HBA) não funcionam em Arm—a seleção de placas de expansão nos racks da série GB deve verificar o suporte Arm.
- Canal de manutenção dependente do fabricante : a Grace vem soldada na bandeja e a reparação passa pela troca de bandeja pelo fabricante—na compra de racks usados, o caminho de garantia e o canal de peças devem constar em contrato (critério de experiência de inspeção desta base).
- Variável de política de circulação internacional :Os superchips da série GB são modelos sensíveis a controles de exportação (segundo reportagens públicas) — este verbete serve apenas como alerta sobre a evolução regulatória e não constitui parecer jurídico.
Notas de mercado MARKET NOTE
Grace circula como parte dos racks da série GB; não existe cotação independente — Princípio de honestidade da AIXX Pedia: sem faixa de mercado; o preço está sujeito à cotação do vendedor (os preços seguem o nível de rack, conforme os verbetes GB200/GB300 NVL72).
Busca de ofertas: Salão da AIXX Exchange › (Intermediação sem comissão, sem participação nas transações; por isso os dados são neutros).
Marcos históricos de preço MILESTONES
Perguntas frequentes FAQ
Não é essa a proposta: o Grace nasceu como superchip CPU+GPU, e seu valor está na interconexão coerente NVLink-C2C e no grande pool de memória — usá-lo isoladamente como servidor de propósito geral não é possível nem faz sentido. Para computação geral, o terreno segue sendo do x86 e dos servidores Arm de propósito geral (Graviton etc.).
Arquiteturas e cenários diferentes não permitem conversão direta — os pontos fortes do Grace são a largura de banda de memória e a cooperação CPU-GPU (NVLink-C2C); benchmarks gerais de throughput inteiro/ponto flutuante têm valor limitado. Na escolha, veja se sua carga é um pipeline de dados que alimenta GPUs: se sim, a combinação Grace+GPU tem grande vantagem; caso contrário, não force a comparação.
Manutenção em nível de tray: o Grace é soldado ao tray de computação, e falhas seguem o canal de substituição de trays do fabricante — ao comprar racks usados, o caminho de garantia e os trays sobressalentes devem constar em contrato; esse é um custo oculto dos equipamentos em nível de rack.
Está maduro: PyTorch/TensorFlow têm wheels para Arm, a NVIDIA oferece suporte nativo ao Grace em toda a pilha, e imagens de contêineres multiarquitetura já são padrão no setor — o atrito está nas ferramentas desenvolvidas internamente e no levantamento de versões Arm de softwares legados; faça um inventário antes da compra.
Indiretamente, sim: os racks da série GB substituem o posto de CPU do modelo tradicional "servidor x86 + GPU" — mas a competição ocorre no nicho de "lado CPU de clusters de IA"; no mercado geral de CPUs de data center, x86 e Arm de propósito geral seguem dominantes.
Entradas relacionadas SEE ALSO
Leituras complementares EXPLORE
Referências REFERENCES
- Site oficial da NVIDIA — página do produto Grace CPU (arquivo principal de especificações, dados de 2026-10) https://www.nvidia.com/en-us/data-center/grace-cpu/
- Site oficial da NVIDIA — página do produto GB200 NVL72 (papel do rack do Grace e especificação de 900GB/s do C2C) https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- Supermicro — SuperCluster GB200 NVL72 Datasheet (composição dos trays) https://www.supermicro.com/datasheet/datasheet_SuperCluster_…
- Busca de ofertas — AIXX Pedia (Intermediação sem comissão; o Grace circula junto aos racks da série GB, sem cotação independente) https://www.aixx.vip/hall.html?model=GB200