AIXX Pedia › Fiches matériel › Grace CPU
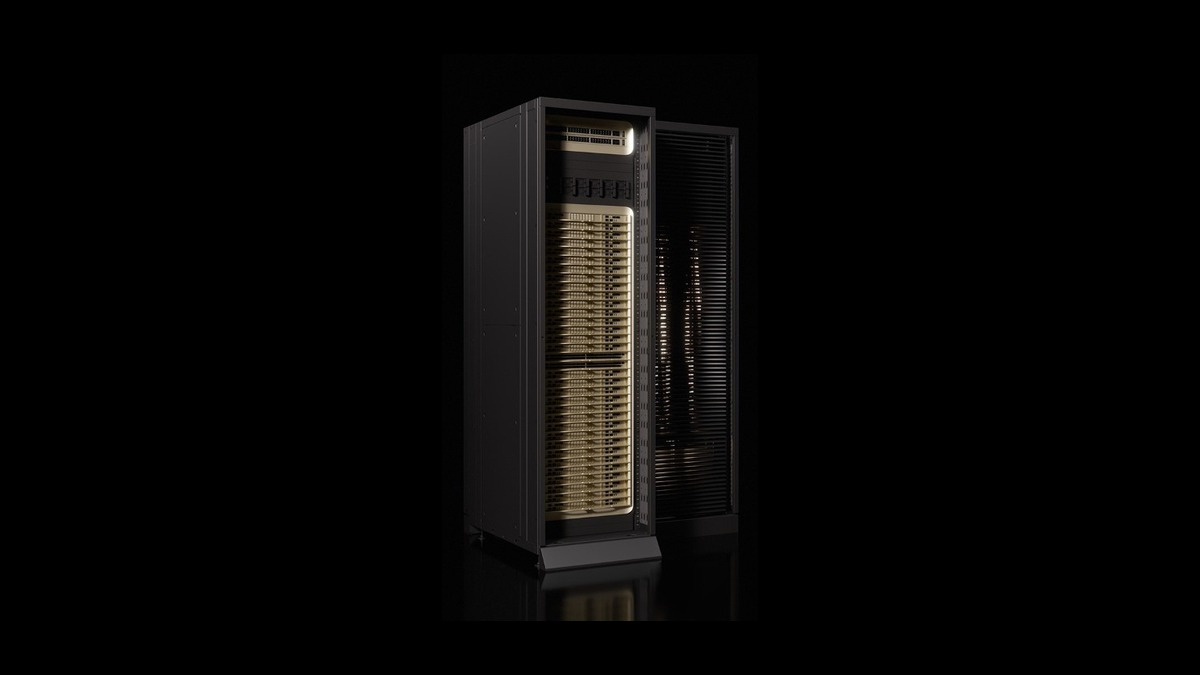
Grace CPU
Vue d'ensemble OVERVIEW
Grace est le Marques de CPU datacenter ——Premier CPU conçu en interne par NVIDIA : un processeur à 72 cœurs basé sur les cœurs Arm Neoverse V2, pensé pour les énormes débits mémoire exigés par l'IA et le HPC (selon la page officielle NVIDIA [1]). Il apparaît rarement seul : son rôle est celui de superchips Grace Hopper (GH200) et Grace Blackwell (GB200/GB300) — associé au GPU via l'interconnexion inter-puces NVLink-C2C pour former un superchip « CPU + GPU » unifié.
Sa raison d'être est de redéfinir la relation entre CPU et GPU : dans une architecture classique, le CPU et le GPU sont séparés par le PCIe, avec des allers-retours de copies de données ; entre Grace et le GPU, c'est une interconnexion cohérente NVLink-C2C (de l'ordre de 900 Go/s sur le GB200 [2]) — du point de vue logiciel, la mémoire CPU et la VRAM GPU forment un tout : les bases de données vectorielles, le traitement de données, la gestion du cache KV et autres « tâches côté CPU » bénéficient directement d'une bande passante de niveau GPU.
Sur le marché du spot en 2026, Grace circule comme composant des racks GB200/GB300 (36 unités par rack) ; la forme autonome (Grace CPU Superchip vendu seul) est rare. Cette fiche ne comporte pas de bande de cotations — le prix réel est soumis au devis du vendeur.
Cas d'usage FIT
AIXX Index (0–100) : pondéré selon l'adéquation aux scénarios de coopération CPU-GPU (critère spécialisé concepts logiciels).
Historique HISTORY
Avril 2021 , Grace dévoilé au GTC : NVIDIA annonce son entrée sur le marché des CPU — un CPU datacenter pour l'IA et le HPC bâti sur des cœurs Arm Neoverse, baptisé en hommage à la pionnière de l'architecture informatique Grace Hopper (d'après la page officielle NVIDIA et l'annonce GTC [1]).
2022-2023 , le superchip devient réalité : Grace Hopper (GH200, Grace + H100 reliés via NVLink-C2C) est expédié en premier, le noyau Linux et les distributions principales complètent l'adaptation à l'écosystème Arm — la « mémoire cohérente CPU+GPU » passe du papier au produit (d'après la page officielle [1]).
2024–2025 , montée en puissance génération GB : Grace Blackwell (GB200) et GB300 font de Grace le pilier à l'échelle du rack — le GB200 NVL72 embarque 36 Grace par rack pour alimenter 72 B200 en données, et le grand réservoir LPDDR5X devient la « seconde couche VRAM » du rack (fiche GB200).
En 2026 , positionnement spot : Grace circule avec les racks série GB, les formes autonomes sont rares. Le camp des CPU datacenter Arm (Grace/AWS Graviton/Ampere, etc.) progresse globalement, mais sur le créneau des superchips IA, Grace est pour l'instant le seul « CPU maison d'un fabricant de GPU ». Les politiques de circulation transfrontalière des puces datacenter évoluent encore ; lors des achats, référez-vous aux politiques des autorités compétentes et à un avis professionnel (selon les reportages publics).
Spécifications techniques SPECIFICATIONS
| Élément | Spécifications (NVIDIA Grace CPU Superchip · données officielles) |
|---|---|
| Cœurs | 72 cœurs Arm Neoverse V2 (superchip unique) |
| Mémoire | LPDDR5X ECC — mémoire à large bande passante orientée efficacité énergétique (capacité selon configuration) |
| Interconnexion | NVLink-C2C — l'interconnexion cohérente CPU↔GPU (de l'ordre de 900 Go/s sur le GB200 [2]) |
| Forme du superchip | Grace Hopper(GH200:Grace+H100)· Grace Blackwell(GB200:2×B200+1×Grace) |
| Rôle dans le rack | GB200/GB300 NVL72 : 36 Grace par rack (72 cœurs × 36 = 2592 cœurs/rack) |
| Écosystème logiciel | Linux (versions Arm des principales distributions) · support natif de la pile logicielle NVIDIA |
| Lancement | Marque annoncée au GTC 04-2021 · GH200 livré en 2023 · GB200 annoncé en 03-2024 |
Les spécifications font foi selon la page officielle NVIDIA (au 10/2026) [1] ; les détails d'horloge/consommation/capacité mémoire dépendent du superchip et de la configuration machine correspondants ; absent du tableau = non vérifié, sans invention.
Place de Grace dans les racks série GB IN THE RACK
| Niveau | Composant | Relation avec Grace |
|---|---|---|
| Niveau puce | Superchip Grace Blackwell (2 B200 + 1 Grace) | Interconnexion cohérente NVLink-C2C — mémoire CPU et VRAM GPU unifiées du point de vue logiciel |
| Niveau plateau | Plateau de calcul (4 GPU + 2 Grace par plateau) | Grace assure le traitement et l'orchestration des données au niveau du plateau |
| Niveau rack | GB200/GB300 NVL72 | 36 Grace par rack · jusqu'à 17 To de pool LPDDR5X (échelle rack) |
Les niveaux sont cohérents avec la fiche GB200 NVL72 ; pour la configuration Grace du GB300, se référer à la documentation du fabricant.
Membres de la famille FAMILY
La famille Grace se décline selon les combinaisons de superchips ; Grace est le corps CPU des racks série GB :
Refroidissement et déploiement COOLING
Grace ne se déploie pas sous forme de serveur autonome — il est soudé dans les superchips et les plateaux de calcul, et son refroidissement suit la solution machine complète (série GB entièrement refroidi par liquide). Du point de vue du déploiement, Grace est une question de pile logicielle : l'architecture Arm implique de vérifier la disponibilité de versions Arm pour tous les logiciels hôtes (agents de supervision, composants de sécurité, chaînes d'outils internes) — les principales distributions Linux et la pile NVIDIA offrent un support natif, mais la longue traîne logicielle de l'entreprise doit être passée en revue un par un (compilation de cette base).
Points de contrôle côté Grace lors de la réception de racks d'occasion : identification et présence des 36 CPU, santé des liens NVLink-C2C (à traiter dans la même campagne que la réception du domaine NVLink), conformité de la capacité et de la configuration LPDDR5X avec les documents d'expédition — la réparation au niveau plateau en cas de panne de Grace passe par le canal du fabricant ; validez le parcours de garantie dès l'achat.
Adéquation aux cas d'usage WORKLOAD FIT
| Charge de travail | Grille d'évaluation des performances de Grace | AIXX Index |
|---|---|---|
| Pipeline de données d'entraînement | Prétraitement / augmentation / tokenisation consommant directement la bande passante NVLink-C2C côté CPU pour alimenter le GPU | 86 |
| Bases vectorielles / recherche | Grand pool mémoire + interconnexion cohérente : adaptation naturelle pour la couche de données chaudes de la recherche vectorielle | 83 |
| Tiering du KV cache en inférence | Le grand pool LPDDR5X comme couche de débordement de la VRAM GPU (fiche GB200) | 83 |
| Portage d'applications x86 génériques | Faisable sous Arm mais hors positionnement — se référer à la ligne « remplacement générique » du tableau ci-dessus | 45 |
Les niveaux de charge sont une compilation de cette base à partir des spécifications publiques (estimation, ne constitue pas un engagement de performance).
Galerie GALLERY
Les photos réelles sont ajoutées au fil des lots d'inspection ; les images générées par IA ne remplacent jamais les photos réelles.
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| Système d'exploitation | Versions Arm des principales distributions Linux (Ubuntu/RHEL, etc., selon le support officiel) |
| Pile NVIDIA | CUDA/pilotes/NCCL, etc. : support natif de Grace — pile logicielle livrée d'un bloc avec les racks série GB |
| Frameworks | Roues Arm disponibles pour PyTorch/TensorFlow et les frameworks IA ; composants data (DALI, etc.) livrés avec la pile NVIDIA |
| Conteneurisation | Écosystème d'images conteneur Arm mature (le multi-arch est déjà la norme du secteur) |
| Rappel d'inventaire | Vérifier une par une la disponibilité des versions Arm des outils internes et agents de sécurité de l'entreprise — principal point de friction de la migration (compilation de cette base) |
L'écosystème datacenter Arm, cultivé depuis des années par des produits comme AWS Graviton, est désormais mature ; les versions évoluent avec le temps, la publication officielle NVIDIA fait foi.
Achat et réception PROCUREMENT
Points de réception (trois) pour les achats liés à Grace (avec les racks série GB) :
Aide-mémoire de réception QUICK CHECK
Contrôle rapide de Grace en quatre étapes (à effectuer lors de la réception des racks série GB) :
Transport et livraison LOGISTICS
Fiches terminologie GLOSSARY
NVLink-C2C
Interconnexion Chip-to-Chip : l'interconnexion haute vitesse cohérente entre Grace et le GPU (de l'ordre de 900 Go/s sur GB200) — elle unifie mémoire CPU et VRAM GPU du point de vue logiciel et constitue ce qui distingue Grace d'un « CPU externe ».
LPDDR5X
LPDDR5X : la version basse consommation de la mémoire LPDDR5, le choix de Grace — orientée efficacité énergétique et large bande passante, au service du positionnement « un grand pool mémoire côté CPU qui alimente le GPU » (pool mémoire de l'ordre de 17 To par rack GB200).
Superchip
La combinaison d'emballage Grace + GPU : Grace Hopper (GH200), Grace Blackwell (série GB200) — la relation « CPU + GPU sur carte mère » est comprimée en une relation « CPU + GPU dans un même package », réécrivant intégralement bande passante d'interconnexion et contraintes de cohérence.
Neoverse V2
Le cœur datacenter d'Arm : les 72 cœurs Neoverse V2 adoptés par Grace — une lignée Arm datacenter partagée avec AWS Graviton3/Ampere One, avec des chaînes d'outils d'écosystème communes.
Vera CPU
Le CPU de génération suivante sur la feuille de route publique NVIDIA (révélé avec la plateforme Vera Rubin) — le successeur de Grace ; la feuille de route officielle NVIDIA fait foi.
Limites et controverses LIMITS
- Formes autonomes rares : Grace ne circule quasiment qu'au sein des superchips série GB — les projets souhaitant acheter un « serveur Grace » seul doivent vérifier si le fabricant propose une offre dédiée (compilation de cette base).
- Coût d'inventaire de la pile logicielle Arm : la disponibilité des versions Arm de la longue traîne logicielle de l'entreprise doit être vérifiée une par une — les principales distributions et la pile NVIDIA offrent un support natif, la friction se situe dans les logiciels internes et patrimoniaux (compilation de cette base).
- Limites de compatibilité avec l'écosystème x86 : certains binaires/pilotes exclusifs x86 (utilitaires de firmware de certaines cartes HBA, par exemple) sont indisponibles sous Arm — le choix des cartes d'extension des racks série GB doit être vérifié pour le support Arm.
- Réparation dépendante du canal du fabricant : Grace est soudée dans le tray : toute maintenance passe par un remplacement du tray au niveau de l'OEM — pour l'achat de racks d'occasion, le chemin de garantie et le circuit de pièces détachées doivent être inscrits au contrat (critères de contrôle de cette base).
- Variable des politiques transfrontalières : Les superchips de la série GB sont des modèles sensibles soumis aux contrôles à l'export (selon les informations publiques) — cette base n'en mentionne l'évolution que pour information, cela ne constitue pas un avis juridique.
Notes de marché MARKET NOTE
Grace circule uniquement en tant que composant des racks de la série GB ; il n'existe pas de cotation autonome — Principe d'honnêteté de cette fiche : pas de bande de marché, le prix est soumis au devis réel du vendeur (les prix au niveau rack suivent la logique des fiches GB200/GB300 NVL72).
Recherche des offres : AIXX Exchange Hall › (Mise en relation sans commission, sans participation aux transactions : une neutralité de fait des données).
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Non, ce n'est pas sa vocation : Grace est conçu comme un superchip CPU+GPU ; sa valeur réside dans l'interconnexion cohérente NVLink-C2C et le grand pool mémoire — l'utiliser seul comme serveur généraliste n'est ni achetable ni pertinent. Le calcul généraliste reste le domaine des serveurs x86 et Arm généralistes (Graviton, etc.).
Pas de conversion directe entre architectures et scénarios différents — les points forts de Grace sont la bande passante mémoire et la synergie CPU-GPU (NVLink-C2C) ; les benchmarks généralistes en entier/flottant ont peu de sens ici. Le choix dépend de votre charge : s'il s'agit d'un pipeline de données destiné à alimenter les GPU, le duo Grace+GPU est très solide ; sinon, ne forcez pas.
Maintenance au niveau tray : Grace est soudée sur le tray de calcul, et chaque panne passe par le circuit de remplacement de tray de l'OEM — pour l'achat d'un rack d'occasion, chemin de garantie et trays de rechange doivent figurer au contrat : c'est un coût caché propre aux équipements de niveau rack.
Oui : PyTorch et TensorFlow disposent de binaires Arm, toute la pile NVIDIA prend Grace en charge nativement, et les images multi-architectures en conteneurs sont la norme du secteur — le point de friction concerne les outils développés en interne et l'inventaire des versions Arm des logiciels legacy : faites l'inventaire avant l'achat.
Indirectement : dans les racks de la série GB, Grace remplace le poste CPU traditionnel « serveur x86 + GPU » — mais la concurrence se joue sur le créneau « CPU côté clusters IA » ; sur le marché généraliste des CPU datacenter, x86 et Arm généraliste restent majoritaires.
Fiches liées SEE ALSO
Pour aller plus loin EXPLORE
Références REFERENCES
- NVIDIA — Page produit du Grace CPU (source principale des spécifications, données d'octobre 2026) https://www.nvidia.com/en-us/data-center/grace-cpu/
- NVIDIA — Page produit du GB200 NVL72 (rôle du Grace dans le rack et référentiel 900 Go/s en C2C) https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- Supermicro — SuperCluster GB200 NVL72 Datasheet (composition des trays) https://www.supermicro.com/datasheet/datasheet_SuperCluster_…
- Recherche d'offres — AIXX (Mise en relation sans commission ; Grace circule au sein des racks de la série GB, sans cotation autonome) https://www.aixx.vip/hall.html?model=GB200