AIXX Pedia › Ficha de hardware › Grace CPU
Grace CPU
Resumen OVERVIEW
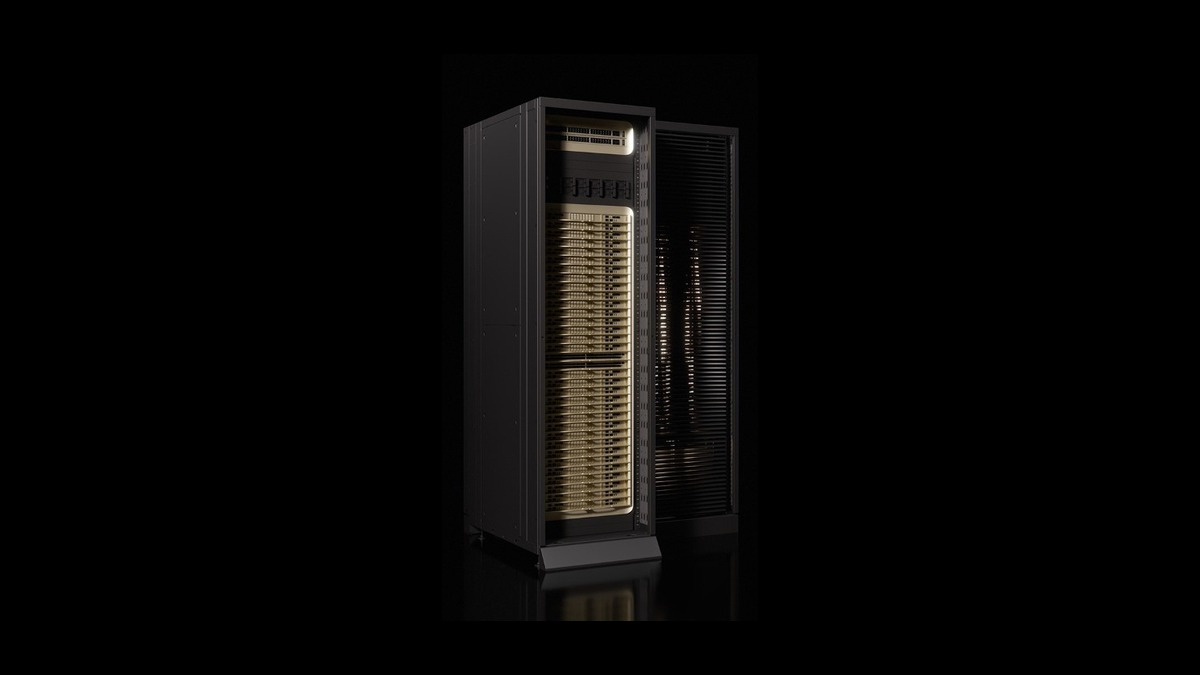
Grace es un Marca de CPU de centro de datos —La primera CPU propia de NVIDIA: un procesador de 72 núcleos basado en núcleos Arm Neoverse V2, diseñado específicamente para el enorme ancho de banda de memoria que exigen la IA y el HPC (según la página oficial de NVIDIA[1]). Rara vez aparece por separado: su papel protagonista es el de superchips Grace Hopper (GH200) y Grace Blackwell (GB200/GB300) , donde se combina con la GPU mediante la interconexión entre chips NVLink-C2C para formar un superchip «CPU+GPU» integrado.
Su razón de ser es redefinir la relación entre CPU y GPU : en la arquitectura tradicional, la CPU y la GPU están separadas por PCIe, con copias de datos constantes de un lado a otro; entre Grace y la GPU existe una interconexión coherente NVLink-C2C (en la configuración del GB200, del orden de 900GB/s[2])—desde la perspectiva del software, la memoria de la CPU y la VRAM de la GPU forman un conjunto unificado, y tareas «del lado de la CPU» como bases de datos vectoriales, procesamiento de datos o gestión de la caché KV aprovechan directamente un ancho de banda de nivel GPU.
En el mercado de segunda mano de 2026, Grace circula como componente de los racks GB200/GB300 (36 unidades por rack); la forma independiente (Grace CPU Superchip por separado) es poco frecuente. Esta ficha no incluye cotizaciones — el precio real está sujeto a la cotización del vendedor.
Casos de uso FIT
AIXX Index (0–100): ponderado por la adecuación a escenarios de cooperación CPU-GPU (criterio especializado en conceptos de software).
Historia HISTORY
Abril de 2021 , Grace se presenta en el GTC: NVIDIA anuncia su entrada en el terreno de las CPU—un CPU de centro de datos para IA y HPC construido sobre núcleos Arm Neoverse, con un nombre que rinde homenaje a la pionera de la arquitectura de computadoras Grace Hopper (según la página oficial de NVIDIA y el anuncio del GTC[1]).
2022-2023 , llega el superchip: Grace Hopper (GH200, Grace+H100 unidos por NVLink-C2C) es el primero en enviarse, y el kernel de Linux junto con las distribuciones principales completan la adaptación al ecosistema Arm—la «memoria coherente CPU+GPU» pasa del papel al producto (según la página oficial[1]).
2024-2025: , la generación GB se despliega a escala: Grace Blackwell (GB200) y GB300 llevan Grace al papel de pilar a nivel de rack — el GB200 NVL72 con 36 Grace por rack alimenta a 72 B200, y el gran conjunto de LPDDR5X se convierte en la «segunda capa de VRAM» del rack (según la ficha del GB200).
En 2026 , posición en el mercado de segunda mano: Grace circula con los racks serie GB; la forma independiente es escasa. El campo de las CPU Arm de centro de datos (Grace/AWS Graviton/Ampere, etc.) crece en conjunto, pero en la vía de los superchips de IA Grace es por ahora el único caso de «CPU de diseño propio por un gran fabricante de GPU». Las políticas de circulación transfronteriza de chips de centro de datos siguen evolucionando; al comprar, rija por las políticas de las autoridades competentes y el asesoramiento profesional (según reportes públicos).
Especificaciones técnicas SPECIFICATIONS
| Concepto | Especificaciones (NVIDIA Grace CPU Superchip · criterio oficial) |
|---|---|
| Núcleo | 72 núcleos Arm Neoverse V2 (por superchip) |
| Memoria | LPDDR5X ECC — memoria de gran ancho de banda orientada a eficiencia energética (capacidad según configuración) |
| Interconexión | NVLink-C2C—interconexión coherente CPU↔GPU (en la configuración del GB200, del orden de 900GB/s[2]) |
| Formato de superchip | Grace Hopper(GH200:Grace+H100)· Grace Blackwell(GB200:2×B200+1×Grace) |
| Papel en el rack | GB200/GB300 NVL72: 36 Grace por rack (72 núcleos ×36 = 2592 núcleos/rack) |
| Ecosistema de software | Linux (versiones Arm de las distribuciones principales) · soporte nativo de toda la pila NVIDIA |
| Lanzamiento | Marca presentada en el GTC 2021-04 · GH200 enviado en 2023 · GB200 anunciado el 2024-03 |
Las especificaciones están sujetas a la página oficial de NVIDIA (cifras de 2026-10)[1]; los detalles de frecuencias, consumo y capacidades de memoria dependen de la configuración del superchip y del equipo completo; lo no incluido en esta tabla = no verificado, no se inventa.
Posición de Grace en los racks serie GB IN THE RACK
| Nivel | Componente | Relación con Grace |
|---|---|---|
| Nivel de chip | Superchip Grace Blackwell (2 B200 + 1 Grace) | Interconexión coherente NVLink-C2C: memoria de CPU y VRAM de GPU unificadas desde el software |
| Nivel de bandeja | Bandeja de cómputo (4 GPU + 2 Grace/bandeja) | Grace asume el procesamiento y la orquestación de datos a nivel de bandeja |
| Nivel rack | GB200/GB300 NVL72 | 36 Grace/rack · hasta 17 TB de LPDDR5X (criterio de rack) |
Los criterios de nivel coinciden con la ficha del GB200 NVL72; la configuración de Grace en el GB300 está sujeta a la documentación del fabricante del sistema.
Miembros de la familia FAMILY
La familia Grace se segmenta por combinación de superchip; Grace es el sustrato CPU de la serie GB:
Refrigeración y despliegue COOLING
Grace no se despliega como servidor independiente: va soldado en los superchips y bandejas de cómputo, y la refrigeración sigue la solución del sistema (toda la serie GB es refrigerada por líquido). Desde la óptica del despliegue, Grace es una cuestión de pila de software : la arquitectura Arm implica verificar que todo el software huésped (agentes de monitoreo, componentes de seguridad, herramientas propias) tenga versión Arm disponible; las distribuciones Linux principales y toda la pila NVIDIA ya ofrecen soporte nativo, pero el software de cola larga interno de cada empresa debe inventariarse caso por caso (criterio de esta biblioteca).
Puntos de verificación del lado Grace en la aceptación de racks de segunda mano: reconocimiento en sitio de las 36 CPU, salud de los enlaces NVLink-C2C (en el mismo lote que la aceptación del dominio NVLink), y concordancia de la capacidad y configuración LPDDR5X con la documentación que acompaña el envío — la reparación de Grace a nivel de bandeja depende del canal del fabricante del sistema; confirme la vía de garantía al comprar.
Adaptación a escenarios WORKLOAD FIT
| Carga de trabajo | Criterios de rendimiento de Grace | AIXX Index |
|---|---|---|
| Pipeline de datos de entrenamiento | El preprocesamiento/aumento/tokenización del lado CPU consume directamente el ancho de banda NVLink-C2C para alimentar la GPU | 86 |
| Base de datos vectorial / recuperación | Gran conjunto de memoria + interconexión coherente: la capa de datos calientes para búsqueda vectorial encaja de forma natural | 83 |
| Estratificación de la caché KV en inferencia | El gran conjunto LPDDR5X como capa de desborde de la VRAM de la GPU (según la ficha del GB200) | 83 |
| Traslado de aplicaciones x86 de propósito general | El ecosistema Arm funciona, pero no es su propósito — según el criterio de «sustitución general» de la tabla anterior | 45 |
Los niveles de carga son una compilación de esta base a partir de especificaciones públicas (cifras estimadas, no constituyen compromiso de rendimiento).
Galería GALLERY
Las fotos reales se irán añadiendo con cada lote de inspección; no se publican imágenes generadas por IA haciéndolas pasar por fotos reales.
Software y ecosistema ECOSYSTEM
| Concepto | Requisito / Situación actual |
|---|---|
| Sistema operativo | Versiones Arm de las distribuciones Linux principales (Ubuntu/RHEL, etc., según soporte oficial) |
| Pila completa NVIDIA | CUDA/drivers/NCCL, etc., con soporte nativo para Grace — la pila de software de los racks serie GB se entrega integrada |
| Frameworks | Ruedas Arm disponibles para frameworks de IA como PyTorch/TensorFlow; componentes de datos (DALI, etc.) vienen con la pila NVIDIA |
| Contenedores | Ecosistema maduro de imágenes de contenedor Arm (las multiarquitectura ya son la norma del sector) |
| Recordatorio de inventario | Confirmar uno a uno la disponibilidad de versiones Arm de herramientas propias y agentes de seguridad — el principal punto de fricción de la migración (criterio de esta biblioteca) |
El ecosistema Arm de centro de datos, madurado durante años con productos como AWS Graviton, está consolidado; las versiones evolucionan con el tiempo, rija por las publicaciones oficiales de NVIDIA.
Compra y aceptación PROCUREMENT
Puntos clave de aceptación para compras relacionadas con Grace (con racks serie GB), tres ítems:
Guía rápida de aceptación QUICK CHECK
Chequeo rápido de Grace en cuatro pasos (ejecutar con la aceptación de racks serie GB):
Transporte y entrega LOGISTICS
Fichas de términos GLOSSARY
NVLink-C2C
Interconexión chip a chip: interconexión coherente de alta velocidad entre Grace y la GPU (900 GB/s aprox. según el GB200) — une la memoria de la CPU y la VRAM de la GPU desde la perspectiva del software; es lo que distingue esencialmente a Grace de una «CPU externa».
LPDDR5X
Versión de bajo consumo de la memoria LPDDR5: la elección de memoria de Grace — orientada a eficiencia energética y gran ancho de banda, al servicio de su papel de «gran conjunto de memoria del lado CPU que alimenta a la GPU» (conjunto de 17 TB aprox. según el rack GB200).
Superchip
La combinación encapsulada Grace+GPU: Grace Hopper (GH200), Grace Blackwell (serie GB200) — comprime la «relación de placa base CPU+GPU» a una «relación de encapsulado de chips», redefiniendo por completo el ancho de banda de interconexión y las restricciones de coherencia.
Neoverse V2
El núcleo IP de centro de datos de Arm: los 72 núcleos Neoverse V2 que usa Grace — linaje Arm de centro de datos compartido con AWS Graviton3/Ampere One, con herramientas de ecosistema comunes.
Vera CPU
La próxima CPU en la hoja de ruta pública de NVIDIA (revelada junto a la plataforma Vera Rubin) — la sucesora de Grace; los criterios de la hoja de ruta están sujetos a las publicaciones oficiales de NVIDIA.
Limitaciones y controversias LIMITS
- Forma independiente escasa : Grace casi solo circula con los superchips serie GB — los proyectos que quieran un «servidor Grace» por separado deben confirmar si el fabricante del sistema ofrece una solución (criterio de esta biblioteca).
- Costo de inventario de la pila Arm : hay que confirmar una a una la disponibilidad Arm del software de cola larga de la empresa — las distribuciones principales y la pila NVIDIA ya dan soporte nativo; la fricción está en el software propio y heredado (criterio de esta biblioteca).
- Límites de compatibilidad con el ecosistema x86 : algunos binarios/drivers exclusivos de x86 (como ciertas utilidades de firmware de tarjetas HBA) no funcionan en Arm — la selección de tarjetas de expansión para racks serie GB debe verificar el soporte Arm.
- Reparación dependiente del fabricante del sistema : Grace va soldado en la bandeja, y su reparación pasa por el reemplazo de bandeja del fabricante — en la compra de racks de segunda mano, la vía de garantía y el canal de repuestos deben constar en el contrato (según la experiencia de inspección de esta biblioteca).
- Variable política del comercio transfronterizo Las series de superchips GB son modelos sensibles a controles de exportación (según reportes públicos) — esta ficha sirve solo como recordatorio sobre la evolución regulatoria y no constituye asesoría legal.
Notas de mercado MARKET NOTE
Grace se comercializa como parte de los racks de la serie GB; no existe cotización independiente — Principio de honestidad de este repositorio: no publicamos bandas de mercado; el precio real está sujeto a la cotización del vendedor (precios a nivel de rack según el criterio de las fichas GB200/GB300 NVL72).
Búsqueda de unidades en venta: AIXX Exchange Hall › (Intermediación sin comisión, sin participación en las transacciones; los datos son por ello neutrales).
Hitos de precios MILESTONES
Preguntas frecuentes FAQ
Su posicionamiento no es ese: Grace nació como superchip CPU+GPU, y su valor reside en la interconexión coherente NVLink-C2C y el gran pool de memoria — usarla sola como servidor de propósito general no es viable ni correcto. La computación general sigue siendo territorio de x86 y de los servidores Arm de propósito general (Graviton, etc.).
Entre arquitecturas y escenarios distintos no existe una conversión directa — la fortaleza de Grace está en el ancho de banda de memoria y la cooperación CPU-GPU (NVLink-C2C); las comparativas de rendimiento entero/flotante de propósito general tienen poco sentido. Al elegir, pregúntate si tu carga es un pipeline de datos que alimenta a la GPU: si es así, la combinación Grace+GPU tiene grandes ventajas; si no, no la impongas a la fuerza.
Reparación a nivel de bandeja: Grace está soldada a la bandeja de cómputo, y las fallas se gestionan por el canal de sustitución de bandejas del fabricante — al comprar racks de segunda mano, la ruta de garantía y las bandejas de repuesto deben figurar en el contrato; es un costo oculto de los equipos a nivel de rack.
Sí: PyTorch/TensorFlow disponen de paquetes para Arm, el stack completo de NVIDIA soporta Grace de forma nativa, y las imágenes de contenedores multiarquitectura ya son la norma del sector — el punto de fricción está en las herramientas propias de cada empresa y en el inventario de software heredado para Arm; haz una lista antes de comprar.
Indirectamente: los racks de la serie GB sustituyen con Grace la posición de CPU del esquema tradicional «servidor x86 + GPU» — pero la competencia ocurre en el nicho del «lado CPU de los clústeres de IA»; en el mercado general de CPU para centros de datos, x86 y Arm de propósito general siguen siendo mayoritarios.
Entradas relacionadas SEE ALSO
Lecturas adicionales EXPLORE
Referencias REFERENCES
- NVIDIA — página oficial del Grace CPU (ficha de especificaciones, criterio de 2026-10) https://www.nvidia.com/en-us/data-center/grace-cpu/
- NVIDIA — página oficial del GB200 NVL72 (papel de rack de Grace y criterio de 900GB/s en C2C) https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- Supermicro — SuperCluster GB200 NVL72 Datasheet (composición de bandejas) https://www.supermicro.com/datasheet/datasheet_SuperCluster_…
- Búsqueda de disponibles — AIXX Exchange (Intermediación sin comisión; Grace circula dentro de los racks de la serie GB, sin cotización independiente) https://www.aixx.vip/hall.html?model=GB200