AIXX Pedia › Fiche modèle › AMD Instinct MI355X
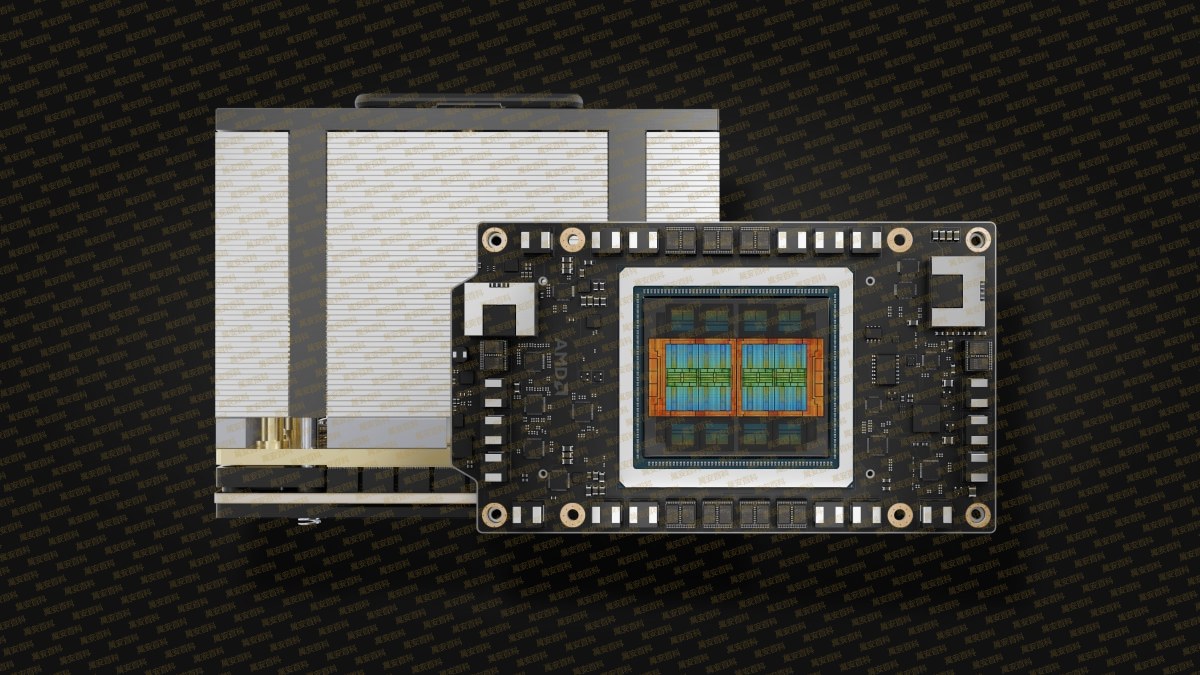
AMD Instinct MI355X
Vue d'ensemble OVERVIEW
AMD Instinct MI355X AMD a dévoilé le 12 juin 2025 lors de la conférence « Advancing AI » cet accélérateur IA flagship pour datacenter : architecture CDNA 4, 288GB HBM3E mémoire vidéo de grande capacité (fournie par Micron/Samsung), 8TB/s bande passante (interface 8192 bits) et 1400 W en refroidissement liquide — positionné officiellement comme « le fleuron de calcul haute densité pour l'entraînement et l'inférence IA à grande échelle », en confrontation directe avec le NVIDIA B300[1]。
Son atout majeur réside dans la capacité mémoire et la puissance de calcul basse précision : 288 Go par carte, à parité avec le B300 et 12,5 % de plus que le MI325X de la génération précédente (256 Go) ; prise en charge des MXFP6/MXFP4 formats microscaling (AMD présente les types de données FP4/FP6 comme l'argument générationnel côté inférence[3]) ; plateforme huit cartes totalisant 2.3TB HBM3E . Les benchmarks indépendants (référentiels SemiAnalysis InferenceMAX et AMD Signal65) montrent que la carte reste compétitive face au B300 sur le coût par million de tokens en inférence de grands modèles, avec même un avantage en TCO[5]。
Il faut d'abord clarifier la question du canal vers la Chine :MI355X n'a pas obtenu de licence d'exportation vers la Chine (après le resserrement des contrôles à l'export en avril 2025, AMD s'est réorienté vers la MI308 variante réservée au marché chinois et a obtenu une licence fin 2025[7]) — sur le marché chinois réglementé, l'offre se limite à la MI308/H20 et à leurs déclinaisons conformes ; la MI355X n'apparaît que sur les marchés étrangers. C'est la première ligne de partage de toute décision d'achat.
Cas d'usage FIT
AIXX Index (0–100) : estimé par pondération des spécifications publiques — mémoire 40 % + interconnexion 30 % + écosystème 30 %, pondérations ajustées par scénario. 90+ niveau flagship · 75+ Excellent · 60+ utilisable · en dessous de 60, non recommandé. Méthode transparente et vérifiable, sans garantie de performance.
Historique HISTORY
En octobre 2024 , AMD a présenté la feuille de route de la série MI350 lors de la conférence Advancing AI (architecture CDNA 4, 288 Go de HBM3E, lancement prévu au second semestre 2025), à un moment où le MI325X venait tout juste d'arriver sur le marché.
Avril 2025 , les contrôles à l'export vers la Chine se sont durcis : la série MI350, dont la MI355X, n'a pas obtenu de licence pour le marché chinois, et AMD a publiquement reconnu une dépréciation de stocks d'environ 1,5 milliard de dollars avant de se réorienter vers la MI308 variante réservée au marché chinois[7]。
Le 12 juin 2025 , AMD a officiellement lancé la série MI350 (MI350X/MI355X) lors de sa conférence « Advancing AI » : jusqu'à 40 fois plus de performance d'inférence que la MI300X selon le constructeur (référentiel MXFP4[2]) ; la presse a rapporté une hausse de prix d'environ 70 % pour la MI355X, à environ 25 000 $ la carte (selon la presse[6])。
Août 2025 , AMD puis NVIDIA ont conclu avec le gouvernement américain un accord de reversement de 15 % des revenus sur les ventes de puces vers la Chine en échange du maintien des licences (selon la presse[8]) ; la MI308 a obtenu sa licence pour la Chine fin 2025.
En 2026 , la MI355X se déploie chez les fournisseurs cloud et les clients d'infrastructure IA à l'étranger, avec une confrontation frontale avec le B300 sur le coût d'inférence selon les référentiels indépendants[5] ; le canal Chine reste limité à la MI308 et à ses déclinaisons conformes.
Spécifications techniques SPECIFICATIONS
| Élément | Spécifications (MI355X · données officielles AMD, vérifiées en octobre 2026[1]) |
|---|---|
| Architecture GPU | AMD CDNA 4 (4e génération d'architecture datacenter, livre blanc officiel[3]) |
| Unités de calcul | 256 Compute Units · 16 384 stream processors (selon les bases de spécifications indépendantes[10]) |
| Mémoire par carte | 288 Go HBM3E (Micron/Samsung, 8 piles) |
| Bande passante mémoire | 8 To/s (8192 bits, chiffres officiels[1]) |
| Formats basse précision | MXFP6 / MXFP4 (prise en charge générationnelle CDNA 4, discours officiel[3]) |
| Interconnexion GPU-GPU | Infinity Fabric de 4e génération · plus de 1 To/s (officiellement « over 1 TB/s »[1]) |
| Interface hôte | PCIe Gen 5 |
| TDP | 1400 W (par défaut en configuration OAM refroidi par liquide ; chiffres officiels[1]) |
| Format | OAM (Open Accelerator Module) · cold plate refroidi par liquide |
| Plateforme 8 GPU | 2,3 To de mémoire HBM3E au total (chiffres officiels[1]) |
| Génération précédente / produit concurrent | MI325X (256 Go, écart de génération +12,5 %) / NVIDIA B300 (288 Go, concurrent à capacité égale) |
Les spécifications font foi selon la page produit officielle AMD (vérifiée en 2026-10[1]) ; les nombres de CU/shaders proviennent de bases de spécifications tierces[10]Concernant FP4/FP6, la page officielle évoque un « support de nouvelle génération » sans détailler les TOPS en précision simple ; il est recommandé de vérifier par des mesures rocm-smi avant l'achat.
Tableau de sélection · MI355X vs B300 CONTEXT
| Élément | AMD MI355X | NVIDIA B300 |
|---|---|---|
| Mémoire par carte | 288GB HBM3E | 288GB HBM3e |
| Bande passante par carte | 8TB/s | environ 8TB/s |
| Interconnexion GPU-GPU | Infinity Fabric · plus de 1 To/s | NVLink 5 · 1.8TB/s |
| Consommation / refroidissement | 1400 W · OAM refroidi par liquide | Environ 1400 W · NVL8 refroidi par air/liquide |
| Écosystème logiciel | ROCm 7 (voie open source) | CUDA (standard de facto) |
| Canal Chine | Aucune licence (alternative spéciale MI308) | Circulation des dérivés conformes H20 |
| Recommandation en une phrase | Outsider du TCO en inférence · marchés internationaux | Choix par défaut de l'écosystème · achats phares |
Comparatif établi à partir des spécifications publiques et de benchmarks tiers[5] ; l'impact réel des différences d'écosystème sur votre activité devrait être évalué en testant vos propres modèles sur les deux piles ROCm/CUDA.
Membres de la famille FAMILY
La série MI350 se décline en trois branches selon le refroidissement et le marché cible :
Refroidissement et déploiement COOLING
MI355X par défaut 1400 W en cold plate refroidi par liquide (OAM) Format : la consommation de la carte (TBP/TGP) atteint 1400 W, et une plateforme 8 GPU approche les 12 kW et plus — une boucle de refroidissement liquide (CDU/cold plates/tuyauterie) est un prérequis incontournable au déploiement , impossible à héberger directement dans une salle refroidie par air. Sans refroidissement liquide, optez pour le MI350X refroidi par air (avec le sacrifice de performances correspondant). L'alimentation est livrée intégrée par l'OEM serveur/intégrateur selon les spécifications de la plateforme OAM ; aucune câblage individuel par carte.
Au niveau baie : plateforme 8 GPU OAM (UBB) livrée en ensemble avec l'unité de distribution du liquide ; la salle doit prévoir l'emplacement du CDU et les circuits primaires/secondaires. Les travaux préalables et les coûts de la mise en refroidissement liquide doivent être intégrés au budget avec le prix des cartes lors de la décision d'achat (voir « Achat et réception »).
Compatibilité des modèles MODEL FIT
| Scénario | Adéquation des 288 Go par carte (estimation : poids × précision + KV/frais du framework, méthode détaillée dans le sélecteur) |
|---|---|
| Inférence MoE type DeepSeek | Modèles creux de plusieurs centaines de milliards résidant intégralement : 288 Go de grande mémoire + large bande passante, terrain naturel du MoE (source tierce[5]) |
| Inférence DeepSeek FP8 complète | Poids FP8 ≈ plusieurs centaines de Go : après chargement sur une seule carte, il reste de la marge pour les longs contextes et la concurrence |
| Inférence quantification MXFP4 | Double capacité de chargement du modèle ou débit doublé (format CDNA 4 de nouvelle génération, chiffres officiels[3]) |
| Fine-tuning de grands modèles | LoRA/QLoRA faisable en grands paramètres ; l'entraînement complet relève du scénario plateforme 8 GPU |
| FP64 HPC | La page officielle indique le FP64 (voir tableau des spécifications[1]) ; les applications HPC se réfèrent à la liste de certification ROCm |
Méthode : mémoire occupée ≈ nombre de paramètres × octets par paramètre (FP16 = 2 o / FP8 = 1 o / FP4 = 0,5 o), KV et frais du framework en sus ; cohérent avec le « calcul mémoire » du sélecteur, vérifiable.
Galerie GALLERY
Le MI355X est un module OAM refroidi par liquide ; les rendus officiels publics sont rares — voir le livre blanc AMD CDNA 4[3]et la documentation des partenaires OEM pour les formats intégrés/cluster.
Présentation vidéo VIDEO
La vidéo explicative de cette fiche est en cours de production (processus des versions multilingues voir le planning de la fenêtre vidéo) — cette section se mettra à jour automatiquement à la mise en ligne.
Logiciels et écosystème ECOSYSTEM
La pile logicielle repose sur ROCm 7 (la voie open source d'AMD) : support officiel de PyTorch/TensorFlow/JAX, adaptation native des frameworks d'inférence vLLM/SGLang (source de benchmarks tierce[5]), noyaux Triton portables. L'écart d'écosystème avec CUDA reste honnêtement le principal point faible : la couverture ROCm des frameworks/opérateurs/logiciels commerciaux de longue traîne est encore en rattrapage, il est impératif de valider votre propre pile de modèles sur ROCm avant l'achat — un critère qui pèse plus lourd sur la livraison que le prix des cartes.
La gestion de cluster passe par la suite AMD (ROCm/SSO/AMDMonitor), avec l'AMD Device Plugin pour l'écosystème K8s ; les grands clients (cloud providers internationaux) disposent déjà de déploiements à l'échelle. Il est conseillé de consigner explicitement dans le contrat d'achat le contrat de support entreprise et le rythme des mises à jour ROCm.
Achat et réception PROCUREMENT
Risques fréquents
Pour les achats OAM à forte valeur, faites appel à un tiers pour l'inspection et des tests à réception ; vérifiez la cohérence du rapport et des numéros de série.
Comment effectuer un stress test BENCH TEST
Outil de validation AMD : intégré aux pilotes rocm-smi (topologie / consommation / températures), outils officiels AMD rocminfo outil de burn-in open source gpu-burn (version ROCm) , bande passante mesurée rocm-bandwidth-test , tests d'interconnexion rccl-tests (nccl-tests version ROCm). Critères standards : pas de throttling en Test de burn-in avec température d'entrée du refroidi par liquide conforme, bande passante mesurée HBM proche des 8 TB/s officiels, aucune erreur ECC sur toute la durée.
Pour des benchmarks comparatifs avec les machines NVIDIA, se référer au protocole public SemiAnalysis InferenceMAX[5] ; fiche de validation spécifique à cette carte en cours de production.
Transport et livraison LOGISTICS
| Étape | Points clés |
|---|---|
| Format et poids | Module OAM refroidi par liquide · livré principalement en plateforme UBB huit cartes ; poids du module selon les mesures du fabricant de la plateforme |
| Emballage | Sac antistatique d'origine + capuchons de protection sur les raccords des cold plates ; les connecteurs rapides liquides craignent la contamination et les chocs pendant le transport |
| Conformité transfrontalière | Carte d'accélération IA d'origine américaine, cible sensible aux contrôles à l'exportation — aucune licence pour la MI355X vers la Chine, flux transfrontalier soumis à documentation de conformité complète |
| Assurance | Assurance valeur totale (environ 25 000 $ par carte selon les médias[6]) ; assurance fuite des raccords liquides recommandée en option |
OEM et variantes VARIANTS
| Variantes / OEM | Format et positionnement |
|---|---|
| MI355X | OAM refroidi par liquide 1400 W · fleuron de la série (conception AMD officielle, intégration plateforme OEM) |
| MI350X | OAM refroidi par air 1000 W · pour les salles sans refroidissement liquide (données officielles[1]) |
| MI308 | Édition Chine · version dégradée conforme ligne MI300 · licence pour la Chine obtenue (selon les médias[7]) |
| Systèmes complets plateforme OAM | Plateformes UBB huit cartes : Supermicro / Dell / HPE / Lenovo (selon les médias[6]) |
Limites et controverses LIMITS
- Pas de licence pour la Chine : pas de licence d'exportation pour la MI355X vers la Chine, indisponible par canaux officiels en Chine continentale — AMD fournit le marché chinois via la MI308 ; l'écart de performance entre les deux lignes est un fait objectif[7]。
- Verrou matériel du refroidi par liquide 1400 W : déploiement impossible en salle refroidi par air ; le retrofit liquide est un coût caché important — sans infrastructure liquide, choisir la MI350X (avec décote de performance).
- Écart écosystème ROCm : face au standard de facto CUDA, la couverture ROCm des opérateurs long tail / frameworks / logiciels commerciaux rattrape son retard — le coût de migration peut absorber l'écart de prix ; validez avec votre propre stack.
- Interconnexion GPU-GPU en face-à-face : l'interconnexion GPU-GPU est annoncée officiellement à « plus de 1 TB/s », inférieure aux 1,8 TB/s du NVLink 5 du B300 — l'écart d'interconnexion en parallélisme de tenseurs à grande échelle est un fait objectif[1]。
- Arrangement de reversse de 15 % des revenus : à partir d'août 2025, AMD/NVIDIA reversent 15 % des revenus des ventes de puces vers la Chine au gouvernement américain en échange des licences (selon les médias[8]) — l'instabilité politique est une variable structurelle de la chaîne d'approvisionnement.
Notes de marché MARKET
| Date | Type | Marché | Fourchette de prix | Périmètre |
|---|---|---|---|---|
| 2026-10 | Référence canal | International | Environ 25 000 $/carte selon les médias (hausse de prix d'environ 70 % rapportée par la presse[6], le prix réel est soumis au devis du vendeur) | Pas de prix catalogue officiel chez AMD |
| 2026-10 | Référence de location cloud | Cloud à l'étranger | MI300X environ 2,39 $/GPU·heure (source tierce[5]) | Tarifs MI355X à observer après mise en ligne cloud |
| 2026-10 | État de la place de marché | Chine continentale | Aucun canal officiel · non applicable | Pas de licence pour la Chine, Recherche place de marché › |
Note : aucune donnée de transaction pour ce modèle dans la base ; « selon les médias » désigne des prix demandés relayés par la presse, ni prix officiels ni prix de transaction, ne constituant aucune base de négociation. Sources : AIXX Exchange (mise en relation sans commission, n'intervient pas dans les transactions).
Chronologie MILESTONES
| Temps | Événement |
|---|---|
| 2024-10 | Présentation de la feuille de route MI350 à la conférence Advancing AI (CDNA 4 · 288 Go · second semestre 2025) |
| 2025-04 | Durcissement des contrôles vers la Chine : série MI350 sans licence, AMD provisionne environ 1,5 milliard $ et se rabat sur la MI308[7] |
| 2025-06-12 | Lancement de la série MI350 (MI350X/MI355X) à la conférence Advancing AI ; hausse de prix d'environ 70 % à environ 25 000 $ selon la presse[2][6] |
| 2025-08 | Accord AMD/NVIDIA avec le gouvernement américain : reversse de 15 % des revenus des ventes vers la Chine (selon les médias[8]) |
| Fin 2025 | MI308 obtient la licence pour la Chine et démarre les livraisons ; montée en volume de la MI355X sur les marchés internationaux[7] |
| 2026-01-15 | Le BIS passe les exportations H200/MI325X vers la Chine au cas par cas (selon les médias[7]) |
FAQ FAQ
Fiches liées SEE ALSO
Références REFERENCES
| [1] | AMD officiel · Page produit Instinct MI355X (spécifications : 288GB HBM3E / 8TB/s / 1400W / 2.3TB pour huit cartes / interconnexion >1TB/s) · https://www.amd.com/en/products/accelerators/instinct/mi350/ (vérifié en 10-2026) |
| [2] | Conférence AMD Advancing AI · Lancement de la série MI350 (2025-06-12, chiffres de performance d'inférence) · https://www.amd.com/en/events/advancing-ai (vérifié en 10-2026) |
| [3] | Livre blanc architecture AMD CDNA 4 (MXFP6/MXFP4 et détails d'architecture) · https://www.amd.com/content/dam/amd/en/documents/instinct-te (vérifié en 10-2026) |
| [4] | AMD officiel · Documentation et écosystème ROCm 7 · https://rocm.docs.amd.com/ (vérifié en 10-2026) |
| [5] | SemiAnalysis · Benchmark InferenceMAX et critères TCO (MI355X vs B300) · https://inferencex.semianalysis.com/chips/mi355x (source tierce) |
| [6] | Presse · Hausse de prix de la MI350 d'environ 70 %, à environ 25 000 $/carte (2025, chiffres publics) · https://www.tomshardware.com/pc-components/gpus (selon les reportages publics) |
| [7] | Rapports publics · Contrôle des exportations vers la Chine et licence MI308 (durcissement 2025-04 / licence fin 2025 / régime au cas par cas du BIS en 2026-01) · https://www.reuters.com/technology/ (selon les reportages publics) |
| [8] | Rapports publics · Dispositif de reversement de 15 % des revenus de ventes en Chine pour AMD/NVIDIA (2025-08) · https://www.reuters.com/technology/ (selon les reportages publics) |
| [9] | Sélecteur · calcul de la mémoire requise (paramètres × précision + overhead KV/framework) · /wiki/xuanxing.html (selon cette base) |
| [10] | Bases de spécifications tierces · Critères CU/shaders (256 CU / 16 384 SP) · https://www.techpowerup.com/gpu-specs/instinct-mi355x.c4309 (source tierce) |
Spécifications ancrées sur la page officielle AMD ; les entrées « chiffres publics » sont des relais presse/canaux, non validés par cette base — pour toute décision d'achat, référez-vous aux documents officiels et aux tests réels.