AIXX Pedia › Ficha de modelo › AMD Instinct MI355X
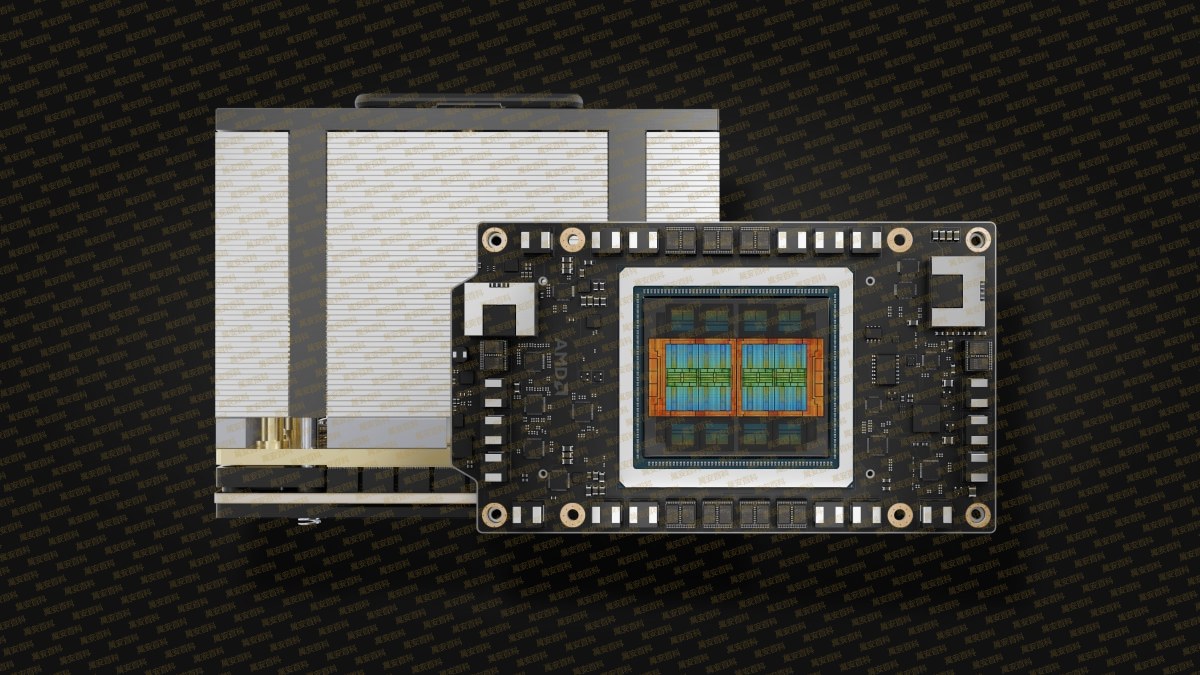
AMD Instinct MI355X
Resumen OVERVIEW
AMD Instinct MI355X Es una tarjeta aceleradora insignia de IA para centros de datos presentada por AMD en el evento «Advancing AI» del 12 de junio de 2025 : arquitectura CDNA 4, 288GB HBM3E gran capacidad de memoria (suministrada por Micron/Samsung), 8TB/s ancho de banda (interfaz de 8192 bits) y 1400W refrigerado por líquido de consumo —la propia AMD la posiciona como «buque insignia de cómputo de alta densidad para entrenamiento e inferencia de IA a gran escala», enfrentándose frontalmente al NVIDIA B300[1]。
Su mayor baza es la capacidad de memoria y el cómputo en baja precisión : 288GB por tarjeta, igual que el B300 y un 12,5% más que la generación anterior MI325X (256GB); soporta MXFP6/MXFP4 formatos microescalados (AMD presenta los tipos de datos FP4/FP6 como su argumento generacional en inferencia[3]); una plataforma de ocho tarjetas suma 2.3TB HBM3E . Los benchmarks de terceros (SemiAnalysis InferenceMAX, criterio AMD Signal65) muestran que compite con el B300 en coste por millón de tokens en inferencia de modelos grandes, e incluso gana en términos de TCO[5]。
Sobre el canal hacia China hay que aclararlo primero :MI355X no ha obtenido licencia de exportación hacia China (tras el endurecimiento de las restricciones en abril de 2025, AMD se volcó en la variante exclusiva para el mercado chino MI308 y obtuvo la licencia a finales de 2025[7]) — en China continental, los canales legítimos se basan principalmente en la MI308/H20 y derivados conformes; la MI355X solo se ve en el mercado de ultramar. Esta es la primera frontera de cualquier decisión de compra.
Casos de uso FIT
AIXX Index (0–100): esta base lo estima con ponderación de especificaciones públicas: memoria 40% + interconexión 30% + ecosistema 30%, ajustando pesos según el escenario. 90+ gama tope · 75+ Excelente · 60+ utilizable · por debajo de 60, no recomendado. Metodología transparente y verificable; no constituye una promesa de rendimiento.
Historia HISTORY
En octubre de 2024 , AMD avanzó en el evento Advancing AI la hoja de ruta de la serie MI350 (arquitectura CDNA 4, 288GB HBM3E, lanzamiento previsto para la segunda mitad de 2025), justo cuando la MI325X acababa de salir al mercado.
Abril de 2025 , el endurecimiento del control exportador estadounidense hacia China dejó a la serie MI350 (con la MI355X incluida) sin licencia; AMD reconoció en cifras públicas una depreciación de inventario de unos 1.500 millones de dólares y pivotó hacia la MI308 variante exclusiva para el mercado chino[7]。
El 12 de junio de 2025 , AMD presentó oficialmente la serie MI350 (MI350X/MI355X) en el evento «Advancing AI»: según la compañía, hasta 40 veces más rendimiento de inferencia que la MI300X (criterio MXFP4[2]); la prensa recogió una subida de precio de la MI355X de en torno al 70%, hasta unos 25.000 dólares por tarjeta (según reportajes públicos[6])。
Agosto de 2025 , AMD y NVIDIA alcanzaron sucesivamente con el gobierno de EE. UU. un acuerdo de entrega del 15% de los ingresos por ventas de chips a China a cambio de prorrogar las licencias (según reportajes públicos[8]); la MI308 obtuvo la licencia para China a finales de 2025.
En 2026 , la MI355X despega entre proveedores cloud y clientes de infraestructura de IA en el extranjero; según cifras de terceros, se enfrenta de tú a tú al B300 en coste de inferencia[5]; el canal hacia China mantiene la MI308 y derivados conformes.
Especificaciones técnicas SPECIFICATIONS
| Concepto | Especificaciones (MI355X · cifras oficiales de AMD, verificadas en 2026-10[1]) |
|---|---|
| Arquitectura GPU | AMD CDNA 4 (cuarta generación de arquitectura para centros de datos, libro blanco oficial[3]) |
| Unidades de cómputo | 256 Compute Units · 16.384 stream processors (según bases de datos de especificaciones de terceros[10]) |
| Memoria por tarjeta | 288GB HBM3E (Micron/Samsung, 8 stacks) |
| Ancho de banda de memoria | 8TB/s (8192 bits, cifras oficiales[1]) |
| Formatos de baja precisión | MXFP6 / MXFP4 (soporte generacional de CDNA 4, cifras oficiales[3]) |
| Interconexión GPU-GPU | Infinity Fabric de 4ª generación · más de 1TB/s (cifra oficial «over 1 TB/s»[1]) |
| Interfaz de host | PCIe Gen 5 |
| Consumo | 1400W (por defecto en formato OAM refrigerado por líquido; cifras oficiales[1]) |
| Formato | OAM (Open Accelerator Module) · placa fría de refrigerado por líquido |
| Plataforma de ocho tarjetas | 2,3TB de HBM3E de memoria total (cifras oficiales[1]) |
| Generación anterior / producto equivalente | MI325X (256GB, salto del +12,5%) / NVIDIA B300 (288GB, equivalente en capacidad) |
Las especificaciones prevalecen según la página oficial de AMD (verificadas en 2026-10[1]); las cifras de CU/stream processors provienen de bases de datos de terceros[10]; en la página oficial, el cómputo FP4/FP6 se describe solo como «soporte generacional», sin desglose de TOPS por precisión; se recomienda verificar con rocm-smi antes de comprar.
Comparativa de selección · MI355X vs B300 CONTEXT
| Concepto | AMD MI355X | NVIDIA B300 |
|---|---|---|
| Memoria por tarjeta | 288GB HBM3E | 288GB HBM3e |
| Ancho de banda por tarjeta | 8TB/s | ≈ 8TB/s |
| Interconexión GPU-GPU | Infinity Fabric · más de 1TB/s | NVLink 5 · 1.8TB/s |
| Consumo/refrigeración | 1400W · OAM refrigerado por líquido | En torno a 1400W · NVL8 refrigerado por aire/líquido |
| Ecosistema de software | ROCm 7 (línea open source) | CUDA (estándar de facto) |
| Canal para China | Sin licencia (sustituida por la MI308 de mercado chino) | H20/derivados conformes en circulación |
| Selección en una frase | Revelación en TCO de inferencia · mercado de ultramar | Opción por defecto del ecosistema · compra insignia |
La comparativa se basa en especificaciones públicas y benchmarks de terceros[5]; para el impacto real de las diferencias de ecosistema, se recomienda probar el propio modelo en doble pila ROCm/CUDA.
Miembros de la familia FAMILY
La serie MI350 se divide en tres líneas según refrigeración y mercado objetivo:
Refrigeración y despliegue COOLING
La MI355X viene por defecto en formato 1400W con placa fría de refrigerado por líquido (OAM) : el consumo de la tarjeta (TBP/TGP) ya ronda los 1400W y la plataforma de ocho tarjetas supera los 12kW — el circuito de refrigerado por líquido (CDU/placas frías/tuberías) es un requisito previo innegociable ; una sala refrigerada por aire no puede alojarla directamente. Sin refrigeración líquida, elegir la MI350X refrigerada por aire (con la consiguiente reducción de rendimiento). La alimentación se entrega integrada por el OEM de servidores/integrador de sistemas según la especificación de la plataforma OAM; cada tarjeta no se cablea por separado.
A nivel de rack: la plataforma OAM de ocho tarjetas (UBB) se entrega junto con la unidad de distribución de refrigerante; la sala debe reservar espacio para el CDU y tuberías de los circuitos primario/secundario. El trabajo previo y el coste de adaptar el refrigerado por líquido deben incluirse en la decisión de compra junto al precio de las tarjetas (ver «Compra e inspección»).
Adaptación de modelos MODEL FIT
| Escenario | Ajuste de los 288GB por tarjeta (estimación: pesos × precisión + KV/overhead del framework, método detallado en el selector) |
|---|---|
| Con 192 GB filtrados: es viable residente un MoE grande cuantizado: posición de ventaja relativa en entornos conformes limitados por memoria | Modelos dispersos de cientos de miles de millones de parámetros residentes al completo: 288GB y el gran ancho de banda son el terreno natural del MoE (cifras de terceros[5]) |
| Inferencia DeepSeek FP8 a pleno rendimiento | Pesos FP8 ≈ varios cientos de GB: cargados en una sola tarjeta, queda margen para contextos largos y concurrencia |
| Inferencia cuantizada MXFP4 | Doble capacidad de carga o doble rendimiento (formato generacional de CDNA 4, cifras oficiales[3]) |
| Fine-tuning de modelos grandes | LoRA/QLoRA viables a gran escala de parámetros; el entrenamiento completo es terreno de plataformas de ocho tarjetas |
| FP64 HPC | Las cifras de FP64 figuran en la página oficial (ver tabla de especificaciones[1]); para HPC, regirse por la lista de certificaciones ROCm |
Criterio: memoria usada ≈ nº de parámetros × bytes por parámetro (FP16=2B / FP8=1B / FP4=0,5B), más KV y overhead del framework; coincide con el «cálculo de memoria» del selector y puede verificarse.
Galería GALLERY
La MI355X es un módulo OAM refrigerado por líquido; los renders oficiales públicos son escasos — ver formatos de servidor/clúster en el libro blanco AMD CDNA 4[3] y en material de los socios OEM.
Vídeo explicativo VIDEO
El vídeo explicativo de esta ficha está en producción (el proceso de versiones en chino/multilingüe está en la lista de producción de la ventana de vídeo)—este bloque se actualizará automáticamente al publicarse.
Software y ecosistema ECOSYSTEM
La pila de software es ROCm 7 (línea open source de AMD): soporte oficial de PyTorch/TensorFlow/JAX, adaptación nativa de los frameworks de inferencia vLLM/SGLang (según benchmarks de terceros[5]) y kernels Triton portables. La brecha con el ecosistema CUDA es, honestamente, el mayor descuento: la cobertura ROCm de frameworks/operadores/software comercial de cola larga aún se está completando, antes de comprar, valida obligatoriamente tu propia pila de modelos sobre ROCm con pruebas reales — este punto condiciona la entrega más que el precio de la tarjeta.
La gestión de clústeres usa el suite de AMD (ROCm/SSO/AMDMonitor), con el AMD Device Plugin en el ecosistema K8s; grandes clientes (proveedores cloud del extranjero) ya cuentan con despliegues a escala. Se recomienda fijar por contrato el soporte enterprise y el ritmo de actualizaciones de ROCm.
Compra e inspección PROCUREMENT
Riesgos habituales
Para compras OAM de alto valor se recomienda una inspección por terceros y pruebas a la llegada, verificando que el informe coincida con los números de serie.
Cómo hacer pruebas de estrés BENCH TEST
Herramienta de referencia de AMD: incluida en el driver rocm-smi (topología/consumo/temperatura), oficial de AMD rocminfo , la herramienta de burn-in de código abierto gpu-burn (versión ROCm) , ancho de banda medido rocm-bandwidth-test , pruebas de interconexión rccl-tests (nccl-tests versión ROCm). Criterio general: sin caída de frecuencias en Prueba de burn-in con temperatura de entrada del refrigerado por líquido dentro de especificación, ancho de banda HBM medido cercano a los 8 TB/s nominales oficiales y sin errores ECC durante todo el proceso.
Como referencia comparativa con equipos NVIDIA, consulta la metodología pública de SemiAnalysis InferenceMAX[5]; el fragmento de referencia propio de esta tarjeta está en producción.
Transporte y entrega LOGISTICS
| Aspecto | Puntos clave |
|---|---|
| Formato y peso | Módulo OAM refrigerado por líquido · Se entrega principalmente como plataforma UBB de ocho tarjetas; el peso del módulo depende de las mediciones del fabricante de la plataforma |
| Embalaje | Bolsa antiestática original + tapas protectoras en los conectores de la placa fría; evita contaminación y golpes en las conexiones rápidas de refrigerado por líquido durante el transporte |
| Cumplimiento transfronterizo | Las tarjetas de aceleración de IA de origen estadounidense son objetivos sensibles a controles de exportación: sin licencia para MI355X hacia China, el flujo transfronterizo requiere documentación de cumplimiento en todo momento |
| Seguro | Seguro a valor completo (según informes públicos, alrededor de 25.000 USD por tarjeta[6]); se recomienda añadir cobertura por fugas en las conexiones de refrigerado por líquido |
OEM y variantes VARIANTS
| Variante / OEM | Formato y posicionamiento |
|---|---|
| MI355X | OAM de 1400W refrigerado por líquido · buque insignia de la serie (diseño oficial de AMD, integración por OEM) |
| MI350X | OAM de 1000W refrigerado por aire · opción sin sala refrigerada por líquido (cifra oficial[1]) |
| MI308 | Edición China · versión reducida conforme de la línea MI300 · con licencia para China (según informes públicos[7]) |
| Servidor completo en plataforma OAM | Plataformas UBB de ocho tarjetas de Supermicro / Dell / HPE / Lenovo, etc. (según informes públicos[6]) |
Limitaciones y controversias LIMITS
- Sin licencia para China : MI355X no obtuvo licencia de exportación a China y no está disponible por canales oficiales en China continental; AMD suministra el mercado chino con el MI308, y la brecha de rendimiento entre ambas líneas es un hecho objetivo[7]。
- Requisito estricto de 1400W refrigerado por líquido : no se puede desplegar directamente en salas refrigeradas por aire; la adaptación a refrigerado por líquido es un coste oculto considerable; sin esa condición, elige el MI350X (con descuento de rendimiento).
- Brecha del ecosistema ROCm : bajo el estándar de facto CUDA, la cobertura de ROCm en operadores de cola larga, frameworks y software comercial sigue en camino: el coste de migración puede absorber la diferencia de precio; valida con tu propia pila de software.
- Interconexión GPU-GPU comparativa : la interconexión GPU-GPU oficial es de «más de 1TB/s», por debajo de los 1.8TB/s del NVLink 5 de B300: la brecha de interconexión existe objetivamente en escenarios de paralelismo tensorial a gran escala[1]。
- Acuerdo de entrega del 15% de ingresos : desde agosto de 2025, AMD/NVIDIA entregan el 15% de los ingresos por ventas de chips a China al Gobierno de EE. UU. a cambio de licencias (según informes públicos[8]): la volatilidad política es una variable a largo plazo para la cadena de suministro.
Notas de mercado MARKET
| Fecha | Tipo | Mercado | Franja de precio | Criterio |
|---|---|---|---|---|
| 2026-10 | Referencia de canal | Exterior | Según informes públicos, unos 25.000 USD por tarjeta (cifra de prensa sobre una subida de precio de aproximadamente el 70%[6], el precio real está sujeto a la cotización del vendedor) | AMD no tiene precio de lista oficial permanente |
| 2026-10 | Referencia de alquiler en la nube | Nubes extranjeras | MI300X: unos 2,39 USD/GPU·hora (cifra de terceros[5]) | Precio del MI355X por observar tras su llegada a la nube |
| 2026-10 | Estado del mercado | China continental | Sin canal oficial · no aplicable | Sin licencia para China, Buscar en el mercado › |
Nota: esta base no tiene datos de transacciones de este modelo; las «cifras de informes públicos» son precios pedidos citados por medios, ni precios oficiales ni precios de transacción, y no constituyen base de negociación alguna. Fuentes: AIXX Exchange (intermediación sin comisión, sin participación en transacciones).
Cronología MILESTONES
| Periodo | Evento |
|---|---|
| 2024-10 | Keynote de Advancing AI anticipa la hoja de ruta MI350 (CDNA 4 · 288GB · segunda mitad de 2025) |
| 2025-04 | Endurecimiento de controles a China: la serie MI350 sin licencia, AMD provisiona unos 1.500 millones de USD y se orienta al MI308[7] |
| 2025-06-12 | Keynote de Advancing AI lanza la serie MI350 (MI350X/MI355X); la prensa reporta una subida de precio de aproximadamente el 70%, hasta unos 25.000 USD[2][6] |
| 2025-08 | AMD/NVIDIA alcanzan con el Gobierno de EE. UU. el acuerdo de entrega del 15% de ingresos por ventas a China (según informes públicos[8]) |
| , el MI308 obtuvo la licencia de exportación a China e inició suministros (según informes públicos | MI308 obtiene licencia para China e inicia suministro; el MI355X gana tracción en mercados de exportación[7] |
| 2026-01-15 | La BIS traslada la revisión de exportación a China de H200/MI325X a un régimen caso por caso (según informes públicos[7]) |
Preguntas frecuentes FAQ
Entradas relacionadas SEE ALSO
Referencias REFERENCES
| [1] | AMD oficial · Página del producto Instinct MI355X (especificaciones: 288GB HBM3E / 8TB/s / 1400W / 2.3TB por ocho tarjetas / interconexión de más de 1TB/s) · https://www.amd.com/en/products/accelerators/instinct/mi350/ (verificado 2026-10) |
| [2] | AMD Advancing AI Keynote · Lanzamiento de la serie MI350 (2025-06-12, cifras de rendimiento de inferencia) · https://www.amd.com/en/events/advancing-ai (verificado 2026-10) |
| [3] | AMD Libro blanco de la arquitectura CDNA 4 (MXFP6/MXFP4 y detalles de arquitectura) · https://www.amd.com/content/dam/amd/en/documents/instinct-te (verificado 2026-10) |
| [4] | AMD oficial · Documentación y ecosistema ROCm 7 · https://rocm.docs.amd.com/ (verificado 2026-10) |
| [5] | SemiAnalysis · Benchmark InferenceMAX y cifras de TCO (MI355X vs B300) · https://inferencex.semianalysis.com/chips/mi355x (criterio de terceros) |
| [6] | Medios · Subida de precio de la serie MI350 de aproximadamente el 70%, hasta unos 25.000 USD por tarjeta (2025, según informes públicos) · https://www.tomshardware.com/pc-components/gpus (criterio de reportes públicos) |
| [7] | Informes públicos · Controles de exportación a China y licencia del MI308 (endurecimiento 2025-04 / licencia a finales de 2025 / régimen caso por caso de la BIS 2026-01) · https://www.reuters.com/technology/ (criterio de reportes públicos) |
| [8] | Informes públicos · Acuerdo de AMD/NVIDIA de entrega del 15% de ingresos por ventas a China (2025-08) · https://www.reuters.com/technology/ (criterio de reportes públicos) |
| [9] | Selector · criterio de cálculo de memoria (parámetros × precisión + overhead de KV/framework) · /wiki/xuanxing.html (criterio propio) |
| [10] | Bases de especificaciones de terceros · Cifras de CU/shaders (256 CU / 16.384 SP) · https://www.techpowerup.com/gpu-specs/instinct-mi355x.c4309 (criterio de terceros) |
Las especificaciones se anclan en la página oficial de AMD; las entradas de «cifras de informes públicos» son trascripciones de medios o canales, esta base no avala su veracidad; para decisiones de compra, atente a documentos oficiales y mediciones reales.