SECTIONS
EDITIONS
NETWORK
스펙 카드 SPEC CARD
AMD Instinct MI325X
256GB HBM3E+6TB/s, MI300X와 동일 칩의 상위 버전. 단일 카드로 700억 파라미터 모델도 여유 있게 탑재 가능. 1TB급 전력 소모로 기존 전용 전원 설비 필요. 차세대 대용량 메모리 추론의 주력
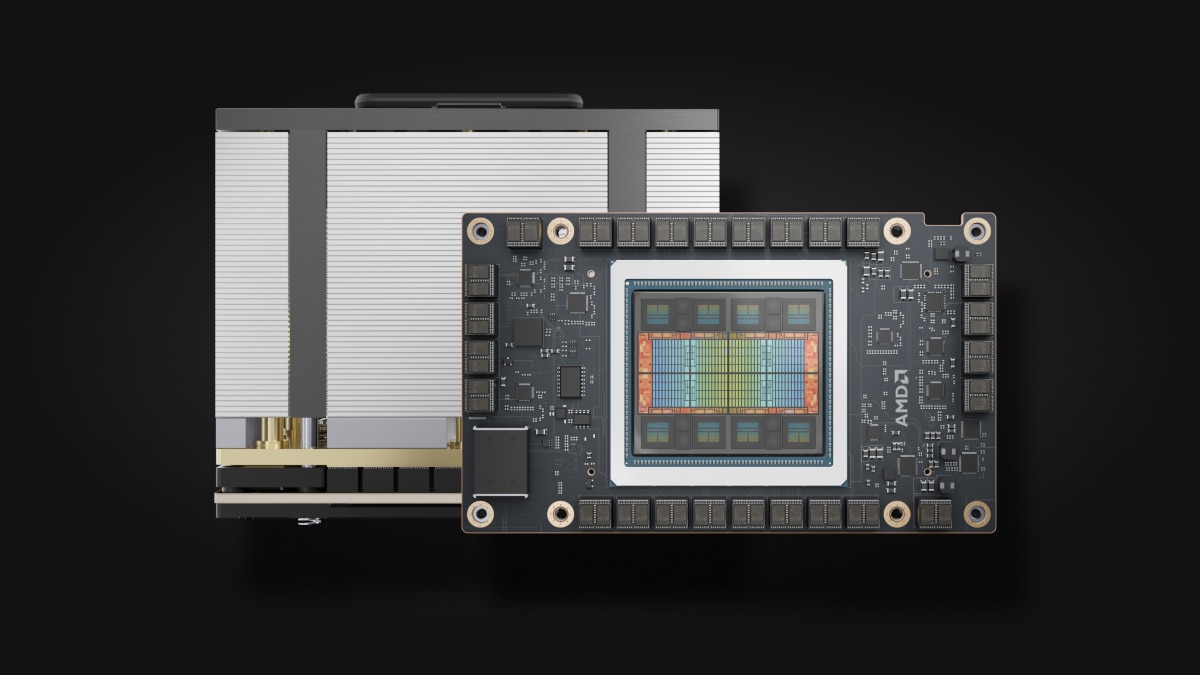
AMD 공식 제조사 이미지
개요
AMD Instinct MI325X는 AMD의 CDNA3 아키텍처 기반 데이터센터 가속기로, MI300X 패밀리의 메모리 증량 업그레이드 모델이다. 동일하게 TSMC 5nm+6nm 하이브리드 공정과 19,456개의 스트림 프로세서를 채용했으며, 메모리는 256GB HBM3E로 업그레이드되어 8192-bit 폭과 함께 6TB/s의 메모리 대역폭을 제공한다(이전 세대 MI300X는 192GB HBM3, 5.3TB/s). FP8 피크 연산 성능은 2.61 PFLOPs로 동급을 유지한다. 이 카드는 OAM 모듈 형태이며, 보드 레벨 소비 전력 피크는 1000W, 멀티 GPU 네트워킹용으로 인피니티 패브릭 링크 8개(링크당 128GB/s)를 제공하고, PCIe 5.0 x16으로 호스트와 연결된다. 초대용량 메모리를 활용한 대형 모델 추론 및 학습 시나리오에 포지셔닝된다.
핵심 스펙
| 아키텍처 | CDNA3 |
| 메모리 | 256 GB |
| 메모리 타입 | HBM3E |
| 메모리 버스 폭 | 8192-bit |
| 메모리 대역폭 | 6 TB/s |
| FP8 연산 성능 | 2.61 PFLOPs |
| FP16 연산 성능 | 1.3 PFLOPs |
| FP32 연산 성능 | 163.4 TFLOPs |
| FP64 연산 성능 | 81.7 TFLOPs |
| INT8 연산 성능 | 2.6 POPs |
| 소비 전력 TBP | 1000W Peak |
| 인터커넥트 | PCIe® 5.0 x16 |
| Infinity Fabric Links | 8 |
| Infinity Fabric 대역폭 | 128 GB/s |
| 스트리밍 프로세서 | 19,456 |
| 폼팩터 | OAM Module |
| 최종 캐시(LLC) | 256 MB |
| 공정 | TSMC 5nm | 6nm FinFET |
스펙은 공식 자료 기준으로 검증되었습니다(공식 벤치마크,2026-10-09 업데이트)· 실제 가격은 판매자 제시가 기준
적용 시나리오
- 초대형 파라미터 모델의 단일 카드 탑재: 256GB HBM3E로 수백억 파라미터급 대형 언어 모델 가중치를 단일 카드에 로드할 수 있으며, 초장문맥을 위한 충분한 KV 캐시 공간을 확보해 멀티 GPU 텐서 병렬의 통신 오버헤드를 줄인다
- 대형 모델 온라인 추론 서비스: FP8 연산 성능 2.61 PFLOPs로 높은 처리량의 추론 성능을 제공하며, 6TB/s 메모리 대역폭으로 대규모 동시 배치 상황의 디코딩 병목을 완화할 수 있어 프로덕션급 추론 서비스 구축에 적합하다
- 멀티 GPU 학습 및 클러스터 확장: 인피니티 패브릭 링크 8개가 멀티 GPU 고속 네트워킹을 지원하며, OAM 베이스보드 구성으로 8카드 시스템을 구성해 대형 모델 학습 및 파인튜닝 작업을 수행할 수 있다
- 고성능 컴퓨팅: 81.7 TFLOPs FP64 배정밀도 성능을 제공하여 전산유체역학, 기상 시뮬레이션 등 전통적인 HPC 워크로드에 활용 가능하다
동일 계열 모델
| 모델 | 메모리 | 소비 전력 |
|---|---|---|
| AMD Radeon PRO W7900 비교 | 48GB GDDR6 with ECC + Infinity Cache 96MB | 295W | 2×8pin | 권장 PSU 750W |
| AMD Instinct MI100 비교 | 32GB HBM2 (Full-Chip ECC, 4 stacks) | 300W Peak (TDP, 패시브 쿨링) |
| AMD Instinct MI300X 비교 | 192 GB | 750W Peak |
| AMD Radeon Instinct MI50 비교 | 16GB 또는 32GB HBM2 (Full-Chip ECC, 듀얼 버전) | 300W Peak TDP (2x8-Pin 외부 전원) |
| AMD Instinct MI455X 비교 | 432GB HBM4 | — |
| AMD Instinct MI250X 비교 | 128GB HBM2e (Full-Chip ECC, 듀얼 다이 합산) | 500W (TDP) | 560W Peak |
영상 해설 VIDEO
구매 및 검수 포인트
- 시스템 형태 확인: MI325X는 OAM 모듈, 패시브 쿨링 설계로 UBB 베이스보드와 섀시 강제 공기 흐름에 의존하므로 일반 PCIe 공랭 슬롯에 직접 장착할 수 없다. 구매 전 서버 시스템 구성과의 호환성을 확인해야 한다
- 전원 및 냉각 여유 계산: 보드 레벨 소비 전력 피크는 1000W(이전 세대 MI300X의 750W보다 높음)에 달하며, 단일 서버에 다중 카드 배치 시 랙 전원, 버스바, 냉각 용량을 항목별로 계산해야 한다
- 소프트웨어 및 인터커넥트 상태 검수: ROCm 드라이버 버전의 해당 모델 지원 범위, 메모리 ECC 로그에 이상 기록이 없는지 확인하고, 인피니티 패브릭 링크 연결성 및 풀 로드 안정성 테스트 보고서를 판매자에게 요구해야 한다
자주 묻는 질문
MI325X 단일 카드로 어느 정도 규모의 모델을 구동할 수 있나?
256GB HBM3E 메모리로 수백억 파라미터급 대형 언어 모델 가중치를 단일 카드에 완전히 탑재할 수 있으며, 장문맥 추론에 필요한 KV 캐시 공간도 확보된다. 더 큰 모델은 인피니티 패브릭 링크 8개로 멀티 GPU 텐서 병렬 분할이 가능하다.
MI325X와 MI300X의 주요 차이점은 무엇인가?
두 모델의 핵심 연산 사양은 동일하다(FP8 모두 2.61 PFLOPs). 차이는 메모리에 집중되어 있다: MI325X는 256GB HBM3E, 대역폭 6TB/s를 탑재했고 MI300X는 192GB HBM3, 대역폭 5.3TB/s이다. MI325X의 보드 레벨 소비 전력 피크도 750W에서 1000W로 상승했다. 요약하면: 연산 성능은 동급, 메모리는 더 크다.
MI325X 현물 구매 시 주의할 점은?
해당 모델은 주로 시스템/베이스보드 구성으로 유통된다. 구매 시 OAM 모듈과 UBB 베이스보드의 호환성, 1000W 피크 소비 전력을 충족하는 전원 구성을 확인하고, ROCm 소프트웨어 스택 버전과 메모리 ECC 기록을 검증하며, 멀티 GPU 인터커넥트 및 풀 로드 번인 테스트 기록을 요청해야 한다.
심층 읽기:MI325X 심층 항목 · 심층 항목MI300X vs MI325X · 심층 항목MI325X vs MI350X · 심층 항목AMD Instinct MI100 · 심층 항목AMD Instinct MI210 · 심층 항목
자료 업데이트 2026-10-09 · 심층 항목으로 이동 편집 방침 프로세스