AIXX Pedia › Ficha de modelo › H800
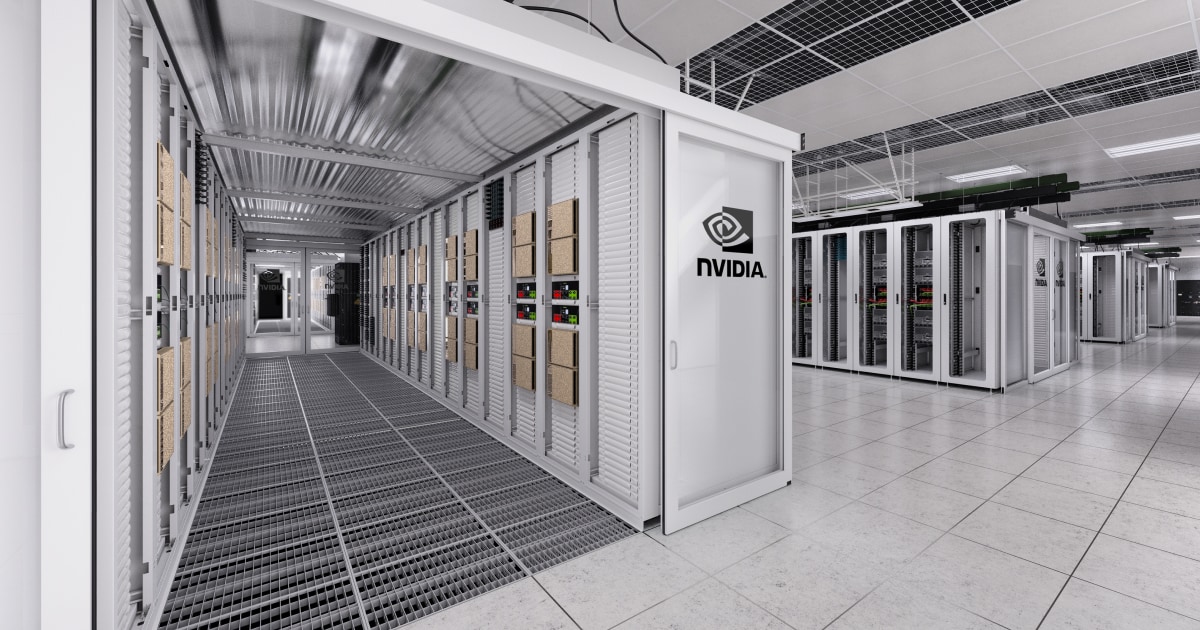
H800
Resumen OVERVIEW
H800 es la versión de la NVIDIA H100 versión derivada conforme de la NVIDIA A100 : el 21 de marzo de 2023 se reveló en su debut de mercado un ajuste para el mercado chino: se conserva la arquitectura base Hopper (cuarta generación de Tensor Core, 14592 núcleos CUDA, PCIe Gen5), y la diferencia clave es que la interconexión GPU-GPU baja de los 900GB/s de la H100 a 400GB/s Según los umbrales de control de exportación aplicables (según reportes públicos y documentación oficial de especificaciones [1][2]).
Con el tiempo se demostró que es la GPU más importante de la historia del entrenamiento de IA en China : La explosión de demanda de entrenamiento de los grandes modelos nacionales en 2023-2024 se ejecutó en gran parte sobre H800: la potencia de cómputo de entrenamiento divulgada públicamente por DeepSeek incluye H800 (según reportes públicos); tras el endurecimiento del control en octubre de 2023, el H800 quedó también sujeto a regulación (según reportes de CNBC [3]) y pasó a circulación del parque instalado; en el mercado spot de 2026, el H800 es una de las GPUs de entrenamiento conformes Hopper más codiciadas y de los valores refugio con precios más firmes del mercado spot nacional (según la experiencia de verificación de esta base).
La H800 se ofrece en dos versiones: 80GB HBM2e (2TB/s) y 94GB HBM3 (3.9TB/s) (según la documentación oficial de especificaciones [1]). Tres cosas a revisar antes de comprar un H800: distinguir la versión (la brecha de precio entre ambas es grande; nvidia-smi lo confirma de inmediato), verificación real del nivel de interconexión (la firma de identidad de los 400GB/s, para evitar productos que no correspondan) y documentación de conformidad del lote (los lotes anteriores y posteriores al control de octubre de 2023 siguieron rutas distintas). Esta ficha no incluye banda de precios: el precio real está sujeto a la cotización del vendedor.
Casos de uso FIT
AIXX Index (0–100): esta biblioteca lo estima con ponderación de especificaciones públicas: memoria 40% + interconexión 30% + ecosistema 30%, con un ajuste por estado de parque instalado.
Historia HISTORY
21 de marzo de 2023 , revelado en su debut de mercado: NVIDIA ajustó su buque insignia H100 para China y lanzó la H800 ; se conserva la arquitectura base Hopper y se reduce la interconexión para cumplir el umbral de control de octubre de 2022.
En 2023 , fuerza principal del entrenamiento de modelos chinos: la H800 se expandió con la ola de construcción de modelos grandes y se convirtió en el cómputo de entrenamiento divulgado públicamente por modelos de referencia (el mismo caso de DeepSeek, según reportes); circulaban en paralelo ambas versiones (80GB HBM2e / 94GB HBM3).
Octubre de 2023 , endurecimiento del control: la nueva normativa del 25 de octubre de 2023 sometió la H800 junto con la A800 a régimen de licencias: la línea variante exclusiva para el mercado chino se cerró por completo y la H800 pasó de producto nuevo a valor refugio del parque instalado.
2024-2026 , etapa de valor refugio del parque instalado: los precios de la H800 en canales de segunda mano y de inventario se mantienen firmes, con el triple respaldo de «potencia de entrenamiento Hopper + estatus conforme + el efecto DeepSeek»; desde 2025, modelos posteriores como la H20 absorben nueva demanda, pero los clústeres H800 existentes siguen en pleno servicio (según esta biblioteca). Las políticas de circulación transfronteriza siguen evolucionando; esta biblioteca se basa en reportes públicos y no constituye asesoría legal.
Especificaciones técnicas SPECIFICATIONS
| Concepto | Especificaciones (H800 · según la documentación oficial de Lenovo; las diferencias entre versiones se indican) |
|---|---|
| Arquitectura GPU | NVIDIA Hopper |
| Memoria por tarjeta | Doble versión: 80GB HBM2e / 94GB HBM3 · ECC |
| Ancho de banda de memoria | 2TB/s (versión 80GB) / 3.9TB/s (versión 94GB) |
| FP32 | 51 TFLOPS (coincidencia en ambas fuentes; las demás precisiones presentan sospecha de desalineación de fuentes, este bloque completo no se adopta ni se declara) |
| Tensor Core | 456 Tensor Core de cuarta generación / GPU |
| Núcleos CUDA | 14592 núcleos CUDA FP32 / GPU |
| Interconexión GPU-GPU | NVLink 400GB/s (el H100 ofrece 900GB/s, según reportes públicos [2]) |
| Interfaz de host | PCIe Gen5 x16 |
| Formato | PCIe de doble ranura, perfil completo y largo completo |
| Particionado multi-instancia | MIG hasta 7 instancias (versión 80GB: 10GB/instancia · versión 94GB: 13GB/instancia) |
| Consumo / refrigeración | 350W · refrigerado por aire pasivo |
| ECC | Compatible |
| Lanzamiento | En 2023 |
Las especificaciones prevalecen según la documentación oficial de los socios autorizados; los recuentos de «Tensor Core/núcleos CUDA» corresponden al fabricante del sistema. Las demás precisiones de cómputo se descartaron en bloque por sospecha de desalineación de fuentes: mejor faltar que errar.
Línea especial para China · tabla comparativa CHINA LINE
| Concepto | A800(2022) | H800(2023) | H20(2024) |
|---|---|---|---|
| Arquitectura | Ampere | Hopper | Hopper (versión recortada) |
| Memoria | 80GB HBM2e | 80GB HBM2e / 94GB HBM3 | 96GB HBM3 |
| Interconexión reducida | NVLink 400GB/s | NVLink 400GB/s | NVLink recortado |
| Fecha de sometimiento a licencias | 2023-10 | 2023-10 | Endurecimiento desde 2025 (según reportes públicos) |
| Selección en una frase | Principal del parque instalado Ampere | Valor refugio para entrenamiento | Tarjeta conforme orientada a inferencia |
La A800 tiene su propia ficha; la conducta de la H20 se basa en reportes públicos; el estatus de control depende de la política de las autoridades y no constituye asesoría legal.
Miembros de la familia FAMILY
La H800 se divide en dos ramas según la memoria (la doble versión en una misma tarjeta es una forma de mercado propia de la H800):
Refrigeración y despliegue COOLING
La H800 es una tarjeta PCIe pasiva de doble ranura, perfil completo y largo completo (350 W), que depende del flujo de aire forzado del chasis: el segmento de 350 W exige mejores conductos de aire que el de 300 W del A800 PCIe; antes de desplegar, verifique la capacidad de refrigerado por aire del chasis y la separación entre ranuras. La segmentación MIG (hasta 7 instancias) es una carta práctica en despliegue: 13 GB por instancia en la versión de 94 GB y 10 GB en la de 80 GB, asignando los pools de inferencia multiusuario con granularidad por instancia (según la documentación oficial de especificaciones [1]).
Verificaciones previas al despliegue de una H800 de segunda mano: originalidad del disipador y estado de las almohadillas térmicas (en el segmento de 350W, las diferencias del disipador afectan directamente la temperatura a plena carga), topología directa de la ranura PCIe Gen5 (pasar por un switch cuesta ancho de banda) y especificación de los cables de alimentación de 8 pines (según la experiencia de verificación de esta biblioteca).
Adaptación de modelos MODEL FIT
| Modelo / escenario | Requisitos de memoria (estimación FP16) | Criterios de despliegue de la H800 | AIXX Index |
|---|---|---|---|
| DeepSeek R1 completo (671B) | FP16 ~1.3TB / FP8 ~690GB | Cabe en 8 GPUs (criterio FP8) : 94GB×8=752GB o 80GB×8=640GB requieren rutas de cuantización FP8/INT8; los Tensor Core Hopper de cuarta generación soportan FP8 | 82 |
| Modelos abiertos de nivel 70B | FP16 ~140GB | Paralelismo tensorial en dos tarjetas; con cuantización INT8, punto crítico de una sola tarjeta (la versión de 94GB tiene más margen) | 82 |
| Nivel 7B-14B | FP16 ~14-28GB | Una sola tarjeta sobra; con MIG o varias tarjetas, acumule concurrencia | 88 |
| Entrenamiento MoE a escala de billones de parámetros | Multiclúster entre servidores | NVLink 400GB/s dentro del bastidor + fabric IB entre bastidores: la interconexión es el punto clave de planificación a gran escala | 74 |
La memoria se estima en FP16 como nº de parámetros × 2 bytes (estimación, sin incluir la caché KV); el soporte FP8 proviene de la arquitectura de los Tensor Core Hopper de cuarta generación (según la arquitectura pública); la estrategia de precisión en despliegue depende del framework.
Galería GALLERY
Software y ecosistema ECOSYSTEM
| Concepto | Requisito / Situación actual |
|---|---|
| CUDA | Misma generación que la H100 (Hopper · capacidad de cómputo 9.0): cobertura total del ecosistema Hopper |
| Driver | Comparte línea de drivers con la H100: soporte continuado de drivers en activo |
| Frameworks | Soporte completo de PyTorch / TensorFlow / vLLM / TensorRT (criterio Hopper, incluido FP8) |
| Soporte MIG | Segmentación multiinquilino madura en Kubernetes y orquestación de contenedores |
| Adaptación de frameworks de entrenamiento | Alta validación en casos públicos como DeepSeek: pila de entrenamiento Hopper madura (según reportes) |
El ecosistema de software de la H800 es el mismo que el de la H100: la compatibilidad de frameworks es la base que la convirtió en valor refugio para entrenamiento; prevalece lo publicado oficialmente por NVIDIA.
Compra e inspección PROCUREMENT
Puntos de verificación al comprar una H800 (tres):
Los seis casos completos de pruebas de estrés están en esta ficha «Cómo hacer la prueba de burn-in» de esta ficha.
Cómo hacer pruebas de estrés BENCH TEST
Seis pruebas de estrés como criterio, con valores anclados a la H800: identificación al abrir → prueba de burn-in de una tarjeta (350W) → plena carga de todo el equipo → ancho de banda de memoria (versión 80GB: 2TB/s / versión 94GB: 3.9TB/s; ≥85% es aprobado) → ancho de banda de interconexión (medición real del nivel NVLink 400GB/s) → throughput de inferencia.
Transporte y entrega LOGISTICS
OEM y variantes VENDORS
La H800 circula principalmente como tarjeta PCIe individual (no hay soluciones públicas de sistema SXM, según fuentes públicas); referencia de socios autorizados:
| Canal | Soluciones representativas | Diferencias clave | Estado a 2026 |
|---|---|---|---|
| PCIe original de NVIDIA | H800 80GB / 94GB PCIe | Las únicas dos versiones en circulación de spot | Segunda mano e inventario en paralelo |
| Lenovo | Solución integrada ThinkSystem H800 PCIe Gen5 | Integración de fábrica y garantía conjunta de firmware | Circulación de desmontajes y proyectos |
| Referencia cruzada de canales | Criterio de bases de datos de especificaciones de terceros[5] | Referencia de mercado | Referencia de mercado |
La configuración de canal prevalece según la documentación oficial del fabricante[1][5].
Fichas de términos GLOSSARY
Doble versión (80GB/94GB)
Forma de mercado propia de la H800: circulan en paralelo 80GB HBM2e (2TB/s) y 94GB HBM3 (3.9TB/s); la versión de 94GB casi duplica el ancho de banda y es prioritaria en escenarios de caché KV grande y contexto largo; el precio real está sujeto a la cotización del vendedor.
Nivel NVLink 400GB/s
Firma de identidad conforme de la H800: la interconexión GPU-GPU baja de los 900GB/s de la H100 a 400GB/s (según reportes): medir el nivel real es el medio de verificación bidireccional (evita una H800 que pase por H100 y remanentes de H100 vendidos como H800).
Tensor Core de cuarta generación y FP8
Los 456 Tensor Core de cuarta generación de la arquitectura Hopper soportan FP8, el motor de throughput del entrenamiento/inferencia de modelos grandes; la H800 conserva esa capacidad (la reducción de interconexión no toca la arquitectura de cómputo), y la ruta FP8 es su sustento técnico para liderar el entrenamiento.
El caso de DeepSeek
El cómputo de entrenamiento divulgado por DeepSeek incluye H800 (según reportes): una «tarjeta de entrenamiento validada públicamente» es la base psicológica de la prima de la H800 en el mercado de segunda mano; la decisión de compra debe basarse en pruebas de estrés reales.
Lotes bajo control
La nueva normativa del 25-10-2023 sometió el H800 a gestión de licencias: desde entonces su circulación corresponde al parque instalado y a canales existentes (según reportes públicos [3]); la verificación de la documentación de cumplimiento del lote es el mínimo en transacciones de segunda mano, y esta base de datos no constituye asesoramiento legal.
Limitaciones y controversias LIMITS
- Techo de los grandes clústeres por la reducción de interconexión : los NVLink de 400GB/s bastan dentro del bastidor, pero en entrenamientos de escala de miles de GPUs con comunicación intensiva entre nodos, la interconexión es el cuello de botella: el contraste con la red de 800G de la generación GB300 (según esta biblioteca).
- Caos en las fuentes de datos de cómputo : las cifras de cómputo por precisión de la H800 están desalineadas entre fuentes de terceros (esta biblioteca descartó el bloque completo al recopilar y solo conserva el FP32=51 TFLOPS coincidente en dos fuentes); al elegir, guíese por documentación oficial y pruebas reales, no confíe en tablas de un solo sitio.
- Límites de cumplimiento posteriores a octubre de 2023 : El H800 está sujeto a gestión de licencias y desde entonces su circulación corresponde al parque instalado y a canales existentes (según reportes públicos [3]); la verificación de la documentación de cumplimiento es el mínimo indispensable, y esta base de datos no constituye asesoramiento legal.
- Intensidad de servicio generalmente alta : la H800 es la fuerza principal del entrenamiento de modelos grandes; el historial de carga 7×24 y los registros ECC son lección obligatoria al verificar máquinas retiradas: un «retiro de entrenamiento» degrada más que un «retiro de inferencia» (según la experiencia de esta biblioteca).
- Desvío hacia modelos posteriores : modelos conformes como la H20 absorben nueva demanda, y el valor del parque instalado de la H800 se sostiene en la «escasez de potencia de entrenamiento Hopper»; observe cómo la política y el ritmo de oferta afectan el valor residual (según esta biblioteca).
Notas de mercado MARKET NOTE
La H800 es uno de los valores refugio más firmes del mercado del parque instalado, pero la versión (80/94GB), el estado, el lote y las condiciones del canal generan gran dispersión de precios: no hay un mercado unificado verificable. Principio de honestidad de este repositorio: no publicamos bandas de mercado; el precio real está sujeto a la cotización del vendedor 。
Búsqueda de unidades en venta: AIXX Exchange Hall › (intermediación sin comisión y sin participación en las transacciones; por eso los datos son neutrales). Cuando se acumulen suficientes instantáneas de mercado, esta sección pasará a la banda de mercado estándar.
Hitos de precios MILESTONES
Preguntas frecuentes FAQ
La diferencia clave está en la interconexión: el NVLink del H800 es de 400GB/s (variante exclusiva para el mercado chino conforme), frente a los 900GB/s del H100: la arquitectura de cómputo es de la misma generación (cuarta generación de Tensor Core y FP8 incluidos). En inferencia de una sola tarjeta la brecha es pequeña; en entrenamiento multi-GPU la eficiencia de comunicación colectiva baja un escalón.
La versión de 94GB HBM3 ofrece 3.9TB/s de ancho de banda, aproximadamente el doble que la de 80GB: para contextos largos, KV cache grandes y entrenamiento de modelos grandes, prioriza la de 94GB; la de 80GB tiene mayor parque instalado y más canales de suministro, y en ajustes de presupuesto ofrece mejor relación calidad-precio: la diferencia de precio está sujeta a la cotización real del vendedor.
Desde octubre de 2023 el H800 está sujeto a licencias, la oferta nueva regular se ha estrechado y el stock disponible pertenece a la circulación del parque instalado: es una de las divisas fuertes Hopper más sólidas del mercado de segunda mano. Verificar la documentación de conformidad es el mínimo indispensable; esta base de datos no constituye asesoría legal.
En FP8, sí: los pesos FP8 completos de R1 rondan los 690GB; la versión de 94GB con ocho tarjetas ofrece 752GB y la de 80GB, 640GB: la de 94GB tiene margen de sobra, mientras que la de 80GB está al límite y exige ajustar con precisión la cuantización y la estrategia de KV cache. El FP8 nativo de los Tensor Core de cuarta generación es la garantía.
No, y tampoco es ese el problema: el H800 no tiene salida de vídeo y no se usa para minar: el riesgo real es el envejecimiento por cargas 7×24 del entrenamiento de grandes modelos. Lo correcto: preguntar por el historial de carga del centro de datos, exportar los registros ECC y someterla a las seis pruebas de estrés (con especial atención a la medición del ancho de banda de memoria y el nivel de interconexión).
Entradas relacionadas SEE ALSO
Comparativa y elección de modelos COMPARE
Referencias REFERENCES
- ThinkSystem NVIDIA H800 PCIe Gen5 GPU Product Guide (documento oficial de especificaciones de un socio autorizado de NVIDIA, archivo principal verificado en 2026-10) https://lenovopress.lenovo.com/lp1814-thinksystem-nvidia-h80…
- Nvidia tweaks flagship H100 chip for export to China, H800 (reportaje de estreno del 2023-03-21) https://www.reuters.com/technology/nvidia-tweaks-flagship-h1…
- CNBC — U.S. curbs export of more AI chips, including Nvidia H800 (2023-10-17, contexto del listado de control) https://www.cnbc.com/2023/10/17/us-bans-export-of-more-ai-ch…
- FR 2023-23055: endurecimiento de controles, A800/H800 regulados (25/10/2023) https://www.federalregister.gov/documents/2023/10/25/2023-23…
- H800 PCIe 80GB specs (base de datos de especificaciones de terceros, referencia cruzada) https:///en/gpu/H800-PCIe-80-GB
- Búsqueda de stock disponible — AIXX Exchange (Intermediación sin comisión; el H800 aún no tiene instantánea de mercado, el precio real está sujeto a la cotización del vendedor) https://www.aixx.vip/hall.html?model=H800