AIXX Pedia › Статья о модели › H20

H20
Обзор OVERVIEW
H20 (NVIDIA H20) — специальная версия для китайского рынка, дата-центровый GPU, разработанный NVIDIA специально для китайского рынка в рамках требований экспортной политики США: архитектура Hopper (производная от GH100), выход на рынок в 2024 году , в той же партии были и другие специальные модели, такие как L20/L2. Это преемник линейки A800/H800, попавшей под ограничения в рамках ужесточения экспортного контроля в октябре 2023 года[2][7]。
Логика её дизайна — открытый «обмен»: экспортный контроль зафиксировал показатели вычислительной мощности, поэтому H20 снизила Tensor-производительность примерно до одной десятой от H100 (по данным СМИ), сохранив 96 ГБ HBM3 большой памяти, пропускную способность 4,0 ТБ/с и межсоединение NVLink 900 ГБ/с того же поколения — по памяти и пропускной способности она даже превосходит H100. Это карта для инференса, а не для обучения[1]。
Судьба неоднократно менялась: в январе 2025 года ажиотаж вокруг DeepSeek спровоцировал массовые закупки (8-GPU сервер подорожал до ~1,1 млн юаней за единицу, по публичным сообщениям[6]); в апреле 2025 года США временно потребовали лицензии, NVIDIA зарезервировала около 5,5 млрд долларов; в июле 2025 года продажи были возобновлены; затем на фоне колебаний политики и закупочной среды в декабре 2025 года H200 получила одобрение для Китая, и H20 постепенно сошла с центра сцены (по совокупности публичных сообщений[4][5]). На вторичном рынке 2026 года H20 представлена в основном оборотом установленного парка ранних поставок.
Сценарии применения FIT
AIXX Index (0–100): оценка базы на основе открытых спецификаций со взвешиванием — память 40% + интерконнект 30% + экосистема 30%, веса корректируются по сценарию. 90+ — флагман · 75+ — Отлично · 60+ — пригодно · ниже 60 — не подходит. Методика прозрачна и проверяема, но не является обещанием производительности.
Хронология HISTORY
17 октября 2023 года , ужесточение экспортного контроля США: A800/H800 для Китая переведены на лицензионный режим; NVIDIA переключилась на разработку нового поколения соответствующих нормам специальных версий — в декабре 2023 года СМИ сообщили о разработке новых чипов для Китая (позднее получивших название H20, в партии вошли L20/L2)[2][7]。
В 2024 году , H20 вышла на рынок (основные поставки года — версия HBM3 8-Hi, по данным TrendForce[3]); серверы с модулем HGX H20 на 8 карт вывели на рынок Inspur, H3C и другие производители; NVIDIA не открыла официальную страницу продукта, спецификации — по данным СМИ и производителей серверов. На старте продажи шли слабо — урезанная вычислительная мощность в сочетании с конкуренцией отечественных китайских решений (по публичным сообщениям).
2025 год Год взлётов и падений: в январе-феврале ажиотаж вокруг DeepSeek спровоцировал массовые закупки, 8-GPU серверы подорожали с ~1 млн до ~1,1 млн юаней, крупные компании массово заказывали инференс-нагрузки (по сообщениям Cailian Press[6]); в апреле США потребовали лицензии на экспорт в Китай, NVIDIA зарезервировала около 5,5 млрд долларов (из них около 2,5 млрд — непоставленный H20[3]); 15 июля получено разрешение на возобновление продаж (по последующим сообщениям СМИ — с договорённостью о разделе доходов); с августа закупочная среда стала осторожнее, в прессе появились слухи о сворачивании производства и преемнике[4]。
Конец 2025 года и далее : в декабре H200 получила одобрение для Китая (память HBM3E по-прежнему ограничена, по данным MyDrivers[5]); в 2026 году СМИ сообщили о фактической остановке продаж AI-чипов NVIDIA в Китае и росте доли местных производителей (CNBC 02.2026, LA Times 06.2026[4][8]). Роль H20 на вторичном рынке сместилась к обороту установленного парка: ранее раскупленные серверы продолжают работать и перепродаваться в китайских дата-центрах. Все формулировки в базе — по публичным сообщениям и не являются юридической консультацией.
Технические характеристики SPECIFICATIONS
Дисклеймер: NVIDIA не открывала официальную страницу H20 (специальная версия для китайского рынка не входит в глобальную линейку продуктов), таблица ниже — по данным СМИ и производителей серверов в разночтениях полей берутся консервативные значения; определяющим является отчёт прошивки по прибытии и фактические замеры.
| Параметр | Спецификации (H20 · по данным СМИ) |
|---|---|
| GPU-чипы | NVIDIA Hopper (производная GH100, специальная версия для китайского рынка) |
| Память на плату | 96 ГБ HBM3 (обновлённая версия ~148 ГБ HBM3e · по сообщениям) |
| Пропускная способность памяти | 4,0 ТБ/с / карта (выше, чем 3,35 ТБ/с у H100) |
| FP16 / BF16 Tensor Core | ~148 TFLOPS (плотный режим; разреженный ~296) |
| FP8 Tensor Core | ~296 TFLOPS (по данным СМИ) |
| FP32 | ~44 TFLOPS (по данным СМИ) |
| Интерконнект GPU-GPU | NVLink четвёртого поколения · 900 ГБ/с (для модуля HGX H20 на 8 карт) |
| Интерконнект с хостом | PCIe Gen5 x16 |
| Энергопотребление платы (TBP/TGP) | ~400 Вт TDP (консенсус СМИ; отдельные страницы каналов указывают 350 Вт) |
| Масштаб CUDA-ядер | на ~41% меньше, чем у H100 (по данным СМИ) |
| Основные форм-факторы систем | Серверы на базе HGX H20 8-GPU (Inspur / H3C / Supermicro и др.) · PCIe-карта |
| Драйверы / CUDA | от драйверов серии 535 (по записи на реальной машине из официальной документации H3C: NVIDIA-SMI 535.161.08 / CUDA 12.2) |
| Предыдущее поколение / прямой конкурент | A800 / H800 (под ограничениями) / H100, H200 |
Спецификации — по перекрёстной проверке открытых источников СМИ[1]; вычислительная мощность Tensor перепроверяется по отчёту прошивки по прибытии и фактическим замерам; отсутствие официальной страницы, подтверждающей заводские данные, — специфический для H20 риск при выборе (см. «Ограничения и споры»).
Межпоколенческое сравнение · как различаются три карты одного поколения GENERATIONS
| Параметр | H100 80GB | H20 96GB | H200 141GB |
|---|---|---|---|
| Память на плату | 80GB HBM3 | 96GB HBM3 | 141GB HBM3e |
| Пропускная способность памяти | 3.35TB/s | 4.0TB/s | 4.8TB/s |
| FP16/BF16 Tensor (разреженный) | 1,979 TFLOPS | ~296 TFLOPS (по данным СМИ) | 1,979 TFLOPS |
| FP8 Tensor (разреженный) | 3,958 TFLOPS | ~296 TFLOPS (по данным СМИ) | 3,958 TFLOPS |
| Интерконнект GPU-GPU | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s |
| Энергопотребление платы (TBP/TGP) | до 700 Вт | ~400 Вт | до 700 Вт |
| Канал для Китая | публичные продажи не одобрены | специальная версия для китайского рынка · колебания политики (нейтрально) | одобрена для Китая 12.2025 |
| Вердикт по выбору | полная мощность · крупнейшая экосистема | урезанная мощность ради допуска · инференс с большой памятью | удвоенная память · массовый флагман |
Столбцы H100/H200 — по официальным страницам, H20 — по данным СМИ; статус канала для Китая — по публичным сообщениям, меняется с политикой и не является юридической консультацией.
Модели семейства FAMILY
Семейство H20 делится на четыре ветки по корпусу и версии памяти; на вторичном рынке доминируют 8-GPU серверы HGX и PCIe-карты:
Охлаждение и развёртывание COOLING
H20 — самое простое в развёртывании поколение семейства Hopper: энергопотребление платы (TBP/TGP) ~400 Вт (по данным СМИ) — это лишь 60% от H100/H200 (уровень 700 Вт); 8-GPU сервер HGX — зрелое решение с воздушным охлаждением, PCIe-карта — двухслотовая, plug-and-play: существующие серверные не требуют переделки под жидкостное охлаждение. Одна из причин, почему её выбрали линии моноблоков для больших моделей в начале 2025 года (по публичным сообщениям).
Совместимость с моделями ИИ MODEL FIT
| Модель / сценарий | Требования к памяти (оценка FP8) | Развёртывание H20 (8 карт, 768 ГБ) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 полная версия (671B) | около 690GB | Восемь карт помещают — 96 ГБ × 8 = 768 ГБ, одна из основных конфигураций моноблоков полной версии DeepSeek в начале 2025 года (по публичным сообщениям); запас невелик, KV cache нужно экономить | 78 |
| R1-Distill уровня 70B | около 70GB | На карте 96 ГБ запас достаточный, вольготнее, чем у H100 (критичные 80 ГБ) | 88 |
| Открытые модели уровня 72B | около 72GB | Помещается на одной карте, для длинного контекста нужен запас под KV cache | 85 |
| Уровень 7B-14B (включая малые модели генерации видео) | около 8-30GB | На карте — легко, для массового продакшена наращивают параллелизм несколькими картами | 90 |
Память оценивается по FP8-весам ≈ количество параметров × 1 байт (расчётная методология, без KV-кэша и запаса на активации); «помещается» относится к объёму памяти, скорость генерации зависит от урезанной вычислительной мощности (Tensor-мощность примерно одна десятая от H100 по той же методологии, по данным СМИ) — throughput определяется фактическими замерами. Индекс AIXX — оценочная методология данной базы.
Галерея GALLERY
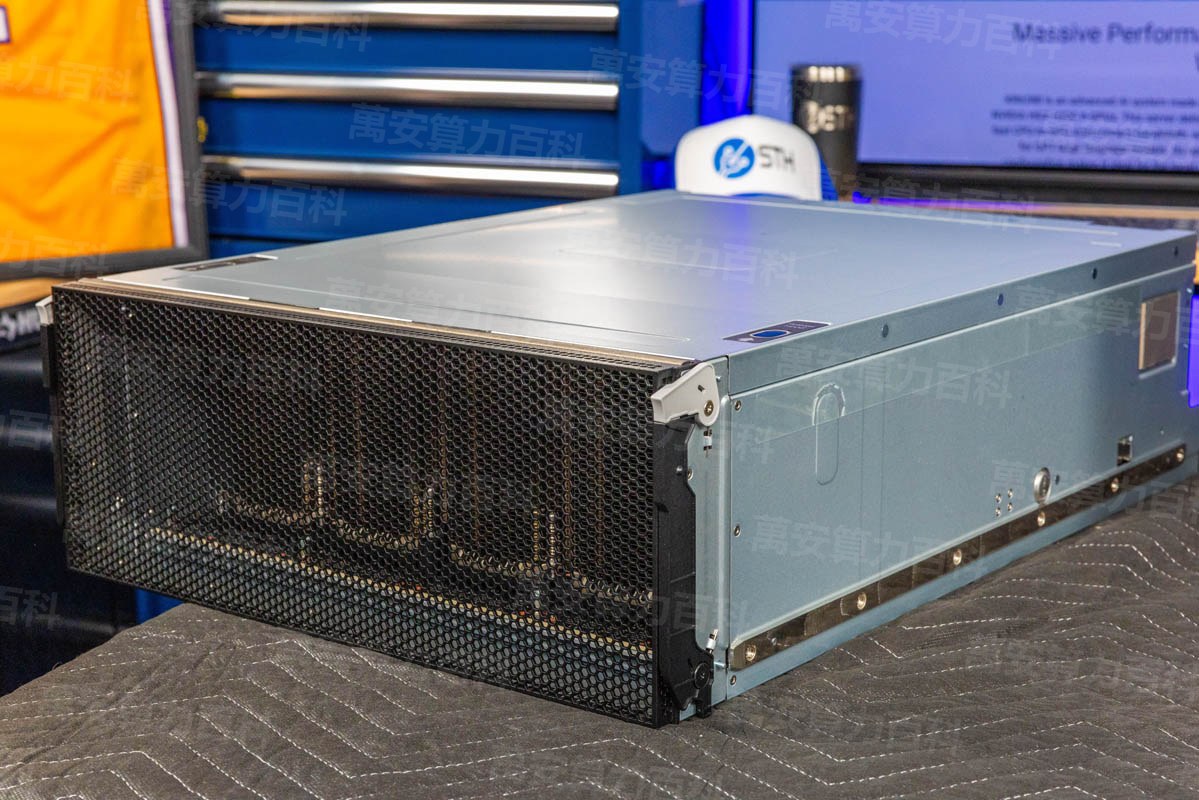
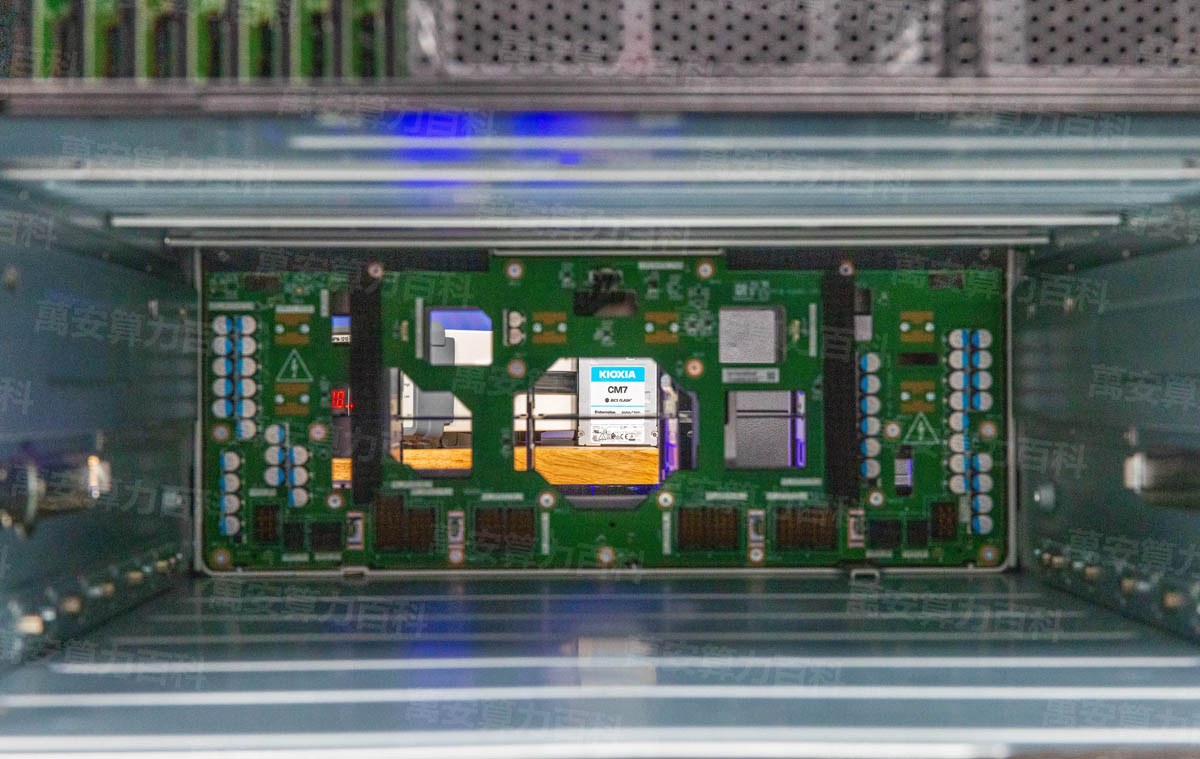
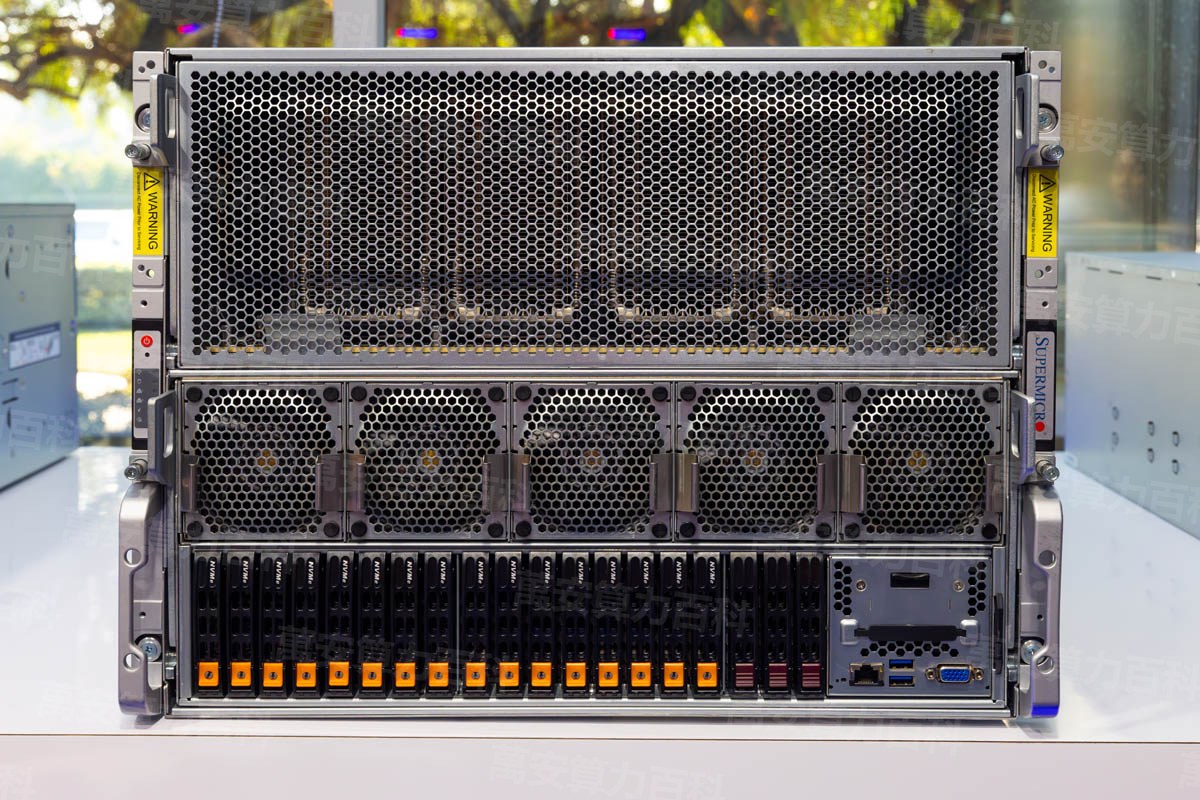
Примечание: H20 — модель, специально поставляемая для Китая; у NVIDIA нет официальной страницы продукта, у авторитетных зарубежных аппаратных СМИ нет и обзорных тестов, поэтому статья пока опирается на изображения от производителей готовых систем; фото реальных образцов будут добавляться по мере проверок партий в этой базе (проверенные фото — источник с высшим приоритетом). AI-изображения не выдаются за реальные; H100/H200 и H20 внешне одинаковы как представители Hopper, фото не может служить критерием идентификации (см. «Закупка и проверка»).
Видеообзор VIDEO
Реальные машины сообщества · источник Bilibili COMMUNITY
Контент реальных машин — от авторов Bilibili (клик загружает официальный плеер Bilibili, просмотр возможен на сайте), права принадлежат исходным авторам. Видео — эталонный кейс специально для H20 (все цифры по реальным характеристикам H20: 96 ГБ / 4,0 ТБ/с / 400 Вт / HGX NVLink 900 ГБ/с · PCIe-версия одной карты помечена как есть), архив озвучки и текстов — в репозитории _wiki_work_1006/gen_tts_benchh20.py.
Реальная машина от сообщества · источник YouTube COMMUNITY HANDS-ON
В некоторых регионах воспроизведение может быть недоступно
Софт и экосистема ECOSYSTEM
| Параметр | Требования / Текущее состояние |
|---|---|
| CUDA / драйверы | от драйверов серии 535 (запись на реальной машине из официального документа развёртывания H3C: NVIDIA-SMI 535.161.08 / CUDA 12.2 распознаёт H20) |
| Фреймворки обучения | PyTorch / TensorFlow официально поддерживают Hopper; мощность H20 ограничена, обучение — в основном мелкомасштабный файнтюнинг |
| Движки инференса | vLLM / SGLang / TensorRT-LLM — нативная поддержка; большая память + высокая пропускная способность — основа инференс-пропускной способности |
| Сетевое оснащение | ConnectX-7 400G или равнозначное решение (стандарт OEM-производителя серверов/системного интегратора) |
| Операционная система | Основные дистрибутивы Linux (Ubuntu 22.04+ и т.п.) |
H20, H100 и H200 принадлежат к экосистеме Hopper, программный стек полностью общий — «урезания экосистемы» нет, есть «урезание мощности». Версии стека развиваются во времени, ориентир — официальные релизы NVIDIA.
Закупка и приёмка PROCUREMENT
Три пункта проверки при закупке H20:
Полные шесть эталонных проверок (цифры по H20) — в этой статье «Как проводить стресс-тест» этой статьи.
Как проводить стресс-тесты BENCH TEST
Шесть проверок, все числовые эталоны по реальным характеристикам H20: распознавание при распаковке → стресс-тест одиночной карты (башня с воздушным охлаждением уровня 400 Вт, ≤85 °C, без ошибок ECC — пройдено) → полная нагрузка всего сервера → пропускная способность памяти (номинал 4,0 ТБ/с, пройдено при ≥85%) → интерконнект (nccl-tests на узле HGX ≥750 ГБ/с / для PCIe-карты проверка полного линка Gen5 x16) → инференс-пропускная способность (≥80% публичных бенчмарков).
nvidia-smigpu-burn 3600 или dcgmi diag -r 3 · 30–60 минутbandwidthTest(встроенный пример CUDA)nccl-tests бенчмарк all_reducevLLM запуск реальной модели под нагрузкойМетодология: пороги «Пройдено»/«Отлично» составлены базой по общепринятой инженерной практике(пропускная способность — доля от номинала, температура — типовой лимит для дата-центров)и постепенно калибруются по накопленным данным отчётов о проверке товара; таблица не является каким-либо приёмочным обязательством, конкретные условия определяются договором. Измеряемые показатели в отчётах о проверке товара базы фиксируются по этой методологии — NOT_EXECUTED означает, что пункт не выполнялся; само «не тестировали» — тоже важная информация.
Доставка и приёмка LOGISTICS
OEM и варианты VENDORS
Одна и та же плата HGX H20, но готовые системы разных производителей различаются форм-фактором, охлаждением и сервисом — при выборе сначала смотрите на различия:
| Производитель систем | Форм-фактор | Отличия | Кому подходит |
|---|---|---|---|
| Inspur | NF5688G7 и др. (модуль HGX Hopper на 8 карт) | Лидер по доле локальных AI-серверов, отлаженное производство готовых систем[9] | Локальные развёртывания · производство готовых систем |
| H3C | Серия UniServer (HGX H20, 8 карт) | Полная официальная документация по развёртыванию (опубликованы записи распознавания реальных H20), развитая сервисная сеть[10] | Корпоративные клиенты · важны документация и сервис |
| Supermicro | Готовые системы HGX H20 на 8 карт (китайский канал) | OEM-производитель больших объёмов, глобальная цепочка поставок (по данным открытых источников) | Приоритет цены · оптовые закупки |
| Интеграторы PCIe-карт | Башенные/стоечные 4U/2U системы с 8×PCIe H20 | Без полной связности NVLink, ниже стоимость, подходит для сценариев с преобладанием инференса | Инференс · приоритет бюджета |
AIXX Index · Сравнение развёртывания по четырём измерениям AIXX INDEX
| Производитель систем | Простота установки | Удобство обслуживания | Плотность производительности | Ожидаемый срок службы |
|---|---|---|---|---|
| Inspur | 88 | 86 | 82 | 80 |
| H3C | 86 | 88 | 81 | 82 |
| Supermicro | 84 | 80 | 84 | 80 |
| Интеграторы PCIe-карт | 90 | 82 | 68 | 78 |
AIXX Index — это оценочная шкала каталога (0–100, оценка основана на открытых данных о форм-факторе, схеме охлаждения и различиях сервисной сети), обновляется по мере проверки реальных машин и не является обязательством по закупке. Конкретные модели определяются официальными публикациями производителей.
Терминологические карточки GLOSSARY
специальная версия для китайского рынка
Модель, чья производительность снижена до лицензионных порогов согласно требованиям политики экспортного контроля США для легального выхода на рынок материкового Китая. H20 — линия специальных версий поколения Hopper (ранее были A800/H800): логика компромисса — сохранить память, пропускную способность и связность, урезав Tensor-производительность. Все формулировки базы основаны на открытых источниках и не являются юридической консультацией.
96GB HBM3 · 4.0TB/s
Основа позиции H20: объём памяти и пропускная способность одной карты выше, чем у H100 (80 ГБ / 3,35 ТБ/с) — экспортный контроль ограничивает показатели вычислительной мощности, а не памяти. Это редкий случай, когда «специальная версия оказывается сильнее по отдельному параметру».
NVLink 4 · 900GB/s
NVLink четвёртого поколения: модуль HGX H20 на 8 карт того же поколения и той же скорости, что H100/H200; PCIe-карта лишена NVLink — при мультикарточных конфигурациях сначала уточняйте форм-фактор.
Модуль HGX H20 на 8 карт
8 чипов H20 на плате с полной связностью через NVSwitch, суммарно 768 ГБ памяти — полная версия DeepSeek R1 в FP8 (около 690 ГБ) помещается в одну систему; именно поэтому в начале 2025 года её сметали с прилавков (расчётная оценка + открытые источники).
Лицензионный режим / разрешение на возобновление
В 2025-04 США потребовали лицензию на экспорт H20 в Китай (NVIDIA зарезервировала около 5,5 млрд долл.), 2025-07-15 разрешение получено, после чего условия поставок и закупок менялись вслед за политикой. Партия и лицензионный статус влияют на гарантию и сохранность стоимости — обязательная проверка при покупке. Не является юридической консультацией.
Ограничения и споры LIMITS
- Урезанная вычислительная мощность — главный недостаток (пишем как есть) : Tensor-производительность в FP16/FP8 составляет примерно одну десятую от сопоставимых показателей H100/H200 (по данным СМИ[1]) — это плата «соответствие требованиям в обмен на доступ к китайскому рынку»: инференс не страдает, но для обучения и сценариев с высокой плотностью вычислений она совершенно не подходит. Купить её как тренировочную карту — худшая ошибка при выборе.
- Характеристики без официального подтверждения : NVIDIA не открыла официальную страницу продукта H20, параметры в сети противоречивы (разные трактовки INT8/разреженности, ошибочные данные о 300 ГБ/с NVLink) — все данные статьи помечены как данные СМИ, при проверке опирайтесь на отчёты прошивки и реальные замеры.
- Неопределённый жизненный цикл продукта : с августа 2025 года появляются сообщения о сворачивании производства и о преемниках (B30A и др.), судьба преемника не решена (по данным открытых источников[4]) — неопределённость в части долгосрочных запчастей, поддержки драйверов и сохранности стоимости; база не даёт однозначных оценок.
- Нестабильная закупочная среда в Китае : сообщения о регуляторной осторожности и проверках безопасности с 2025-08, одобрение H200 в 2025-12 как преемника — официальные пути закупки H20 в Китае колебались вместе с политикой (нейтральная формулировка, открытые источники, не юридическая консультация).
- Ловушки в трактовке версий : путаются начальная версия 96GB HBM3 и обновлённая с ~148GB HBM3e (по сообщениям СМИ); большая разница цен между готовыми HGX-системами и PCIe-картами — при запросе цены «сервера H20» обязательно уточняйте версию и форм-фактор.
- Высокая волатильность цен на вторичном рынке : во время ажиотажа в 2025-01 цена выросла примерно на 100 тыс. юаней за систему за месяц, краткосрочный скачок в 2025-04 на фоне слухов о прекращении поставок (по данным открытых источников) — рынок резко реагирует на политические новости, цены уточняйте у актуальных продавцов, см. «рыночную полосу».
Рыночный диапазон цен MARKET DATA
| Дата | Методика | Регион | Диапазон ориентировочной цены | Примечание |
|---|---|---|---|---|
| 2025-02 | Сообщения каналов | Материковый Китай | Система на 8 карт — около 1,1 млн юаней/шт. (более чем +100 тыс. к уровню начала года) | Данные Cailianshe[6] |
| 2025-02 | Сообщения каналов | Материковый Китай | Цена одной карты — около 110 тыс. юаней/шт. | Данные Cailianshe[6] |
| 2025-07 | Ожидания спроса и предложения | Материковый Китай | Продажи возобновлены, ожидается рост доли потребления HBM до 6% в 2025 году | TrendForce[3] |
| 2026-10-20 | Зал базы | — | H20 в продаже отсутствует | Проверено базой (семейство сверено по точной модели); рыночные снимки накапливаются ежедневно с 2026-10-20, при наличии товара выводятся автоматически |
Оговорка к графику: в базе сейчас нет H20 в продаже, внешних якорных цен лишь отдельные точки — расчётный диапазон не строим (проводить кривую по разрозненным точкам — значит выдумывать данные; непроверенное не публикуем); график тренда цен автоматически появится после накопления рыночных снимков (как в статьях H100/H200).
Ключевые ценовые события MILESTONES
Частые вопросы FAQ
Смотрите, где узкое место: для инференса и сценариев с большой памятью (70B на одну карту, полная R1 на восемь карт) 96 ГБ/4,0 ТБ/с у H20 даже выше, чем 80 ГБ/3,35 ТБ/с у H100, плюс это была легально продававшаяся в Китае модель с 400 Вт — просто в развёртывании; для обучения, ускоренного файнтюнинга и сценариев с высокой плотностью вычислений Tensor-производительность H20 — примерно одна десятая от сопоставимых показателей H100 (по данным СМИ) — берите сразу H100/H200. Одной фразой: H20 продают за память и доступ, H100/H200 — за вычислительную мощность.
H20 — специальная версия для китайского рынка согласно требованиям политики экспортного контроля США: вышла в 2024 году, в апреле 2025-го временно попала под лицензионное требование, в июле получила разрешение на возобновление, после чего поставки и закупочная среда менялись вслед за политикой (по открытым источникам). На 2026 год в наличии преимущественно ранее оборот установленного парка, поставки новых машин остановлены. Материал не является юридической консультацией, статус соответствия закупок определяйте по политике регуляторов и профессиональным заключениям.
Экспортный контроль ограничивает показатели вычислительной мощности, а не памяти — H20 сохранила 96 ГБ HBM3 и 4,0 ТБ/с (против 80 ГБ / 3,35 ТБ/с у H100), урезанной оказалась Tensor-производительность. Поэтому это карта, созданная для инференса: инференс больших моделей требует памяти и пропускной способности, а не пиковой вычислительной мощности.
Основной объём поставок 2024 года пришёлся на начальную версию 96GB HBM3; обновлённая версия с ~148GB HBM3e известна по сообщениям СМИ (в отдельных публикациях фигурируют 141–148 ГБ). Внешне версии неотличимы — при проверке опирайтесь на фактический объём памяти по nvidia-smi и отчёт прошивки, в договоре обязательно указывайте версию.
Да: восемь карт HGX H20 дают суммарно 768 ГБ (96 ГБ×8), полные веса в FP8 занимают около 690 ГБ (расчётная оценка) — помещаются. Именно поэтому в начале 2025 года в инференс-системах для DeepSeek массово применяли H20 (по открытым источникам). Но учтите: «помещается» не значит «работает быстро» — скорость генерации страдает от урезанной производительности, ориентируйтесь на реальные замеры.
Связанные статьи SEE ALSO
Сравнение моделей и выбор COMPARE
Источники REFERENCES
- MIT Technology Review China — NVIDIA возобновила продажи H20 в Китае (96GB HBM3 / 4,0 ТБ/с / FP8 296 TFLOPS / FP16 148 TFLOPS / ядер на 41% меньше, чем у H100) https://www.mittrchina.com/news/detail/15016
- Reuters — сообщение о разработке NVIDIA соответствующего требованиям чипа для Китая (2023-12, пересказ) https://www.reuters.com/technology/
- TrendForce — H20 Export Approval Reignites Demand Momentum (партии 2024: HBM3 8-Hi / план обновления до HBM3e / 2025-04: около 2,5 млрд долл. непоставленной продукции / 2025-07-15: возобновление экспорта) https://www.trendforce.com/presscenter/news/20250716-12644.h…
- CNBC — Nvidia still hasn't sold its U.S.-approved China AI chips(2026-02-26) https://www.cnbc.com/2026/02/26/nvidia-china-chip-sales-expo…
- MyDrivers/Sina Finance — H200 разрешат продавать, но HBM3E по-прежнему под запретом (2025-12-11, подтверждение преемственности H200) https://finance.sina.com.cn/tech/discovery/2025-12-12/doc-in…
- Cailianshe — Дороже на 100 тыс. к началу года! H20 стала «любимицей крупных компаний» (2025-02, система на 8 карт — около 1,1 млн юаней/шт., карта — около 110 тыс. юаней) https://www.cls.cn/detail/1956679
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (авторитетный архив по хронологии экспортного контроля) https://www.congress.gov/crs-product/R48642
- Los Angeles Times — Nvidia's AI chip sales in China stall as local chipmakers like Huawei take lead(2026-06-29) https://www.latimes.com/business/story/2026-06-29/
- Inspur — страница AI-сервера NF5688G7 (модуль HGX-Hopper-8GPU; источник изображения системы в статье) https://www.ieisystem.com/product/ai/15080.html
- H3C — документация по развёртыванию H20 (записи реального распознавания: NVIDIA-SMI 535.161.08 / CUDA 12.2) https://www.h3c.com
- Tom's Hardware — Nvidia responds to reports that its H20 GPU for China is ending production (сообщения об ожидании одобрения B30A) https://www.tomshardware.com/tech-industry/artificial-intell…
- Nvidia working on new AI chip for China that outperforms H20(2025-08-19) https://www.reuters.com/technology/nvidia-working-new-ai-chi…
- GPU Database — NVIDIA H20 (9984 CUDA / 60 МБ L2 / 400 Вт) https://www.techpowerup.com/gpu-specs/nvidia-h20.c4184.html
- Данные рыночной полосы — AIXX Pedia (актуальные котировки платформы и диапазон по канальным данным, обновляется ежедневно; по H20 зафиксировано 0 предложений в наличии) https://www.aixx.vip/hall.html