AIXX Pedia › Ficha de modelo › H20

H20
Visão geral OVERVIEW
H20 (NVIDIA H20) é uma GPU de data center variante exclusiva para o mercado chinês em conformidade, desenvolvida pela NVIDIA sob as exigências da política de controle de exportações dos EUA: arquitetura Hopper (derivada do GH100), lançada e enviada em 2024 , na mesma leva dos modelos exclusivos L20/L2. É a sucessora da linha A800/H800, que foi incluída nas restrições com o endurecimento do controle em outubro de 2023[2][7]。
Sua lógica de projeto é uma troca explícita: o controle de exportação travou as métricas de computação, então o H20 reduziu o poder de computação Tensor para cerca de um décimo do H100 na mesma base de comparação (segundo a imprensa), mas manteve os 96GB de HBM3, a largura de banda de 4.0TB/s e a interconexão NVLink de 900GB/s da mesma geração — memória e largura de banda até superiores às do H100. É uma placa feita para inferência, não para treinamento[1]。
Um destino de altos e baixos: em janeiro de 2025, a febre do DeepSeek desencadeou uma corrida de compras (servidores de 8 placas chegaram a subir para cerca de 1,1 milhão de RMB por unidade, segundo relatos públicos[6]); em abril de 2025, os EUA exigiram licença momentaneamente e a NVIDIA provisionou cerca de 5,5 bilhões de dólares; em julho de 2025, obteve aprovação para retomar; depois, com as oscilações de política e do ambiente de compras, em dezembro de 2025 o H200 foi aprovado para assumir no mercado chinês e o H20 saiu gradualmente do centro das atenções (consolidação de relatos públicos[4][5]). No mercado de pronta entrega de 2026, o H20 circula sobretudo como base instalada das primeiras remessas.
Cenários de uso FIT
AIXX Index (0–100): esta base estima com pesos baseados em especificações públicas — memória de vídeo 40% + interconexão 30% + ecossistema 30%, com pesos ajustados por cenário. 90+ nível flagship · 75+ Excelente · 60+ utilizável · abaixo de 60 não recomendado. Metodologia transparente e verificável, não constitui promessa de desempenho.
Histórico HISTORY
Em 17 de outubro de 2023 , o controle de exportações dos EUA endureceu e as variantes A800/H800 para a China passaram a exigir licença; a NVIDIA passou a desenvolver uma nova rodada de variantes em conformidade — a imprensa noticiou em dezembro de 2023 o novo chip em desenvolvimento para a China (posteriormente batizado H20, na mesma leva com L20/L2)[2][7]。
Em 2024 , o H20 começou a ser enviado (os lotes do ano foram principalmente a versão HBM3 8-Hi, segundo a TrendForce[3]); sistemas com o módulo HGX H20 de 8 placas chegaram ao mercado por fabricantes como Inspur e H3C; a NVIDIA não abriu página oficial do produto, e as especificações baseiam-se em material da imprensa e dos integradores. As vendas iniciais foram fracas — cortes de computação somados à concorrência de alternativas domésticas (segundo relatos públicos).
2025 Foi um ano de montanha-russa: em janeiro-fevereiro a febre do DeepSeek desencadeou compras em massa, servidores de 8 placas subiram de cerca de 1 milhão para cerca de 1,1 milhão de RMB por unidade, e grandes empresas encomendaram cargas de inferência em volume (segundo a agência Cailianshe[6]); em abril, os EUA passaram a exigir licença para exportação à China e a NVIDIA provisionou cerca de 5,5 bilhões de dólares (dos quais cerca de 2,5 bilhões em H20 que não pôde ser enviado[3]); em 15 de julho, obteve aprovação para retomar as vendas (relatos posteriores mencionaram arranjos de compartilhamento de receita); a partir de agosto, o ambiente de compras tornou-se cauteloso, com rumores de encerramento da produção e vazamentos do chip sucessor[4]。
Do fim de 2025 até hoje : em dezembro, o H200 foi aprovado para suceder na China (a memória HBM3E permanece restrita, segundo o MyDrivers[5]); em 2026, veículos de imprensa noticiaram que as vendas reais de chips de IA da NVIDIA para a China estavam paralisadas e que a participação dos fabricantes locais crescia (CNBC 02/2026, Los Angeles Times 06/2026[4][8]). O papel do H20 no mercado de pronta entrega passou a ser a circulação da base instalada: sistemas comprados no início ainda servem e são revendidos em data centers domésticos. Todas as afirmações desta ficha baseiam-se em relatos públicos e não constituem parecer jurídico.
Especificações técnicas SPECIFICATIONS
Nota de metodologia: a NVIDIA não mantém página oficial do H20 (a variante para a China não consta do catálogo global); a tabela abaixo segue o que a imprensa e os integradores divulgaram , com valores conservadores nos campos divergentes; prevalecem os relatórios de firmware e as medições reais.
| Item | Especificações (H20 · segundo a imprensa) |
|---|---|
| Núcleo da GPU | NVIDIA Hopper (derivado do GH100 em conformidade para a China) |
| Memória de vídeo por placa | 96GB HBM3 (versão atualizada com ~148GB HBM3e · segundo relatos) |
| Largura de banda de memória | 4.0TB/s por placa (acima dos 3.35TB/s do H100) |
| FP16 / BF16 Tensor Core | ~148 TFLOPS (denso; ~296 esparso) |
| FP8 Tensor Core | ~296 TFLOPS (segundo a imprensa) |
| FP32 | ~44 TFLOPS (segundo a imprensa) |
| Interconexão GPU-GPU | NVLink de quarta geração · 900GB/s (especificação do módulo HGX H20 de 8 placas) |
| Interconexão com o host | PCIe Gen5 x16 |
| Consumo da placa (TBP/TGP) | ~400W TDP (leitura majoritária da imprensa; algumas páginas de canais indicam 350W) |
| Escala de CUDA cores | ~41% menos que o H100 (segundo a imprensa) |
| Formato principal de máquina completa | Sistema HGX H20 de 8 placas (Inspur / H3C / Supermicro etc.) · placa única PCIe |
| Drivers / CUDA | A partir da série 535 (registro real em documentação oficial da H3C: NVIDIA-SMI 535.161.08 / CUDA 12.2) |
| Geração anterior / produto equivalente | A800 / H800 (já restritos) / H100, H200 |
Especificações conforme cruzamento de fontes públicas da imprensa[1]; a computação Tensor deve ser verificada com relatórios de firmware e medições — a ausência de dados de fábrica respaldados por página oficial é um risco de seleção peculiar do H20 (ver "Limitações e controvérsias").
Comparação geracional · como se dividem as três placas da geração GENERATIONS
| Item | H100 80GB | H20 96GB | H200 141GB |
|---|---|---|---|
| Memória de vídeo por placa | 80GB HBM3 | 96GB HBM3 | 141GB HBM3e |
| Largura de banda de memória | 3.35TB/s | 4.0TB/s | 4.8TB/s |
| Tensor FP16/BF16 (esparso) | 1,979 TFLOPS | ~296 TFLOPS (segundo a imprensa) | 1,979 TFLOPS |
| Tensor FP8 (esparso) | 3,958 TFLOPS | ~296 TFLOPS (segundo a imprensa) | 3,958 TFLOPS |
| Interconexão GPU-GPU | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s |
| Consumo da placa (TBP/TGP) | Até 700W | ~400W | Até 700W |
| Canal para a China | Sem aprovação para venda pública | Variante em conformidade · vaivém de política (leitura neutra) | Aprovada para a China em 12/2025 |
| Recomendação em uma frase | Computação máxima · maior ecossistema | Trocou computação por acesso · inferência com muita memória | Memória dobrada · carro-chefe de volume |
As colunas H100/H200 seguem a página oficial e a H20 segue divulgações da imprensa; o estado do canal para a China é leitura de relatos públicos e evolui com a política, sem constituir parecer jurídico.
Membros da família FAMILY
A família H20 divide-se em quatro variantes por encapsulamento e versão de memória; no mercado de pronta entrega predominam o sistema HGX de 8 placas e a placa única PCIe:
Refrigeração e implantação COOLING
O H20 é a geração da família Hopper mais fácil de implantar : o consumo da placa (TBP/TGP) de ~400W (segundo a imprensa) equivale a cerca de 60% do H100/H200 (classe 700W); o sistema HGX de 8 placas é uma solução refrigerada a ar consolidada, e a placa PCIe dual-slot é plug-and-play — data centers existentes não precisam de retrofit para refrigeração líquida para hospedá-lo, uma das razões de sua escolha pelas linhas de soluções all-in-one de grandes modelos no início de 2025 (segundo relatos públicos).
Compatibilidade de modelos MODEL FIT
| Modelo / cenário | Necessidade de memória (estimativa FP8) | Implantação do H20 (8 placas, 768GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 completo (671B) | Cerca de 690GB | Cabe nas oito placas — 96GB×8=768GB, uma das configurações principais das soluções all-in-one DeepSeek completas do início de 2025 (segundo relatos públicos); a folga é apertada e o KV cache exige planejamento | 78 |
| R1-Distill nível 70B | Cerca de 70GB | Placa única de 96GB com boa folga, mais confortável que o H100 (80GB, no limite) | 88 |
| Modelos open-source nível 72B | Cerca de 72GB | Implantável em placa única; em contextos longos, reserve margem de KV cache | 85 |
| Nível 7B-14B (incluindo pequenos modelos de geração de vídeo) | Cerca de 8-30GB | Tranquilo em placa única; produção em grande escala empilha placas para mais concorrência | 90 |
Memória estimada por pesos em FP8 ≈ nº de parâmetros × 1 byte (estimativa, sem incluir KV cache nem margem de ativações); "cabe" refere-se apenas à dimensão de capacidade — a velocidade de geração sofre com o corte de computação (Tensor em ~1/10 do H100 na mesma base, segundo a imprensa) — o throughput prevalece conforme medição. O AIXX Index segue a metodologia de estimativa desta base.
Galeria GALLERY
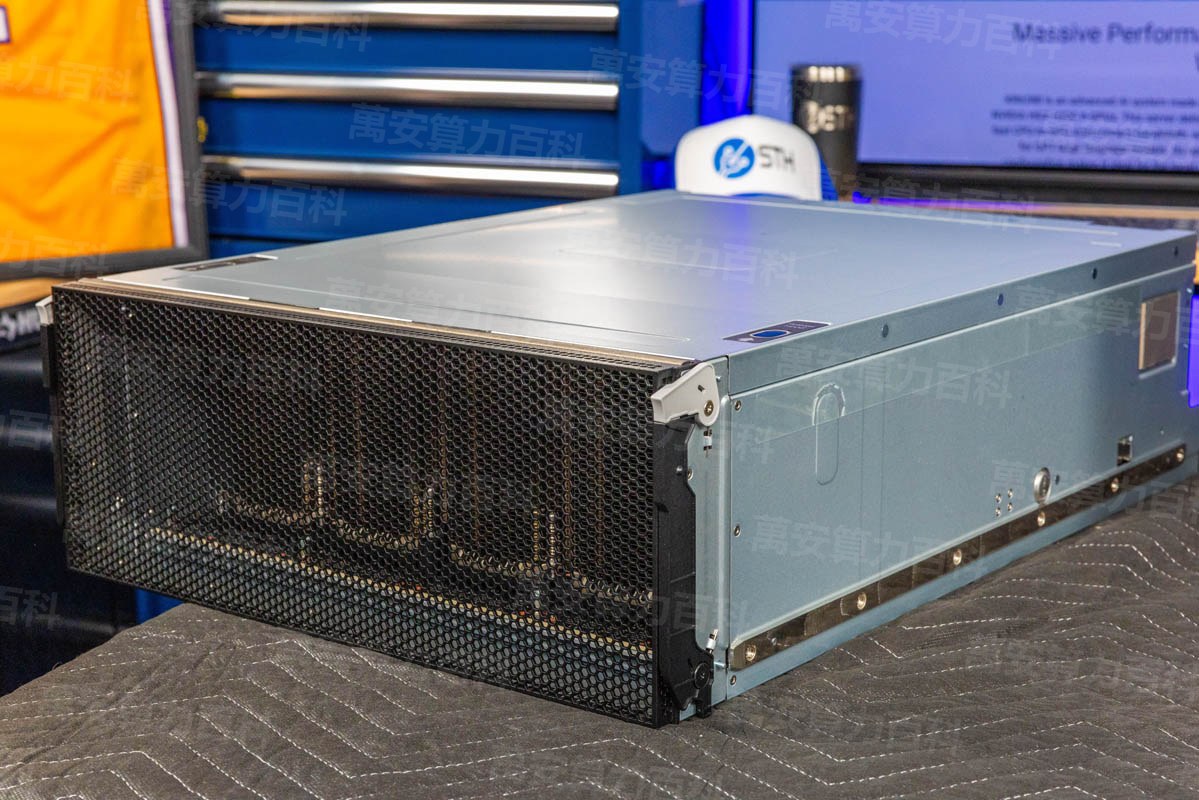
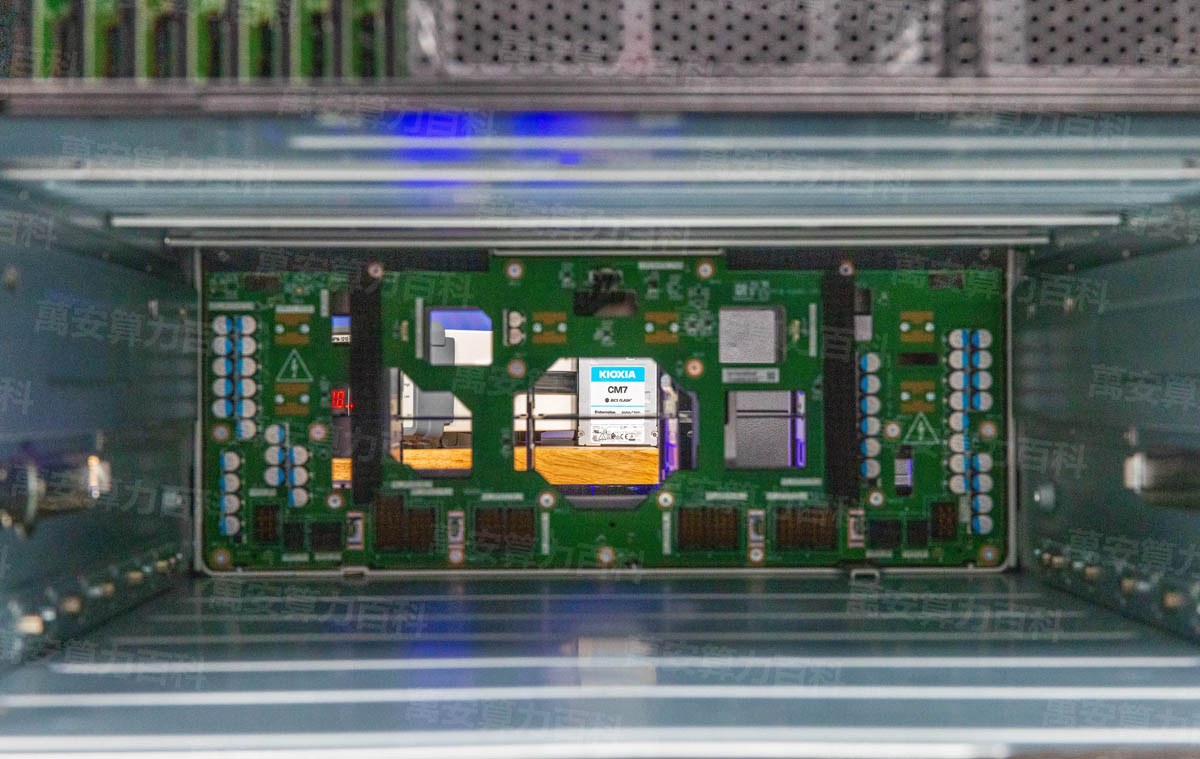
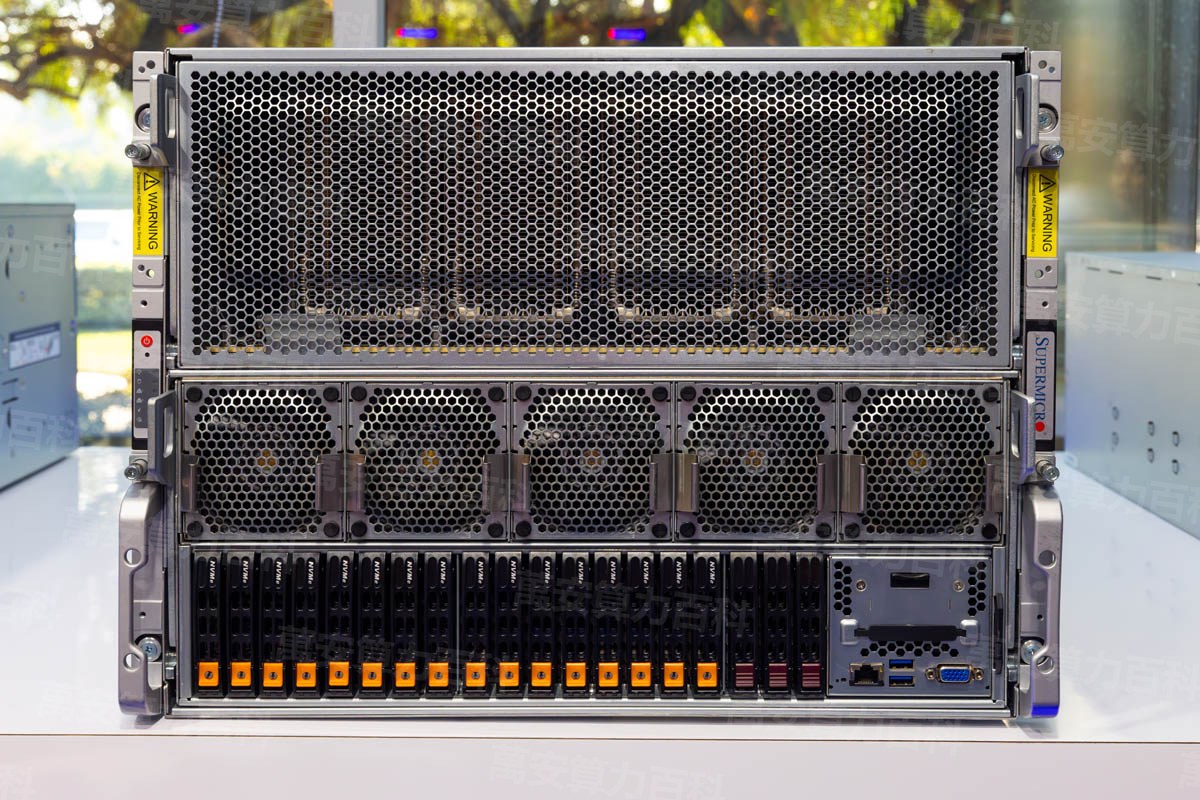
Nota: o H20 é uma variante exclusiva para o mercado chinês; a NVIDIA não mantém página oficial e não há análises com fotos reais na grande imprensa internacional de hardware, por isso esta ficha usa por ora imagens dos integradores; fotos reais das inspeções desta base serão acrescentadas continuamente (as fotos de inspeção da base têm máxima prioridade como fonte de imagem). Imagens geradas por IA não se passam por fotos reais; H100/H200 e H20 têm a mesma aparência da família Hopper — fotos não servem como critério de identificação (ver "Compra e inspeção").
Vídeo explicativo VIDEO
Demonstrações reais da comunidade · fonte: Bilibili COMMUNITY
Conteúdo de demonstrações reais da comunidade, de criadores do Bilibili (clicando, carrega o player oficial do Bilibili, com reprodução direta na página); direitos autorais dos UP originals. O vídeo é um caso de referência exclusivo do H20 (todos os valores ancorados no H20: 96GB / 4.0TB/s / 400W / HGX NVLink 900GB/s · especificação PCIe de placa única indicada como tal); narração e textos de cena arquivados em _wiki_work_1006/gen_tts_benchh20.py.
Máquina real da comunidade · fonte: YouTube COMMUNITY HANDS-ON
Em algumas regiões pode não ser possível reproduzir diretamente
Software e ecossistema ECOSYSTEM
| Item | Requisitos / situação atual |
|---|---|
| CUDA / drivers | A partir da série 535 (registro real na documentação oficial de implantação da H3C: NVIDIA-SMI 535.161.08 / CUDA 12.2 reconhecendo o H20) |
| Framework de treino | PyTorch / TensorFlow suportam oficialmente o Hopper; com computação limitada, o H20 destina-se sobretudo a fine-tuning em pequena escala |
| Motores de inferência | vLLM / SGLang / TensorRT-LLM suportam nativamente; muita memória + alta largura de banda são a base do throughput de inferência |
| Infraestrutura de rede | ConnectX-7 400G ou solução de interconexão equivalente (padrão dos integradores) |
| Sistema operacional | Distribuições Linux mainstream (Ubuntu 22.04+, etc.) |
O H20 pertence ao mesmo ecossistema Hopper do H100/H200 e compartilha integralmente a pilha de software — não há "ecossistema reduzido", há "computação reduzida". As versões da pilha evoluem com o tempo; prevalecem os lançamentos oficiais da NVIDIA.
Aquisição e inspeção PROCUREMENT
Pontos de inspeção na compra de um H20 (três):
Os seis casos completos de burn-in (valores ancorados no H20) constam desta ficha "Como testar" desta ficha.
Como fazer stress test BENCH TEST
Metodologia dos seis testes, com todos os valores ancorados no H20: identificação na abertura → Teste de burn-in de placa única (torre refrigerada a ar classe 400W, ≤85°C, zero ECC, Aprovado) → carga máxima do sistema → largura de banda de memória (nominal 4.0TB/s, ≥85% Aprovado) → interconexão (conjunto HGX com nccl-tests ≥750GB/s / placa PCIe valida Gen5 x16 com enlace pleno) → throughput de inferência (≥80% do benchmark público).
nvidia-smigpu-burn 3600 ou dcgmi diag -r 3 · 30–60 minutosbandwidthTest(exemplo nativo do CUDA)nccl-tests benchmark all_reducevLLM rodar um modelo real com cargaNota metodológica: as linhas de Aprovado/Excelente foram compiladas por este banco segundo critérios de engenharia usuais (largura de banda como proporção do valor nominal, temperatura no limite comum para data centers) e serão calibradas progressivamente com dados medidos dos relatórios de inspeção; esta tabela não constitui qualquer compromisso de aceitação, prevalecendo o acordado em contrato. Os itens medidos no relatório de inspeção deste banco são registrados conforme esta tabela — NOT_EXECUTED indica que o item não foi executado, e o próprio «não testado» também é informação relevante.
Transporte e entrega LOGISTICS
OEM e variantes VENDORS
Com a mesma placa-base HGX H20, o que difere entre os fabricantes é o formato, o resfriamento e o serviço — antes de escolher, veja as diferenças:
| Fabricante | Formato representativo | Diferenciais | Para quem |
|---|---|---|---|
| Inspur | NF5688G7 (YuanNao) e similares (módulo HGX Hopper de 8 GPUs) | Liderança na participação de servidores de IA locais, linha de produção de all-in-one madura[9] | Implantação doméstica · linha all-in-one |
| H3C | Série UniServer (HGX H20 de 8 GPUs) | Documentação oficial de implantação completa (registros públicos de reconhecimento do H20 em hardware real), rede de serviços em profundidade[10] | Clientes corporativos · quem prioriza documentação e serviço |
| Supermicro | Servidor HGX H20 de 8 GPUs (canal da região da China) | OEM de grande volume, com contexto de cadeia de suprimentos global (segundo relatos públicos) | Quem busca custo-benefício · compra em lote |
| Integradores de placa única PCIe | Torre/rack 4U/2U com 8×PCIe H20 | Sem interconexão total NVLink, custo menor, adequado para cenários predominantemente de inferência | Linha de inferência · prioridade orçamentária |
AIXX Index · comparação de implantação em quatro dimensões AIXX INDEX
| Fabricante | Facilidade de instalação | Facilidade de manutenção | Densidade de desempenho | Expectativa de vida útil |
|---|---|---|---|---|
| Inspur | 88 | 86 | 82 | 80 |
| H3C | 86 | 88 | 81 | 82 |
| Supermicro | 84 | 80 | 84 | 80 |
| Integradores de placa única PCIe | 90 | 82 | 68 | 78 |
O AIXX Index é uma estimativa desta base (0–100, calculada com base em formato público, solução de refrigeração e diferenças na rede de serviços), atualizada conforme verificação em unidades reais, e não constitui compromisso de compra. Os modelos específicos prevalecem conforme o anúncio oficial do fabricante.
Cartões de terminologia GLOSSARY
Variante exclusiva para o mercado chinês
Modelo cujo desempenho foi reduzido aos limites de licença para entrar legalmente no mercado continental chinês, sob a política de controles de exportação dos EUA. O H20 é a linha especial da geração Hopper (antes dele, A800/H800); a lógica de troca: manter memória/banda/interconexão e cortar o poder de processamento Tensor. Todas as informações nesta base são de relatos públicos e não constituem aconselhamento jurídico.
96GB HBM3 · 4.0TB/s
A razão de ser do H20: memória e banda por GPU superiores às do H100 (80 GB / 3,35 TB/s) — o que os controles de exportação restringem são os indicadores de computação, não a memória. É um caso raro em que a "variante especial acaba sendo superior em um aspecto".
NVLink 4 · 900GB/s
NVLink de quarta geração; o módulo HGX H20 de 8 GPUs é da mesma geração e velocidade que H100/H200; a versão de placa única PCIe não tem NVLink — antes de montar um cluster multi-GPU, primeiro distinga o formato.
Módulo HGX H20 de 8 GPUs
8 GPUs H20 soldadas na placa-base com interconexão total via NVSwitch, totalizando 768 GB de memória — o DeepSeek R1 completo em FP8 (cerca de 690 GB) cabe em uma única máquina; essa é a razão concreta da corrida por compras no início de 2025 (estimativa + relatos públicos).
Gestão de licenciamento / retomada aprovada
Em 04/2025, os EUA passaram a exigir licença para a exportação do H20 à China (a NVIDIA provisionou cerca de US$ 5,5 bilhões); em 15/07/2025 houve aprovação para retomada, e desde então a oferta e o ambiente de compras oscilam conforme a política. Lote e status de licença afetam garantia e valor de revenda — verifique obrigatoriamente na inspeção. Não constitui aconselhamento jurídico.
Limitações e controvérsias LIMITS
- O maior defeito é o poder de processamento reduzido (dito com franqueza) : o desempenho Tensor em FP16/FP8 é cerca de um décimo do H100/H200 no mesmo critério (segundo divulgação da mídia[1]) — essa é a troca de "conformidade em troca de acesso ao mercado continental": a inferência não é afetada, mas o treinamento e cenários de alta densidade computacional são totalmente inadequados. Comprá-lo como GPU de treinamento é o maior erro de seleção possível.
- Especificações sem respaldo de página oficial : a NVIDIA não mantém uma página oficial de produto para o H20, e os parâmetros circulantes são confusos (critérios de INT8/esparso divergentes, boato errado de NVLink a 300 GB/s) — todas as informações deste verbete estão marcadas como divulgação da mídia; na inspeção, prevalecem os relatórios de firmware e testes reais.
- Ciclo de vida do produto incerto : desde agosto de 2025, alternam-se rumores de encerramento de produção e relatos de chips sucessores (B30A etc.), com a aprovação do sucessor em aberto (relatos públicos[4]) — há incerteza em peças de reposição de longo prazo, suporte de drivers e expectativa de valor de revenda; esta base não faz juízo definitivo.
- Ambiente de compras no continente oscilante : relatos de cautela regulatória e revisão de segurança a partir de 08/2025, e a aprovação do H200 em 12/2025 como sucessor — o caminho oficial de compra do H20 no continente varia conforme a evolução da política (formulação neutra, relatos públicos, não constitui aconselhamento jurídico).
- Armadilha de critérios de versão : a versão inicial de 96 GB HBM3 e a versão atualizada de ~148 GB HBM3e (segundo relatos) se misturam nas informações; a diferença de preço entre servidores HGX completos e placas PCIe únicas é grande — ao cotar um "servidor H20", pergunte primeiro a versão e o formato.
- Alta volatilidade no mercado de usados : em janeiro de 2025, a onda de compras elevou o preço em cerca de 100 mil yuan/máquina no mês; em abril de 2025, pico repentino durante rumores de corte de suprimento (relatos públicos) — o mercado oscila fortemente com notícias de política; as cotações devem seguir o vendedor em tempo real, veja "faixa de mercado".
Faixa de mercado MARKET DATA
| Data | Critério | Região | Faixa de preço de referência | Observação |
|---|---|---|---|---|
| 2025-02 | Relatos de canal | China continental | Servidor de 8 GPUs: cerca de 1,1 milhão de yuan/unidade (+100 mil ou mais desde o fim do ano anterior) | Segundo a Cailianshe[6] |
| 2025-02 | Relatos de canal | China continental | Preço unitário por GPU: cerca de 110 mil yuan | Segundo a Cailianshe[6] |
| 2025-07 | Expectativa de oferta e demanda | China continental | Retomada de vendas aprovada; participação do H20 no consumo de HBM projetada para subir a 6% em 2025 | TrendForce[3] |
| 2026-10-20 | Showroom desta base | — | Nenhum H20 à venda no momento | Verificação real desta base (modelos da família conferidos por número exato); o snapshot de mercado acumula-se diariamente desde 20/10/2026, exibido automaticamente quando há estoque |
Nota sobre o gráfico: esta base não tem atualmente H20 à venda e os preços-âncora externos são apenas pontos isolados — não traçamos curvas por estimativa (desenhar uma curva com pontos esparsos é inventar dados; sem verificação, não afirmamos); o gráfico de tendência de preços entrará no ar automaticamente após o acúmulo diário de snapshots (mesma prática do verbete H100/H200).
Marcos históricos de preço MILESTONES
Perguntas frequentes FAQ
Veja onde está o gargalo: para inferência e cenários de grande memória (70B em GPU única, R1 completo em oito GPUs), o H20 com 96 GB/4,0 TB/s supera o H100 de 80 GB/3,35 TB/s, além de ter sido um modelo legalmente à venda no continente e fácil de implantar com 400 W; para treinamento, aceleração de fine-tuning e alta densidade computacional, o poder Tensor do H20 é cerca de um décimo do H100 no mesmo critério (segundo a mídia) — vá direto ao H100/H200. Em resumo: o H20 vende memória e acesso ao mercado; o H100/H200 vende poder de processamento.
O H20 é uma variante exclusiva para o mercado chinês, sob a política de controles de exportação dos EUA: lançado em 2024, exigiu licença em abril de 2025, retomado em julho de 2025, e desde então oferta e ambiente de compras oscilam conforme a política (relatos públicos). Em 2026, o estoque disponível é predominantemente da circulação da base instalada inicial, com estagnação da oferta de novos equipamentos. Esta informação não constitui aconselhamento jurídico; o status de conformidade das compras deve seguir as políticas dos órgãos reguladores e opinião especializada.
O que os controles de exportação restringem são os indicadores de computação, não a memória — o H20 manteve 96 GB de HBM3 e 4,0 TB/s de banda (acima dos 80 GB / 3,35 TB/s do H100), cortando o poder Tensor. É, portanto, uma GPU feita para inferência: a inferência de grandes modelos consome memória e banda, não tanto o pico de computação.
A força de entregas de 2024 foi a versão inicial de 96 GB HBM3; a versão atualizada de ~148 GB HBM3e é mencionada em relatos posteriores (alguns citam entre 141 e 148 GB). Externamente as duas versões são idênticas; na inspeção, use o teste real de memória via nvidia-smi e relatórios de firmware, e o contrato de compra deve especificar a versão.
Sim: oito GPUs HGX H20 somam 768 GB (96 GB×8), e os pesos completos em FP8 (~690 GB, estimativa) cabem — exatamente por isso o H20 foi amplamente adotado em all-in-one de inferência DeepSeek no início de 2025 (relatos públicos). Mas atenção: "caber" não significa "rodar rápido": o throughput de geração é afetado pelo corte de computação; confie em testes reais.
Entradas relacionadas SEE ALSO
Comparação e escolha de modelos COMPARE
Referências REFERENCES
- MIT Technology Review China — NVIDIA retoma vendas do H20 na China (96 GB HBM3 / 4,0 TB/s / FP8 296 TFLOPS / FP16 148 TFLOPS / 41% menos núcleos que o H100) https://www.mittrchina.com/news/detail/15016
- Review — relato sobre chip compatível em desenvolvimento pela NVIDIA para a China (12/2023, segunda mão) https://www.reuters.com/technology/
- TrendForce — H20 Export Approval Reignites Demand Momentum (HBM3 8-Hi do lote 2024 / plano de atualização HBM3e / US$ 2,5 bilhões não despachados em 04/2025 / retomada de exportação em 15/07/2025) https://www.trendforce.com/presscenter/news/20250716-12644.h…
- CNBC — Nvidia still hasn't sold its U.S.-approved China AI chips(2026-02-26) https://www.cnbc.com/2026/02/26/nvidia-china-chip-sales-expo…
- MyDrivers/Sina Finance — H200 pode ser vendido, mas HBM3E continua proibido (11/12/2025, evidência da sucessão pelo H200) https://finance.sina.com.cn/tech/discovery/2025-12-12/doc-in…
- Cailianshe — Subiu 100 mil desde o ano anterior! H20 é o "favorito das big techs" (02/2025, servidor de 8 GPUs ~1,1 milhão de yuan, GPU única ~110 mil yuan) https://www.cls.cn/detail/1956679
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (arquivo autoritativo da linha do tempo dos controles de exportação) https://www.congress.gov/crs-product/R48642
- Los Angeles Times — Nvidia's AI chip sales in China stall as local chipmakers like Huawei take lead(2026-06-29) https://www.latimes.com/business/story/2026-06-29/
- Inspur — página do produto AI Server NF5688G7 (YuanNao) (módulo HGX-Hopper-8GPU; fonte da foto do servidor neste verbete) https://www.ieisystem.com/product/ai/15080.html
- H3C — documentação de implantação H20 (registros de reconhecimento em hardware real: NVIDIA-SMI 535.161.08 / CUDA 12.2) https://www.h3c.com
- Tom's Hardware — Nvidia responds to reports that its H20 GPU for China is ending production (relato do B30A aguardando aprovação) https://www.tomshardware.com/tech-industry/artificial-intell…
- Nvidia working on new AI chip for China that outperforms H20(2025-08-19) https://www.reuters.com/technology/nvidia-working-new-ai-chi…
- GPU Database — NVIDIA H20 (9984 CUDA / 60 MB L2 / 400 W, segundo critério) https://www.techpowerup.com/gpu-specs/nvidia-h20.c4184.html
- Dados da faixa de mercado — AIXX Exchange (cotações à venda nesta plataforma e intervalos conhecidos de canal, atualização diária; atualmente 0 unidades de H20 à venda, registrado fielmente) https://www.aixx.vip/hall.html