
H20
概要OVERVIEW
H20(NVIDIA H20)は、NVIDIA が米国の輸出規制政策の要求に応じて中国市場向けに開発した、中国市場向けコンプライアンス特別仕様のデータセンター GPU です:Hopper アーキテクチャ(GH100 派生)、2024 年に上市・出荷し、同じ時期に L20/L2 などの特別仕様モデルも登場しました。2023 年 10 月の規制強化で A800/H800 特別供給ラインが規制対象となった後の後継者です[2][7]。
その設計思想は公開された「交換」にあります:輸出規制が演算性能指標をロックしたため、 H20 は Tensor 演算性能を H100 と同指標の約 10 分の 1 に抑え(メディア報道の数値)、96GB HBM3 の大容量メモリ、4.0TB/s の帯域幅、同世代の NVLink 900GB/s インターコネクトを確保しました——メモリ容量と帯域幅はむしろ H100 を上回ります。推論のために生まれた一枚であり、学習のために生まれたものではありません[1]。
その運命は何度も揺れ動きました:2025 年 1 月の DeepSeek ブームで買い殺到(8 GPU サーバーは一時約 110 万元/台まで高騰、報道ベースの数値[6]);2025 年 4 月に米側が一時ライセンス要求、NVIDIA は約 55 億ドルの引当金計上;2025 年 7 月に承認され販売再開;その後は政策と調達環境の変動を経て、2025 年 12 月に H200 が中国市場向け後継として承認され、H20 は供給の中心から徐々に退きました(報道の総合[4][5])。2026 年の現物市場では、H20 は初期のインストールベースの流通が中心です。
適用シーンFIT
AIXX Index(0–100):当ライブラリは公開スペックに基づく加重推定です——メモリ 40% + インターコネクト 30% + エコシステム 30%、用途に応じて重みを調整。90+ フラッグシップ級 · 75+ 優秀 · 60+ 実用圏 · 60 未満は不向き。算出方法は透明で検証可能ですが、性能の保証ではありません。
沿革HISTORY
2023 年 10 月 17 日、米国の輸出規制が強化され、A800/H800 の中国特別供給がライセンス管理対象に;NVIDIA は新たなコンプライアンス特別仕様の開発へ——メディアは 2023 年 12 月に中国向け新チップの開発を報道(後の H20、同時に L20/L2 も)[2][7]。
2024 年、H20 が上市・出荷(当年の出荷分は主に HBM3 8-Hi 版、TrendForce の数値[3])、HGX H20 8GPU モジュール搭載の完成機がInspur(Inspur)、H3C などのメーカーから市場へ投入;NVIDIA は公式製品ページを設けず、スペックはメディアとサーバーOEMメーカー/システムインテグレーターの資料によります。上市初期は出荷が低迷——演算性能の削減に加え国産代替との競合(報道ベースの数値)。
2025年浮き沈みの激しい一年でした:1〜2 月に DeepSeek ブームで買いが殺到し、8 GPU サーバーは約 100 万元/台から約 110 万元/台へ、大手が推論ワークロード用に大量発注(財聯社報道の数値[6]);4 月に米側が中国向け輸出にライセンスを要求、NVIDIA は約 55 億ドルを計上(うち約 25 億ドル分の H20 が出荷不能[3]);7 月 15 日に販売再開が承認(その後の報道では収益分配の取り決め付き);8 月以降、調達環境は慎重化し、生産終了の噂や後継チップの情報が報じられました[4]。
2025 年末以降:12 月に H200 が中国市場向け後継として承認(HBM3E メモリは依然制限あり、MyDrivers 報道の数値[5]);2026 年、メディアは NVIDIA の中国向け AI チップ実売の停滞と国内メーカー シェア上昇を報道(CNBC 2026-02、LA Times 2026-06[4][8])。H20 の現物市場での役割はインストールベースの流通へ:初期に購入された完成機は引き続き中国国内のデータセンターで稼働・転売されています。本データベースの記述はすべて公開報道の数値であり、法的助言を構成するものではありません。
技術仕様SPECIFICATIONS
数値に関する注記:NVIDIA は H20 の公式製品ページを設けていないため(中国市場向け特別仕様はグローバル製品ラインに未掲載)、下表はメディアとサーバーOEMメーカー/システムインテグレーターの公表数値に基づき、記載が異なる項目は保守的な値を採用;納品時のファームウェア報告と実測を優先します。
| 項目 | スペック(H20 · メディア公表数値) |
|---|---|
| GPU コア | NVIDIA Hopper(GH100 の中国市場向けコンプライアンス特別仕様派生) |
| 単体メモリ | 96GB HBM3(アップグレード版は約148GB HBM3e · 報道の数値) |
| メモリ帯域幅 | 4.0TB/s / GPU(H100 の 3.35TB/s を上回る) |
| FP16 / BF16 Tensor Core | 約 148 TFLOPS(稠密指標;疎行列で約 296) |
| FP8 Tensor Core | 約 296 TFLOPS(メディアの数値) |
| FP32 | 約 44 TFLOPS(メディアの数値) |
| GPU間インターコネクト | NVLink 第四世代 · 900GB/s(HGX H20 8GPU モジュールの数値) |
| ホストインターコネクト | PCIe Gen5 x16 |
| ボード消費電力(TBP/TGP) | 約 400W TDP(メディアの主流数値;一部販売ページでは 350W 表記) |
| CUDA コア規模 | H100 より約 41% 少ない(メディアの数値) |
| 主流のサーバー形態 | HGX H20 8GPU ベースボード完成機(Inspur / H3C / Supermicro など)· PCIe 単体カード |
| ドライバー / CUDA | 535 系ドライバー以降(H3C 公式ドキュメントの実機認識記録:NVIDIA-SMI 535.161.08 / CUDA 12.2) |
| 前世代 / 対抗製品 | A800 / H800(規制対象済み)/ H100、H200 |
スペックはメディアの公開資料のクロスチェックに準拠[1];Tensor 演算性能の数値は納品時のファームウェア報告と実測で再確認を。出荷時データに公式ページの裏付けがないことが、H20 特有の選定リスクです(「制約と論争」参照)。
世代対比 · 同世代 3 枚の違いGENERATIONS
| 項目 | H100 80GB | H20 96GB | H200 141GB |
|---|---|---|---|
| 単体メモリ | 80GB HBM3 | 96GB HBM3 | 141GB HBM3e |
| メモリ帯域幅 | 3.35TB/s | 4.0TB/s | 4.8TB/s |
| FP16/BF16 Tensor(疎行列) | 1,979 TFLOPS | 約 296 TFLOPS(メディアの数値) | 1,979 TFLOPS |
| FP8 Tensor(疎行列) | 3,958 TFLOPS | 約 296 TFLOPS(メディアの数値) | 3,958 TFLOPS |
| GPU間インターコネクト | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s |
| ボード消費電力(TBP/TGP) | 最大 700W | 約 400W | 最大 700W |
| 中国向けチャネル | 公開販売未承認 | コンプライアンス特別仕様 · 政策の変動(中立的数値) | 2025-12 中国向け承認 |
| 選定を一言で | フル性能 · 最大のエコシステム | 演算性能を削って市場参入を確保 · 大容量メモリ推論 | メモリ倍増 · 販売の主力 |
H100/H200 は公式ページ数値、H20 はメディア公表数値で記載;中国向けチャネルの状況は公開報道の数値で政策により変動し、法的助言を構成しません。
ファミリー構成FAMILY
H20 ファミリーはパッケージとメモリバージョンで 4 系統に分かれ、現物市場では HGX 8GPU 完成機と PCIe 単体カードが主力:
冷却と導入COOLING
H20 は Hopper ファミリーの中で最も導入しやすい世代です:約 400W のボード消費電力(TBP/TGP)(メディアの数値)は H100/H200(700W 級)の 6 割程度、HGX 8GPU 完成機は成熟した空冷タワー構成、PCIe 単体カードは 2 スロット空冷で挿すだけで使えます——既設機房は液冷改修なしでラックに搭載可能で、これが 2025 年初頭に大規模モデル オールインワン機ラインに選ばれた理由の一つです(報道ベースの数値)。
モデル対応MODEL FIT
| モデル / シナリオ | メモリ必要量(FP8 概算) | H20 導入(8GPU 768GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 フルスペック(671B) | 約 690GB | 8 枚で収まる——96GB×8=768GB、2025 年初頭の DeepSeek フル推論オールインワン機の主力構成の一つ(報道ベースの数値);余裕はやや厳しく、KV cache は精緻な設計が必要 | 78 |
| R1-Distill 70B クラス | 約 70GB | 単体 96GB で余裕十分、H100(80GB でぎりぎり)より楽 | 88 |
| 72B クラスオープンソースモデル | 約 72GB | 単体で導入可能、長コンテキストでは KV cache の余裕を確保 | 85 |
| 7B-14B クラス(動画生成の小型モデル含む) | 約 8-30GB | 単体なら楽、量産ラインは複数 GPU で同時実行数を積む | 90 |
メモリは FP8 重み ≈ パラメータ数 × 1 バイトで概算(推計の数値、KV cache と活性化の余裕は未含む);「収まる」はメモリ容量の次元であり、生成速度は演算性能削減の影響を受けます(Tensor 演算性能は H100 同指標の約 10 分の 1、メディアの数値)——スループットは実測を優先。AIXX Index は本データベースの推計数値です。
ギャラリーGALLERY
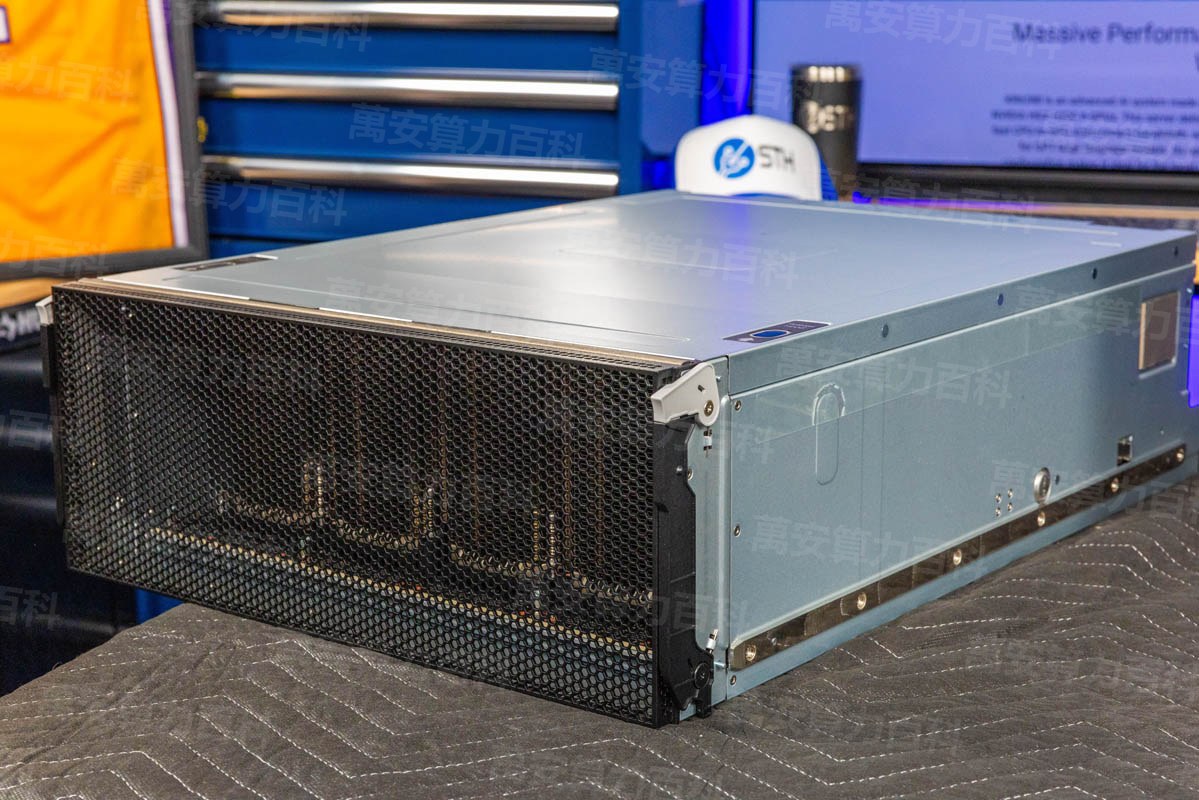
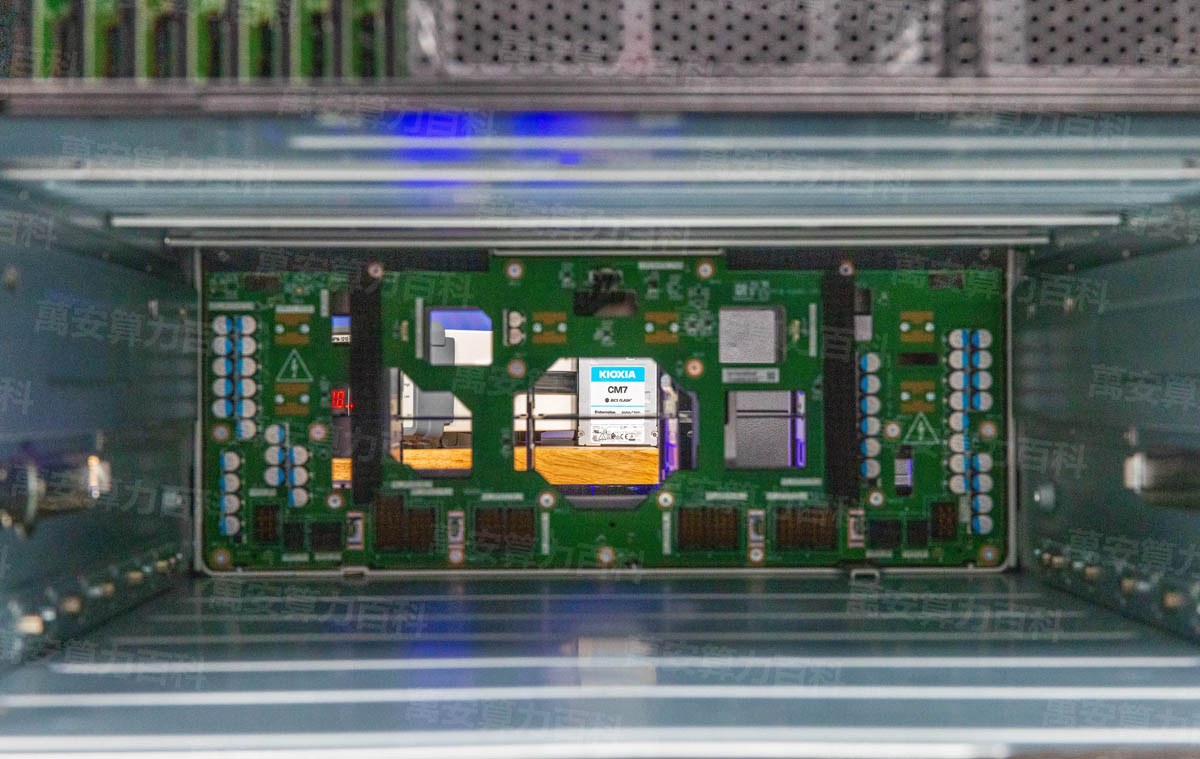
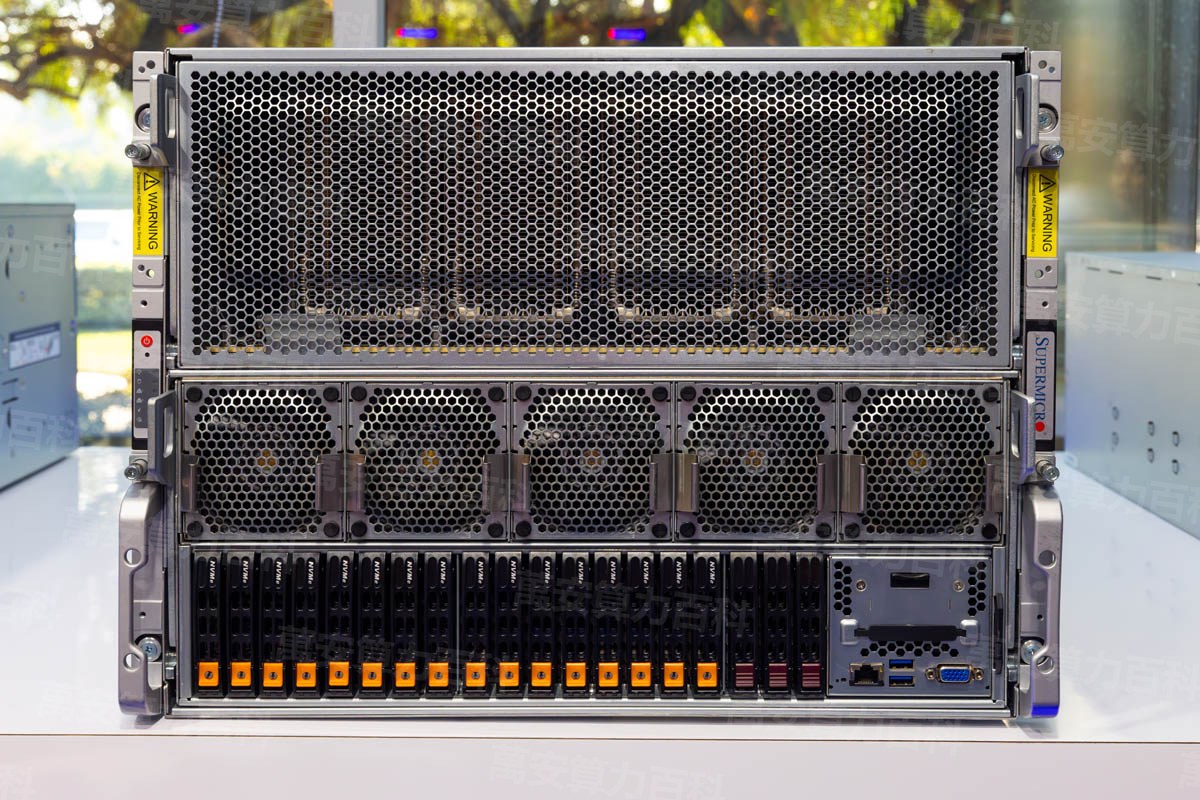
注記:H20 は中国市場向け特別仕様モデルで、NVIDIA の公式製品ページはなく、海外の有力ハードウェアメディアにも実写レビューがないため、本項目では当面サーバーOEMメーカー/システムインテグレーターの画像を開架します;実写画像は本データベースの検品ロットに合わせて順次追加予定(本データベースの検品実写が最優先の画像ソース)。AI 生成画像は実写と偽りません;H100/H200 と H20 は外観ともに Hopper 系で、写真を識別の根拠にすることはできません(「調達と検品」参照)。
動画解説VIDEO
コミュニティ実機 · 出典 BilibiliCOMMUNITY
コミュニティ実機コンテンツの出典は Bilibili クリエイター(クリックで Bilibili 公式プレイヤーを読み込み、サイト内で直接視聴可能)、著作権は元 UP 主に帰属します。本動画は H20 専用の判定事例(数値はすべて H20 実機に基づく:96GB / 4.0TB/s / 400W / HGX NVLink 900GB/s · 単体 PCIe の数値は実際どおり記載)、ナレーションとシーンテキストのアーカイブはリポジトリ _wiki_work_1006/gen_tts_benchh20.py を参照。
コミュニティ実機 · 出典 YouTubeCOMMUNITY HANDS-ON
地域によっては直接再生できない場合があります
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| CUDA / ドライバー | 535 系ドライバー以降(H3C 公式導入ドキュメントの実機記録:NVIDIA-SMI 535.161.08 / CUDA 12.2 が H20 を認識) |
| 学習フレームワーク | PyTorch / TensorFlow は Hopper を公式サポート;H20 は演算性能が制限され、学習用途は小規模ファインチューニングが中心 |
| 推論エンジン | vLLM / SGLang / TensorRT-LLM すべてネイティブサポート;大容量メモリ + 高帯域幅が推論スループットの土台 |
| ネットワーク構成 | ConnectX-7 400G または同等のインターコネクト方案(サーバーOEMメーカー/システムインテグレーター標準搭載の数値) |
| OS | 主要Linuxディストリビューション(Ubuntu 22.04+ など) |
H20 は H100/H200 と同じ Hopper エコシステムに属し、ソフトウェアスタックは完全に共通——「エコシステムの縮小」は存在せず、「演算性能の縮小」が存在します。ソフトウェアスタックのバージョンは時期により変動し、NVIDIA 公式リリースを優先します。
調達と検品PROCUREMENT
H20 調達の検品ポイント(3 項目):
6 項目の完全なストレステスト判定(数値は H20 実機に基づく)は本項目を参照「ストレステストの方法」節を参照。
ストレステストの方法BENCH TEST
6 項目のストレステスト数値はすべて H20 実機に基づく:開梱識別 → 単体焼き込みテスト(400W 級空冷タワー、85℃ 以下かつ ECC エラー零で合格)→ 全機フルロード → メモリ帯域幅(公称 4.0TB/s、85% 以上で合格)→ インターコネクト(HGX 機体は nccl-tests で 750GB/s 以上 / PCIe 単体カードは Gen5 x16 満リンクを確認)→ 推論スループット(公開ベースマークの 80% 以上)。
nvidia-smigpu-burn 3600 または dcgmi diag -r 3 · 30〜60分bandwidthTest(CUDA同梱サンプル)nccl-tests all_reduce ベンチマークvLLM 実モデルを起動して負荷計測基準の説明:合格/優秀ラインは当ライブラリが技術上の一般的基準に基づき整理したもの(帯域は公称値に対する比率、温度はデータセンターの一般的上限)。検品報告書の実測データの蓄積に応じて段階的に校正する。本表はいかなる検収の約束を構成するものではなく、詳細は契約の取り決めによる。当ライブラリの検品報告書の実測項目は本表の基準に従って記録される——NOT_EXECUTED は未実施を意味し、「未測定」そのものも重要な情報である。
輸送と納品LOGISTICS
OEM とバリエーションVENDORS
同じ HGX H20 ベースボードでも、各社の完成品はフォームファクタ・冷却・サービスで差がつきます——選定はまず違いの確認から。
| 一体機メーカー | 代表形態 | 差別化ポイント | 向いているケース |
|---|---|---|---|
| Inspur | 元脳 NF5688G7 など(HGX Hopper 8 GPU モジュール) | 国産 AI サーバーのシェア首位、一体型マシンの生産ラインが成熟[9] | 国内デプロイ · 一体型生産ライン |
| 新华三 | UniServer シリーズ(HGX H20 8 GPU) | 公式デプロイドキュメントが完備(H20 実機認識記録を公開)、サービス網が地方まで届く[10] | エンタープライズ顧客 · ドキュメントとサービス重視 |
| Supermicro | HGX H20 8 GPU 完整机(中国地域チャネル) | 量産型 OEM、グローバルサプライチェーンの背景(公開報道ベース) | コスパ重視 · 大量調達 |
| PCIe 単体カードのインテグレーター | 4U/2U 8×PCIe H20 タワー/ラック型 | NVLink フルインターコネクトなし、低コスト、推論主体の用途に適合 | 推論パイプライン · 予算優先 |
AIXX Index · デプロイ四軸比較AIXX INDEX
| 一体機メーカー | 導入の容易さ | 保守のしやすさ | 性能密度 | 寿命見込み |
|---|---|---|---|---|
| Inspur | 88 | 86 | 82 | 80 |
| 新华三 | 86 | 88 | 81 | 82 |
| Supermicro | 84 | 80 | 84 | 80 |
| PCIe 単体カードのインテグレーター | 90 | 82 | 68 | 78 |
AIXX Index は本ライブラリの推定値(0–100、推定根拠=公開されているフォームファクタ・冷却方式・サービス網の差異)で、実機検証に伴い更新されます。調達の約束を構成するものではありません。具体的な型番はメーカー公式発表に依拠します。
用語カードGLOSSARY
中国市場向けコンプライアンス特別仕様
米国輸出規制政策の要件のもと、ライセンス閾値に合わせて性能を削り、中国大陸市場へ合法的に投入されるモデル。H20 は Hopper 世代の特別仕様ライン(先行例は A800/H800)。交換論理:メモリ容量・帯域・インターコネクトは確保し、Tensor 演算性能を削減。本データベースの記述はすべて公開報道ベースであり、法的助言を構成しません。
96GB HBM3 · 4.0TB/s
H20 の存在意義:シングル GPU のメモリ容量と帯域が H100(80GB / 3.35TB/s)を上回る——輸出規制でロックされているのは演算性能指標であり、メモリではない。これは「特別仕様なのにある項目で上位」という珍しいケース。
NVLink 4 · 900GB/s
第四世代 NVLink、HGX H20 8 GPU モジュールは H100/H200 と同世代・同速度。PCIe 単体カードには NVLink なし——マルチ GPU クラスタの要件があるなら、まずフォームファクタの確認を。
HGX H20 8 GPU モジュール
8 個の H20 をベースボードに搭載し NVSwitch でフルインターコネクト、合計 768GB のメモリ——DeepSeek R1 フル FP8(約 690GB)が 1 台で収まる。これが 2025 年初頭に買い殺された実質的な理由(推定ベース + 公開報道ベース)。
ライセンス管理 / 承認による回復
2025 年 4 月に米国側が H20 の対中輸出にライセンスを要求(NVIDIA は約 55 億ドルを引当計上)、2025 年 7 月 15 日に承認・回復、以降は供給・調達環境が政策に応じて揺れ動く。ロットとライセンス状態は保証と資産価値に影響するため、検品時には必ず確認を。法的助言ではありません。
限界と論点LIMITS
- 演算性能の削減が最大の弱点(ありのままに):FP16/FP8 Tensor 演算性能は H100/H200 の同基準のおよそ 10 分の 1(メディア開示ベース[1])——これが「コンプライアンスと引き換えに中国市場参入を得る」交換論理:推論には影響せず、トレーニングや高演算密度の用途には全く不向き。トレーニングカードとして購入するのが最大の選定ミス。
- 仕様に公式ページの裏付けなし:NVIDIA は H20 の公式製品ページを開設しておらず、ネット上のスペック情報は混乱(INT8/スパarsity基準が不統一、NVLink 300GB/s という誤情報あり)——本項目はすべてメディア開示ベースを明記し、検品はファームウェアレポートと実測による。
- 製品ライフサイクルが不確定:2025 年 8 月以降、生産終了のうわさと後継チップ(B30A など)の報道が交互に登場し、後継の承認も未決(公開報道ベース[4])——長期の予備部品・ドライバサポート・資産価値の見通しには不確実性があり、本データベースは断定しない。
- 中国大陸の調達環境が反復:2025 年 8 月以降の規制当局の慎重姿勢とセキュリティ审查の報道、2025 年 12 月の H200 承認によるバトンタッチ——H20 の中国大陸での正規調達経路は政策の展開に伴い変動(中立的表現、公開報道ベース、法的助言ではない)。
- バージョン基準の落とし穴:96GB HBM3 初期版と約148GB HBM3e アップグレード版(報道ベース)が混在報道。HGX 完整机と PCIe 単体カードで価格差が大きい——「H20 サーバー」の見積もりでは、まずバージョンとフォームファクタの確認が必須。
- 中古価格の高 volatility:2025 年 1 月の買い殺しで月内約 10 万元/台上昇、2025 年 4 月の供給途絶うわさ期に短期的急騰(公開報道ベース)——相場は政策ニュースに伴い激しく変動。価格はリアルタイムの出品者提示によります。「相場帯」参照。
相場帯MARKET DATA
| 日付 | 基準 | 地域 | 参考価格帯 | 備考 |
|---|---|---|---|---|
| 2025-02 | チャネル報道 | 中国本土 | 8 GPU 完整机 約 110 万元/台(年初より +10 万元以上) | 財聯社報道ベース[6] |
| 2025-02 | チャネル報道 | 中国本土 | 単体カード単価 約 11 万元/GPU | 財聯社報道ベース[6] |
| 2025-07 | 需給見通し | 中国本土 | 販売再開が承認、2025 年通年の HBM 消費シェアは 6% へ上昇見込み | TrendForce[3] |
| 2026-10-20 | 本データベースホール | — | 現在 H20 の出品なし | 本データベース実査(ファミリー基準は精密型番で照合済み)。相場スナップショットは 2026-10-20 以降、日々蓄積、在庫ありの場合は自動表示 |
グラフ基準:本データベースは現在 H20 の出品がなく、外部アンカー価格も散発的な時点のみ——推定帯は作らない(散在する時点で曲線を描くのはデータの捏造であり、検証されていないものは語らない)。相場スナップショットが日々蓄積された後、価格トレンドチャートは自動で公開(H100/H200 項目と同様の方式)。
価格イベント年表MILESTONES
よくある質問FAQ
ボトルネックがどこかで判断:推論と大容量メモリの用途(70B 級シングル GPU、R1 フル 8 GPU)では、H20 の 96GB/4.0TB/s は H100 の 80GB/3.35TB/s を上回り、かつ中国大陸でコンプライアンス販売された実績があり、400W でデプロイしやすい。トレーニング、ファインチューニングの高速化、高演算密度の用途では、H20 の Tensor 演算性能は H100 同基準の約 10 分の 1(メディアベース)なので、H100/H200 を直接検討を。ひとことで:H20 が売っているのはメモリと参入資格、H100/H200 が売っているのは演算性能。
H20 は米国輸出規制政策の要件による中国市場向けコンプライアンス特別仕様モデル:2024 年発売、2025 年 4 月に一時ライセンス要求、7 月に承認・回復、以降は供給・調達環境が政策に応じて揺れ動く(公開報道ベース)。2026 年の現物は主に初期のインストールベースの流通で、新機の供給は停滞。本項は法的助言ではなく、調達のコンプライアンス状態は主管当局の政策と専門意見による。
輸出規制でロックされているのは演算性能指標でありメモリではない——H20 は 96GB HBM3 と 4.0TB/s の帯域(H100 の 80GB / 3.35TB/s を上回る)を確保し、削られたのは Tensor 演算性能。だからこそ推論のために生まれたカード:大規模モデルの推論はメモリと帯域を食うが、ピーク演算性能はさほど食わない。
2024 年出荷の主力は 96GB HBM3 初期版。約148GB HBM3e アップグレード版は後続の報道ベース(一部報道では 141-148GB と幅あり)。両版は外観上の違いがなく、検品は nvidia-smi によるメモリ実測とファームウェアレポートで、見積もり契約には必ずバージョンを明記すること。
可能:8 GPU の HGX H20 は合計 768GB(96GB×8)で、FP8 フルの重み約 690GB(推定ベース)が収まる——これこそ 2025 年初頭に DeepSeek 推論一体型マシンが H20 を大量採用した理由(公開報道ベース)。ただし「収まる」は「速い」を意味しない:生成スループットは演算性能削減の影響を受けるため、実測によること。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- MIT Technology Review 中国 — NVIDIA が H20 の中国販売を回復(96GB HBM3 / 4.0TB/s / FP8 296 TFLOPS / FP16 148 TFLOPS / コア数は H100 比 41% 少ない) https://www.mittrchina.com/news/detail/15016
- 社 — NVIDIA の中国向けコンプライアンスチップ開発報道(2023-12、転述ベース) https://www.reuters.com/technology/
- TrendForce — H20 Export Approval Reignites Demand Momentum(2024 ロット HBM3 8-Hi / HBM3e アップグレード計画 / 2025-04 約 25 億ドルが出荷不能 / 2025-07-15 輸出回復) https://www.trendforce.com/presscenter/news/20250716-12644.h…
- CNBC — Nvidia still hasn't sold its U.S.-approved China AI chips(2026-02-26) https://www.cnbc.com/2026/02/26/nvidia-china-chip-sales-expo…
- 快科技/新浪財経 — H200 は販売可能だが HBM3E は依然禁止(2025-12-11、H200 バトンタッチの裏付け) https://finance.sina.com.cn/tech/discovery/2025-12-12/doc-in…
- 財聯社 — 年初より 10 万元高!H20 は「大手の最愛」に(2025-02、8 GPU 機 約 110 万元/台、単体カード 約 11 万元) https://www.cls.cn/detail/1956679
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors(輸出規制のタイムラインの権威あるアーカイブ) https://www.congress.gov/crs-product/R48642
- Los Angeles Times — Nvidia's AI chip sales in China stall as local chipmakers like Huawei take lead(2026-06-29) https://www.latimes.com/business/story/2026-06-29/
- Inspur — 元脳 NF5688G7 AI サーバー製品ページ(HGX-Hopper-8GPU モジュール。本項目の完整机画像の出典) https://www.ieisystem.com/product/ai/15080.html
- 新华三 — H20 デプロイドキュメント(NVIDIA-SMI 535.161.08 / CUDA 12.2 の実機認識記録) https://www.h3c.com
- Tom's Hardware — Nvidia responds to reports that its H20 GPU for China is ending production(B30A 承認待ちの報道) https://www.tomshardware.com/tech-industry/artificial-intell…
- Nvidia working on new AI chip for China that outperforms H20(2025-08-19) https://www.reuters.com/technology/nvidia-working-new-ai-chi…
- GPU Database — NVIDIA H20(9984 CUDA / 60MB L2 / 400W ベース) https://www.techpowerup.com/gpu-specs/nvidia-h20.c4184.html
- 相場帯データ — AIXX AIXX Exchange(本プラットフォームの出品報価とチャネル把握の区間、毎日更新。H20 現在 0 出品をありのまま記録) https://www.aixx.vip/hall.html