AIXX Pedia › Fiche modèle › H20

H20
Vue d'ensemble OVERVIEW
H20 (NVIDIA H20) est un GPU data center variante réservée au marché chinois, développé par NVIDIA pour le marché chinois dans le cadre des restrictions d'exportation américaines : architecture Hopper (dérivée du GH100), commercialisé en 2024 , aux côtés des variantes L20/L2 de la même vague. Il a pris la relève de la ligne spéciale A800/H800, soumise aux contrôles lors du durcissement d'octobre 2023[2][7]。
Sa logique de conception relève d'un échange assumé : les contrôles à l'export plafonnant les indicateurs de puissance de calcul, le H20 voit sa puissance Tensor ramenée à environ un dixième de celle du H100 à périmètre comparable (selon la presse), mais conserve ses 96 Go de HBM3, une bande passante de 4,0 To/s et l'interconnexion NVLink 900 Go/s de la génération — mémoire et bande passante supérieures au H100. C'est une carte née pour l'inférence, pas pour l'entraînement.[1]。
Un destin mouvementé : janvier 2025 : la vague DeepSeek déclenche une ruée sur les stocks (les serveurs 8 GPU ont brièvement grimpé à environ 1,1 million de yuans l'unité, selon les médias[6]) ; avril 2025 : Washington exige brièvement une licence, NVIDIA passe une provision d'environ 5,5 milliards de dollars ; juillet 2025 : approbation et reprise des ventes ; ensuite, au gré des revirements politiques et d'achat, décembre 2025 : le H200 est approuvé pour la Chine et prend le relais, le H20 quittant progressivement le devant de la scène (synthèse de la presse publique[4][5]). Sur le marché de l'occasion en 2026, le H20 circule essentiellement via le parc installé des premières vagues.
Cas d'usage FIT
AIXX Index (0–100) : estimé par pondération des spécifications publiques — mémoire 40 % + interconnexion 30 % + écosystème 30 %, pondérations ajustées par scénario. 90+ niveau flagship · 75+ Excellent · 60+ utilisable · en dessous de 60, non recommandé. Méthode transparente et vérifiable, sans garantie de performance.
Historique HISTORY
Le 17 octobre 2023 , durcissement des contrôles à l'exportation américains : A800/H800, variantes pour la Chine, passent sous licence ; NVIDIA se tourne vers une nouvelle génération de variantes conformes — la presse rapporte en décembre 2023 le développement de nouvelles puces pour la Chine (baptisées ensuite H20, avec L20/L2)[2][7]。
2024 , le H20 arrive sur le marché (les livraisons de l'année portent surtout sur la version HBM3 8-Hi, selon TrendForce[3]) ; les systèmes complets dotés du module HGX H20 8 GPU sont lancés par Inspur, H3C et autres ; NVIDIA n'a pas ouvert de page produit officielle, les spécifications s'appuient sur la presse et les documentations des intégrateurs. Le démarrage commercial est décevant — puissance réduite et concurrence des alternatives nationales (selon la presse).
2025 L'année des montagnes russes : en janvier-février, la vague DeepSeek déclenche une ruée, les serveurs 8 GPU passent d'environ 1 à 1,1 million de yuans, commandes massives pour des charges d'inférence chez les grands acteurs (selon Cailianshe[6]) ; en avril, Washington impose une licence pour l'export vers la Chine, NVIDIA passe une provision d'environ 5,5 milliards de dollars (dont environ 2,5 milliards liés au H20 invendable[3]) ; le 15 juillet, approbation et reprise des ventes (les médias évoquent ensuite un accord de partage de revenus) ; à partir d'août, prudence sur les achats, rumeurs de fin de production et révélations sur la puce successeur[4]。
Fin 2025 à aujourd'hui : en décembre, le H200 est approuvé pour la Chine (mémoire HBM3E toujours bridée, selon MyDrivers[5]) ; en 2026, la presse rapporte un arrêt quasi total des ventes de puces IA de NVIDIA en Chine et la montée des acteurs locaux (CNBC 02/2026, Los Angeles Times 06/2026[4][8]). Sur le marché, le H20 devient un produit de circulation du parc installé : les systèmes achetés tôt servent encore et se revendent dans les data centers chinois. Toutes les mentions de cette fiche s'appuient sur des sources publiques et ne constituent pas un avis juridique.
Spécifications techniques SPECIFICATIONS
Avertissement de périmètre : NVIDIA n'ayant pas de page produit officielle pour le H20 (variante pour la Chine absente du catalogue mondial), le tableau ci-dessous reflète les informations de la presse et des intégrateurs ; en cas de divergences, la valeur prudente a été retenue ; se référer aux rapports de firmware et aux tests réels à réception.
| Élément | Spécifications (H20 · selon la presse) |
|---|---|
| Cœur GPU | NVIDIA Hopper (dérivé GH100 variante de conformité pour la Chine) |
| Mémoire par carte | 96 Go HBM3 (version évoluée environ 148 Go HBM3e · selon la presse) |
| Bande passante mémoire | 4,0 To/s par carte (contre 3,35 To/s pour le H100) |
| FP16 / BF16 Tensor Core | environ 148 TFLOPS (dense ; environ 296 en sparse) |
| FP8 Tensor Core | environ 296 TFLOPS (selon la presse) |
| FP32 | environ 44 TFLOPS (selon la presse) |
| Interconnexion GPU-GPU | NVLink quatrième génération · 900 Go/s (périmètre module HGX H20 8 GPU) |
| Interconnexion hôte | PCIe Gen5 x16 |
| Consommation de la carte (TBP/TGP) | environ 400 W TDP (consensus presse ; certaines pages indiquent 350 W) |
| Nombre de cœurs CUDA | environ 41 % de moins que le H100 (selon la presse) |
| Format système dominant | Systèmes HGX H20 8 GPU (Inspur / H3C / Supermicro, etc.) · carte PCIe simple |
| Pilotes / CUDA | à partir des pilotes de la série 535 (relevé réel de la documentation officielle H3C : NVIDIA-SMI 535.161.08 / CUDA 12.2) |
| Génération précédente / concurrent direct | A800 / H800 (soumis aux contrôles) / H100, H200 |
Spécifications à recouper via les sources publiques[1]; la puissance Tensor doit être vérifiée par rapport aux rapports de firmware et aux tests réels : l'absence de page officielle est un risque d'achat propre au H20 (voir « Limites et controverses »).
Comparaison générationnelle · qui fait quoi parmi les trois cartes de la génération GENERATIONS
| Élément | H100 80GB | H20 96GB | H200 141GB |
|---|---|---|---|
| Mémoire par carte | 80GB HBM3 | 96GB HBM3 | 141GB HBM3e |
| Bande passante mémoire | 3.35TB/s | 4.0TB/s | 4.8TB/s |
| Tensor FP16/BF16 (sparse) | 1,979 TFLOPS | environ 296 TFLOPS (selon la presse) | 1,979 TFLOPS |
| Tensor FP8 (sparse) | 3,958 TFLOPS | environ 296 TFLOPS (selon la presse) | 3,958 TFLOPS |
| Interconnexion GPU-GPU | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s |
| Consommation de la carte (TBP/TGP) | jusqu'à 700 W | environ 400 W | jusqu'à 700 W |
| Canal Chine | vente publique non approuvée | variante de conformité · revirements politiques (périmètre neutre) | approuvé pour la Chine en 12/2025 |
| Recommandation en une phrase | pleine puissance · écosystème le plus large | puissance sacrifiée contre l'accès marché · inférence à grande mémoire | mémoire doublée · cheval de bataille en volume |
Les colonnes H100/H200 suivent le périmètre officiel, le H20 le périmètre presse ; le statut du canal Chine repose sur la presse publique et évolue avec la politique, sans valeur d'avis juridique.
Membres de la famille FAMILY
La famille H20 se décline en quatre variantes selon le packaging et la version de mémoire ; le marché de l'occasion est dominé par les systèmes HGX 8 GPU et les cartes PCIe :
Refroidissement et déploiement COOLING
Le H20 est la déclinaison Hopper la plus facile à déployer : avec environ 400 W par carte (selon la presse), soit 60 % du H100/H200 (700 W), le système HGX 8 GPU est une solution tour refroidie par air éprouvée, et la carte PCIe double slot s'installe en plug-and-play — les salles existantes se passent de conversion au refroidi par liquide. C'est l'une des raisons de son adoption par les lignes d'appliances grands modèles début 2025 (selon la presse).
Compatibilité des modèles MODEL FIT
| Modèle / scénario | Besoin mémoire (estimation FP8) | Déploiement H20 (8 cartes, 768 Go) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 complet (671B) | environ 690GB | Ça tient en 8 cartes — 96 Go × 8 = 768 Go, l'une des configurations phares des appliances DeepSeek complètes début 2025 (selon la presse) ; la marge est serrée, le KV cache doit être calibré avec soin | 78 |
| R1-Distill classe 70B | environ 70GB | 96 Go par carte, marge confortable, plus serein que le H100 (80 Go limite) | 88 |
| Modèles open source classe 72B | environ 72GB | déployable en carte simple, contexte long : garder de la marge pour le KV cache | 85 |
| Niveau 7B-14B (petits modèles de génération vidéo inclus) | Environ 8-30GB | aisé en carte simple, le volume passe par le multigpu en production | 90 |
Mémoire estimée en poids FP8 ≈ paramètres × 1 octet (estimation, hors KV cache et marge d'activation) ; « ça tient » s'entend en capacité mémoire ; la vitesse de génération reste pénalisée par la puissance réduite (Tensor ≈ un dixième du H100, selon la presse) — se référer aux débits mesurés. L'AIXX Index suit les estimations de cette base.
Galerie GALLERY
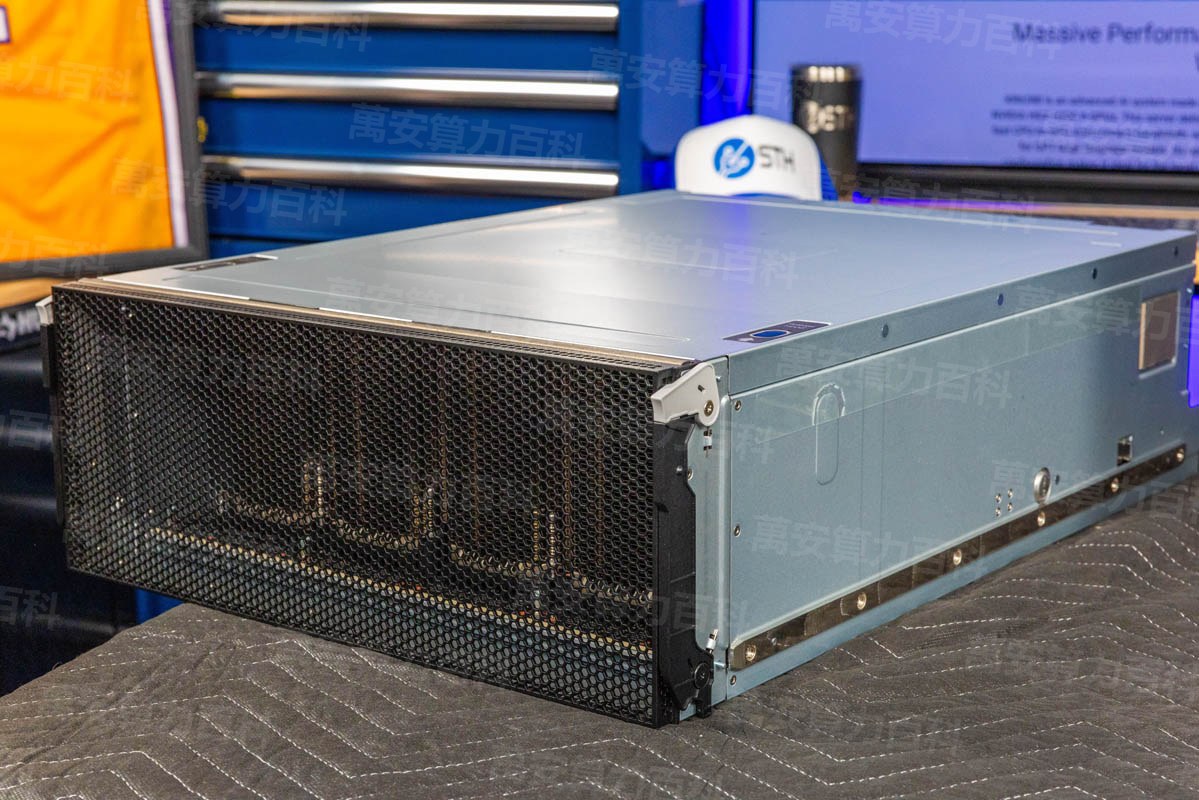
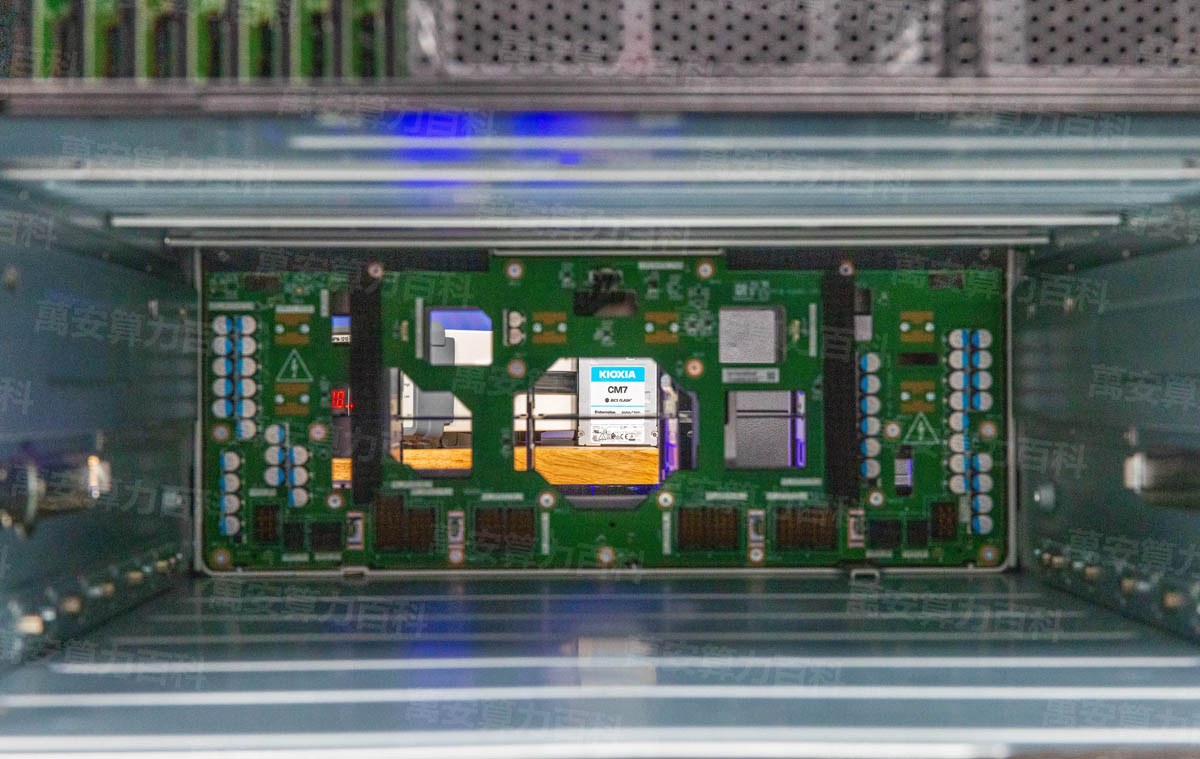
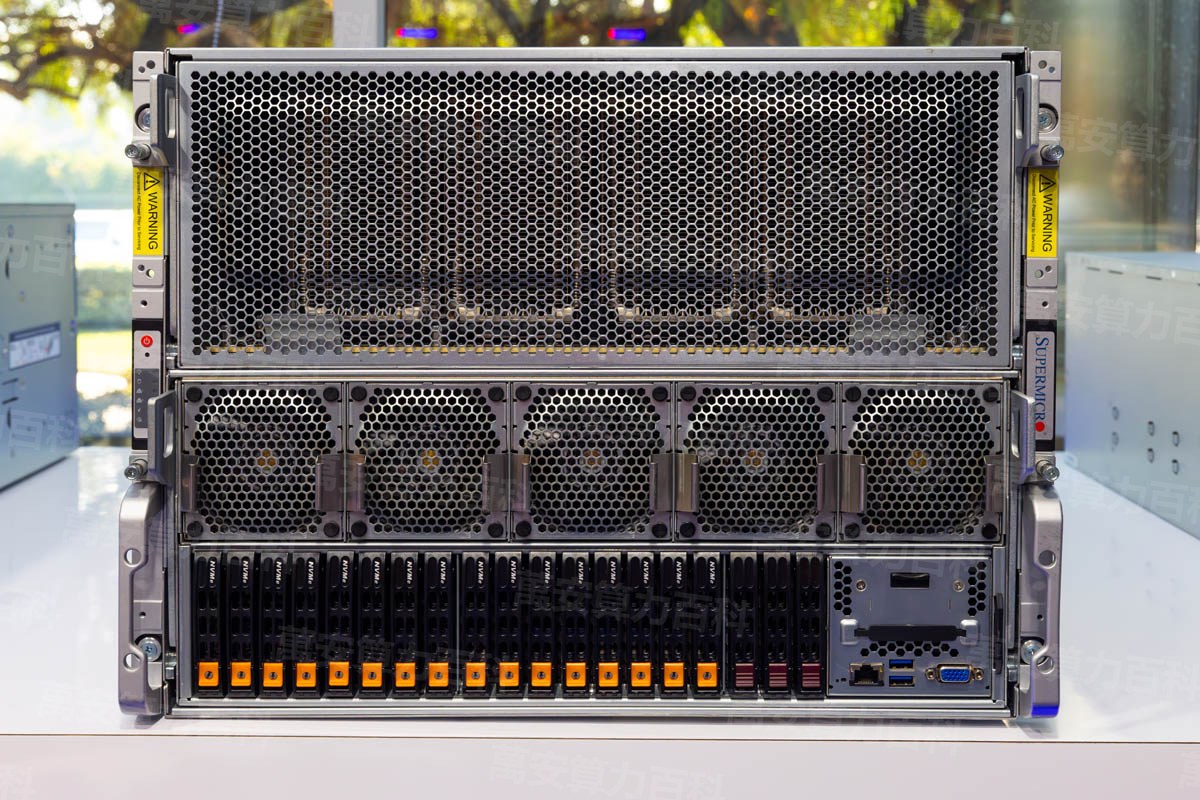
Note : le H20 étant une variante réservée au marché chinois, sans page produit officielle chez NVIDIA ni test photo sur les grands médias matériels étrangers, cette fiche s'appuie pour l'instant sur les photos constructeurs ; les photos réelles seront enrichies au fil des lots vérifiés par cette base (les photos de réception de cette base constituent la source prioritaire). Aucune image générée par IA ne se fait passer pour une photo réelle ; H100/H200 et H20 partagent le même look Hopper : une photo ne suffit pas à identifier une carte (voir « Achat et réception »).
Présentation vidéo VIDEO
Retours terrain · source Bilibili COMMUNITY
Contenus terrain de créateurs Bilibili (le lecteur officiel Bilibili se charge au clic, lecture directe sur place), droits réservés aux auteurs d'origine. Cette vidéo est un verdict propre au H20 (chiffres tous ancrés sur le H20 : 96 Go / 4,0 To/s / 400 W / NVLink HGX 900 Go/s · périmètre PCIe carte simple indiqué tel quel), scripts et textes archivés dans _wiki_work_1006/gen_tts_benchh20.py.
Machine réelle de la communauté · Source YouTube COMMUNITY HANDS-ON
La lecture directe peut être indisponible dans certaines régions
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| CUDA / pilotes | à partir des pilotes série 535 (relevé réel du déploiement officiel H3C : NVIDIA-SMI 535.161.08 / CUDA 12.2 détecte le H20) |
| Frameworks d'entraînement | PyTorch / TensorFlow supportent officiellement Hopper ; puissance bridée sur le H20, l'entraînement reste limité au fine-tuning à petite échelle |
| Moteurs d'inférence | vLLM / SGLang / TensorRT-LLM tous nativement supportés ; grande mémoire + haute bande passante, socle du débit d'inférence |
| Infrastructure réseau | ConnectX-7 400G ou solution d'interconnexion équivalente (standard constructeur) |
| Système d'exploitation | Distributions Linux courantes (Ubuntu 22.04+, etc.) |
Le H20 appartient comme le H100/H200 à l'écosystème Hopper, pile logicielle 100 % partagée — pas de « rétrécissement d'écosystème », mais bien un « rétrécissement de puissance ». Les versions logicielles évoluent, se référer aux publications officielles NVIDIA.
Achat et réception PROCUREMENT
Points de contrôle à la réception d'un H20 (trois) :
Les six verdicts complets de stress tests (chiffres ancrés sur le H20) figurent dans cette fiche « Comment tester en charge » de cette entrée.
Comment effectuer un stress test BENCH TEST
Protocole des six stress tests, tous les verdicts ancrés sur le H20 : identification au déballage → test de burn-in carte simple (tour refroidi par air 400 W, ≤85 °C sans ECC = conforme) → pleine charge machine complète → bande passante mémoire (nominal 4,0 To/s, conforme si ≥85 %) → interconnexion (nccl-tests ≥750 Go/s en groupe HGX / carte PCIe : vérifier Gen5 x16 pleine liaison) → débit d'inférence (≥80 % des bases publiques).
nvidia-smigpu-burn 3600 ou dcgmi diag -r 3 · 30–60 minutesbandwidthTest(échantillons fournis avec CUDA)nccl-tests Benchmark all_reducevLLM Faire tourner un vrai modèle en chargeNote de méthodologie : les seuils Conforme/Excellent ont été établis par cette base selon les usages courants de l'ingénierie (bande passante en pourcentage du nominal, température selon les limites usuelles en datacenter) et seront recalibrés progressivement à mesure que s'accumulent les données réelles des rapports d'inspection ; ce tableau ne constitue aucun engagement de réception, les termes du contrat prévalent. Les mesures des rapports d'inspection de cette base sont enregistrées selon cette méthodologie — NOT_EXECUTED signifie que le test n'a pas été effectué, et « non testé » est en soi une information importante.
Transport et livraison LOGISTICS
OEM et variantes VENDORS
Pour une même base HGX H20, les systèmes complets des différents fabricants se distinguent par leur forme, leur refroidissement et leurs services — voici les différences à examiner en priorité lors du choix :
| Intégrateur | Format représentatif | Points de différenciation | Pour qui ? |
|---|---|---|---|
| Inspur | NF5688G7 et modèles apparentés (module HGX Hopper 8 GPU) | Leader en part de marché des serveurs IA locaux, chaîne de production d'appliance tout-en-un mature[9] | Déploiement local · production d'appliance |
| H3C | Série UniServer (HGX H20 8 GPU) | Documentation officielle de déploiement complète (registre d'identification H20 publié), réseau de service étendu en profondeur[10] | Clients professionnels · documentation et services |
| Supermicro | Système HGX H20 8 GPU (circuit Chine) | OEM de volume, ancrage dans la chaîne d'approvisionnement mondiale (selon les rapports publics) | Rapport qualité-prix · achats en volume |
| Intégrateurs de cartes PCIe | Tour/rack 4U/2U avec 8×PCIe H20 | Pas de NVLink full-interconnect, coût réduit, adapté aux scénarios d'inférence | Chaînes d'inférence · budget prioritaire |
AIXX Index · comparaison de déploiement en quatre dimensions AIXX INDEX
| Intégrateur | Facilité d'installation | Facilité de maintenance | Densité de performance | Durée de vie attendue |
|---|---|---|---|---|
| Inspur | 88 | 86 | 82 | 80 |
| H3C | 86 | 88 | 81 | 82 |
| Supermicro | 84 | 80 | 84 | 80 |
| Intégrateurs de cartes PCIe | 90 | 82 | 68 | 78 |
L'AIXX Index est une estimation propre à cette base (0–100, basée sur le format public, la solution de refroidissement et les différences de réseau de services), mise à jour au fil des vérifications sur machine réelle ; elle ne constitue aucun engagement d'achat. Les modèles concrets font foi selon les annonces officielles des fabricants.
Fiches terminologie GLOSSARY
variante réservée au marché chinois
Modèle dont les performances ont été réduites sous les seuils de licence afin d'entrer légalement sur le marché chinois continental, dans le cadre de la politique américaine de contrôle des exportations. Le H20 est la gamme spéciale de la génération Hopper (après l'A800/H800) ; l'échange : mémoire et bande passante préservées, puissance Tensor sacrifiée. Les informations de cette base reposent sur des rapports publics et ne constituent pas un avis juridique.
96GB HBM3 · 4.0TB/s
La raison d'être du H20 : mémoire et bande passante par carte supérieures à celles du H100 (80 Go / 3,35 To/s) — le contrôle des exportations verrouille la puissance de calcul, pas la mémoire. Un cas rare de « version spéciale plus performante sur un point ».
NVLink 4 · 900GB/s
NVLink de quatrième génération : le module HGX H20 8 GPU offre les mêmes vitesse et génération que le H100/H200 ; les cartes PCIe, en revanche, sont dépourvues de NVLink — distinguez d'abord les formes selon vos besoins d'interconnexion multi-GPU.
Module HGX H20 8 GPU
8 puces H20 montées sur la base, full-interconnect NVSwitch, 768 Go de mémoire au total — DeepSeek R1 complet en FP8 (environ 690 Go) tient dans une seule machine ; voici la raison matérielle de sa ruée début 2025 (estimation + rapports publics).
Gestion des licences / réapprobation
Avril 2025 : les États-Unis soumettent l'export du H20 vers la Chine à une licence (NVIDIA provisionne environ 5,5 milliards USD) ; le 15 juillet 2025, approbation et reprise ; depuis, l'offre et l'environnement d'achat fluctuent avec la politique. Les lots et le statut des licences affectent la garantie et la valeur de revente : à vérifier impérativement à la réception. Ne constitue pas un avis juridique.
Limites et controverses LIMITS
- La puissance de calcul amputée est son principal défaut (en toute honnêteté) : la puissance Tensor FP16/FP8 est environ un dixième de celle du H100/H200 à périmètre comparable (selon la presse[1]) — c'est l'échange « conformité contre accès au marché continental » : l'inférence n'est pas affectée, mais l'entraînement et les scénarios à forte densité de calcul sont inadaptés. L'acheter comme carte d'entraînement est la pire erreur de sélection possible.
- Spécifications sans page officielle : NVIDIA n'a pas de page produit officielle pour le H20, et les paramètres circulant en ligne sont confus (INT8/accès clairsemé divergents, NVLink erronément annoncé à 300 Go/s) — toutes les données de cette entrée sont sourcées auprès de la presse ; à la réception, fiez-vous aux rapports firmware et aux mesures réelles.
- Cycle de vie produit incertain : depuis août 2025, rumeurs de fin de production et annonces de successeurs (B30A, etc.) alternent dans les médias, l'approbation du successeur restant en suspens (rapports publics[4]) — l'approvisionnement en pièces de rechange, le support des pilotes et la conservation de la valeur présentent des incertitudes ; cette base ne se prononce pas.
- Environnement d'achat continental fluctuant : depuis août 2025, rapports sur la prudence réglementaire et les audits de sécurité ; décembre 2025, approbation du H200 pour la relève — le circuit d'achat officiel du H20 en Chine continentale évolue avec la politique (formulation neutre, rapports publics, ne constitue pas un avis juridique).
- Piège des versions : la version initiale 96 Go HBM3 et la version améliorée ~148 Go HBM3e (selon la presse) sont souvent confondues ; l'écart de prix entre systèmes HGX complets et cartes PCIe est important — pour toute offre de « serveur H20 », demandez d'abord la version et la forme.
- Forte volatilité des prix d'occasion : vague d'achat de janvier 2025, hausse d'environ 100 000 RMB par machine en un mois ; flambée courte pendant les rumeurs de rupture d'avril 2025 (rapports publics) — le marché fluctue fortement au gré des nouvelles politiques ; fiez-vous aux prix des vendeurs en temps réel, voir la « bande de marché ».
Encadré marché MARKET DATA
| Date | Périmètre | Région | Fourchette de prix de référence | Remarque |
|---|---|---|---|---|
| 2025-02 | Circuits selon la presse | Chine continentale | Système 8 GPU : environ 1,1 million RMB par machine (plus de +100 000 RMB depuis la fin d'année) | Source : Caixin/CLS[6] |
| 2025-02 | Circuits selon la presse | Chine continentale | Prix unitaire par carte : environ 110 000 RMB | Source : Caixin/CLS[6] |
| 2025-07 | Attentes offre-demande | Chine continentale | Reprise de la vente approuvée, part de consommation HBM attendue en hausse à 6 % sur 2025 | TrendForce[3] |
| 2026-10-20 | Hall de cette base | — | Aucun H20 en vente actuellement | Vérification propre de cette base (versions de la famille vérifiées par modèle exact) ; instantanés du marché cumulés quotidiennement depuis le 20/10/2026, affichage automatique dès disponibilité |
Note graphique : cette base n'a actuellement aucun H20 en vente et les prix d'ancrage externes ne couvrent que quelques dates — pas de bande interpolée (tracer une courbe à partir de points épars revient à inventer des données ; sans vérification, on ne se prononce pas) ; le graphique de tendance s'affichera automatiquement une fois les instantanés quotidiens cumulés (même méthode que pour les entrées H100/H200).
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Regardez où se situe le goulot : pour l'inférence et la grande mémoire (70B en une carte, R1 complet en huit cartes), le 96 Go/4,0 To/s du H20 dépasse le 80 Go/3,35 To/s du H100, et il fut le modèle conforme en vente sur le continent, avec un TDP de 400 W facile à intégrer ; pour l'entraînement, l'accélération du fine-tuning et les scénarios à haute densité de calcul, la puissance Tensor du H20 est environ un dixième de celle du H100 (selon la presse), passez directement au H100/H200. En une phrase : le H20 vend de la mémoire et de l'accès au marché, le H100/H200 vend de la puissance de calcul.
Le H20 est une variante réservée au marché chinois conforme au contrôle des exportations américain : lancé en 2024, soumis à licence en avril 2025 puis réapprouvé en juillet, depuis l'offre et l'achat fluctuent avec la politique (rapports publics). Le marché de l'occasion en 2026 repose principalement sur la circulation du parc installé des débuts, l'offre de machines neuves étant à l'arrêt. Cette entrée ne constitue pas un avis juridique ; le statut de conformité des achats relève des politiques des autorités et d'avis professionnels.
Le contrôle des exportations verrouille la puissance de calcul, pas la mémoire — le H20 conserve 96 Go de HBM3 et 4,0 To/s de bande passante (au-dessus des 80 Go / 3,35 To/s du H100), et sacrifie la puissance Tensor. C'est donc une carte née pour l'inférence : l'inférence de grands modèles consomme de la mémoire et de la bande passante, peu de puissance crête.
La version de référence expédiée en 2024 était la 96 Go HBM3 initiale ; la version améliorée ~148 Go HBM3e relève de rapports ultérieurs (certains médias annoncent 141–148 Go). Les deux versions sont extérieurement identiques ; à la réception, fiez-vous à la mesure de mémoire via nvidia-smi et aux rapports firmware, et mentionnez impérativement la version dans le contrat.
Oui : un HGX H20 8 GPU totalise 768 Go (96 Go×8), les poids complets FP8 pèsent environ 690 Go (estimation) — cela tient. C'est précisément la raison de l'adoption massive du H20 dans les appliances d'inférence DeepSeek début 2025 (rapports publics). Attention : « tenir » ne veut pas dire « aller vite » : le débit de génération est affecté par la réduction de puissance ; fiez-vous aux mesures réelles.
Fiches liées SEE ALSO
Comparaison et choix de machines COMPARE
Références REFERENCES
- MIT Technology Review Chine — NVIDIA reprend la vente du H20 en Chine (96 Go HBM3 / 4,0 To/s / FP8 296 TFLOPS / FP16 148 TFLOPS / 41 % de cœurs en moins que le H100) https://www.mittrchina.com/news/detail/15016
- Revue — rapport sur le développement par NVIDIA d'une puce conforme pour la Chine (12/2023, selon des sources indirectes) https://www.reuters.com/technology/
- TrendForce — H20 Export Approval Reignites Demand Momentum (HBM3 8-Hi des lots 2024 / plan de mise à niveau HBM3e / ~2,5 milliards USD impossibles à expédier en 04/2025 / reprise des exportations le 15/07/2025) https://www.trendforce.com/presscenter/news/20250716-12644.h…
- CNBC — Nvidia still hasn't sold its U.S.-approved China AI chips(2026-02-26) https://www.cnbc.com/2026/02/26/nvidia-china-chip-sales-expo…
- MyDrivers/Sina Finance — le H200 vendable mais le HBM3E toujours interdit (11/12/2025, confirmant la relève par le H200) https://finance.sina.com.cn/tech/discovery/2025-12-12/doc-in…
- CLS (Cailianshe) — +100 000 RMB depuis la fin d'année ! Le H20 devenu le « chouchou des grands comptes » (02/2025, système 8 GPU ≈ 1,1 M RMB, carte ≈ 110 000 RMB) https://www.cls.cn/detail/1956679
- CRS R48642 : U.S. Export Controls and China: Advanced Semiconductors (référence sur la chronologie des contrôles à l'exportation) https://www.congress.gov/crs-product/R48642
- Los Angeles Times — Nvidia's AI chip sales in China stall as local chipmakers like Huawei take lead(2026-06-29) https://www.latimes.com/business/story/2026-06-29/
- Inspur — page produit du serveur IA NF5688G7 (module HGX-Hopper-8GPU ; source des illustrations de systèmes de cette entrée) https://www.ieisystem.com/product/ai/15080.html
- H3C — documentation de déploiement H20 (registre réel NVIDIA-SMI 535.161.08 / CUDA 12.2) https://www.h3c.com
- Tom's Hardware — Nvidia responds to reports that its H20 GPU for China is ending production (rapport sur le B30A en attente d'approbation) https://www.tomshardware.com/tech-industry/artificial-intell…
- Nvidia working on new AI chip for China that outperforms H20(2025-08-19) https://www.reuters.com/technology/nvidia-working-new-ai-chi…
- GPU Database — NVIDIA H20 (9984 CUDA / 60 Mo L2 / 400 W) https://www.techpowerup.com/gpu-specs/nvidia-h20.c4184.html
- Données de bande de marché — AIXX (offres en vente sur la plateforme et intervalles connus des circuits, mises à jour quotidiennes ; 0 H20 en vente actuellement, consigné tel quel) https://www.aixx.vip/hall.html