AIXX Pedia › Ficha de modelo › H20

H20
Resumen OVERVIEW
H20 (NVIDIA H20) es una GPU de data center variante exclusiva para el mercado chino, desarrollada por NVIDIA para el mercado chino en cumplimiento de la política de control de exportaciones de EE. UU.: arquitectura Hopper (derivada del GH100), puesta a la venta en 2024 , junto con las variantes L20/L2 de la misma tanda. Es la sucesora de la línea especial A800/H800 tras ser incluida en el control a raíz del endurecimiento regulatorio de octubre de 2023[2][7]。
Su lógica de diseño fue un intercambio explícito: el control de exportaciones fijaba los indicadores de cómputo, así que el H20 redujo la capacidad Tensor a aproximadamente una décima parte de la del H100 en términos comparables (según cifras de la prensa), conservando los 96GB de HBM3, los 4.0TB/s de ancho de banda y la interconexión NVLink de 900GB/s de su generación —memoria y ancho de banda incluso superiores a los del H100. Es una tarjeta nacida para inferencia, no para entrenamiento[1]。
Su destino fue cambiante: en enero de 2025 el auge de DeepSeek desató una compra masiva (los servidores de 8 tarjetas llegaron a subir a unos 1,1 millones de yuanes por unidad, según reportes públicos[6]); en abril de 2025 EE. UU. exigió licencia por un tiempo y NVIDIA contabilizó provisiones de unos 5.500 millones de dólares; en julio de 2025 obtuvo la aprobación para reanudar las ventas; tras nuevas oscilaciones en política y entorno de compras, en diciembre de 2025 el H200 fue aprobado como sucesor para China y el H20 fue saliendo gradualmente del centro de la oferta (síntesis de reportes públicos[4][5]). En el mercado spot de 2026, el H20 se ofrece principalmente como circulación del parque instalado de los primeros lotes.
Casos de uso FIT
AIXX Index (0–100): esta biblioteca lo estima con ponderación según especificaciones públicas — memoria 40% + interconexión 30% + ecosistema 30%, con pesos ajustados por escenario. 90+ gama tope · 75+ Excelente · 60+ utilizable · menos de 60 no recomendado. Metodología transparente y verificable; no constituye una promesa de rendimiento.
Historia HISTORY
El 17 de octubre de 2023 , el control de exportaciones de EE. UU. se endureció y las variantes A800/H800 para China quedaron sujetas a licencia; NVIDIA pasó a desarrollar una nueva ronda de variantes conformes: la prensa reportó en diciembre de 2023 que desarrollaba nuevos chips para China (luego nombrados H20, junto con L20/L2)[2][7]。
En 2024 , el H20 salió a la venta (los lotes de ese año fueron principalmente la versión HBM3 8-Hi, según TrendForce[3]); los equipos completos con el módulo HGX H20 de 8 tarjetas llegaron al mercado de mano de Inspur, H3C y otros OEM de servidores/integrador de sistemas; NVIDIA no publicó página oficial de producto, por lo que las especificaciones se basan en fuentes de prensa y de los fabricantes. Las ventas iniciales fueron tibias: recorte de cómputo sumado a la competencia de la sustitución nacional (según reportes públicos).
2025 fue un año de grandes altibajos: entre enero y febrero el auge de DeepSeek desató compras masivas, los servidores de 8 tarjetas subieron de unos 1 millón a unos 1,1 millones de yuanes por unidad y los grandes fabricantes encargaron grandes volúmenes para cargas de inferencia (según STCN[6]); en abril EE. UU. exigió licencia para la exportación a China y NVIDIA contabilizó provisiones de unos 5.500 millones de dólares (de los cuales unos 2.500 millones correspondían a H20 no entregado[3]); el 15 de julio obtuvo la aprobación para reanudar ventas (reportes posteriores mencionaron acuerdos de reparto de ingresos); desde agosto el entorno de compras se volvió cauteloso y aparecieron rumores de cierre de capacidad y filtraciones del chip sucesor[4]。
Finales de 2025 hasta hoy : en diciembre el H200 fue aprobado como sucesor para China (memoria HBM3E aún restringida, según MyDrivers[5]); en 2026 la prensa reportó que las ventas reales de chips de IA de NVIDIA a China estaban estancadas y que crecía la cuota de los fabricantes locales (CNBC 2026-02, Los Angeles Times 2026-06[4][8]). El papel spot del H20 pasa a ser la circulación del parque instalado: los equipos comprados en la primera ola siguen en servicio y en reventa en data centers nacionales. Todas las afirmaciones de esta ficha se basan en reportes públicos y no constituyen asesoramiento legal.
Especificaciones técnicas SPECIFICATIONS
Declaración de fuentes: NVIDIA no publicó página oficial del H20 (la variante para China no figura en su catálogo global); la tabla siguiente recoge cifras de prensa y de los OEM de servidores/integrador de sistemas ; en campos con datos discrepantes se toma el valor conservador; prevalecen los reportes de firmware a la llegada y las mediciones reales.
| Concepto | Especificaciones (H20 · cifras de prensa) |
|---|---|
| Núcleo GPU | NVIDIA Hopper (derivado del GH100 como variante exclusiva para el mercado china conforme) |
| Memoria por tarjeta | 96GB HBM3 (versión mejorada de unos 148GB HBM3e · según reportes) |
| Ancho de banda de memoria | 4.0TB/s por tarjeta (superior a los 3.35TB/s del H100) |
| FP16 / BF16 Tensor Core | unos 148 TFLOPS (denso; unos 296 con dispersión) |
| FP8 Tensor Core | unos 296 TFLOPS (cifras de prensa) |
| FP32 | unos 44 TFLOPS (cifras de prensa) |
| Interconexión GPU-GPU | NVLink cuarta generación · 900GB/s (según módulo HGX H20 de 8 tarjetas) |
| Interconexión con el host | PCIe Gen5 x16 |
| Consumo de la tarjeta (TBP/TGP) | TDP de unos 400W (cifra mayoritaria en prensa; algunas páginas de canal indican 350W) |
| Escala de CUDA Cores | un 41% menos que el H100 aprox. (cifras de prensa) |
| Formato de sistema dominante | Equipos con placa HGX H20 de 8 tarjetas (Inspur / H3C / Supermicro, etc.) · tarjeta individual PCIe |
| Drivers / CUDA | desde drivers serie 535 (registro real en documentación oficial de H3C: NVIDIA-SMI 535.161.08 / CUDA 12.2) |
| Generación anterior / producto equivalente | A800 / H800 (ya bajo control) / H100, H200 |
Especificaciones a validar cruzando fuentes públicas de prensa[1]; la capacidad Tensor debe verificarse con reportes de firmware y pruebas reales: la ausencia de página oficial que respalde los datos de fábrica es un riesgo específico del H20 al momento de elegir (véase «Limitaciones y controversias»).
Comparativa generacional · cómo se reparten las tres tarjetas de la misma generación GENERATIONS
| Concepto | H100 80GB | H20 96GB | H200 141GB |
|---|---|---|---|
| Memoria por tarjeta | 80GB HBM3 | 96GB HBM3 | 141GB HBM3e |
| Ancho de banda de memoria | 3.35TB/s | 4.0TB/s | 4.8TB/s |
| FP16/BF16 Tensor (disperso) | 1,979 TFLOPS | unos 296 TFLOPS (cifras de prensa) | 1,979 TFLOPS |
| FP8 Tensor (disperso) | 3,958 TFLOPS | unos 296 TFLOPS (cifras de prensa) | 3,958 TFLOPS |
| Interconexión GPU-GPU | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s |
| Consumo de la tarjeta (TBP/TGP) | hasta 700W | unos 400W | hasta 700W |
| Canal para China | venta pública no aprobada | variante exclusiva para el mercado chino conforme · vaivenes regulatorios (cifras neutras) | aprobada para China en 2025-12 |
| Recomendación en una frase | Máximo rendimiento · el ecosistema más grande | cambia cómputo por acceso · inferencia con gran memoria | memoria duplicada · caballo de batalla en volumen |
La columna H100/H200 recoge cifras de página oficial y la H20 cifras de prensa; el estado del canal para China es de reportes públicos y evoluciona con las políticas, sin constituir asesoramiento legal.
Miembros de la familia FAMILY
La familia H20 se divide en cuatro variantes según encapsulado y versión de memoria; el mercado spot está dominado por los equipos HGX de 8 tarjetas y las tarjetas PCIe individuales:
Refrigeración y despliegue COOLING
El H20 es la generación de la familia Hopper más fácil de desplegar : su consumo por tarjeta de unos 400W (cifras de prensa) es apenas el 60% del del H100/H200 (nivel 700W), el equipo HGX de 8 tarjetas es una solución torre refrigerada por aire madura y la tarjeta PCIe cabe en doble ranura con refrigeración por aire lista para conectar y usar: las salas de máquinas existentes no requieren adaptación a refrigerado por líquido para alojarlo; una de las razones por las que las líneas de equipos todo en uno de grandes modelos lo eligieron a inicios de 2025 (según reportes públicos).
Adaptación de modelos MODEL FIT
| Modelo / escenario | Requisito de memoria (estimación FP8) | Despliegue H20 (8 tarjetas, 768GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 completo (671B) | ≈ 690GB | En ocho tarjetas cabe —96GB×8=768GB, una de las configuraciones principales de los equipos todo en uno con inferencia DeepSeek completa de inicios de 2025 (según reportes públicos); margen ajustado, el KV cache debe gestionarse con cuidado | 78 |
| R1-Distill clase 70B | ≈ 70GB | Con 96GB por tarjeta el margen es holgado, más desahogado que el H100 (80GB al límite) | 88 |
| Modelos abiertos clase 72B | ≈ 72GB | Desplegable en una sola tarjeta; para contextos largos conviene reservar margen de KV cache | 85 |
| Nivel 7B-14B (incluye pequeños modelos de generación de vídeo) | unos 8-30GB | Sencillo en una tarjeta; las líneas de gran volumen escalan concurrencia con varias tarjetas | 90 |
Memoria estimada con pesos FP8 ≈ parámetros × 1 byte (cálculo propio, sin incluir KV cache ni margen de activación); «cabe» se refiere solo a la dimensión de capacidad de memoria; la velocidad de generación se ve afectada por el recorte de cómputo (capacidad Tensor de unas diez veces menor que la del H100, cifras de prensa): el throughput prevalece según mediciones reales. El AIXX Index es un cálculo propio de esta base.
Galería GALLERY
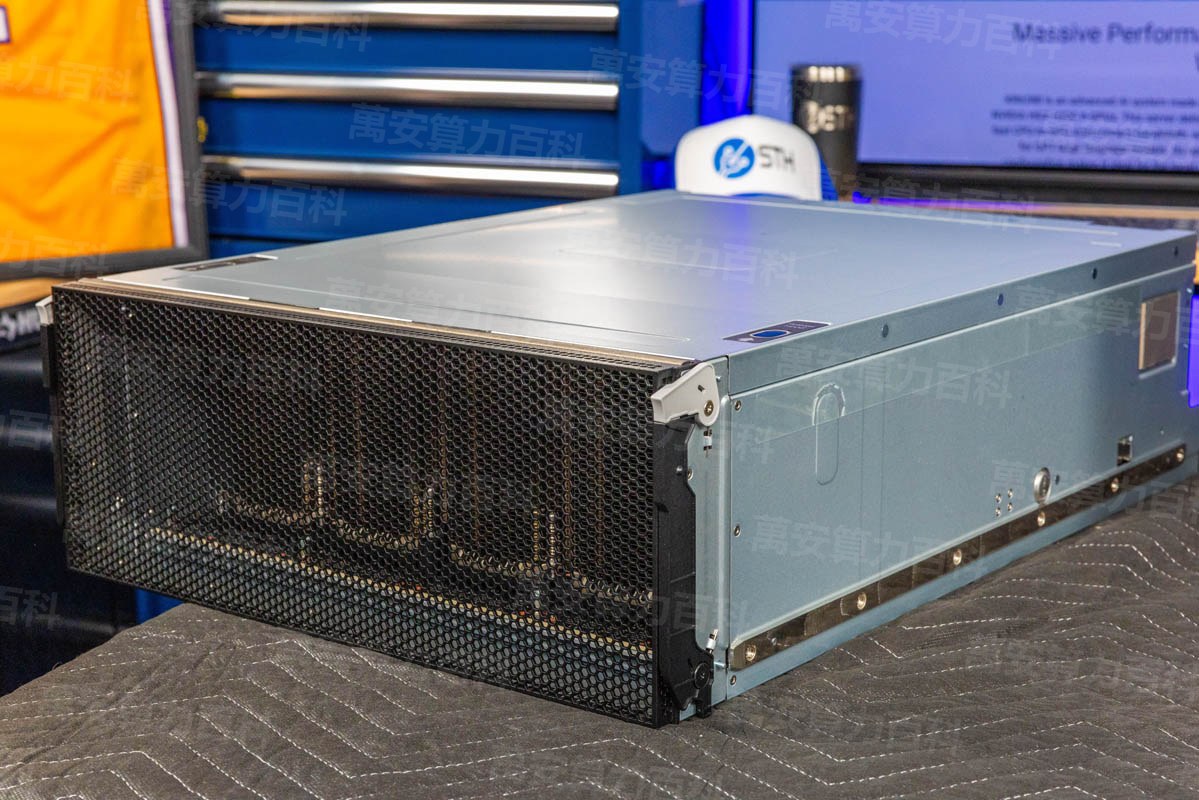
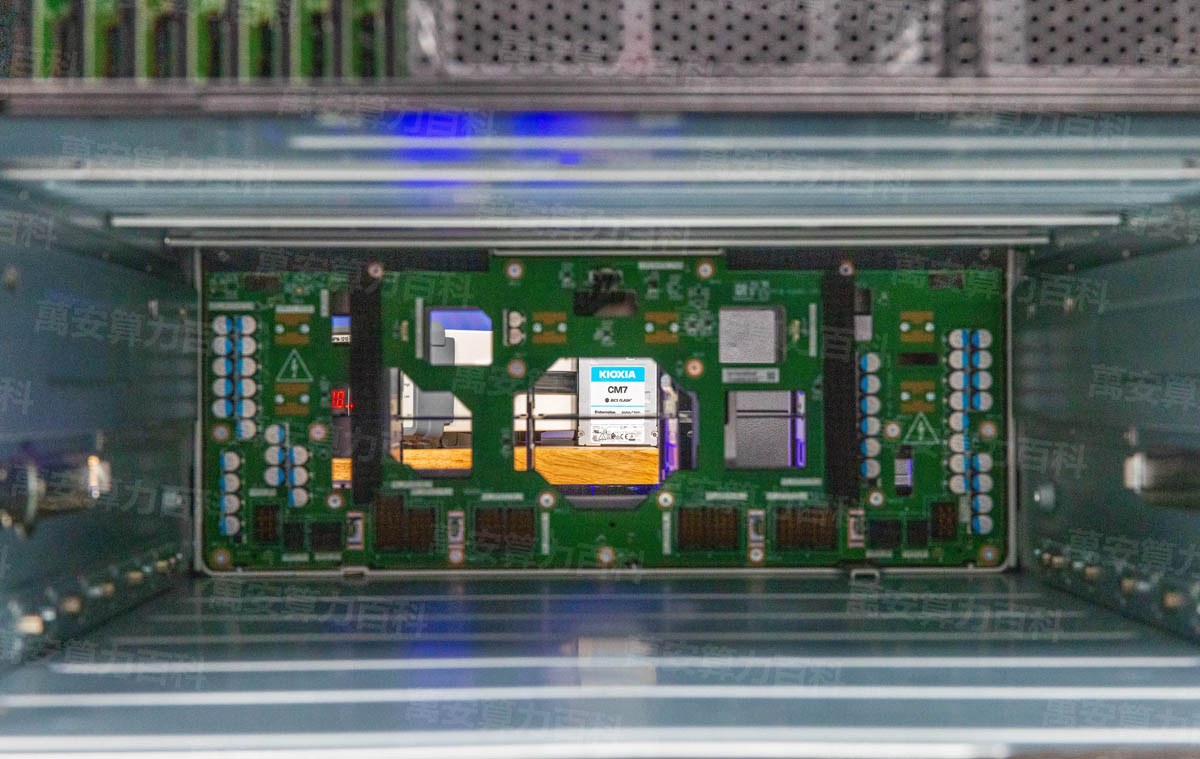
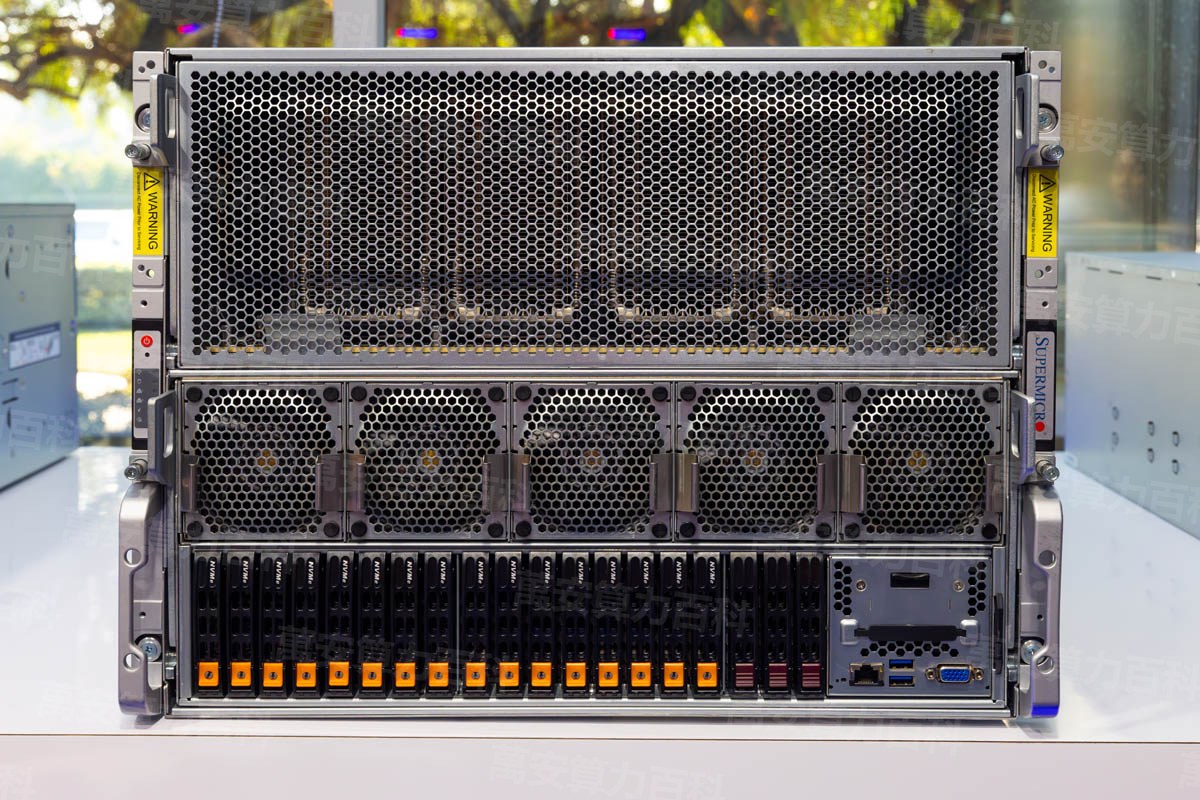
Nota: el H20 es una variante exclusiva para el mercado chino sin página oficial de producto de NVIDIA, y tampoco hay análisis con fotos reales en medios hardware extranjeros de referencia, por lo que esta ficha abre con imágenes de OEM de servidores/integrador de sistemas; las fotos reales se irán añadiendo de forma continua con los lotes verificados por esta base (las fotos de verificación propia son la fuente de máxima prioridad). Las imágenes generadas por IA no se presentan como fotos reales; el H100/H200 y el H20 comparten aspecto de la serie Hopper, por lo que las fotos no sirven como criterio de identificación (véase «Compra y verificación»).
Vídeo explicativo VIDEO
Máquinas reales de la comunidad · fuente Bilibili COMMUNITY
Contenido de máquinas reales de creadores de Bilibili (el reproductor oficial de Bilibili se carga al hacer clic y puede verse en la propia página); derechos de autor de sus respectivos creadores. Este vídeo es un veredicto exclusivo del H20 (todas las cifras ancladas al H20 real: 96GB / 4.0TB/s / 400W / HGX NVLink 900GB/s · la variante PCIe individual indicada tal cual); la transcripción de la narración y los textos de escena se archivan en _wiki_work_1006/gen_tts_benchh20.py.
Equipos reales de la comunidad · Fuente YouTube COMMUNITY HANDS-ON
En algunas regiones puede no reproducirse directamente
Software y ecosistema ECOSYSTEM
| Concepto | Requisitos / Situación actual |
|---|---|
| CUDA / drivers | desde drivers serie 535 (registro real del documento oficial de despliegue de H3C: NVIDIA-SMI 535.161.08 / CUDA 12.2 reconoce el H20) |
| Frameworks de entrenamiento | PyTorch / TensorFlow ofrecen soporte oficial de Hopper; con el cómputo limitado del H20, el entrenamiento queda reducido a ajuste fino a pequeña escala |
| Motores de inferencia | vLLM / SGLang / TensorRT-LLM lo soportan de forma nativa; la gran memoria + el alto ancho de banda son la base de su throughput de inferencia |
| Red complementaria | ConnectX-7 400G o solución de interconexión equivalente (configuración estándar del OEM) |
| Sistema operativo | Distribuciones Linux principales (Ubuntu 22.04+ etc.) |
El H20 pertenece al mismo ecosistema Hopper que el H100/H200 y comparte íntegramente el stack de software: la «reducción de ecosistema» no existe; la «reducción de cómputo» sí. Las versiones del stack evolucionan con el tiempo; prevalecen las publicaciones oficiales de NVIDIA.
Compra e inspección PROCUREMENT
Puntos de verificación al comprar un H20 (tres):
Los seis veredictos de prueba completos (cifras ancladas al H20 real) se encuentran en esta ficha «Cómo hacer pruebas de estrés» de esta entrada.
Cómo hacer pruebas de estrés BENCH TEST
Metodología de las seis pruebas, con veredictos todos anclados al H20 real: reconocimiento al abrir la caja → Prueba de burn-in de una tarjeta (torre refrigerada por aire de nivel 400W, ≤85℃ y cero ECC = Aprobado) → plena carga de todo el equipo → ancho de banda (nominal 4.0TB/s, ≥85% = Aprobado) → interconexión (nccl-tests en el grupo HGX ≥750GB/s / en tarjeta PCIe verificar enlace completo Gen5 x16) → throughput de inferencia (≥80% del benchmark público).
nvidia-smigpu-burn 3600 o dcgmi diag -r 3 · 30–60 minutosbandwidthTest(muestras incluidas en CUDA)nccl-tests benchmark all_reducevLLM Desplegar un modelo real y medirNota metodológica: las líneas de Aprobado/Excelente fueron recopiladas por este repositorio según criterios habituales de ingeniería (ancho de banda como proporción del valor nominal, temperatura según el límite habitual en centros de datos) y se irán calibrando progresivamente con datos reales de los informes de inspección; esta tabla no constituye compromiso alguno de aceptación, lo concreto se rige por el contrato. Las mediciones de los informes de inspección de este repositorio se registran según esta misma tabla — NOT_EXECUTED indica que la prueba no se ejecutó, y «no se midió» es en sí mismo información relevante.
Transporte y entrega LOGISTICS
OEM y variantes VENDORS
Una misma placa base HGX H20; las diferencias entre integradores están en el formato, la refrigeración y el servicio — al elegir, mira primero las diferencias:
| Fabricante del servidor | Formato representativo | Diferenciadores | ¿Para quién? |
|---|---|---|---|
| Inspur | MetaSeries NF5688G7 y similares (módulo HGX Hopper de 8 tarjetas) | Líder en cuota de servidores de IA locales, línea de producción de sistemas integrados consolidada[9] | Despliegue local · línea de sistemas integrados |
| H3C | Serie UniServer (HGX H20 de 8 tarjetas) | Documentación oficial de despliegue completa (registros de identificación del H20 publicados), red de servicio de proximidad[10] | Clientes corporativos · quienes exigen documentación y servicio |
| Supermicro | Sistema completo HGX H20 de 8 tarjetas (canal para China) | OEM de gran volumen, con trasfondo de cadena de suministro global (según informes públicos) | Relación calidad-precio · compras por lotes |
| Integradores de tarjetas PCIe | 4U/2U 8×PCIe H20 torre/rack | Sin interconexión NVLink, coste reducido, orientado a inferencia | Líneas de inferencia · presupuesto prioritario |
AIXX Index · comparación de despliegue en cuatro dimensiones AIXX INDEX
| Fabricante del servidor | Facilidad de instalación | Facilidad de mantenimiento | Densidad de rendimiento | Expectativa de vida útil |
|---|---|---|---|---|
| Inspur | 88 | 86 | 82 | 80 |
| H3C | 86 | 88 | 81 | 82 |
| Supermicro | 84 | 80 | 84 | 80 |
| Integradores de tarjetas PCIe | 90 | 82 | 68 | 78 |
El AIXX Index es una estimación propia de esta biblioteca (0–100, basada en formato público, solución de refrigeración y diferencias en la red de servicios); se actualiza con las verificaciones en unidades reales y no constituye un compromiso de compra. Los modelos específicos están sujetos a las publicaciones oficiales del fabricante.
Fichas de términos GLOSSARY
Variante exclusiva para el mercado chino
Modelo que reduce rendimiento bajo umbrales de licencia para entrar legalmente en China continental, conforme a la política de control de exportaciones de EE. UU. El H20 es la línea exclusiva de la generación Hopper (precedida por A800/H800); la lógica de intercambio: conservar memoria, ancho de banda e interconexión, recortar la potencia Tensor. Todas las afirmaciones de esta entrada provienen de informes públicos y no constituyen asesoramiento legal.
96GB HBM3 · 4.0TB/s
La razón de ser del H20: memoria y ancho de banda por tarjeta superiores al H100 (80GB / 3.35TB/s) — el control de exportaciones limita las métricas de cómputo, no la memoria. Es un caso raro de «variante exclusiva superior en algún aspecto».
NVLink 4 · 900GB/s
Cuarta generación de NVLink; el módulo HGX H20 de 8 tarjetas comparte generación y velocidad con H100/H200; el formato de tarjeta PCIe carece de NVLink — distingue primero el formato si necesitas redes multi-GPU.
Módulo HGX H20 de 8 tarjetas
8 chips H20 montados en placa, interconexión total por NVSwitch, 768GB de memoria en total — DeepSeek R1 completo en FP8 (unos 690GB) cabe en un solo equipo; esta es la razón dura de su compra masiva a comienzos de 2025 (estimación + informes públicos).
Gestión de licencias / aprobación de reanudación
En 2025-04 EE. UU. exigió licencia para exportar el H20 a China (NVIDIA provisionó unos 5.500 millones de USD); el 2025-07-15 se aprobó la reanudación, y desde entonces el entorno de oferta y compra ha oscilado con la política. El lote y el estado de licencia afectan garantía y valor de reventa: inspección obligatoria. No constituye asesoramiento legal.
Limitaciones y controversias LIMITS
- El recorte de cómputo es su mayor defecto (dicho con franqueza) : la potencia Tensor FP16/FP8 es aproximadamente una décima parte del H100/H200 en igualdad de condiciones (según medios[1]) — es el intercambio por «cumplimiento a cambio de acceso al mercado chino»: la inferencia no se ve afectada, pero es totalmente inadecuado para entrenamiento y escenarios de alta densidad de cómputo. Comprarlo como tarjeta de entrenamiento es el mayor error de selección.
- Especificaciones sin respaldo oficial : NVIDIA no tiene página oficial del H20 y las cifras que circulan son confusas (criterios INT8/dispersión dispares, falsa afirmación de NVLink de 300GB/s) — esta entrada marca todo según informes de medios; en la inspección, rigen el informe de firmware y las mediciones reales.
- Ciclo de vida del producto incierto : desde agosto de 2025 se alternan rumores de cierre de producción y de chips sucesores (B30A, etc.), con la aprobación del sucesor sin resolver (según informes públicos[4]) — existe incertidumbre en repuestos a largo plazo, soporte de drivers y expectativa de valor; esta entrada no emite juicio.
- Entorno de compra en China cambiante : informes de cautela regulatoria y revisión de seguridad desde 2025-08, y aprobación del H200 para China en 2025-12 — la vía de compra oficial del H20 en China fluctúa con la evolución de la política (redacción neutra, informes públicos, sin asesoramiento legal).
- Trampa de versiones : la versión inicial de 96GB HBM3 y la versión actualizada de unos 148GB HBM3e (según informes) se confunden en los reportes; la brecha de precio entre el sistema HGX completo y la tarjeta PCIe es grande — ante una cotización de «servidor H20», pregunta primero versión y formato.
- Alta volatilidad en el mercado de segunda mano : en la ola de compras de 2025-01 subió unos 100.000 CNY por unidad en un mes; picos a corto plazo durante los rumores de corte de 2025-04 (informes públicos) — el mercado oscila fuertemente con las noticias de política; el precio real está sujeto a la cotización del vendedor; ver «banda de mercado».
Franja de mercado MARKET DATA
| Fecha | Criterio | Región | Banda de precio de referencia | Notas |
|---|---|---|---|---|
| 2025-02 | Informes de canal | China continental | Sistema de 8 tarjetas: unos 1,1 millones de CNY/unidad (más de +100.000 frente a fin de año) | Criterio según Bursamérica/medios financieros[6] |
| 2025-02 | Informes de canal | China continental | Precio unitario por tarjeta: unos 110.000 CNY | Criterio según Bursamérica/medios financieros[6] |
| 2025-07 | Expectativa de oferta y demanda | China continental | Reanudación de ventas aprobada; se prevé que la cuota de consumo de HBM suba al 6% en 2025 | TrendForce[3] |
| 2026-10-20 | Sala de esta base de datos | — | Sin H20 a la venta por ahora | Verificado por esta base (familia comprobada por modelo exacto); instantáneas de mercado acumuladas a diario desde el 2026-10-20; se muestran automáticamente cuando hay stock |
Nota sobre el gráfico: esta base no tiene actualmente H20 a la venta y los precios externos son solo puntos aislados — no se dibuja una banda estimada (trazar una curva con puntos sueltos es inventar datos; lo no verificado no se publica); el gráfico de tendencia de precios se activará automáticamente al acumularse las instantáneas diarias (misma práctica que en las entradas H100/H200).
Cronología de hitos de precios MILESTONES
Preguntas frecuentes FAQ
Mira dónde está el cuello de botella: para inferencia y gran memoria (70B por tarjeta, R1 completo en ocho tarjetas), el 96GB/4.0TB/s del H20 supera el 80GB/3.35TB/s del H100, además fue un modelo legalmente vendible en China y con 400W es fácil de desplegar; para entrenamiento, aceleración de fine-tuning y alta densidad de cómputo, la potencia Tensor del H20 es una décima parte del H100 en igualdad de condiciones (criterio de medios): ve directo al H100/H200. En una frase: el H20 vende memoria y acceso, el H100/H200 vende cómputo.
El H20 es una variante exclusiva para el mercado chino conforme a la política de control de exportaciones de EE. UU.: salió en 2024, en abril de 2025 se exigió licencia temporalmente, en julio se aprobó la reanudación, y desde entonces la oferta y el entorno de compra han oscilado con la política (informes públicos). El stock de 2026 se compone principalmente de circulación del parque instalado anterior; la oferta de equipos nuevos está paralizada. Esta nota no constituye asesoramiento legal; el estado de cumplimiento debe consultarse con la política de las autoridades competentes y opinión profesional.
El control de exportaciones limita las métricas de cómputo, no la memoria — el H20 conserva 96GB HBM3 y 4.0TB/s (superior al 80GB / 3.35TB/s del H100) y recorta la potencia Tensor. Por eso es una tarjeta nacida para la inferencia: la inferencia de modelos grandes consume memoria y ancho de banda, no tanta potencia pico.
La versión dominante de 2024 fue la inicial de 96GB HBM3; la actualizada de unos 148GB HBM3e es un criterio de informes posteriores (algunos medios citan entre 141-148GB). Ambas versiones son idénticas exteriormente; en la inspección rige la memoria medida con nvidia-smi y el informe de firmware, y el contrato de compra debe especificar la versión.
Sí: el HGX H20 de ocho tarjetas suma 768GB (96GB×8) y los pesos completos en FP8 (unos 690GB, estimación) caben — esta es la razón por la que en 2025 los servidores integrados de inferencia DeepSeek adoptaron masivamente el H20 (informes públicos). Pero ojo: «caber» no es «ir rápido»; el throughput de generación se ve afectado por el recorte de cómputo; rige la medición real.
Fichas relacionadas SEE ALSO
Comparativa y selección de modelos COMPARE
Referencias REFERENCES
- MIT Technology Review China — NVIDIA reanuda la venta del H20 en China (96GB HBM3 / 4.0TB/s / FP8 296 TFLOPS / FP16 148 TFLOPS / 41% menos núcleos que el H100) https://www.mittrchina.com/news/detail/15016
- — Informe de NVIDIA desarrollando chips conformes para China (2023-12, según fuentes citadas) https://www.reuters.com/technology/
- TrendForce — H20 Export Approval Reignites Demand Momentum (HBM3 8-Hi del lote 2024 / plan de actualización HBM3e / 2025-04 unos 2.500 millones de USD sin poder enviarse / reanudación de exportación el 2025-07-15) https://www.trendforce.com/presscenter/news/20250716-12644.h…
- CNBC — Nvidia still hasn't sold its U.S.-approved China AI chips(2026-02-26) https://www.cnbc.com/2026/02/26/nvidia-china-chip-sales-expo…
- MyDrivers/Sina Finance — El H200 puede venderse pero el HBM3E sigue prohibido (2025-12-11, respaldo del relevo por el H200) https://finance.sina.com.cn/tech/discovery/2025-12-12/doc-in…
- Bursamérica — ¡Sube 100.000 frente a fin de año! El H20 ya es el «favorito de los grandes» (2025-02, sistema de 8 tarjetas unos 1,1 millones de CNY, tarjeta suelta unos 110.000 CNY) https://www.cls.cn/detail/1956679
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (archivo autoritativo de la cronología de los controles de exportación) https://www.congress.gov/crs-product/R48642
- Los Angeles Times — Nvidia's AI chip sales in China stall as local chipmakers like Huawei take lead(2026-06-29) https://www.latimes.com/business/story/2026-06-29/
- Inspur — Página del producto del servidor de IA NF5688G7 (módulo HGX-Hopper-8GPU; fuente de la imagen del sistema de esta entrada) https://www.ieisystem.com/product/ai/15080.html
- H3C — Documentación de despliegue del H20 (registro de identificación real con NVIDIA-SMI 535.161.08 / CUDA 12.2) https://www.h3c.com
- Tom's Hardware — Nvidia responds to reports that its H20 GPU for China is ending production (informe del B30A pendiente de aprobación) https://www.tomshardware.com/tech-industry/artificial-intell…
- Nvidia working on new AI chip for China that outperforms H20(2025-08-19) https://www.reuters.com/technology/nvidia-working-new-ai-chi…
- GPU Database — NVIDIA H20 (9984 CUDA / 60MB L2 / criterio 400W) https://www.techpowerup.com/gpu-specs/nvidia-h20.c4184.html
- Datos de banda de mercado — AIXX Exchange (cotizaciones en venta en esta plataforma e intervalos de canal, actualización diaria; H20: 0 en venta actualmente, registrado con honestidad) https://www.aixx.vip/hall.html