AIXX Pedia › Modelleintrag › H20

H20
Überblick OVERVIEW
H20 (NVIDIA H20) ist eine unter den US-Exportkontrollvorgaben speziell für den chinesischen Markt entwickelte, exportkonforme Datacenter-GPU von NVIDIA: Hopper-Architektur (GH100-Ableitung), Markteinführung und Auslieferung 2024 , im selben Batch auch die Sondervarianten L20/L2. Sie ist der Nachfolger der A800/H800-Sonderlinie, die bei der Verschärfung der Kontrollbestimmungen im Oktober 2023 unter die Regulierung fiel[2][7]。
Ihre Designlogik ist ein offener Tauschhandel: Die Exportkontrollen setzen der Rechenleistung Grenzen, also senkte das H20 die Tensor-Rechenleistung auf rund ein Zehntel des H100-Niveaus (Medienangaben), hielt dafür aber 96GB HBM3Videospeicher, 4,0TB/s Bandbreite und die 900GB/s-NVLink-Interconnect der gleichen Generation — Speicher und Bandbreite liegen sogar über dem H100. Das ist eine Karte für Inferenz, nicht für Training[1]。
Ein wechselhaftes Schicksal: Im Januar 2025 löste der DeepSeek-Boom eine Hamsterkäufe aus (8-GPU-Server stiegen zeitweise auf rund 1,1 Mio. RMB pro Einheit, Medienberichte[6]); im April 2025 verlangte die US-Regierung zeitweise Lizenzen, NVIDIA buchte rund 5,5 Mrd. USD ab; im Juli 2025 wurde der Verkauf wieder genehmigt; danach schwankte die Lage mit Politik und Beschaffungsumfeld, im Dezember 2025 wurde das H200 als Nachfolger für China freigegeben, das H20 trat schrittweise aus dem Zentrum des Angebots (zusammengesetzte Medienberichte[4][5]). Auf dem Spotmarkt 2026 besteht das H20 überwiegend aus Umlauf im installierten Bestand.
Einsatzszenarien FIT
AIXX Index (0–100): Die Datenbank gewichtet öffentliche Spezifikationen – Speicher 40 % + Interconnect 30 % + Ökosystem 30 %, je nach Szenario angepasst. 90+ Flaggschiff · 75+ Ausgezeichnet · 60+ brauchbar · unter 60 ungeeignet. Methodik transparent und überprüfbar, keine Leistungszusage.
Historie HISTORY
Am 17. Oktober 2023 verschärften die USA die Exportkontrollen, die A800/H800-Sondervarianten für China fielen unter Lizenzpflicht; NVIDIA wandte sich der Entwicklung einer neuen Runde konformer Sondervarianten zu — Medien berichteten im Dezember 2023 über einen neuen Chip für China (später als H20 benannt, im selben Batch L20/L2)[2][7]。
2024 kam das H20 auf den Markt (die Auslieferungen des Jahres waren überwiegend die HBM3-8-Hi-Variante, TrendForce[3]); Komplettsysteme mit HGX-H20-8-GPU-Modulen brachten Inspur, H3C u. a. auf den Markt; NVIDIA unterhält keine offizielle Produktseite, Spezifikationen beruhen auf Medien- und OEM-Angaben. Der Verkaufsstart verlief zäh — gedrosselte Rechenleistung plus Konkurrenz durch heimische Alternativen (Medienberichte).
2025 war ein Jahr der Extreme: Im Januar/Februar löste der DeepSeek-Boom Hamsterkäufe aus, 8-GPU-Server stiegen von rund 1,0 auf rund 1,1 Mio. RMB pro Einheit, große Anbieter orderten massenhaft Inferenz-Kapazität (Berichte von Cailianshe[6]); im April verlangte die US-Regierung Lizenzen für China-Exporte, NVIDIA buchte rund 5,5 Mrd. USD ab (davon rund 2,5 Mrd. USD nicht ausgelieferte H20[3]); am 15. Juli wurde der Verkauf wieder genehmigt (Medienberichten zufolge mit Umsatzbeteiligungsvereinbarungen); ab August wurde das Beschaffungsumfeld vorsichtiger, Gerüchte über Auslaufkapazitäten und Nachfolgechips machten die Runde[4]。
Ende 2025 bis heute : Im Dezember wurde das H200 für China freigegeben (HBM3E-Speicher weiterhin limitiert, Berichte von MyDrivers[5]); 2026 berichteten Medien, NVIDIAs China-Geschäft mit KI-Chips faktisch stillstehe, der Anteil heimischer Hersteller steige (CNBC 02/2026, LA Times 06/2026[4][8]). Die Rolle des H20 auf dem Spotmarkt wandelt sich zum Umlauf im installierten Bestand: Früher aufgekaufte Systeme dienen weiterhin in chinesischen Rechenzentren oder werden weiterverkauft. Alle Angaben hier sind Medienberichten entnommen und stellen keine Rechtsberatung dar.
Technische Daten SPECIFICATIONS
Hinweis zur Datenlage: NVIDIA unterhält keine offizielle H20-Produktseite (die Sondervariante für China ist nicht in der globalen Produktlinie gelistet); die folgende Tabelle basiert auf Medien- und OEM-Angaben , bei abweichenden Werten wird der konservative Wert angesetzt; maßgeblich sind Firmware-Reports bei Wareneingang und Messungen.
| Position | Spezifikationen (H20 · Medienangaben) |
|---|---|
| GPU-Chip | NVIDIA Hopper (GH100-Ableitung, konform für China) |
| Speicher pro Karte | 96GB HBM3 (Upgrade-Version rund 148GB HBM3e · Berichtsangaben) |
| VRAM-Bandbreite | 4,0TB/s pro Karte (über den 3,35TB/s des H100) |
| FP16 / BF16 Tensor Core | rund 148 TFLOPS (dicht; sparse rund 296) |
| FP8 Tensor Core | rund 296 TFLOPS (Medienangaben) |
| FP32 | rund 44 TFLOPS (Medienangaben) |
| GPU-zu-GPU-Interconnect | NVLink vierte Generation · 900GB/s (HGX-H20-8-GPU-Modul) |
| Host-Interconnect | PCIe Gen5 x16 |
| Board-Power (TBP/TGP) | rund 400W TDP (überwiegende Medienangabe; einzelne Kanalseiten nennen 350W) |
| CUDA-Kernanzahl | rund 41 % weniger als H100 (Medienangaben) |
| Übliche Systemformen | HGX-H20-8-GPU-Basiskomplettsysteme (Inspur / H3C / Supermicro u. a.) · PCIe-Einzelkarte |
| Treiber / CUDA | ab Treiberreihe 535 (dokumentierte Erkennung laut offizieller H3C-Dokumentation: NVIDIA-SMI 535.161.08 / CUDA 12.2) |
| Vorgänger / Vergleichsprodukt | A800 / H800 (unter Kontrolle) / H100, H200 |
Spezifikationen beruhen auf kreuzgeprüften öffentlichen Medienquellen[1]; die Tensor-Rechenleistung sollte anhand von Firmware-Reports und Messungen verifiziert werden — dass die Werksangaben keine offizielle Seite belegen, ist ein typisches Auswahlrisiko des H20 (siehe „Grenzen und Kontroversen“).
Generationenvergleich · drei Karten derselben Generation im Vergleich GENERATIONS
| Position | H100 80GB | H20 96GB | H200 141GB |
|---|---|---|---|
| Speicher pro Karte | 80GB HBM3 | 96GB HBM3 | 141GB HBM3e |
| VRAM-Bandbreite | 3.35TB/s | 4.0TB/s | 4.8TB/s |
| FP16/BF16 Tensor (sparse) | 1,979 TFLOPS | rund 296 TFLOPS (Medienangaben) | 1,979 TFLOPS |
| FP8 Tensor (sparse) | 3,958 TFLOPS | rund 296 TFLOPS (Medienangaben) | 3,958 TFLOPS |
| GPU-zu-GPU-Interconnect | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s |
| Board-Power (TBP/TGP) | bis zu 700W | rund 400W | bis zu 700W |
| China-Kanal | keine Freigabe für öffentlichen Verkauf | Konforme Sondervariante · politisch wechselhaft (neutrale Darstellung) | 12/2025 für China freigegeben |
| Auswahl in einem Satz | volle Rechenleistung · größtes Ökosystem | Rechenleistung gegen Marktzugang getauscht · Inferenz mit großem Speicher | verdoppelter Speicher · Volumen-Arbeitstier |
H100/H200 werden nach offiziellen Seitenangaben gelistet, das H20 nach Medienangaben; der Status des China-Kanals beruht auf öffentlichen Berichten und entwickelt sich mit der Politik weiter, keine Rechtsberatung.
Familienmitglieder FAMILY
Die H20-Familie gliedert sich nach Packaging und Speicherversion in vier Zweige; auf dem Spotmarkt dominieren HGX-8-GPU-Systeme und PCIe-Einzelkarten:
Kühlung und Deployment COOLING
Das H20 ist in der Hopper-Familie die am einfachsten zu deployende Generation : Mit rund 400W Board-Power (TBP/TGP) (Medienangaben) liegt es bei nur 60 % des H100/H200 (700W-Klasse), HGX-8-GPU-Systeme sind ausgereifte luftgekühlte Lösungen, die PCIe-Einzelkarte ist Dual-Slot luftgekühlt und Plug-and-Play — Bestands-Rechenzentren kommen ohne flüssigkeitsgekühlt-Umbau aus, einer der Gründe, warum die All-in-One-Appliance-Produktlinien Anfang 2025 darauf setzten (öffentliche Berichte).
Modellkompatibilität MODEL FIT
| Modell / Szenario | VRAM-Bedarf (FP8-Schätzung) | H20-Deployment (8 Karten, 768GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 Vollversion (671B) | ca. 690 GB | Acht Karten reichen aus — 96GB×8=768GB, eine der Hauptkonfigurationen der DeepSeek-Full-Power-Inferenz-Appliances Anfang 2025 (öffentliche Berichte); Reserve knapp, KV-Cache sparsam planen | 78 |
| R1-Distill 70B-Klasse | ca. 70 GB | Einzelkarte 96GB mit reichlich Reserve, entspannter als H100 (80GB grenzwertig) | 88 |
| 72B-Klasse-Open-Source-Modelle | ca. 72 GB | auf Einzelkarte deploybar, bei langem Kontext KV-Cache-Reserve einplanen | 85 |
| 7B–14B-Klasse (inkl. kleiner Video-Generierungsmodelle) | rund 8–30GB | auf Einzelkarte locker, in Serienproduktion Parallelität über mehrere Karten | 90 |
Speicherbedarf geschätzt mit FP8-Gewichten ≈ Parameterzahl × 1 Byte (Schätzung, ohne KV-Cache und Aktivierungsreserve); „passt hinein“ bezieht sich auf die Speicherkapazität, die Generierungsgeschwindigkeit leidet unter der gedrosselten Rechenleistung (Tensor-Leistung rund ein Zehntel des H100-Niveaus, Medienangaben) — Durchsatz nur aus Messungen. Der AIXX Index ist eine Schätzgröße dieser Datenbank.
Bildergalerie GALLERY
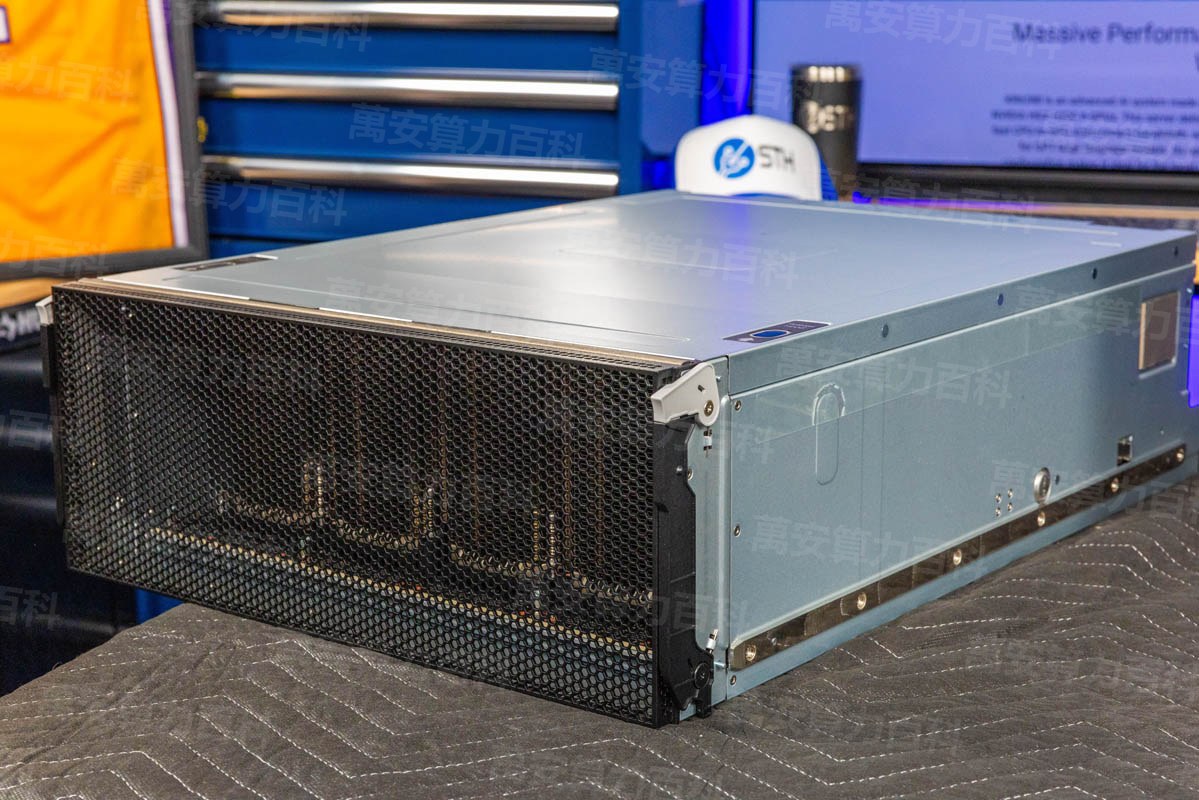
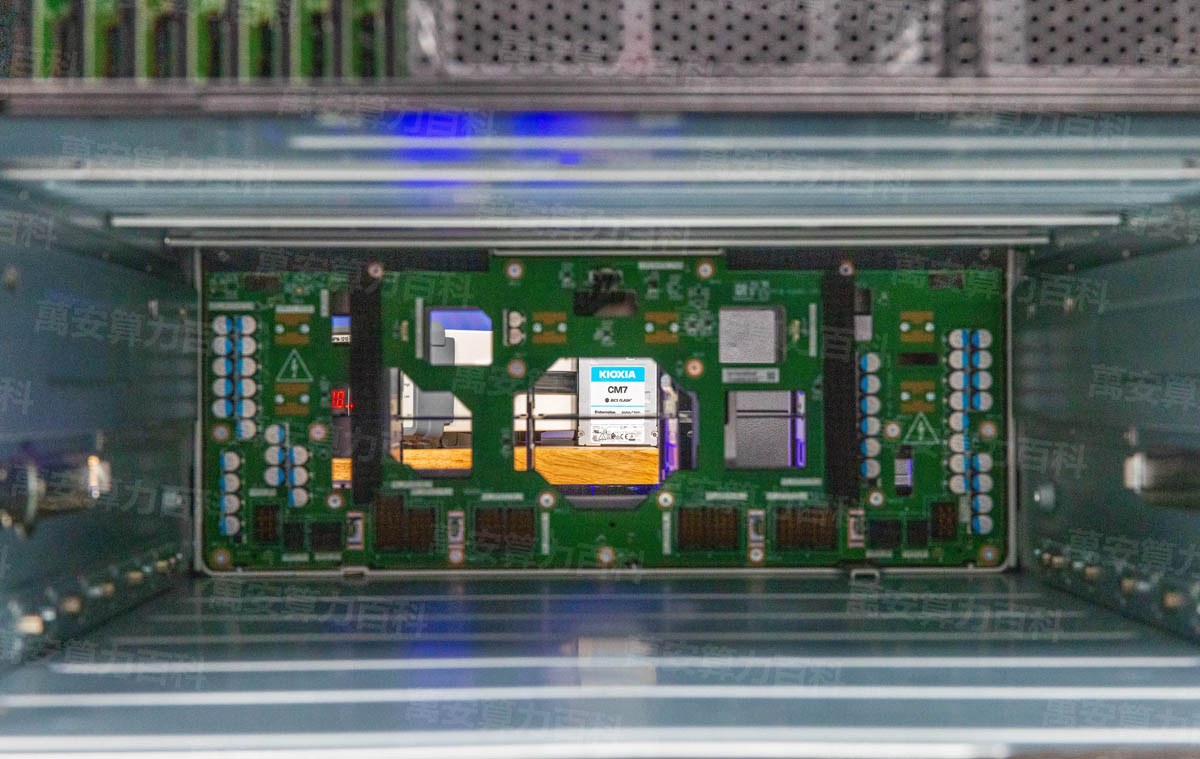
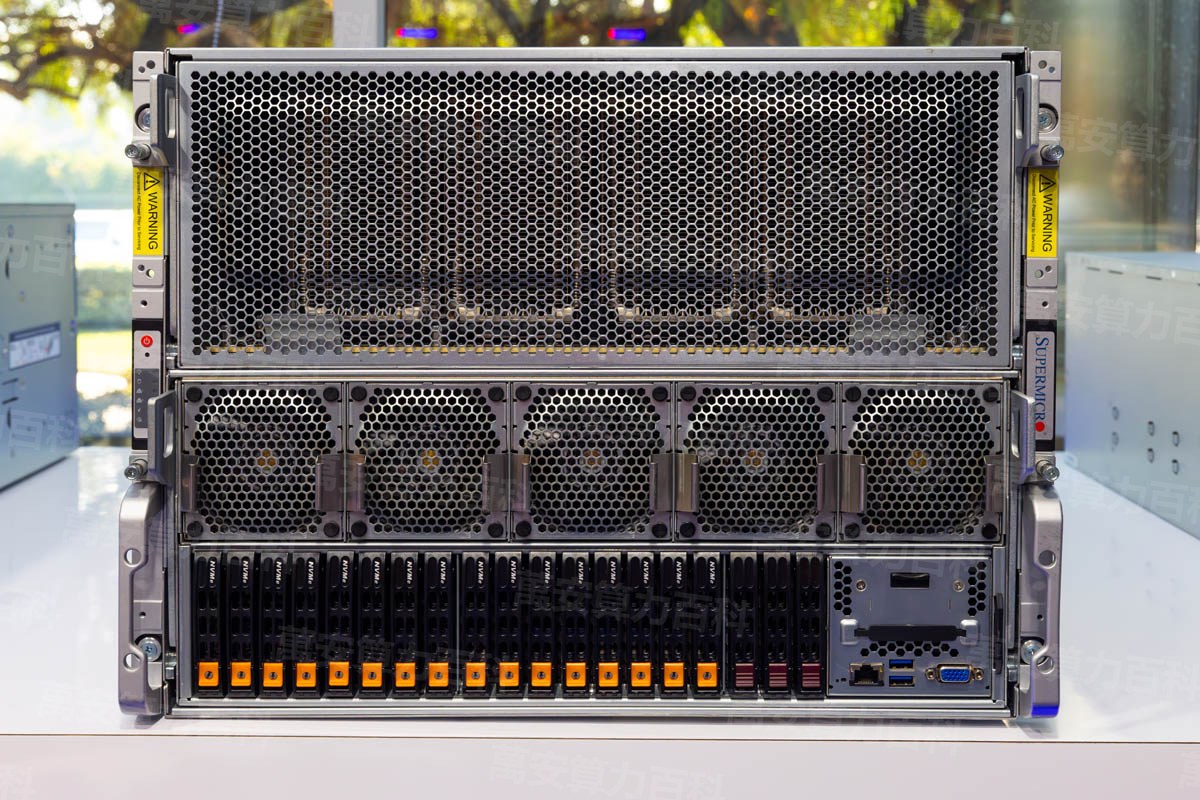
Hinweis: Das H20 ist eine Sondervariante für den chinesischen Markt, NVIDIA hat keine offizielle Produktseite, auch renommierte ausländische Hardwaremedien haben keine Praxistests — dieser Eintrag nutzt vorläufig Herstellerbilder; eigene Aufnahmen aus den Warenprüfungen dieser Datenbank werden laufend ergänzt (eigene Prüfaufnahmen sind die höchste priorisierte Bildquelle). KI-generierte Bilder geben sich nicht als Originalfotos aus; H100/H200 und H20 sehen äußerlich gleich aus (Hopper-Familie), Fotos taugen nicht als Identifikationsgrundlage (siehe „Beschaffung und Warenprüfung“).
Videoerklärung VIDEO
Praxisberichte aus der Community · Quelle Bilibili COMMUNITY
Praxisinhalte der Community stammen von Bilibili-Creatoren (klick lädt den offiziellen Bilibili-Player, direkt auf der Seite abspielbar), die Rechte liegen bei den ursprünglichen Uploadern. Das Video ist ein H20-spezifischer Referenzfall (alle Werte am H20 verankert: 96GB / 4,0TB/s / 400W / HGX NVLink 900GB/s · PCIe-Einzelkartenwerte entsprechend gekennzeichnet); Transkript und Szenentexte im Repo _wiki_work_1006/gen_tts_benchh20.py.
Community-Hardware · Quelle: YouTube COMMUNITY HANDS-ON
In einigen Regionen ist die Wiedergabe ggf. nicht möglich
Software & Ökosystem ECOSYSTEM
| Position | Anforderung / Status |
|---|---|
| CUDA / Treiber | ab Treiberreihe 535 (dokumentierte Erkennung laut offizieller H3C-Deploy-Dokumentation: NVIDIA-SMI 535.161.08 / CUDA 12.2 erkennt das H20) |
| Trainings-Frameworks | PyTorch / TensorFlow unterstützen Hopper offiziell; beim H20 ist die Rechenleistung begrenzt, Training beschränkt sich auf kleines Fine-Tuning |
| Inferenz-Engines | vLLM / SGLang / TensorRT-LLM unterstützen nativ; großer Speicher + hohe Bandbreite sind das Fundament des Inferenz-Durchsatzes |
| Netzwerkausstattung | ConnectX-7 400G oder gleichwertige Interconnect-Lösung (OEM-Standard) |
| Betriebssystem | Gängige Linux-Distributionen (Ubuntu 22.04+ etc.) |
Das H20 gehört mit H100/H200 zur Hopper-Ökosphäre, der Software-Stack ist identisch — ein „Ökosystem-Rabatt“ existiert nicht, ein „Rechenleistungs-Rabatt“ schon. Software-Stack-Versionen entwickeln sich weiter, maßgeblich sind NVIDIA-Offiziellangaben.
Beschaffung und Warenprüfung PROCUREMENT
Warenprüfung beim H20-Kauf (drei Punkte):
Vollständige Sechs-Punkte-Belastungstest-Urteile (Werte am H20 verankert) siehe Modelleintrag „Burn-in-Test“ dieses Eintrags.
Stresstests BENCH TEST
Sechs-Punkte-Testverfahren, alle Werturteile am H20 verankert: Auspacken & Erkennung → Burn-in-Test Einzelkarte (400W-Klasse luftgekühlt, ≤85 °C, null ECC = Bestanden) → Volllast gesamtes System → Speicherbandbreite (Nennwert 4,0TB/s, ≥85 % = Bestanden) → Interconnect (HGX-Knoten nccl-tests ≥750GB/s / PCIe-Einzelkarte Gen5-x16-Vollverbindung prüfen) → Inferenz-Durchsatz (≥80 % der öffentlichen Benchmarks).
nvidia-smigpu-burn 3600 oder dcgmi diag -r 3 · 30–60 MinutenbandwidthTest(CUDA-Musterbeispiele)nccl-tests all_reduce-BenchmarkvLLM Echtes Modell unter Last fahrenMethodik-Hinweis: Die Grenzwerte für „Bestanden“/„Ausgezeichnet“ wurden in dieser Bibliothek nach gängigen Ingenieursstandards zusammengestellt (Bandbreite als Anteil des Nennwerts, Temperatur nach branchenüblichen Datacenter-Limits) und werden mit zunehmenden Prübericht-Messdaten schrittweise kalibriert; diese Tabelle stellt keinerlei Abnahmeverprechen dar, maßgeblich sind die vertraglichen Vereinbarungen. Die Messpunkte der Prüfberichte dieser Bibliothek werden nach genau dieser Tabelle erfasst – NOT_EXECUTED bedeutet: Punkt nicht geprüft. Auch das „nicht getestet“ ist eine wichtige Information.
Versand & Auslieferung LOGISTICS
OEM & Varianten VENDORS
Gleiche HGX-H20-Platine, die Gesamtsysteme der Hersteller unterscheiden sich in Formfaktor, Kühlung und Service – bei der Auswahl zuerst auf die Unterschiede achten:
| Systemhersteller | Typischer Formfaktor | Unterscheidungsmerkmale | Für wen geeignet |
|---|---|---|---|
| Inspur | YuanKong NF5688G7 u. a. (HGX-Hopper-8-Karten-Modul) | Marktführend bei inländischen AI-Servern, ausgereifte Komplettgeräte-Fertigung[9] | Inlandsdeployment · Komplettgeräte-Fertigung |
| H3C | UniServer-Serie (HGX H20 8 Karten) | Vollständige offizielle Deployment-Dokumentation (H20-Erkennungsprotokolle öffentlich), tiefgestaffeltes Servicenetz[10] | Unternehmenskunden · Dokumentation und Service |
| Supermicro | HGX-H20-8-Karten-Gesamtsysteme (China-Kanal) | Hochvolumiger OEM, globaler Lieferketten-Hintergrund (laut öffentlichen Berichten) | Preis-Leistungs-orientiert · Großeinkauf |
| PCIe-Einzelkarten-Integratoren | 4U/2U 8×PCIe H20 Tower/Rack | Kein NVLink-Full-Mesh, geringe Kosten, für Inferenz-Szenarien geeignet | Inferenz-Pipelines · Budget first |
AIXX Index · Vierdimensionaler Deployment-Vergleich AIXX INDEX
| Systemhersteller | Einfache Installation | Wartungsfreundlichkeit | Leistungsdichte | Lebensdauererwartung |
|---|---|---|---|---|
| Inspur | 88 | 86 | 82 | 80 |
| H3C | 86 | 88 | 81 | 82 |
| Supermicro | 84 | 80 | 84 | 80 |
| PCIe-Einzelkarten-Integratoren | 90 | 82 | 68 | 78 |
Der AIXX Index ist eine Schätzgröße dieser Datenbank (0–100, Grundlage der Schätzung: öffentliche Formfaktoren, Kühllösung und Unterschiede im Servicenetzwerk) und wird mit verifizierten Praxistests aktualisiert; er stellt keine Kaufzusicherung dar. Maßgeblich sind die offiziellen Angaben des Herstellers zum jeweiligen Modell.
Glossarkarten GLOSSARY
Sondervariante für den chinesischen Markt
Modelle, die zur legalen Einfuhr auf das chinesische Festland unter US-Exportkontrollbestimmungen durch Lizenzschwellen reduzierte Leistung bieten. Das H20 ist die Sondervariante der Hopper-Generation (zuvor A800/H800); die Tauschlogik: Speicher/Bandbreite/Interconnect behalten, Tensor-Leistung kürzen. Alle Angaben dieser Datenbank beruhen auf öffentlichen Berichten und stellen keine Rechtsberatung dar.
96GB HBM3 · 4.0TB/s
Das Fundament des H20: Speicher und Bandbreite pro Karte liegen beide über dem H100 (80 GB / 3,35 TB/s) – die Exportkontrollen zielen auf die Rechenleistung, nicht auf den Speicher. Dies ist der seltene Fall, in dem eine Sondervariante in einem Punkt sogar stärker ist.
NVLink 4 · 900GB/s
NVLink der vierten Generation; das HGX-H20-8-Karten-Modul ist gleichauf mit H100/H200 derselben Generation und Geschwindigkeit; PCIe-Einzelkarten haben kein NVLink – bei Multi-Karten-Netzwerkanforderungen zuerst den Formfaktor klären.
HGX-H20-8-Karten-Modul
8 H20 direkt auf der Platine, durch NVSwitch voll vernetzt, zusammen 768 GB Speicher – DeepSeek R1 in voller FP8-Genauigkeit (ca. 690 GB) passt auf einen Server; genau deshalb wurden Anfang 2025 die Systeme weggekauft (Schätzung + öffentliche Berichte).
Lizenzierung / Genehmigung zur Wiederaufnahme
Im April 2025 verlangten die USA für H20-Exporte nach China eine Lizenz (NVIDIA bildete ca. 5,5 Mrd. USD ab), am 15.07.2025 wurde die Genehmigung zur Wiederaufnahme erteilt; seither schwanken Angebot und Beschaffungsumfeld mit der Politik. Chargen- und Lizenzstatus beeinflussen Garantie und Werterhalt – bei der Warenprüfung zwingend kontrollieren. Keine Rechtsberatung.
Grenzen & Kontroversen LIMITS
- Reduzierte Rechenleistung ist der größte Nachteil (ehrlich benannt) : Die FP16/FP8-Tensor-Leistung liegt bei etwa einem Zehntel des H100/H200 (laut Medienberichten[1]) – das ist der Tausch „Compliance gegen Marktzugang in China“: Inferenz bleibt unbeeinträchtigt, für Training und rechendichte Szenarien völlig ungeeignet. Es als Trainingskarte zu kaufen, ist der größte Auswahlfehler.
- Spezifikationen ohne offizielle Produktseite : NVIDIA betreibt keine offizielle H20-Produktseite, die im Umlauf befindlichen Parameterangaben sind widersprüchlich (INT8/Sparse-Angaben uneinheitlich, NVLink fälschlich mit 300 GB/s zitiert) – dieser Eintrag kennzeichnet alle Angaben als Medienberichte; bei der Warenprüfung gelten Firmware-Report und Messung.
- Unsicherer Produktlebenszyklus : Seit August 2025 wechseln sich Gerüchte über das Auslaufen der Produktion und Berichte über Nachfolger-Chips (u. a. B30A) ab; die Genehmigung des Nachfolgers ist offen (laut öffentlichen Berichten[4]) – Unsicherheit bei Langzeit-Ersatzteilen, Treiber-Support und Werterhaltungserwartung; die Datenbank trifft keine Festlegung.
- Schwankendes Beschaffungsumfeld in China : Berichte über behördliche Zurückhaltung und Sicherheitsprüfungen ab August 2025, im Dezember 2025 die Freigabe des H200 als Nachfolger – der reguläre Beschaffungsweg für das H20 in China schwankt mit der Politikevolution (neutrale Formulierung, öffentliche Berichte, keine Rechtsberatung).
- Versionsfallen bei den Angaben : Die 96-GB-HBM3-Erstversion und die ca. 148-GB-HBM3e-Aktualisierung (laut Berichten) werden gemischt gemeldet; die Preisdifferenz zwischen HGX-Gesamtsystem und PCIe-Einzelkarte ist groß – bei einem „H20-Server“-Angebot zuerst Version und Formfaktor klären.
- Hohe Preisvolatilität im Gebrauchtmarkt : Januar 2025 Kaufwelle mit ca. 100.000 RMB Anstieg pro System im Monat, April 2025 Kurzfristiger Anstieg während der Unterbrechungsgerüchte (laut öffentlichen Berichten) – die Marktlage schwankt stark mit Politikhinweisen, Angebote gelten zum jeweiligen Verkäuferpreis, siehe „Marktleiste“.
Marktlage MARKET DATA
| Datum | Kategorie | Region | Referenzpreisspanne | Anmerkung |
|---|---|---|---|---|
| 2025-02 | Kanalberichte | Festlandchina | 8-Karten-Gesamtsystem ca. 1,1 Mio. RMB/System (seit Jahresbeginn +100.000 RMB und mehr) | Laut Cailian Press[6] |
| 2025-02 | Kanalberichte | Festlandchina | Einzelkarteneinkauf ca. 110.000 RMB/Karte | Laut Cailian Press[6] |
| 2025-07 | Angebots-/Nachfrageprognose | Festlandchina | Wiederaufnahme des Verkaufs genehmigt; Anteil am HBM-Verbrauch 2025 erwartet auf 6 % steigend | TrendForce[3] |
| 2026-10-20 | AIXX Pedia Marktplatz | — | Derzeit kein H20 im Angebot | Eigene Bestandsprüfung (Familieneinträge wurden nach exaktem Modell abgeglichen); Marktschnappschüsse werden seit dem 20.10.2026 täglich erfasst, Verfügbarkeit wird automatisch eingebunden |
Hinweis zur Diagrammlage: Derzeit kein H20 in der Datenbank im Angebot, externe Ankerpreise nur vereinzelt – keine geschätzte Spanne (aus vereinzelten Zeitpunkten eine Kurve zu zeichnen hieße Daten zu erfinden, Unverifiziertes wird nicht behauptet); nach fortlaufender Erfassung der Marktschnappschüsse geht der Preistrend automatisch online (gleiche Vorgehensweise wie bei H100/H200).
Wichtige Preisereignisse MILESTONES
FAQ FAQ
Auf den Engpass schauen: Für Inferenz- und Großspeicher-Szenarien (70B-Klasse pro Karte, R1 in voller Größe auf 8 Karten) liegt das H20 mit 96 GB/4,0 TB/s über dem H100 mit 80 GB/3,35 TB/s, war zudem als konformes Modell in China erhältlich und mit 400 W leicht zu deployen; bei Training, Fine-Tuning-Beschleunigung und rechendichten Szenarien liegt die Tensor-Leistung des H20 bei etwa einem Zehntel des H100 (Medienangabe) – dann direkt H100/H200. Ein Satz: Das H20 verkauft Speicher und Marktzugang, das H100/H200 verkauft Rechenleistung.
Das H20 ist eine exportkonforme Sondervariante für den chinesischen Markt gemäß den US-Exportkontrollen: 2024 auf den Markt gekommen, im April 2025 zeitweise lizenzpflichtig, im Juli 2025 die Genehmigung zur Wiederaufnahme erteilt; seither schwanken Angebot und Beschaffungsumfeld mit der Politik (laut öffentlichen Berichten). 2026 stammt der Bestand überwiegend aus dem Umlauf im installierten Bestand, Neugeräte-Neuzufuhr steht still. Dieser Eintrag ist keine Rechtsberatung; der Compliance-Status bei Beschaffung richtet sich nach den Vorgaben der Behörden und fachkundiger Beratung.
Die Exportkontrollen zielen auf die Rechenleistung, nicht auf den Speicher – das H20 behielt 96 GB HBM3 und 4,0 TB/s Bandbreite (über dem H100 mit 80 GB / 3,35 TB/s), gekürzt wurde die Tensor-Leistung. Es ist also eine Karte, die für Inferenz geboren wurde: LLM-Inferenz frisst Speicher und Bandbreite, weniger Spitzenrechenleistung.
2024 wurde überwiegend die 96-GB-HBM3-Erstversion ausgeliefert; die ca. 148-GB-HBM3e-Aktualisierung ist Berichtslage (einzelne Quellen nennen 141–148 GB unterschiedlich). Äußerlich unterscheiden sich beide Versionen nicht; bei der Warenprüfung gelten nvidia-smi-Speichermessung und Firmware-Report, im Angebotsvertrag muss die Version verbindlich genannt sein.
Ja: 8× HGX H20 ergeben zusammen 768 GB (96 GB×8), die FP8-Vollgewichte (ca. 690 GB, Schätzung) passen – genau deshalb wurden Anfang 2025 in DeepSeek-Inferenz-Komplettgeräten massenhaft H20 verbaut (laut öffentlichen Berichten). Aber: „Passt“ heißt nicht „läuft schnell“ – der Generierungsdurchsatz leidet unter der reduzierten Rechenleistung, maßgeblich sind eigene Messungen.
Verwandte Einträge SEE ALSO
Modellvergleich und Auswahl COMPARE
Quellen REFERENCES
- MIT Technology Review China – NVIDIA nimmt H20-Verkauf in China wieder auf (96 GB HBM3 / 4,0 TB/s / FP8 296 TFLOPS / FP16 148 TFLOPS / Kerne 41 % weniger als H100) https://www.mittrchina.com/news/detail/15016
- Agentur — Bericht über kompatible NVIDIA-Chips für China (2023-12, wiedergegebene Darstellung) https://www.reuters.com/technology/
- TrendForce – H20 Export Approval Reignites Demand Momentum (HBM3 8-Hi der 2024er-Charge / HBM3e-Upgradplan / 2025-04 ca. 2,5 Mrd. USD nicht auslieferbar / Wiederaufnahme der Exporte am 15.07.2025) https://www.trendforce.com/presscenter/news/20250716-12644.h…
- CNBC — Nvidia still hasn't sold its U.S.-approved China AI chips(2026-02-26) https://www.cnbc.com/2026/02/26/nvidia-china-chip-sales-expo…
- MyDrivers/Sina Finance – H200 verkaufbar, aber HBM3E weiter verboten (2025-12-11, Bestätigung der H200-Nachfolge) https://finance.sina.com.cn/tech/discovery/2025-12-12/doc-in…
- Cailian Press – 100.000 RMB teurer als vor Jahresfrist! H20 wird zum „Liebling der Big Techs“ (2025-02, 8-Karten-System ca. 1,1 Mio. RMB, Einzelkarte ca. 110.000 RMB) https://www.cls.cn/detail/1956679
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (maßgebliches Archiv zur Chronologie der Exportkontrollen) https://www.congress.gov/crs-product/R48642
- Los Angeles Times — Nvidia's AI chip sales in China stall as local chipmakers like Huawei take lead(2026-06-29) https://www.latimes.com/business/story/2026-06-29/
- Inspur – YuanKong NF5688G7 AI-Server-Produktseite (HGX-Hopper-8-GPU-Modul; Quelle der Systemabbilder dieses Eintrags) https://www.ieisystem.com/product/ai/15080.html
- H3C – H20-Deployment-Dokumentation (NVIDIA-SMI 535.161.08 / CUDA 12.2, Erkennungsprotokolle eines realen Systems) https://www.h3c.com
- Tom's Hardware – Nvidia responds to reports that its H20 GPU for China is ending production (Bericht über ausstehende B30A-Freigabe) https://www.tomshardware.com/tech-industry/artificial-intell…
- Nvidia working on new AI chip for China that outperforms H20(2025-08-19) https://www.reuters.com/technology/nvidia-working-new-ai-chi…
- GPU Database – NVIDIA H20 (9984 CUDA / 60 MB L2 / 400 W Angabe) https://www.techpowerup.com/gpu-specs/nvidia-h20.c4184.html
- Marktleistendaten – AIXX Exchange (Angebote der Plattform und erfragte Kanalspannen, täglich aktualisiert; für H20 aktuell 0 Angebote, so dokumentiert) https://www.aixx.vip/hall.html