AIXX Pedia › Ficha de modelo › H100

H100
Visão geral OVERVIEW
H100 (nome completo NVIDIA H100, pertence à série "Hopper") é uma GPU de data center anunciada pela NVIDIA na 22 de março de 2022 na GTC e confirmada em produção em setembro de 2022 (envios a partir de outubro): obra inaugural da geração Hopper, a primeira GPU a integrar a Transformer Engine (estreia da precisão FP8), memória HBM3 e PCIe Gen5[1][2]。
É a placa que "alavanca a era dos grandes modelos": após o ChatGPT detonar a corrida armamentista global por poder computacional, a H100 chegou a ser a unidade mais cobiçada de capacidade de IA do mundo e, devido às restrições de exportação para a China, tornou-se um símbolo da disputa de chips entre EUA e China (ver "Histórico" e "Limitações e controvérsias").
No mercado spot de 2026, o papel da H100 é base de volume : o poder computacional continua em plena força na geração Hopper, com o ecossistema mais maduro e a demanda de aluguel em recuperação em 2025-2026 (segundo índices públicos[7][8]), mas o limite rígido de 80GB de memória vem sendo pressionado a cada geração pela H200 (141GB) e pela B300 (288GB) — antes de comprá-la, confirme que seu gargalo não é a memória.
Cenários de uso FIT
AIXX Index (0–100): esta base estima com pesos baseados em especificações públicas — memória de vídeo 40% + interconexão 30% + ecossistema 30%, com pesos ajustados por cenário. 90+ nível flagship · 75+ Excelente · 60+ utilizável · abaixo de 60 não recomendado. Metodologia transparente e verificável, não constitui promessa de desempenho.
Histórico HISTORY
22 de março de 2022 a GTC apresenta a arquitetura Hopper e a H100: 80 bilhões de transistores, processo customizado TSMC 4N; a Transformer Engine traz o FP8 pela primeira vez à sequência principal de precisão da GPU, que também é a primeira com HBM3 + PCIe Gen5[2][3]。
20 de setembro de 2022 keynote de outono da GTC confirma a produção e anuncia envios a partir de outubro[4]; 21 de março de 2023 DGX H100 entra em produção disponível para pedidos, primeira unidade entregue à OpenAI[5]ao longo do ano seguinte, a H100 torna-se a força absoluta da expansão global de capacidade de IA.
7 de outubro de 2022 o controle de exportação dos EUA submete a H100 a licenciamento para a China; a NVIDIA lança sucessivamente as variantes exclusivas para o mercado chinês A800/H800 (final de 2022) e a linha H20 (entregue em 2024) para manter o fornecimento, interrompido várias vezes com o endurecimento das restrições em out/2023 e o licenciamento da H20 em abr/2025[6]. A H100 em si nunca retornou à lista aprovada para a China — em dezembro de 2025, a H200 foi a aprovada[9]。
2025-2026 a H100 entra na fase de "base instalada": H200/B300 entram em operação por geração e dividem as novas aquisições, mas a demanda de inferência volta a empurrar os preços de aluguel para cima — índice de aluguel sobe cerca de 10% entre dez/2025 e jan/2026[7]em abril de 2026, contratos anuais superam $2/GPU·h (análises públicas[8]), e no mercado spot continua sendo o modelo Hopper de maior volume.
Especificações técnicas SPECIFICATIONS
| Item | Especificações (H100 SXM · dados oficiais) |
|---|---|
| Núcleo da GPU | NVIDIA Hopper GH100(SXM5) |
| Memória de vídeo por placa | 80GB HBM3 |
| Largura de banda de memória | 3,35TB/s / placa |
| FP8 Tensor Core | 3.958 TFLOPS (com esparsidade) |
| FP16 / BF16 Tensor Core | 1.979 TFLOPS (com esparsidade) |
| TF32 Tensor Core | 989 TFLOPS (com esparsidade) |
| FP64 / FP64 Tensor | 34 / 67 TFLOPS |
| Interconexão GPU-GPU | NVLink de quarta geração · 900GB/s + malha completa NVSwitch |
| Consumo da placa (TBP/TGP) | Até 700W (configurável; versão PCIe 350W / versão NVL 350-400W) |
| Formato principal de máquina completa | Plataforma HGX H100 de 8 placas (refrigerado a ar / refrigerado a líquido) · DGX H100 |
| Geração anterior / produto equivalente | A100 80GB(Ampere)/ H200、B300 |
As especificações seguem os dados oficiais públicos da NVIDIA[1]; toda a capacidade Tensor segue o critério oficial "com esparsidade", metade em modo dense; as configurações variam conforme OEM e lote.
Comparação geracional · quatro gerações lado a lado GENERATIONS
| Item | A100 80GB | H100 80GB | H200 | B300 |
|---|---|---|---|---|
| Memória de vídeo por placa | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| Largura de banda de memória | Cerca de 2TB/s | 3.35TB/s | 4.8TB/s | Cerca de 8TB/s |
| Precisão marcante | FP16 | FP8(Transformer Engine) | FP8 | FP4 |
| Interconexão GPU-GPU | NVLink 3 · 600GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| Recomendação em uma frase | Continuidade do parque instalado | Orçamento limitado · maior ecossistema | Grande memória · força de volume | Compra flagship · próxima geração |
Especificações conforme material público oficial da NVIDIA; colunas A100/H200/B300 detalhadas nas respectivas fichas comparativas.
Membros da família FAMILY
A família H100 divide-se em quatro variantes por encapsulamento e formato; no mercado spot da China continental e global, predomina o servidor HGX de 8 placas (à venda nesta base: HGX H100 8 da Supermicro / Dell / H3C / Gigabyte):
Refrigeração e implantação COOLING
A H100 predomina na forma refrigerado a ar, HGX de 8 placas : a solução de torre de dissipação para SXM5 de classe 700W está madura e pode ser implantada em data centers existentes — uma das razões de continuar sendo a "capacidade computacional de menor barreira de adaptação". As variantes refrigerado a líquido expandiram a partir de 2023 com projetos de alta densidade (como o servidor completo refrigerado a líquido Supermicro SYS-821GE-TNHR[12]), enquanto a versão H100 PCIe é uma placa dual-slot de 350W refrigerado a ar, sem malha completa via baseboard.


Compatibilidade de modelos MODEL FIT
| Modelo / cenário | Necessidade de memória (estimativa FP8) | Deploy na H100 (8 placas, 640GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 completo (671B) | Cerca de 690GB | Oito placas não comportam — requer quantização INT4 (cerca de 350GB, cabe) ou deploy multi-servidor; para R1 completo em um servidor, veja H200/B300 | 41 |
| R1-Distill nível 70B | Cerca de 70GB | Cabe em uma placa de 80GB, com folga apertada (KV cache exige ajuste fino) | 82 |
| Modelos open-source nível 72B | Cerca de 72GB | Limite de uma placa; na prática, usa-se paralelismo de tensor em duas placas | 75 |
| Nível 7B-14B (incluindo pequenos modelos de geração de vídeo) | Cerca de 8-30GB | Uma placa com folga; linhas de produção em lote empilham concorrência com múltiplas placas | 90 |
Memória estimada por pesos FP8 ≈ parâmetros × 1 byte (estimativa, sem KV cache nem margem de ativação); o AIXX Index segue o critério de estimativa desta base, atualizado com medições. Deploy de nível 70B em placa única é caso-limite; prevalecem os testes reais.
Galeria GALLERY


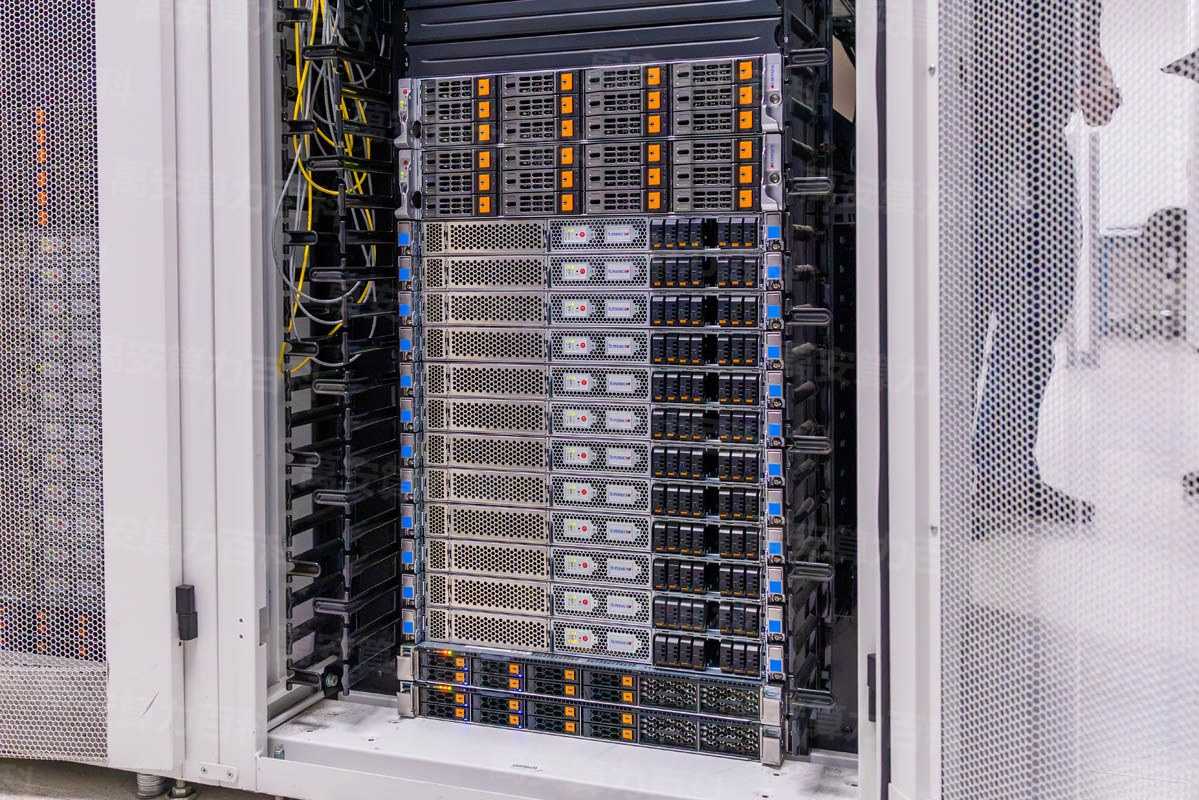
Fotos reais continuam sendo adicionadas conforme os lotes de inspeção; imagens geradas por IA não são apresentadas como fotos reais.
Vídeo explicativo VIDEO
Este vídeo é o roteiro geral dos seis testes (critérios independentes do modelo); a versão dedicada à H100 está na fila de produção e, quando publicada, substituirá este com capa de âncora real da H100.
Máquina real da comunidade · fonte: YouTube COMMUNITY HANDS-ON
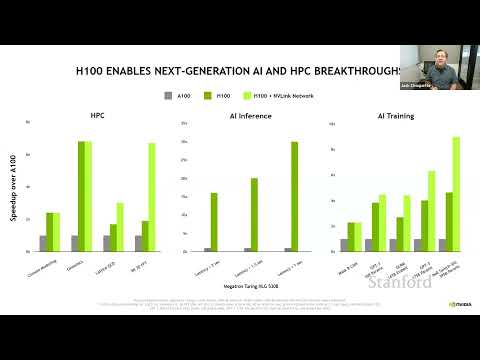
Em algumas regiões pode não ser possível reproduzir diretamente
Software e ecossistema ECOSYSTEM
| Item | Requisitos / situação atual |
|---|---|
| CUDA | Suporte a Hopper a partir da 11.8 (versão de estreia), cobertura total na 12.x atual |
| Driver | A partir da série 520 (estreia), atual 550 ou superior |
| Framework de treino | PyTorch / TensorFlow suportam oficialmente Hopper, o ecossistema mais maduro |
| Motores de inferência | vLLM / SGLang / TensorRT-LLM têm a H100 como modelo de referência de suporte |
| Infraestrutura de rede | ConnectX-7 400G ou solução de interconexão equivalente |
| Sistema operacional | Distribuições Linux mainstream (Ubuntu 22.04+, etc.) |
O ecossistema Hopper, maduro após mais de três anos, serve de base à grande maioria dos benchmarks públicos de otimização de inferência; as versões da stack de software evoluem com o tempo, prevalecendo os lançamentos oficiais da NVIDIA.
Aquisição e inspeção PROCUREMENT
Três pontos de inspeção na compra de uma H100:
Os seis critérios completos de teste (valores ancorados na H100 real) estão na seção "Como testar" desta ficha.
Como fazer stress test BENCH TEST
Seis critérios de teste, todos os valores ancorados na H100 real: identificação na abertura → Teste de burn-in de placa única (torre refrigerado a ar 700W, ≤85℃ sem erros ECC = Aprovado) → carga máxima do servidor → largura de banda de memória (nominal 3,35TB/s, ≥85% = Aprovado) → largura de banda de interconexão (nccl-tests ≥750GB/s, nominal 900GB/s) → throughput de inferência (≥80% do benchmark público).
nvidia-smigpu-burn 3600 ou dcgmi diag -r 3 · 30–60 minutosbandwidthTest(exemplo nativo do CUDA)nccl-tests benchmark all_reducevLLM rodar um modelo real com cargaNota metodológica: as linhas de Aprovado/Excelente foram compiladas por este banco segundo critérios de engenharia usuais (largura de banda como proporção do valor nominal, temperatura no limite comum para data centers) e serão calibradas progressivamente com dados medidos dos relatórios de inspeção; esta tabela não constitui qualquer compromisso de aceitação, prevalecendo o acordado em contrato. Os itens medidos no relatório de inspeção deste banco são registrados conforme esta tabela — NOT_EXECUTED indica que o item não foi executado, e o próprio «não testado» também é informação relevante.
Transporte e entrega LOGISTICS
OEM e variantes VENDORS
Na mesma base HGX H100, os sistemas completos de cada fabricante diferem em formato, refrigeração e serviços — na escolha, comece pelas diferenças (esta base cobre quatro deles):
| Fabricante | Formato representativo | Diferenciais | Para quem |
|---|---|---|---|
| Supermicro | Sistema HGX H100 8 (refrigerado a ar / refrigerado a líquido) | O carro-chefe de volume; o modelo refrigerado a líquido conta com avaliação completa da mídia especializada[12] | Compra à pronta-entrega · foco em custo-benefício |
| Dell | Linha PowerEdge (HGX H100 8) | Rede de serviços global de primeira linha e suporte corporativo | Implantação multinacional · foco em serviços |
| H3C AIXX | Sistema HGX H100 8 | Rede de serviços e entrega local, frequente em projetos da Ásia-Pacífico | Canal Ásia-Pacífico · serviços locais |
| Gigabyte | Sistema HGX H100 8 | Configuração flexível, forte presença no canal da Ásia-Pacífico | Compras via canal Ásia-Pacífico |
| Oficial NVIDIA | DGX H100 (sistema de 8 GPUs) | Entrega integrada oficial, stack completo de software com respaldo do fabricante; a primeira unidade foi entregue à OpenAI[5] | Treino pronto para uso · suporte do fabricante |
AIXX Index · comparação de implantação em quatro dimensões AIXX INDEX
| Fabricante | Facilidade de instalação | Facilidade de manutenção | Densidade de desempenho | Expectativa de vida útil |
|---|---|---|---|---|
| Supermicro | 88 | 84 | 84 | 80 |
| Dell | 90 | 92 | 84 | 85 |
| H3C AIXX | 86 | 84 | 83 | 82 |
| Gigabyte | 85 | 80 | 85 | 80 |
| Oficial NVIDIA | 92 | 88 | 82 | 85 |
O AIXX Index é uma estimativa desta base (0–100, calculada com base em formato público, solução de refrigeração e diferenças na rede de serviços), atualizada conforme verificação em unidades reais, e não constitui compromisso de compra. Os modelos específicos prevalecem conforme o anúncio oficial do fabricante.
Cartões de terminologia GLOSSARY
Memória HBM3
Memória de alta largura de banda empilhada ao lado da GPU. Cada H100 traz 80GB de HBM3 com 3.35TB/s — a migração para HBM3e só veio com a geração H200. A capacidade de memória é hoje a maior limitação do H100 na escolha de compra.
Interconexão NVLink 4
Quarta geração do NVLink, com 900GB/s diretos por GPU; combinado com NVSwitch, faz as oito GPUs trabalharem como uma só. H100 e H200 são da mesma geração e mesma velocidade.
Empacotamento SXM5 onboard
As GPUs são soldadas diretamente na base (não em placas avulsas); a base de 8 GPUs do HGX H100 é justamente o formato SXM5. Na inspeção, verifique a base junto. A contraparte em placa é a versão PCIe (350W, HBM2e).
Transformer Engine / FP8
Motor de precisão mista que estreou no H100, consolidando o ponto flutuante de 8 bits como precisão dominante em treino e inferência; estimativa de memória: pesos em FP8 ≈ nº de parâmetros × 1 byte.
Controles de exportação e lotes de conformidade
O H100 entrou nos controles de exportação dos EUA em outubro de 2022; as variantes exclusivas para o mercado chinês (A800/H800/H20) são modelos ajustados derivados desses controles. Lote e rota aduaneira afetam garantia e valorização — checagem obrigatória na inspeção. As informações desta base refletem reportagens públicas e não constituem parecer jurídico.
Novidades e eventos relacionados TIMELINE
Limitações e controvérsias LIMITS
- Limite rígido de memória : 80GB HBM3 / 3.35TB/s, amplamente superado pelo H200 (141GB / 4.8TB/s) — o R1 da DeepSeek em FP8 completo exige cerca de 690GB, e as 8 GPUs do H100, com 640GB, não comportam (estimativa; ver "Adequação de modelos"). Essa é a razão de fundo que separa o H100 de seus sucessores na escolha de compra.
- Protagonista dos controles de exportação para a China : incluído no primeiro lote de controles em outubro de 2022; desde então, as variantes exclusivas para o mercado chinês (A800/H800/H20) foram ajustadas várias vezes conforme a política. O H100 em si nunca voltou à lista de aprovações para a China (o aprovado em dezembro de 2025 foi o H200) — sem venda pública em canais regulares da China continental; o mercado de spot circula por canais cinza[6][9]. Esta base registra apenas reportagens públicas e não constitui parecer jurídico.
- Pressão da geração Blackwell : o B300, com 288GB de HBM3e, precisão FP4 e NVLink 5 (1.8TB/s), abre dois degraus de geração em precisão, e a participação do H100 nas novas aquisições de computação segue sendo substituída.
- Risco de lacunas entre versões : a diferença de desempenho entre a versão PCIe (HBM2e / 2TB/s / 350W / sem interconexão total via NVSwitch) e a versão SXM é grande; as cotações de "H100 barato" costumam ser da versão PCIe — cotação e inspeção devem primeiro esclarecer o formato de empacotamento.
- Risco de refurbish e falsificação : H100 e H200 são visualmente muito parecidos, e casos de "H100 vendido como H200" já foram registrados no mercado spot (segundo relatos de inspetores); validar o número de série por canal independente + medição real da memória são etapas indispensáveis.
- Debate sobre a geração de computação : coexistem a tese do "H100 ultrapassado" e a do "H100 que se valoriza" — o repique dos preços de aluguel em 2025–2026 (segundo índices públicos[7]) sustenta a segunda; a curva de substituição pelo Blackwell sustenta a primeira. Esta base não toma posição; os dados estão na "Faixa de mercado".
Faixa de mercado MARKET DATA
| Data | Critério | Região | Faixa de preço de referência | Observação |
|---|---|---|---|---|
| 2026-10-20 | Salão em tempo real | EUA (USD) | $1,87 mi – 1,87 mi | 1 cotação › (critério de oferta por lote) |
| 2026-10-20 | Salão em tempo real | China continental | ¥50,24 mi – 50,24 mi | 1 cotação › (critério de oferta por lote) |
| 2026-10-20 | Salão em tempo real | Singapura (SGD) | S$3,60 mi – 4,14 mi | 3 cotações (critério de oferta por lote) |
| 2026-10-20 | Salão em tempo real | Oriente Médio (AED) | AED 3,60 mi – 3,60 mi | 1 cotação (critério de oferta por lote) |
| 2026-10-20 | Salão em tempo real | Europa (EUR) | €2,91 mi – 2,91 mi | 1 cotação (critério de oferta por lote) |
| 2026-10-20 | Salão em tempo real | Japão (JPY) | JPY 3,73 mi – 3,73 mi | 1 cotação (critério de oferta por lote) |
| 2026-10 | Referência de canal | Global | Cartão novo a ~US$ 31 mil / GPU | Critério de agregação de cotações públicas[10] · Sistemas à venda › |
| 2026-04 | Mercado de aluguel | Nuvem na América do Norte | Contrato anual >$2 / GPU·hora (+40%) | Critério de análises públicas[8] |
| 2026-01 | Mercado de aluguel | Global | Índice de aluguel +10% em um mês | Índice de aluguel da Silicon Data[7] |
| 2026-10 | Critério de política | China continental | Sem venda pública aprovada | O H100 não está na lista de aprovações para a China; o mercado spot circula por canais cinza (critério de reportagens públicas, sem caráter de parecer jurídico) |
Critério: a América do Norte é uma estimativa — ancorada nos preços públicos de sistemas completos de US$ 280–350 mil/unidade no início das entregas de 2023 e projetada a partir daí; em 10/2026, ancorada na medição real à venda do dia, US$ 1,874 mi/unidade (1 cotação), com interpolação suave no trecho central e substituição ponto a ponto conforme os retratos diários se acumulam; China continental/Singapura/Europa/Japão/Oriente Médio usam retratos reais à venda (CNY 5,024 mi/unidade · 1 cotação · SGD 3,604–4,142 mi · 3 cotações · EUR 2,915 mi / JPY 3,734 mi / AED 3,601 mi, 1 cotação cada), todos em moeda original, sem conversão mútua. Fonte dos dados de preço desta base: AIXX Exchange de Cálculo (Intermediação sem comissão, sem participação nas transações; não detém nem especula preços de fechamento, daí a neutralidade dos dados). A faixa estimada serve apenas como referência de tendência; o preço real está sujeito à cotação do vendedor.
Marcos históricos de preço MILESTONES
Perguntas frequentes FAQ
Depende do gargalo: para quem é sensível a orçamento, roda inferência e fine-tuning de até ~70B ou cenários HPC/FP64, o H100 segue como a base de maior ecossistema e maior estoque do mercado spot — e os preços de aluguel até repicaram em 2025–2026 (critério de índices públicos). Mas 80GB de memória é um limite duro para modelos de dezenas/centenas de bilhões de parâmetros — se o gargalo é memória, vá direto ao H200.
Computação empatada, interconexão da mesma geração (NVLink 4 · 900GB/s); a diferença está toda na memória: 80GB HBM3 / 3.35TB/s contra 141GB HBM3e / 4.8TB/s; 8 GPUs somam 640GB contra 1,128TB — o R1 em FP8 completo (~690GB) não cabe no H100, mas roda em uma única máquina com H200. Em resumo: o H200 vende memória; o H100 vende orçamento.
O H100 entrou nos controles de exportação dos EUA para a China em outubro de 2022; o aprovado em dezembro de 2025 foi o H200, e o H100 ficou de fora. Não há venda pública em canais regulares da China continental; o mercado spot circula por canais cinza. Esta informação reflete reportagens públicas e não constitui parecer jurídico; antes de comprar, prevalecem as políticas das autoridades competentes e pareceres profissionais de conformidade.
As duas gerações são visualmente muito parecidas, e fotos não bastam: confira a serigrafia e os relatórios oficiais de firmware, valide o número de série por canal independente e feche com uma medição real da memória — 80GB ou 141GB aparece na hora (ver "Compra e inspeção" e "Como fazer stress test").
Versão SXM: 700W, HBM3 a 3.35TB/s, interconexão total via NVSwitch, formato dominante dos sistemas HGX de 8 GPUs; versão PCIe: 350W, HBM2e a 2TB/s, sem interconexão de alta velocidade se não houver ponte dupla. Os "H100 baratos" costumam ser PCIe; cotação e contrato devem especificar o empacotamento.
Entradas relacionadas SEE ALSO
Comparação e escolha de modelos COMPARE
Referências REFERENCES
- Site oficial da NVIDIA — página do produto H100 (arquivo de especificações, verificado em 10/2026) https://www.nvidia.com/en-us/data-center/h100/
- Tom's Hardware — Nvidia Reveals Hopper H100 GPU With 80 Billion Transistors (cobertura do GTC, 03/2022) https://www.tomshardware.com
- Nvidia Launches Hopper H100 GPU, New DGXs and More(2022-03-22) https://www.hpcwire.com
- CRN — Nvidia H100 GPUs In Full Production, Shipping In October(2022-09-20 keynote) https://www.crn.com/news/components-peripherals/nvidia-h100-…
- Relações com investidores da NVIDIA — NVIDIA Hopper GPUs Expand Reach as Demand for AI Grows (21/03/2023, produção do DGX H100 / primeira unidade à OpenAI) https://investor.nvidia.com/news/press-release-details/2023/…
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (Linha do tempo dos controles de exportação para a China) https://www.congress.gov/crs-product/R48642
- Silicon Data — índice de aluguel do H100 +10% (09/01/2026) https://www.silicondata.com
- Aluguel do H100 +40%, contrato anual supera $2/GPU·hora (04/2026, critério de reportagem) https://semianalysis.com
- H200 aprovado para a China; preço de canal de módulo em torno de ¥1,4 mi/módulo (24/12/2025, mesma referência do verbete H200 [2])
- Agregador de cotações de canal — H100 novo a ~US$ 31.000/GPU (critério de 2026) https://benchgecko.ai
- Checking out the NVIDIA H100 in Our First Look at Hopper (fotos reais do módulo) https://www.servethehome.com/checking-out-the-nvidia-h100-in…
- A Look at the Liquid Cooled Supermicro SYS-821GE-TNHR 8x NVIDIA H100 AI Server (fotos reais do sistema refrigerado a líquido) https://www.servethehome.com/a-look-at-the-liquid-cooled-sup…
- Faixa de cotações com dados — AIXX Exchange de Cálculo (preços à venda nesta plataforma e faixas conhecidas via canais, atualizado diariamente) /hall.html