
H100
개요OVERVIEW
H100(정식 명칭 NVIDIA H100, 「Hopper」 시리즈 소속) NVIDIA가 2022년 3월 22일GTC에서 발표하고 2022년 9월 양산을 공식화(10월부터 출하)한 데이터센터 GPU: Hopper 세대의 개막작으로, Transformer Engine(FP8 정밀도 최초 탑재)을 첫 선보이고 HBM3 메모리와 PCIe Gen5를 최초로 채용한 GPU이다.[1][2]。
대규모 모델 시대를 여는 계기가 된 카드: ChatGPT가 전 세계 연산 경쟁을 촉발한 뒤 H100은 한때 가장 희소한 AI 연산 단위가 되었으며, 대중국 수출 통제로 인해 미중 반도체 갈등의 상징적 모델이기도 하다(「연혁」 및 «한계와 논란» 참조).
2026년 현물 시장에서 H100의 역할은물량 기반이다: 연산 성능은 여전히 풀 스펙 Hopper, 생태계는 가장 성숙했고 임대 수요는 2025-2026년 오히려 회복세(공개 지수 기준[7][8])를 보이지만, 80GB라는 메모리 상한은 H200(141GB)과 B300(288GB)에 세대마다 가격을 눌리고 있다 — 구매 전 자신의 병목이 메모리가 아닌지 먼저 확인하라.
적용 시나리오FIT
AIXX Index(0–100): 본 라이브러리는 공개 사양 기반 가중 산출——메모리 40% + 인터커넥트 30% + 에코시스템 30%, 시나리오별 가중치 조정. 90+ 플래그십급 · 75+ 우수 · 60+ 사용 가능 · 60 미만 부적합. 방법론이 투명하고 검증 가능하며, 성능 보장은 아니다.
연혁HISTORY
2022년 3월 22일, GTC에서 Hopper 아키텍처와 H100 발표: 800억 트랜지스터, TSMC 4N 커스텀 공정, Transformer Engine으로 FP8이 처음으로 GPU 주력 정밀도 체계에 진입했으며 HBM3 + PCIe Gen5를 최초로 채용한 GPU[2][3]。
2022년 9월 20일GTC 가을 키노트에서 양산 공식화 및 10월부터 출하 발표[4];2023년 3월 21일DGX H100 양산 수주 가능, 최초 대량 납품처는 OpenAI[5], 이후 1년간 H100은 전 세계 AI 연산 확장의 절대 주력이 되었다.
2022년 10월 7일, 미국 수출 통제로 H100이 대중국 허가 관리 대상에 편입; NVIDIA는 A800/H800 특화 모델(2022년 말), H20 특화 라인(2024년 출하)을 잇달아 내놓으며 대중국 공급을 이어갔으나 2023년 10월 통제 강화와 2025년 4월 H20 허가 관리로 수차례 공급이 중단[6]. H100 본체는 끝내 대중국 승인 목록에 복귀하지 못했다 — 2025년 12월 대중국 승인된 것은 H200이다.[9]。
2025-2026년, H100은 «기존 보유 기반» 단계에 진입: H200/B300이 세대마다 상륙해 신규 수요를 나눠 가지만, 추론 수요가 임대가를 다시 끌어올렸다 — 임대가 지수 2025년 12월~2026년 1월 약 10% 상승[7], 2026년 4월 1년 계약 임대가 $2/GPU·시 돌파(공개 분석 기준[8]), 현물 시장에서는 여전히 물량이 가장 많은 Hopper 모델이다.
기술 사양SPECIFICATIONS
| 항목 | 스펙 (H100 SXM · 공식 기준) |
|---|---|
| GPU 코어 | NVIDIA Hopper GH100(SXM5) |
| 보드당 메모리 | 80GB HBM3 |
| 메모리 대역폭 | 3.35TB/s / 카드 |
| FP8 Tensor Core | 3,958 TFLOPS (스파스 기준) |
| FP16 / BF16 Tensor Core | 1,979 TFLOPS (스파스 기준) |
| TF32 Tensor Core | 989 TFLOPS (스파스 기준) |
| FP64 / FP64 Tensor | 34 / 67 TFLOPS |
| GPU 간 인터커넥트 | NVLink 4세대 · 900GB/s + NVSwitch 풀 인터커넥트 |
| 보드 소비 전력(TBP/TGP) | 최대 700W (구성 가능; PCIe 버전 350W / NVL 버전 350-400W) |
| 주류 시스템 형태 | HGX H100 8카드 베이스보드 (공랭 / 수랭) · DGX H100 |
| 전 세대 / 경쟁 제품 | A100 80GB(Ampere)/ H200、B300 |
사양은 NVIDIA 공식 공개 자료 기준[1];전체 Tensor 연산력은 공식「스파스 포함」기준이며, dense 기준은 절반입니다;완제품 구성은 OEM 및 생산배치에 따라 차이가 있습니다.
세대 대조 · 4세대 한눈에 보기GENERATIONS
| 항목 | A100 80GB | H100 80GB | H200 | B300 |
|---|---|---|---|---|
| 보드당 메모리 | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| 메모리 대역폭 | 약 2TB/s | 3.35TB/s | 4.8TB/s | 약 8TB/s |
| 대표 정밀도 | FP16 | FP8(Transformer Engine) | FP8 | FP4 |
| GPU 간 인터커넥트 | NVLink 3 · 600GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| 선택 한 줄 요약 | 기존 보유 연계 | 예산 한계 · 최대 생태계 | 대용량 메모리 · 물량 주력 | 플래그십 신규 구매 · 차세대 |
스펙은 NVIDIA 공식 공개 자료 기준; A100/H200/B300 열의 상세는 각 항목 대조 참조.
패밀리 라인업FAMILY
H100 패밀리는 패키징과 폼팩터에 따라 4개 라인으로 나뉘며, 대만 및 글로벌 현물 시장은 HGX 8카드 시스템이 주력이다(본 라이브러리 판매 품목은 Supermicro / Dell / H3C / Gigabyte 4개사의 HGX H100 8):
냉각 및 배치COOLING
H100의 주류는공랭 HGX 8카드 폼팩터: 700W급 SXM5 히트싱크 솔루션이 성숙해 기존 서버룸에 바로 배치 가능하며, 이것이 지금까지도 «개조 진입장벽이 가장 낮은 연산 자원»인 이유 중 하나다. 수랭 변형은 2023년부터 고밀도 프로젝트와 함께 확산되었고(예: Supermicro SYS-821GE-TNHR 수랭 시스템[12]), H100 PCIe 버전은 350W 듀얼슬롯 공랭 확장카드로 베이스보드 없는 풀 인터커넥트가 없다.


모델 호환성MODEL FIT
| 모델 / 시나리오 | 메모리 수요 (FP8 추정) | H100 배포 (8카드 640GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 풀 스펙 (671B) | 약 690GB | 8카드로 수용 불가 — INT4 양자화 필요(약 350GB로 수용 가능)하거나 멀티노드 배포 필요; 풀 스펙 단일 서버는 H200/B300 참조 | 41 |
| R1-Distill 70B급 | 약 70GB | 단일 카드 80GB 배포 가능하나 여유 부족 (KV cache 정밀 설계 필요) | 82 |
| 72B급 오픈소스 모델 | 약 72GB | 단일 카드 한계선, 실무에서는 대부분 듀얼카드 텐서 병렬 채용 | 75 |
| 7B-14B급 (영상 생성 소형 모델 포함) | 약 8-30GB | 단일 카드 여유, 대량 파이프라인은 멀티카드로 동시성 확보 | 90 |
VRAM은 FP8 가중치 ≈ 파라미터 수 × 1바이트로 추정(추산 기준, KV 캐시 및 활성화 여유 미포함);AIXX 지수는 본 라이브러리의 추산 기준이며 실측에 따라 갱신됩니다. 70B급 싱글카드 배포는 한계 상황이므로 실측을 기준으로 합니다.
갤러리GALLERY


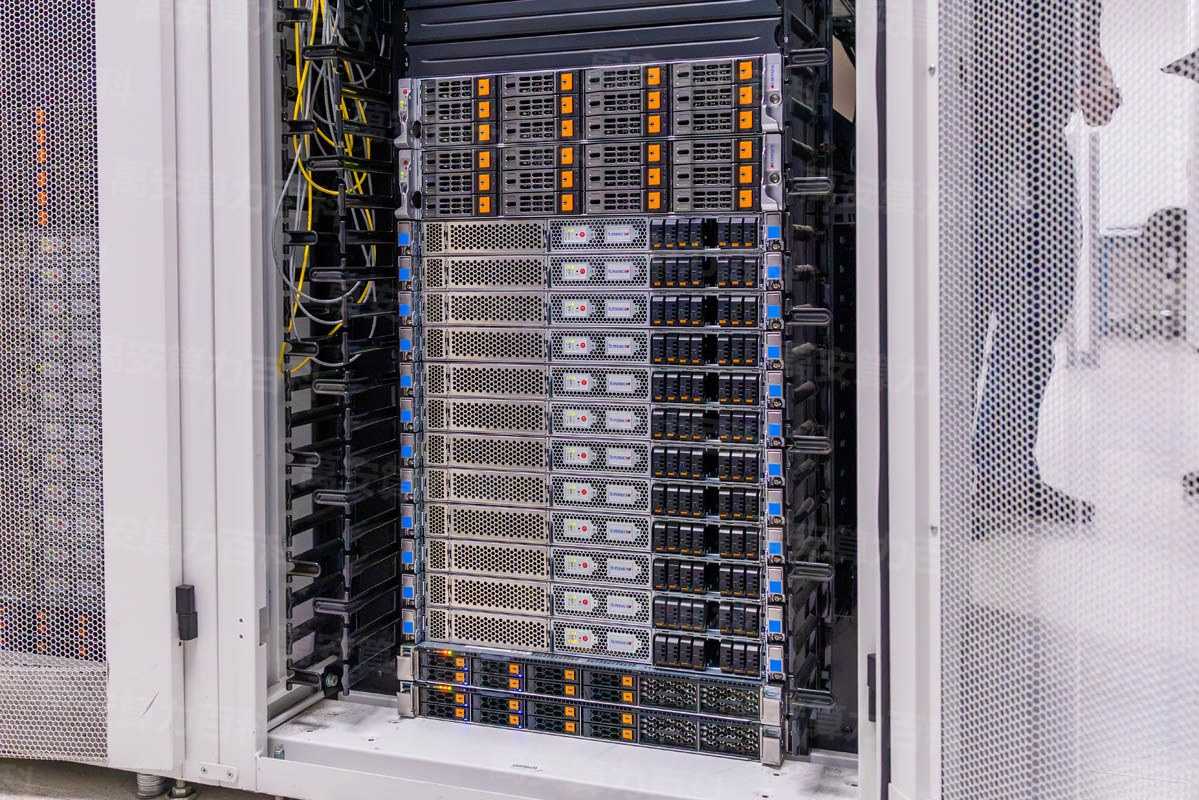
실물 촬영 이미지는 검수배치마다 지속적으로 추가됩니다;AI 생성 이미지는 실물 촬영으로 둔갑하지 않습니다.
영상 해설VIDEO
본 영상은 번인 테스트 판례 공통 영상(6개 판례 기준은 모델과 무관)이며, H100 전용 버전 영상은 제작 대기열에 있으며, 공개 후 본 카드를 교체하고 H100 실측 앵커 커버를 적용한다.
커뮤니티 실기기 · 출처 YouTubeCOMMUNITY HANDS-ON
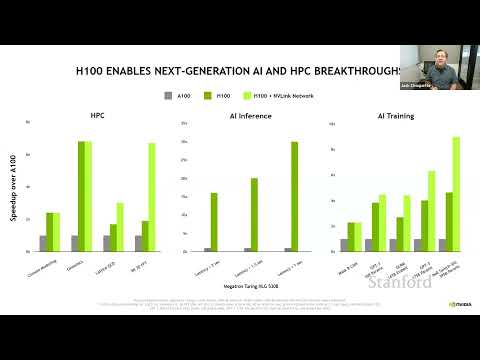
일부 지역에서는 바로 재생되지 않을 수 있습니다
소프트웨어와 에코시스템ECOSYSTEM
| 항목 | 요구 사항 / 현황 |
|---|---|
| CUDA | 11.8부터 Hopper 지원(첫 지원 버전), 현행 12.x 전체 커버 |
| 드라이버 | 520 계열부터(첫 지원), 현행 550 계열 이상 |
| 학습 프레임워크 | PyTorch / TensorFlow 공식 Hopper 지원, 가장 성숙한 생태계 |
| 추론 엔진 | vLLM / SGLang / TensorRT-LLM 모두 H100을 베이스라인 지원 모델로 채택 |
| 네트워크 구성 | ConnectX-7 400G 또는 동급 인터커넥트 솔루션 |
| 운영체제 | 주류 Linux 배포판(Ubuntu 22.04+ 등) |
Hopper 생태계는 3년 이상의 축적으로 가장 성숙했으며, 대부분의 추론 최적화 공개 벤치마크는 H100을 기준 모델로 합니다;소프트웨어 스택 버전은 시간에 따라 발전하며, NVIDIA 공식 발표를 기준으로 합니다.
구매 및 검수PROCUREMENT
H100 구매 시 검수 포인트 (3가지):
6개 항목 전체 번인 테스트 판례(수치는 H100 실측 앵커)는 본 항목의«번인 테스트 방법»절 참조.
벤치마크(스트레스 테스트) 방법BENCH TEST
6개 항목 번인 테스트 기준, 수치 판례는 모두 H100 실측 앵커: 개봉 식별 → 단일 카드 번인 테스트(700W 공랭 히트싱크, ≤85℃ ECC 에러 없으면 합격) → 전체 시스템 풀 로드 → 메모리 대역폭(정격 3.35TB/s, ≥85% 합격) → 인터커넥트 대역폭(nccl-tests ≥750GB/s, 정격 900GB/s) → 추론 처리량(공개 벤치마크의 ≥80%).
nvidia-smigpu-burn 3600 또는 dcgmi diag -r 3 · 30–60분bandwidthTest(CUDA 내장 샘플)nccl-tests all_reduce 벤치마크vLLM 실제 모델 구동기준 설명: 합격/우수 기준선은 본 라이브러리가 엔지니어링 통용 기준(대역폭은 공칭값 대비 비율, 온도는 데이터센터 통용 상한)으로 정리한 것으로, 검수 보고서 실측 데이터 축적에 따라 점차 보정됩니다. 본 표는 어떠한 검수 약속도 구성하지 않으며, 구체적인 사항은 계약 약정 기준입니다.본 라이브러리 검수 보고서의 실측 항목은 본 표 기준으로 기록됩니다 — NOT_EXECUTED는 해당 항목 미실행을 의미하며, 「미측정」 자체도 중요한 정보입니다.
운송과 납품LOGISTICS
OEM과 변형 모델VENDORS
동일한 HGX H100 기판이라도 제조사별 완제품의 차이는 폼팩터, 냉각, 서비스에 있습니다——선정 전 차이를 먼저 확인하세요(본 라이브러리 판매 품목은 이 중 4개사 포함):
| 완제품 제조사 | 대표 폼팩터 | 차이점 | 적합한 대상 |
|---|---|---|---|
| Supermicro 슈퍼마이크로 | HGX H100 8 완제품(공랭 / 수랭 트윈 폼팩터) | 대량 판매 주력, 수랭 모델은 전문 매체의 완전한 리뷰 존재[12] | 재고 구매 · 가성비 중시 |
| Dell 델 | PowerEdge 시리즈(HGX H100 8) | 글로벌 톱티어 서비스 네트워크와 엔터프라이즈급 지원 | 국제 배포 · 서비스 중시 |
| H3C 신화삼 | HGX H100 8 완제품 | 로컬 서비스와 납품 네트워크, 아태 지역 프로젝트에 흔함 | 아태 채널 · 로컬 서비스 |
| Gigabyte 기가바이트 | HGX H100 8 완제품 | 유연한 구성, 아태 채널 강세 | 아태 채널 구매 |
| NVIDIA 공식 | DGX H100(8카드 완제품) | 공식 올인원 납품, 풀스택 소프트웨어와 제조사 백업, 첫 대량 납품처는 OpenAI[5] | 개봉 즉시 훈련 · 원 제조사 지원 |
AIXX Index · 배포 4개 항목 비교AIXX INDEX
| 완제품 제조사 | 설치 용이성 | 유지보수 편의성 | 성능 밀도 | 수명 전망 |
|---|---|---|---|---|
| Supermicro 슈퍼마이크로 | 88 | 84 | 84 | 80 |
| Dell 델 | 90 | 92 | 84 | 85 |
| H3C 신화삼 | 86 | 84 | 83 | 82 |
| Gigabyte 기가바이트 | 85 | 80 | 85 | 80 |
| NVIDIA 공식 | 92 | 88 | 82 | 85 |
AIXX Index는 본 라이브러리의 추정 기준(0–100, 산출 근거=공개 폼팩터, 냉각 방안 및 서비스 네트워크 차이)이며, 실기 검증에 따라 갱신되며 구매 약속을 구성하지 않습니다. 구체적 사양은 제조사 공식 발표 기준입니다.
용어 카드GLOSSARY
HBM3 메모리
GPU 옆에 적층된 고대역폭 메모리. H100은 카드당 80GB HBM3, 대역폭 3.35TB/s——H200 세대에서야 HBM3e로 업그레이드되었습니다. 메모리 용량은 현재 H100의 가장 큰 선택상 단점입니다.
NVLink 4 상호연결
4세대 NVLink, 카드당 900GB/s 다이렉트 인터커넥트, NVSwitch와 결합해 8개 GPU를 한 개처럼 협동 동작시킵니다. H100과 H200은 동세대 동일 속도입니다.
SXM5 온보드 패키징
GPU가 기판에 직접 실장됩니다(카드 탈착식 아님). HGX H100 8카드 기판이 곧 SXM5 폼팩터입니다. 검수 시 기판까지 함께 검증해야 합니다. 이에 대응하는 카드형 폼팩터는 PCIe 버전(350W, HBM2e)입니다.
Transformer Engine / FP8
H100이 최초 선보인 혼합 정밀도 엔진으로, 8비트 부동소수점이 학습과 추론의 주류 정밀도가 되었습니다. 메모리 사용량 추정: FP8 가중치 ≈ 파라미터 수 × 1바이트.
수출 규제와 컴플라이언스 배치
H100은 2022년 10월부터 미국의 대중국 수출 규제에 포함되었으며, 전용 공급 라인(A800/H800/H20)은 모두 규제에서 파생된 조정형 모델입니다. 배치와 통관 경로는 보증 및 가치 유지에 영향을 미치므로 검수 시 반드시 확인하세요. 본 라이브러리의 서술은 모두 공개 보도 기준이며 법적 의견을 구성하지 않습니다.
동향과 관련 이슈TIMELINE
한계와 논쟁점LIMITS
- 메모리 하드 리밋: 80GB HBM3 / 3.35TB/s, H200(141GB / 4.8TB/s)에 크게 역전되었습니다——DeepSeek R1 풀버전 FP8 약 690GB, H100 8카드 640GB로는 수용 불가(추정 기준, 「모델 적합성」 참조). 이것이 후속 모델과의 선택 기준이 갈리는 근본 원인입니다.
- 대중국 수출 규제의 주인공: 2022년 10월 최초 규제 대상에 포함된 이후 A800/H800/H20 등 전용 공급 라인은 정책에 따라 여러 차례 조정되었습니다. H100 본체는 현재까지 대중국 승인 목록에 복귀하지 못했습니다(2025년 12월 승인된 것은 H200)——중국 본토 정식 채널에서는 공개 판매가 없으며, 재고 유통은 그레이 채널에 해당합니다[6][9]. 본 라이브러리는 공개 보도 기준만 기록하며 법적 의견을 구성하지 않습니다.
- Blackwell 세대의 압박: B300은 288GB HBM3e, FP4 정밀도, NVLink 5(1.8TB/s)로 두 단계 정밀도 격차를 벌렸으며, H100의 신규 연산 구매 내 점유율은 계속 대체되고 있습니다.
- 버전 혼동 주의: PCIe 버전(HBM2e / 2TB/s / 350W / NVSwitch 풀 인터커넥트 없음)과 SXM 버전의 성능 차이가 큽니다. 「저가 H100」 견적은 대부분 PCIe 버전입니다——견적과 검수 시 패키징 폼팩터를 먼저 구분해야 합니다.
- 리퍼 및 사칭 위험: H100과 H200은 외관이 매우 유사해 「H100으로 H200 사칭」이 이미 재고 시장에서 확인되었습니다(검수 기관 통보 기준). 시리얼넘버 독립 검증 + 메모리 실측이 필수 절차입니다.
- 세대 간 논쟁: 「H100 구세대론」과 「H100 가치 유지론」이 공존합니다——임대료가 2025-2026 회복세(공개 지수 기준[7])를 보이며 후자를 뒷받침하고, Blackwell 대체 곡선이 전자를 뒷받침합니다. 본 라이브러리는 성격 규정을 하지 않으며, 데이터는 「시세 구간」을 참조하세요.
시세 밴드MARKET DATA
| 날짜 | 기준 | 지역 | 참고 가격대 | 비고 |
|---|---|---|---|---|
| 2026-10-21 | 마켓 실시간 | 미국(USD) | $187만 – 187만 | 1건 견적 ›(전량 배치호가 기준) |
| 2026-10-21 | 마켓 실시간 | 중국 본토 | ¥5,024,118만 – 5,024,118만 | 1건 견적 ›(전량 배치호가 기준) |
| 2026-10-21 | 마켓 실시간 | 싱가포르(SGD) | S$360만 – 414만 | 3건 견적(전량 배치호가 기준) |
| 2026-10-21 | 마켓 실시간 | 중동(AED) | AED 360만 – 360만 | 1건 견적(전량 배치호가 기준) |
| 2026-10-21 | 마켓 실시간 | 유럽(EUR) | €291만 – 291만 | 1건 견적(전량 배치호가 기준) |
| 2026-10-21 | 마켓 실시간 | 일본(JPY) | JPY 373만 – 373만 | 1건 견적(전량 배치호가 기준) |
| 2026-10 | 채널 참고 | 글로벌 | 신품 카드당 약 $3.1만 / 카드 | 공개 견적 집계 기준[10] · 판매 중 완제품 › |
| 2026-04 | 임대 시장 | 북미 클라우드 | 1년 계약 >$2 / GPU·시간(+40%) | 공개 분석 기준[8] |
| 2026-01 | 임대 시장 | 글로벌 | 임대 가격 지수 월간 +10% | Silicon Data 임대 지수[7] |
| 2026-10 | 정책 기준 | 중국 본토 | 승인 공개 판매 없음 | H100은 대중국 승인 목록에 없으며, 재고 유통은 그레이 채널에 해당(공개 보도 기준, 법적 의견 아님) |
기준:북미는 추정 기준——2023년 초기 출하 시점 공개 보도 완제품가 $28-35만/대로 소급하고, 2026-10 기준일 판매 중 실측 $187.4만/대(1건)에 고정하며, 중간 구간은 완만한 상승 보간, 일 단위 스냅샷 축적 후 점진 대체. 중국 본토/싱가포르/유럽/일본/중동은 판매 중 실측 스냅샷(CNY 502.4만/대 · 1건 · SGD 360.4-414.2만 · 3건 · EUR 291.5만 / JPY 373.4만 / AED 360.1만 각 1건)이며, 모두 원화 기준으로 상호 환산하지 않습니다. 본 라이브러리 가격 데이터 출처:AIXX 거래소(수수료 0% 매칭, 거래에 참여하지 않으며, 체결가를 파악·추측하지 않아 데이터가 중립적입니다). 추정 구간은 추세 참고용이며, 실제 가격은 판매자 제시가 기준.
가격 주요 이벤트MILESTONES
자주 묻는 질문FAQ
병목을 보세요: 예산 민감형, 70B급 이하 추론 및 파인튜닝, HPC/FP64 시나리오에서 H100은 여전히 재고 시장에서 생태계가 가장 크고 기존 보유량이 가장 두터운 대량 판매 기반 he 적이며, 2025-2026 임대 가격도 회복세였습니다(공개 지수 기준). 하지만 80GB 메모리는 백억(100B)급 모델에 하드 리밋입니다——병목이 메모리라면 바로 H200을 보세요.
연산 성능은 동등하고 인터커넥트도 동세대(NVLink 4 · 900GB/s)이며, 차이는 전부 메모리에 있습니다: 80GB HBM3 / 3.35TB/s 대 141GB HBM3e / 4.8TB/s. 8카드 합계 640GB 대 1.128TB——R1 풀버전 FP8(약 690GB)은 H100에 수용 불가, H200은 단일 서버 배포 가능. 한마디로: H200은 메모리를 팔고, H100은 예산을 팝니다.
H100은 2022년 10월부터 미국 대중국 수출 규제에 포함되었으며, 2025년 12월 대중국 승인된 것은 H200이고 H100은 승인 목록에 없습니다. 중국 본토 정식 채널에서는 공개 판매가 없으며, 재고 유통은 그레이 채널에 해당합니다. 이 항목은 공개 보도 기준이며 법적 의견을 구성하지 않으므로, 구매 전 주관 부처 정책과 전문 컴플라이언스 의견을 기준으로 하세요.
두 세대는 외관이 매우 유사해 사진만으로는 신뢰할 수 없습니다: 실크스크린과 공식 펌웨어 리포트 대조, 시리얼넘버 독립 채널 검증 후 메모리 실측으로 최종 확정하세요——80GB와 141GB는 측정하면 바로 확인됩니다(「구매 및 검수」와 「스트레스 테스트 방법」 참조).
SXM 버전: 700W, HBM3 3.35TB/s, NVSwitch 풀 인터커넥트, HGX 8카드 완제품의 주류 폼팩터입니다. PCIe 버전: 350W, HBM2e 2TB/s, 듀얼 카드 브리지가 없으면 고속 인터커넥트 없음. 「저가 H100」은 대부분 PCIe 버전이므로, 견적서와 계약서에 반드시 패키징 폼팩터를 명시해야 합니다.
관련 항목SEE ALSO
모델 비교 및 선택COMPARE
참고 자료REFERENCES
- NVIDIA 공식 사이트 — H100 제품 페이지(사양 기본 자료, 2026-10 검증) https://www.nvidia.com/en-us/data-center/h100/
- Tom's Hardware — Nvidia Reveals Hopper H100 GPU With 80 Billion Transistors(2022-03 GTC 발표 보도) https://www.tomshardware.com
- Nvidia Launches Hopper H100 GPU, New DGXs and More(2022-03-22) https://www.hpcwire.com
- CRN — Nvidia H100 GPUs In Full Production, Shipping In October(2022-09-20 keynote) https://www.crn.com/news/components-peripherals/nvidia-h100-…
- NVIDIA 투자자 관계 — NVIDIA Hopper GPUs Expand Reach as Demand for AI Grows(2023-03-21, DGX H100 양산 / 첫 납품 OpenAI) https://investor.nvidia.com/news/press-release-details/2023/…
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors(대중국 수출 규제 타임라인) https://www.congress.gov/crs-product/R48642
- Silicon Data — H100 임대 가격 지수 +10%(2026-01-09) https://www.silicondata.com
- H100 임대가 +40%, 1년 계약 $2/GPU·시간 돌파(2026-04, 인용 기준) https://semianalysis.com
- H200 대중국 승인, 채널 모듈 가격 약 140만 위안/모듈(2025-12-24, H200 항목 [2]과 동일)
- 채널 견적 집계 — 신품 H100 약 $31,000/카드(2026 기준) https://benchgecko.ai
- Checking out the NVIDIA H100 in Our First Look at Hopper(모듈 실사) https://www.servethehome.com/checking-out-the-nvidia-h100-in…
- A Look at the Liquid Cooled Supermicro SYS-821GE-TNHR 8x NVIDIA H100 AI Server(수랭 완제품 실사) https://www.servethehome.com/a-look-at-the-liquid-cooled-sup…
- 시세 밴드 데이터 — AIXX 거래소(본 플랫폼 판매 호가 및 채널 확인 구간, 매일 업데이트) /hall.html