
H100
概要OVERVIEW
H100(正式名称 NVIDIA H100、Hopper シリーズに属す)は NVIDIA が 2022 年 3 月 22 日に GTC で発表、2022 年 9 月に量産を公式発表(10 月より出荷)したデータセンター向け GPU:Hopper 世代の第一作で、Transformer Engine(FP8 精度を初搭載)を初搭載し、初めて HBM3 メモリと PCIe Gen5 を備えた GPU[1][2]。
大規模モデル時代を切り開いた一枚:ChatGPT が世界の算力軍備競争に火をつけた後、H100 は一時世界で最も需給が逼迫した AI 算力の単位となり、対中輸出規制によって米中チップ攻防の象徴的機種にもなった(「沿革」「限界と論争」参照)。
2026 年の現貨市場における H100 の役割は量産基盤:算力は Hopper のフルスペックのまま、エコシステムは最も成熟し、レンタル需要は 2025〜2026 年にむしろ回復している(公表指数ベース[7][8])。ただしメモリ 80GB というハード上限は、H200(141GB)や B300(288GB)に世代ごとに価格を圧されつつある——購入前に、自分のボトルネックがメモリ容量ではないかを確認すべきだ。
適用シーンFIT
AIXX Index(0–100):当ライブラリは公開スペックに基づく加重推定です——メモリ 40% + インターコネクト 30% + エコシステム 30%、用途に応じて重みを調整。90+ フラッグシップ級 · 75+ 優秀 · 60+ 実用圏 · 60 未満は不向き。算出方法は透明で検証可能ですが、性能の保証ではありません。
沿革HISTORY
2022 年 3 月 22 日、GTC で Hopper アーキテクチャと H100 を発表:800 億トランジスタ、TSMC 4N カスタムプロセス、Transformer Engine により FP8 が初めて GPU の主要精度に加わり、HBM3 + PCIe Gen5 を初めて備えた GPU でもあった[2][3]。
2022 年 9 月 20 日GTC 秋季基調講演で量産を公式発表、10 月より出荷すると告知[4];2023 年 3 月 21 日DGX H100 量産受注開始、初号機は OpenAI に納入[5]、その後 1 年で H100 は世界の AI 算力拡張の絶対的主力となった。
2022 年 10 月 7 日、米国の輸出規制により H100 が対中許可管理対象に;NVIDIA は A800/H800 特別仕様(2022 年末)、H20 特別仕様ライン(2024 年出荷)を相次いで投入して対中供給を継続したが、2023 年 10 月の規制強化と 2025 年 4 月の H20 許可管理により幾度となく途絶えた[6]。H100 本体が対中承認リストに戻ることはなかった——2025 年 12 月に対中承認されたのは H200[9]。
2025〜2026 年、H100 は「ストック基盤」段階に入る:H200/B300 が世代ごとに登場して新規調達を奪う一方、推論需要がレンタル価格を再び押し上げ——レンタル価格指数は 2025 年 12 月〜2026 年 1 月に約 10% 上昇[7]、2026 年 4 月には 1 年契約のレンタル価格が $2/GPU・時を突破(公表分析ベース[8])、現貨市場では依然として取扱量最大の Hopper 機種。
技術仕様SPECIFICATIONS
| 項目 | スペック(H100 SXM · 公式値) |
|---|---|
| GPU コア | NVIDIA Hopper GH100(SXM5) |
| 単体メモリ | 80GB HBM3 |
| メモリ帯域幅 | 3.35TB/s / 枚 |
| FP8 Tensor Core | 3,958 TFLOPS(スパース表記) |
| FP16 / BF16 Tensor Core | 1,979 TFLOPS(スパース表記) |
| TF32 Tensor Core | 989 TFLOPS(スパース表記) |
| FP64 / FP64 Tensor | 34 / 67 TFLOPS |
| GPU間インターコネクト | NVLink 第四世代 · 900GB/s + NVSwitch フルインターコネクト |
| ボード消費電力(TBP/TGP) | 最大 700W(設定可能;PCIe 版 350W / NVL 版 350-400W) |
| 主流のサーバー形態 | HGX H100 8 枚構成ベースボード(空冷 / 液冷)· DGX H100 |
| 前世代 / 対抗製品 | A100 80GB(Ampere)/ H200、B300 |
仕様は NVIDIA 公開資料による[1];Tensor 演算性能はすべて公式の「スパース込み」表記、dense 表記は半分;システム構成は OEM とロットにより差がある。
世代対照 · 4 世代一括表示GENERATIONS
| 項目 | A100 80GB | H100 80GB | H200 | B300 |
|---|---|---|---|---|
| 単体メモリ | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| メモリ帯域幅 | 約 2TB/s | 3.35TB/s | 4.8TB/s | 約 8TB/s |
| 代表精度 | FP16 | FP8(Transformer Engine) | FP8 | FP4 |
| GPU間インターコネクト | NVLink 3 · 600GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| 選定を一言で | ストック継続 | 予算最重視 · エコシステム最大 | 大容量メモリ · 量産主力 | フラッグシップ新規購入 · 次世代 |
スペックは NVIDIA 公式公開資料に準拠;A100/H200/B300 列は各項目の対照表を参照。
ファミリー構成FAMILY
H100 ファミリーはパッケージとフォームファクタで 4 系統に分かれ、中国本土および世界の現貨は HGX 8 枚構成システムが主力(当ライブラリの販売品は Supermicro / Dell / H3C / Gigabyte の 4 社による HGX H100 8 枚構成):
冷却と導入COOLING
H100 の主流は空冷 HGX 8 枚構成:700W クラス SXM5 の冷却ソリューションは成熟しており、既存の設備でそのまま導入できる——これも同機が今なお「改造ハードルが最も低い算力」である理由の一つ。液冷バリアントは 2023 年以降、高密度プロジェクトとともに展開(例:Supermicro SYS-821GE-TNHR 液冷システム[12])、H100 PCIe 版は 350W の 2 スロット空冷カードで、ベースボードなしのフルインターコネクト非対応。


モデル対応MODEL FIT
| モデル / シナリオ | メモリ必要量(FP8 概算) | H100 でのデプロイ(8 枚 640GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 フルスペック(671B) | 約 690GB | 8 枚では収まらない——INT4 量子化(約 350GB で収容可)か複数マシン分散が必要;フルスペック単体なら H200/B300 を参照 | 41 |
| R1-Distill 70B クラス | 約 70GB | 1 枚 80GB でデプロイ可、余裕はやや乏しい(KV cache の調整が必要) | 82 |
| 72B クラスオープンソースモデル | 約 72GB | 1 枚ではぎりぎり、実運用では 2 枚のテンソル並列が一般的 | 75 |
| 7B-14B クラス(動画生成の小型モデル含む) | 約 8-30GB | 1 枚で余裕、バッチ産線は複数枚で同時実行数を確保 | 90 |
メモリは FP8 重み ≈ パラメータ数 × 1 バイトで概算(推定ベース、KV cache と活性化のマージンは未含む);AIXX Index は当ライブラリの推定基準で、実測に応じて更新。70B クラスの 1 枚デプロイはぎりぎりの運用であり、実測を優先。
ギャラリーGALLERY


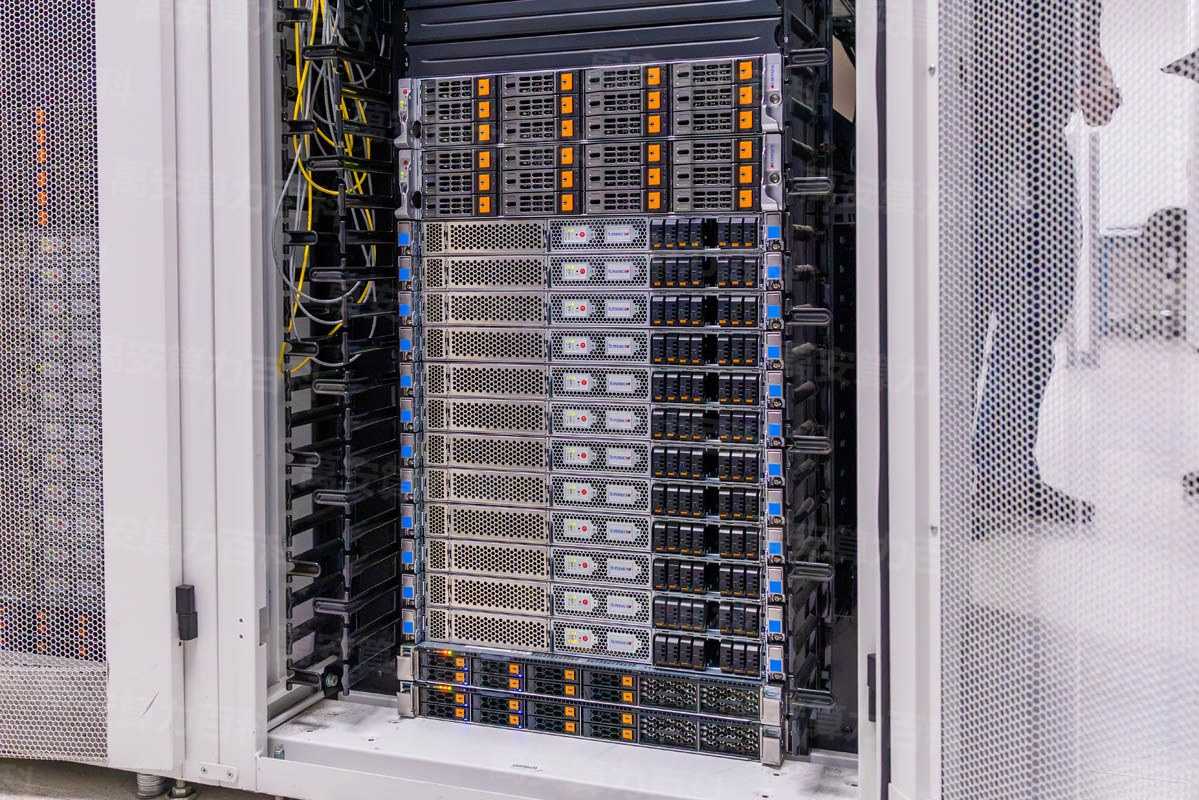
実写画像は検品ロットに合わせて順次追加;AI 生成画像は実写と偽らない。
動画解説VIDEO
本動画はストレステスト判例の共通版(6 項目の判例基準は機種に依存しない)で、H100 専用版動画は制作スケジュールに入っており、公開後本カードを差し替え H100 の実測アンカーカバーを添付する。
コミュニティ実機 · 出典 YouTubeCOMMUNITY HANDS-ON
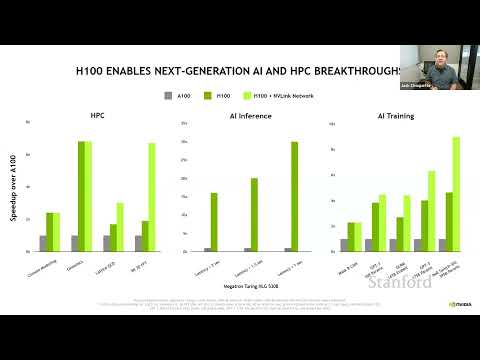
地域によっては直接再生できない場合があります
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| CUDA | 11.8 から Hopper 対応(初公開バージョン)、現行 12.x で全面カバー |
| ドライバー | 520 系から(初公開)、現行は 550 系以上 |
| 学習フレームワーク | PyTorch / TensorFlow は公式に Hopper 対応、エコシステムは最も成熟 |
| 推論エンジン | vLLM / SGLang / TensorRT-LLM ともに H100 を基準サポート機種とする |
| ネットワーク構成 | ConnectX-7 400G または同等のインターコネクトソリューション |
| OS | 主要Linuxディストリビューション(Ubuntu 22.04+ など) |
Hopper エコシステムは 3 年余りの蓄積を経て最も成熟し、大多数の推論最適化の公開ベンチマークは H100 を基準機種としている;ソフトウェアスタックのバージョンは時間とともに変化するため、NVIDIA 公式リリースに準拠。
調達と検品PROCUREMENT
H100 調達時の検品ポイント(3 項目):
6 項目ストレステストの完全版判例(数値は H100 実測アンカー)は本項目の「ストレステストの方法」節を参照。
ストレステストの方法BENCH TEST
6 項目のストレステスト基準、数値判例はすべて H100 実測アンカー:開封確認 → 1 枚焼き込みテスト(700W 空冷塔、≤85℃ かつ ECC エラーゼロで合格)→ 全機フルロード → メモリ帯域幅(公称 3.35TB/s、≥85% で合格)→ インターコネクト帯域(nccl-tests ≥750GB/s、公称 900GB/s)→ 推論スループット(公開ベンチの ≥80%)。
nvidia-smigpu-burn 3600 または dcgmi diag -r 3 · 30〜60分bandwidthTest(CUDA同梱サンプル)nccl-tests all_reduce ベンチマークvLLM 実モデルを起動して負荷計測基準の説明:合格/優秀ラインは当ライブラリが技術上の一般的基準に基づき整理したもの(帯域は公称値に対する比率、温度はデータセンターの一般的上限)。検品報告書の実測データの蓄積に応じて段階的に校正する。本表はいかなる検収の約束を構成するものではなく、詳細は契約の取り決めによる。当ライブラリの検品報告書の実測項目は本表の基準に従って記録される——NOT_EXECUTED は未実施を意味し、「未測定」そのものも重要な情報である。
輸送と納品LOGISTICS
OEM とバリエーションVENDORS
同一の HGX H100 基板でも、メーカー間の違いはフォームファクタ、冷却、サービスにあります。選定はまずこの違いを確認(本ライブラリ在庫はそのうち4社をカバー):
| 一体機メーカー | 代表形態 | 差別化ポイント | 向いているケース |
|---|---|---|---|
| Supermicro 超微 | HGX H100 8 搭載機(空冷 / 液冷の両フォームファクタ) | 量販の主力。液冷モデルは専門メディアによる完本レビューあり[12] | 現調達 · コスパ重視 |
| Dell Dell | PowerEdge シリーズ(HGX H100 8) | 世界的トップティアのサービス網とエンタープライズ級サポート | 越境展開 · サービス重視 |
| H3C 新華三 | HGX H100 8 搭載機 | ローカルのサービス・デリバリーネットワーク、アジア太平洋プロジェクトで定番 | アジア太平洋チャネル · ローカルサービス |
| Gigabyte 技嘉 | HGX H100 8 搭載機 | 構成の柔軟性が高く、アジア太平洋チャネルに強い | アジア太平洋チャネルでの調達 |
| NVIDIA 純正 | DGX H100(8 カード搭載機) | 公式一体型デリバリー、フルスタックソフトウェアとメーカー純正の裏付け、初号機は OpenAI へ納入[5] | 開梱即学習 · 純正サポート重視 |
AIXX Index · デプロイ四軸比較AIXX INDEX
| 一体機メーカー | 導入の容易さ | 保守のしやすさ | 性能密度 | 寿命見込み |
|---|---|---|---|---|
| Supermicro 超微 | 88 | 84 | 84 | 80 |
| Dell Dell | 90 | 92 | 84 | 85 |
| H3C 新華三 | 86 | 84 | 83 | 82 |
| Gigabyte 技嘉 | 85 | 80 | 85 | 80 |
| NVIDIA 純正 | 92 | 88 | 82 | 85 |
AIXX Index は本ライブラリの推定値(0–100、推定根拠=公開されているフォームファクタ・冷却方式・サービス網の差異)で、実機検証に伴い更新されます。調達の約束を構成するものではありません。具体的な型番はメーカー公式発表に依拠します。
用語カードGLOSSARY
HBM3 メモリ
GPU の横にスタックされた高帯域メモリ。H100 は1カード 80GB HBM3、帯域 3.35TB/s——HBM3e への更新は H200 の世代から。メモリ容量は現在の H100 における最大の選定上の弱点です。
NVLink 4 インターコネクト
第4世代 NVLink。1カードあたり 900GB/s の直結インターコネクトで、NVSwitch と組み合わせれば8基の GPU が1基のように協調動作。H100 と H200 は同世代・同速度です。
SXM5 基板直載せ実装
GPU は基板に直接はんだ付け(カード挿し式ではない)。HGX H100 の8カード基板がまさに SXM5 フォームファクタ。検品時は基板ごと検証が必要です。対位するカード挿し式は PCIe 版(350W、HBM2e)です。
Transformer Engine / FP8
H100 が初搭載した混合精度エンジン。8ビット浮動小数点を学習・推論の主流精度に押し上げました。メモリ使用量の概算:FP8 重み ≈ パラメータ数 × 1 バイト。
輸出規制とコンプライアンス ロット
H100 は2022年10月以降、米国の対中輸出規制の対象となり、特別供給ライン(A800/H800/H20)はいずれも規制に由来する調整型です。ロットと通関経路は保証と資産価値に影響するため、検品時の必須確認事項。本ライブラリの記述はすべて公開報道ベースであり、法的助言を構成しません。
動向と関連イベントTIMELINE
限界と論点LIMITS
- メモリのハードリミット:80GB HBM3 / 3.35TB/s は H200(141GB / 4.8TB/s)に大きく逆転されました——DeepSeek R1 フル構成 FP8 は約 690GB で、H100 8カード合計 640GB には収まりません(推定ベース、詳しくは「モデル適合性」参照)。これが後継機との選定分かれ目の根本要因です。
- 対中輸出規制の主役:2022年10月に最初の規制対象となり、以降 A800/H800/H20 などの特別供給ラインは政策に伴い数度の調整を経ています。H100 本体は現在も対中承認リストに戻っていません(2025年12月に承認されたのは H200)——中国本土の正規チャネルでの公開販売はなく、現物流通はグレーチャネルに属します[6][9]。本ライブラリは公開報道ベースの記録のみで、法的助言を構成しません。
- Blackwell 世代からの圧迫:B300 は 288GB HBM3e、FP4 精度と NVLink 5(1.8TB/s)により2世代分の精度差を築き、H100 の新規調達に占めるシェアは代替が進んでいます。
- バージョン見分けの落とし穴:PCIe 版(HBM2e / 2TB/s / 350W / NVSwitch フルメッシュなし)と SXM 版の性能差は大きく、「低価格 H100」の見積もりは PCIe 版であることが多い——見積もりと検品ではまず実装形態の確認が必須です。
- リファビッシュ・偽装リスク:H100 と H200 は外観が非常に似ており、「H100 を H200 として偽る」事例が現物市場で確認されています(検品機関の通報ベース)。シリアル番号の独立検証+メモリ実測が必須手順です。
- 計算世代をめぐる論争:「H100 時代遅れ論」と「H100 価値維持論」が並存——賃料は2025-2026年に回復(公開指数ベース[7])しており後者を支持、Blackwell の代替カーブは前者を支持。本ライブラリは方向付けを行わず、データは「市況ゾーン」を参照。
相場帯MARKET DATA
| 日付 | 基準 | 地域 | 参考価格帯 | 備考 |
|---|---|---|---|---|
| 2026-10-20 | マーケットリアルタイム | 米国(USD) | $187万 – 187万 | 1 件の見積 ›(ロット全体の提示価格ベース) |
| 2026-10-20 | マーケットリアルタイム | 中国本土 | ¥5,024,118万 – 5,024,118万 | 1 件の見積 ›(ロット全体の提示価格ベース) |
| 2026-10-20 | マーケットリアルタイム | シンガポール(SGD) | S$360万 – 414万 | 3 件の見積(ロット全体の提示価格ベース) |
| 2026-10-20 | マーケットリアルタイム | 中東(AED) | AED 360万 – 360万 | 1 件の見積(ロット全体の提示価格ベース) |
| 2026-10-20 | マーケットリアルタイム | 欧州(EUR) | €291万 – 291万 | 1 件の見積(ロット全体の提示価格ベース) |
| 2026-10-20 | マーケットリアルタイム | 日本(JPY) | JPY 373万 – 373万 | 1 件の見積(ロット全体の提示価格ベース) |
| 2026-10 | チャネル参考 | グローバル | 新品1カードあたり約 $3.1 万 / 枚 | 公開見積の集計ベース[10] · 在庫一体機 › |
| 2026-04 | レンタル市場 | 北米クラウド | 1年契約 >$2 / GPU·時間(+40%) | 公開分析ベース[8] |
| 2026-01 | レンタル市場 | グローバル | 賃料指数が単月 +10% | Silicon Data レンタル指数[7] |
| 2026-10 | 政策ベース | 中国本土 | 承認済みの公開販売なし | H100 は対中承認リストに含まれず、現物流通はグレーチャネルに属します(公開報道ベース、法的助言ではありません) |
算定基準:北米は推定ベース——2023年の出荷初期は公開報道の一体機価格 $28-35 万/台に遡って設定し、2026-10 は当日の在庫実測に固定 $187.4 万/台(1 件)、中間は緩やかな上昇の内挿、日次スナップショットの蓄積後に点ごとに置き換え。中国本土/シンガポール/欧州/日本/中東は在庫実測スナップショット(CNY 502.4 万/台 · 1 件 · SGD 360.4-414.2 万 · 3 件 · EUR 291.5 万 / JPY 373.4 万 / AED 360.1 万 各 1 件)で、いずれも現地通貨ベース、相互に換算しません。本ライブラリの価格データ出典:AIXX 取引所(手数料ゼロのマッチング、取引には関与せず、成約価格も把握・推測しないため、データは中立です)。推定帯は推移の参考にのみ供し、実際の価格は出品者の提示価格によります。
価格イベント年表MILESTONES
よくある質問FAQ
ボトルネックで判断:予算重視、70B クラス以下の推論とファインチューニング、HPC/FP64 ユースケースなら、H100 は現物市場で最もエコシステムが大きくストックの厚い量販の基盤であり、2025-2026年はレンタル料まで回復しています(公開指数ベース)。ただし 80GB メモリは数百億パラメータ級モデルにとってハードリミット——メモリがボトルネックなら H200 を直接見ましょう。
計算性能は同等、インターコネクトも同世代(NVLink 4 · 900GB/s)。差はすべてメモリにあります:80GB HBM3 / 3.35TB/s 対 141GB HBM3e / 4.8TB/s。8カード合計は 640GB 対 1.128TB——R1 フル構成 FP8(約 690GB)は H100 に収まらず、H200 なら1台でデプロイ可能。一言でいえば:H200 はメモリを売り、H100 は予算を売る。
H100 は2022年10月以降、米国の対中輸出規制の対象であり、2025年12月に対中が承認されたのは H200 で、H100 は承認リストに含まれていません。中国本土の正規チャネルでの公開販売はなく、現物流通はグレーチャネルに属します。本項は公開報道ベースであり法的助言ではないため、調達前には主管当局の方針と専門のコンプライアンス意見に依拠してください。
両世代は外観が非常に似ており、写真だけでは信頼できません:シルク印刷と公式ファームウェアレポートを照合し、シリアル番号を独立チャネルで検証した上で、メモリ実測で最終確認——80GB と 141GB は測れば一目瞭然です(「調達と検品」「ストレステストの方法」参照)。
SXM 版:700W、HBM3 3.35TB/s、NVSwitch フルメッシュで、HGX 8カード一体機の主流形態。PCIe 版:350W、HBM2e 2TB/s、デュアルカードブリッジなしでは高速インターコネクトなし。「低価格 H100」は PCIe 版であることが多く、見積もりと契約には実装形態の明記が必須です。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- NVIDIA 公式サイト — H100 製品ページ(仕様の一次資料、2026-10 検証) https://www.nvidia.com/en-us/data-center/h100/
- Tom's Hardware — Nvidia Reveals Hopper H100 GPU With 80 Billion Transistors(2022-03 GTC 発表報道) https://www.tomshardware.com
- Nvidia Launches Hopper H100 GPU, New DGXs and More(2022-03-22) https://www.hpcwire.com
- CRN — Nvidia H100 GPUs In Full Production, Shipping In October(2022-09-20 keynote) https://www.crn.com/news/components-peripherals/nvidia-h100-…
- NVIDIA 投資家向け情報 — NVIDIA Hopper GPUs Expand Reach as Demand for AI Grows(2023-03-21、DGX H100 量産 / 初号機 OpenAI 納入) https://investor.nvidia.com/news/press-release-details/2023/…
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors(対中規制のタイムライン) https://www.congress.gov/crs-product/R48642
- Silicon Data — H100 レンタル価格指数 +10%(2026-01-09) https://www.silicondata.com
- H100 賃料 +40%、1年契約が $2/GPU·時間を突破(2026-04、転述ベース) https://semianalysis.com
- H200 の対中承認、チャネルモジュール価格 約140万元/モジュール(2025-12-24、H200 項目 [2] と同出典)
- チャネル見積集計 — 新品 H100 約 $31,000/枚(2026 ベース) https://benchgecko.ai
- Checking out the NVIDIA H100 in Our First Look at Hopper(モジュール実写) https://www.servethehome.com/checking-out-the-nvidia-h100-in…
- A Look at the Liquid Cooled Supermicro SYS-821GE-TNHR 8x NVIDIA H100 AI Server(液冷一体機実写) https://www.servethehome.com/a-look-at-the-liquid-cooled-sup…
- マーケット帯データ — AIXX Exchange(当プラットフォームの販売中の提示価格とチャネル把握区間、毎日更新) /hall.html