AIXX Pedia › Fiche modèle › H100

H100
Vue d'ensemble OVERVIEW
H100 (nom complet NVIDIA H100, appartenant à la série « Hopper ») est un GPU datacenter annoncé par NVIDIA le 22 mars 2022 lors du GTC, avec la production officiellement lancée en septembre 2022 (livraisons à partir d'octobre) : pièce maîtresse de la génération Hopper, premier GPU doté du Transformer Engine (première du FP8), premier GPU à embarquer de la HBM3 et du PCIe Gen5[1][2]。
C'est la carte qui a « ouvert la porte de l'ère des grands modèles » : après que ChatGPT a déclenché la course mondiale aux ressources de calcul, le H100 est devenu pendant un temps l'unité de calcul IA la plus recherchée au monde, et s'est imposé comme une pièce emblématique de la guerre des puces entre la Chine et les États-Unis en raison des contrôles à l'export (voir « Historique » et « Limites et controverses »).
Sur le marché spot de 2026, le rôle du H100 est celui d'un socle de volume : la puissance de calcul reste celle du Hopper pleine vitesse, l'écosystème est le plus mature, et la demande de location a même rebondi en 2025-2026 (selon l'AIXX Index public[7][8]), mais le plafond strict de 80GB de mémoire est progressivement sous-coté par le H200 (141GB) puis le B300 (288GB) — avant d'acheter, vérifiez d'abord que votre goulot d'étranglement n'est pas la mémoire.
Cas d'usage FIT
AIXX Index (0–100) : cette base l'estime par pondération des spécifications publiques — mémoire 40 % + interconnexion 30 % + écosystème 30 %, avec pondération ajustée selon le scénario. 90+ niveau flagship · 75+ Excellent · 60+ utilisable · en dessous de 60, non recommandé. Méthode transparente et vérifiable, sans engagement de performance.
Historique HISTORY
22 mars 2022 , le GTC dévoile l'architecture Hopper et le H100 : 80 milliards de transistors, process custom TSMC 4N ; le Transformer Engine fait entrer le FP8 pour la première fois dans la gamme de précisions principales des GPU, et c'est aussi le premier GPU HBM3 + PCIe Gen5[2][3]。
20 septembre 2022 keynote d'automne du GTC : lancement officiel de la production, livraisons annoncées à partir d'octobre[4]; 21 mars 2023 le DGX H100 passe en production commandable, première unité livrée à OpenAI[5], et dans l'année qui suit, le H100 devient le fer de lance absolu de l'expansion mondiale des capacités de calcul IA.
7 octobre 2022 , les contrôles à l'export américains soumettent le H100 à un régime de licence pour la Chine ; NVIDIA lance successivement les variantes réservées au marché chinois A800/H800 (fin 2022) puis la gamme H20 (livrée en 2024) pour maintenir l'offre vers la Chine, avec plusieurs interruptions suite au durcissement des contrôles d'octobre 2023 et au régime de licence H20 d'avril 2025[6]. Le H100 lui-même n'est jamais revenu sur la liste des licences approuvées pour la Chine — c'est le H200 qui obtient l'approbation en décembre 2025[9]。
2025-2026 , le H100 entre dans une phase de « socle installé » : le H200/B300 prend en charge les nouveaux achats génération après génération, mais la demande d'inférence fait remonter à nouveau les prix de location — l'indice de location progresse d'environ 10 % entre décembre 2025 et janvier 2026[7], et en avril 2026 les contrats annuels franchissent $2/GPU·h (selon les analyses publiques[8]), le marché spot en reste le modèle Hopper le plus échangé.
Fiche technique SPECIFICATIONS
| Élément | Spécification (H100 SXM · données officielles) |
|---|---|
| Cœur GPU | NVIDIA Hopper GH100(SXM5) |
| Mémoire par carte | 80GB HBM3 |
| Bande passante mémoire | 3,35TB/s / carte |
| FP8 Tensor Core | 3 958 TFLOPS (avec parcimonie) |
| FP16 / BF16 Tensor Core | 1 979 TFLOPS (avec parcimonie) |
| TF32 Tensor Core | 989 TFLOPS (avec parcimonie) |
| FP64 / FP64 Tensor | 34 / 67 TFLOPS |
| Interconnexion GPU-GPU | NVLink quatrième génération · 900GB/s + NVSwitch full mesh |
| Consommation de la carte (TBP/TGP) | jusqu'à 700W (configurable ; version PCIe 350W / version NVL 350-400W) |
| Formes machines courantes | Baseboard HGX H100 8 cartes (refroidi par air / refroidi par liquide) · DGX H100 |
| Génération précédente / concurrent | A100 80GB(Ampere)/ H200、B300 |
Spécifications selon les données publiques officielles NVIDIA[1] ; toute la puissance Tensor est au « avec parcimonie » officiel, en dense il faut diviser par deux ; les configurations machine varient selon l'OEM et le lot.
Tableau générationnel · quatre générations en un coup d'œil GENERATIONS
| Élément | A100 80GB | H100 80GB | H200 | B300 |
|---|---|---|---|---|
| Mémoire par carte | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| Bande passante mémoire | environ 2TB/s | 3.35TB/s | 4.8TB/s | environ 8TB/s |
| Précision emblématique | FP16 | FP8(Transformer Engine) | FP8 | FP4 |
| Interconnexion GPU-GPU | NVLink 3 · 600GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| Choix en une phrase | Parc installé en prolongation | Budget serré · plus grand écosystème | Grande mémoire · pilier du volume | Achat flagship · génération suivante |
Spécifications selon les données publiques officielles NVIDIA ; voir les fiches respectives pour les colonnes A100/H200/B300.
Famille H100 FAMILY
La famille H100 se décline en quatre branches selon le packaging et la forme ; sur le marché spot chinois comme mondial, la machine 8 cartes HGX domine (en vente dans cette base : les HGX H100 8 de Supermicro / Dell / H3C / Gigabyte) :
Refroidissement et déploiement COOLING
Le H100 est majoritairement déployé en forme HGX 8 cartes refroidi par air : la solution de refroidissement SXM5 pour du 700W est éprouvée et déployable dans les salles existantes, l'une des raisons pour lesquelles il reste aujourd'hui « la puissance de calcul au seuil de transformation le plus bas ». Les variantes refroidi par liquide se sont déployées à partir de 2023 avec les projets haute densité (comme la machine refroidi par liquide Supermicro SYS-821GE-TNHR[12]), tandis que le H100 PCIe se présente comme une carte double slot 350W refroidi par air, sans baseboard full mesh.


Compatibilité modèles MODEL FIT
| Modèle / scénario | Besoin mémoire (estimation FP8) | Déploiement H100 (8 cartes 640GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 pleine version (671B) | environ 690GB | impossible sur huit cartes — nécessite une quantification INT4 (environ 350GB, faisable) ou un déploiement multi-machines ; pour la pleine version sur une seule machine, voir H200/B300 | 41 |
| R1-Distill classe 70B | environ 70GB | déployable sur une carte 80GB, marge serrée (KV cache à dimensionner finement) | 82 |
| Modèles open source classe 72B | environ 72GB | Limite à une seule carte, en pratique on utilise souvent deux cartes en parallélisme de tenseurs | 75 |
| Niveau 7B-14B (petits modèles de génération vidéo inclus) | Environ 8-30GB | Une seule carte suffit aisément ; en production par lots, on empile la concurrence avec plusieurs cartes | 90 |
La VRAM est estimée selon les poids FP8 ≈ nombre de paramètres × 1 octet (méthode d'estimation, sans inclure le KV cache ni la marge d'activation) ; l'AIXX Index correspond à la méthode d'estimation de cette base, mise à jour au fil des tests réels. Le déploiement d'un modèle 70B sur une seule carte est un cas limite ; se référer aux mesures réelles.
Galerie GALLERY


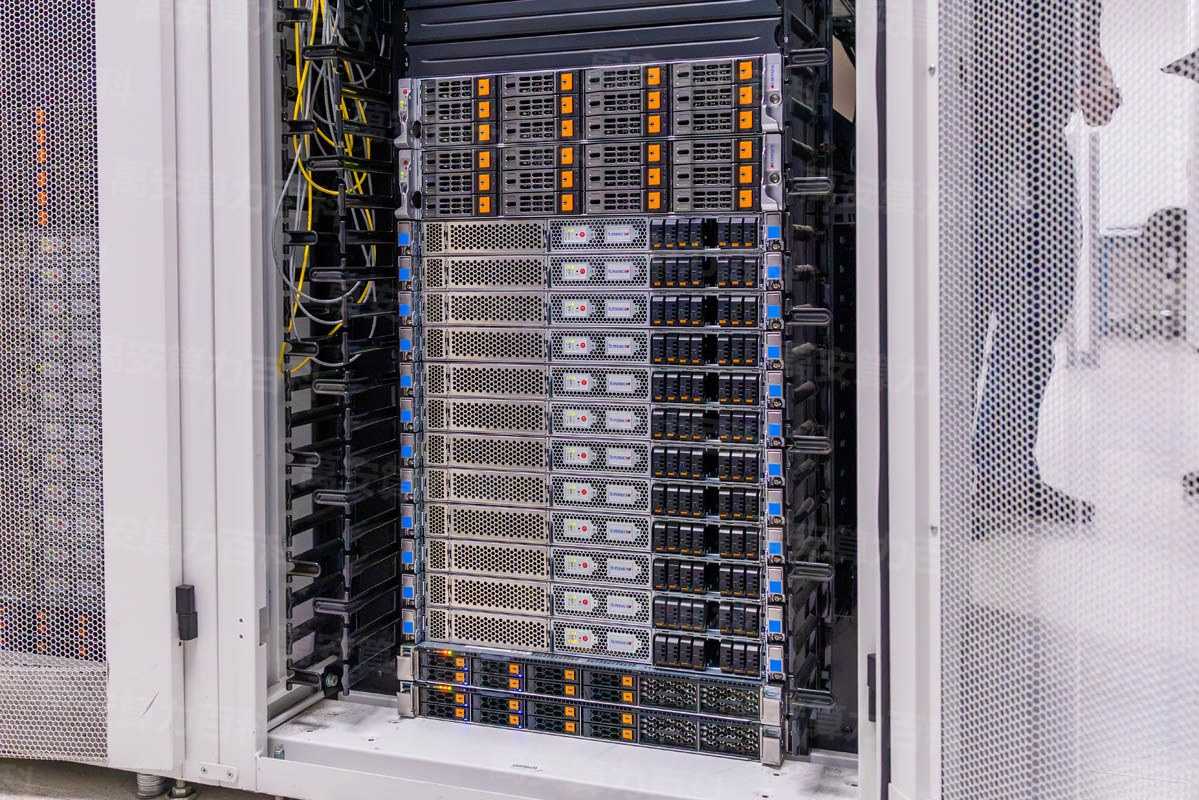
Les photos réelles seront complétées au fil des lots d'inspection ; les images générées par IA ne remplaceront jamais les vraies photos.
Présentation vidéo VIDEO
Cette vidéo est le cas générique de test de burn-in (les six critères sont indépendants du modèle) ; la version spécifique H100 est dans la file de production et remplacera celle-ci dès sa mise en ligne, avec une vignette ancrée sur des données H100 réelles.
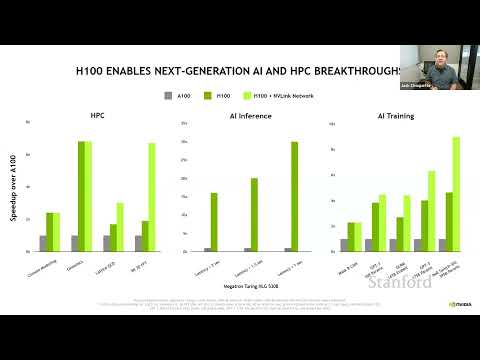
Machine réelle de la communauté · source YouTube COMMUNITY HANDS-ON
La lecture directe peut être impossible dans certaines régions
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| CUDA | Support Hopper depuis la 11.8 (version de lancement), couverture complète en 12.x |
| Pilote | À partir de la série 520 (lancement), actuellement série 550 et plus |
| Frameworks d'entraînement | PyTorch / TensorFlow prennent officiellement en charge Hopper, l'écosystème le plus mature |
| Moteurs d'inférence | vLLM / SGLang / TensorRT-LLM prennent tous le H100 comme machine de référence |
| Infrastructure réseau | ConnectX-7 400G ou solution d'interconnexion équivalente |
| Système d'exploitation | Distributions Linux courantes (Ubuntu 22.04+ etc.) |
L'écosystème Hopper, mûri depuis plus de trois ans, est le plus abouti ; la grande majorité des benchmarks publics d'optimisation d'inférence prennent le H100 comme référence ; les versions de la pile logicielle évoluent dans le temps, se référer aux publications officielles NVIDIA.
Achat et inspection PROCUREMENT
Points d'inspection à l'achat d'un H100 (trois points) :
Les six critères complets de test de burn-in (valeurs ancrées sur le H100 réel) figurent dans la section « Comment tester en burn-in » du présent article.
Comment tester sous charge BENCH TEST
Six critères de test de burn-in, toutes les valeurs ancrées sur le H100 réel : identification à l'ouverture → Test de burn-in carte par carte (tour de refroidissement par air 700W, ≤85℃, zéro erreur ECC = conforme) → pleine charge machine complète → bande passante mémoire (nominal 3.35TB/s, ≥85% conforme) → bande passante d'interconnexion (nccl-tests ≥750GB/s, nominal 900GB/s) → débit d'inférence (≥80% du benchmark public).
nvidia-smigpu-burn 3600 ou dcgmi diag -r 3 · 30–60 minutesbandwidthTest(exemple fourni avec CUDA)nccl-tests benchmark all_reducevLLM Charger un vrai modèle et mesurerNote méthodologique : les seuils Conforme/Excellent sont établis par cette base selon les pratiques d'ingénierie courantes (bande passante en proportion du nominal, température selon la limite usuelle en datacenter) et seront progressivement calibrés avec les données des rapports d'inspection ; ce tableau ne constitue aucun engagement de réception, le contrat prévaut en tout état de cause. Les mesures des rapports d'inspection de cette base sont consignées selon ce tableau — NOT_EXECUTED signifie que le test n'a pas été réalisé ; « non testé » est en soi une information importante.
Transport et livraison LOGISTICS
OEM et variantes VENDORS
Sur une même base HGX H100, les fabricants de systèmes complets se différencient par le facteur de forme, le refroidissement et le service — commencez la sélection par les différences (quatre d'entre eux sont couverts par les ventes de cette base) :
| Fabricant | Forme représentative | Points de différenciation | Pour qui |
|---|---|---|---|
| Supermicro | Système HGX H100 8 (double forme refroidi par air / refroidi par liquide) | Cheval de bataille en volume, modèle refroidi par liquide ayant fait l'objet d'un test complet par des médias spécialisés[12] | Achat en stock · priorité au rapport qualité-prix |
| Dell | Série PowerEdge (HGX H100 8) | Réseau de service de premier plan mondial et support de niveau entreprise | Déploiement multinational · le service compte |
| H3C | Système HGX H100 8 | Réseau de service et de livraison local, fréquent sur les projets Asie-Pacifique | Canaux Asie-Pacifique · service local |
| Gigabyte | Système HGX H100 8 | Configuration flexible, forte présence sur les canaux Asie-Pacifique | Achat via les canaux Asie-Pacifique |
| NVIDIA officiel | DGX H100 (système 8 GPU) | Livraison intégrée officielle, pile logicielle complète et caution de l'original, premier exemplaire livré à OpenAI[5] | Entraînement prêt à l'emploi · support constructeur |
AIXX Index · comparaison de déploiement en quatre dimensions AIXX INDEX
| Fabricant | Facilité d'installation | Facilité de maintenance | Densité de performance | Espérance de vie |
|---|---|---|---|---|
| Supermicro | 88 | 84 | 84 | 80 |
| Dell | 90 | 92 | 84 | 85 |
| H3C | 86 | 84 | 83 | 82 |
| Gigabyte | 85 | 80 | 85 | 80 |
| NVIDIA officiel | 92 | 88 | 82 | 85 |
L'AIXX Index est la méthodologie d'estimation de cette base (0–100, critères = forme publique, solution de refroidissement et différences de réseau de service), mis à jour au fil des vérifications sur machines réelles ; il ne constitue pas un engagement d'achat. Les modèles précis font foi selon les annonces officielles des fabricants.
Fiches terminologie GLOSSARY
Mémoire HBM3
Mémoire à haute bande passante empilée à côté du GPU. Chaque H100 embarque 80 Go de HBM3 à 3,35 To/s — il faudra attendre la génération H200 pour passer au HBM3e. La capacité mémoire est aujourd'hui le principal point faible du H100.
Interconnexion NVLink 4
Quatrième génération NVLink, 900 Go/s par carte en interconnexion directe ; combiné aux NVSwitch, il fait coopérer huit GPU comme un seul ; H100 et H200 sont de la même génération et à la même vitesse.
Packaging SXM5
Le GPU est soudé directement sur la base (et non sur carte enfichable) ; la base 8 GPU HGX H100 est précisément au format SXM5 ; l'inspection doit inclure la base elle-même. Le format équivalent en carte est la version PCIe (350 W, HBM2e).
Transformer Engine / FP8
Le moteur de précision mixte introduit avec le H100 a fait du flottant 8 bits la précision dominante pour l'entraînement et l'inférence ; estimation de l'empreinte mémoire : poids FP8 ≈ nombre de paramètres × 1 octet.
Contrôle des exportations et lots de conformité
Depuis octobre 2022, le H100 est soumis au contrôle américain des exportations vers la Chine ; les lignes spéciales (A800/H800/H20) sont toutes des variantes ajustées issues de ce contrôle. Lots et parcours douanier impactent garantie et valeur de revente — vérification obligatoire à l'inspection. Les informations de cette base reprennent uniquement des sources publiques et ne constituent pas un avis juridique.
Actualités et événements liés TIMELINE
Limites et controverses LIMITS
- Plafond mémoire strict 80 Go HBM3 / 3,35 To/s, largement dépassé par le H200 (141 Go / 4,8 To/s) — DeepSeek R1 complet en FP8 nécessite environ 690 Go, ce que 640 Go de huit H100 ne peuvent contenir (estimation, voir « Compatibilité modèles ») : c'est la raison profonde de la ligne de partage avec les modèles successeurs.
- Figure emblématique du contrôle des exportations vers la Chine Inscrit dès octobre 2022 dans la première vague de contrôle ; depuis, les lignes spéciales A800/H800/H20 ont été ajustées à plusieurs reprises selon la politique ; le H100 lui-même n'est jamais revenu sur la liste des approbations vers la Chine (le H200, lui, a été approuvé en décembre 2025) — aucune vente publique sur les canaux officiels en Chine continentale, les flux en stock relèvent de canaux gris[6][9]. Cette base ne fait que relayer des informations publiques et ne constitue pas un avis juridique.
- Pression de la génération Blackwell Avec 288 Go de HBM3e, la précision FP4 et NVLink 5 (1,8 To/s), le B300 creuse un écart de deux générations de précision ; la part du H100 dans les nouveaux achats de capacité de calcul continue d'être remplacée.
- Piège des versions hétérogènes L'écart de performance entre la version PCIe (HBM2e / 2 To/s / 350 W / sans full-mesh NVSwitch) et la version SXM est important ; les offres « H100 à bas prix » sont le plus souvent des versions PCIe — prix et inspection doivent impérativement distinguer le packaging d'abord.
- Risques de reconditionné et de substitution H100 et H200 se ressemblent beaucoup ; des cas de « H100 présentés comme H200 » ont été signalés sur le marché du stock (selon les rapports d'organismes d'inspection) ; vérification indépendante des numéros de série + test réel de la mémoire sont indispensables.
- Controverse générationnelle « Le H100 est dépassé » coexiste avec « le H100 conserve sa valeur » — la remontée des tarifs de location en 2025-2026 (selon indices publics[7]) soutient la seconde thèse, la courbe de remplacement par Blackwell la première ; cette base ne tranche pas, les données sont dans « Tendance marché ».
Fourchettes de prix MARKET DATA
| Date | Méthodologie | Région | Fourchette de prix de référence | Note |
|---|---|---|---|---|
| 2026-10-20 | Temps réel salle des marchés | États-Unis (USD) | 1,87 M$ – 1,87 M$ | 1 offre › (offre par lot complet) |
| 2026-10-20 | Temps réel salle des marchés | Chine continentale | 50 241 180 ¥ – 50 241 180 ¥ | 1 offre › (offre par lot complet) |
| 2026-10-20 | Temps réel salle des marchés | Singapour (SGD) | 3,60 M S$ – 4,14 M S$ | 3 offres (offre par lot complet) |
| 2026-10-20 | Temps réel salle des marchés | Moyen-Orient (AED) | 3,60 M AED – 3,60 M AED | 1 offre (offre par lot complet) |
| 2026-10-20 | Temps réel salle des marchés | Europe (EUR) | 2,91 M€ – 2,91 M€ | 1 offre (offre par lot complet) |
| 2026-10-20 | Temps réel salle des marchés | Japon (JPY) | 3,73 M JPY – 3,73 M JPY | 1 offre (offre par lot complet) |
| 2026-10 | Référence canal | Monde | Neuf, environ 31 000 $ / carte | Agrégation d'offres publiques[10] · Systèmes en vente › |
| 2026-04 | Marché de la location | Cloud nord-américain | Contrat d'un an >2 $ / GPU·heure (+40 %) | Analyses publiques[8] |
| 2026-01 | Marché de la location | Monde | Indice de location +10 % sur un mois | Silicon Data Rental Index[7] |
| 2026-10 | Statut réglementaire | Chine continentale | Aucune vente publique approuvée | Le H100 n'est pas sur la liste des approbations vers la Chine ; le stock en circulation relève de canaux gris (sources publiques, ne constitue pas un avis juridique) |
Méthodologie : l'Amérique du Nord est une estimation — ancrée sur les prix publics des systèmes à la sortie en 2023 (280–350 k$/unité), rétroprojetée, puis ancrée le 10-2026 sur l'offre réelle du jour à 1,874 M$/unité (1 offre), interpolation progressive au milieu, remplacée point par point au fil des instantanés quotidiens ; Chine continentale / Singapour / Europe / Japon / Moyen-Orient sont des instantanés d'offres réelles (5,024 M CNY/unité · 1 offre · SGD 3,604–4,142 M · 3 offres · EUR 2,915 M / JPY 3,734 M / AED 3,601 M, 1 offre chacun), tous en devise d'origine, sans conversion. Source des données prix de cette base : AIXX Exchange (mise en relation sans commission, sans participation aux transactions ; ne détient ni ne devine les prix de transaction, d'où la neutralité des données). La fourchette estimée n'indique que la tendance — le prix réel est soumis au devis du vendeur.
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Regardez le facteur limitant : pour les budgets serrés, l'inférence et le fine-tuning de modèles jusqu'à ~70B, et les scénarios HPC/FP64, le H100 reste l'écosystème le plus large et le socle le plus étoffé du marché spot ; les prix de location ont même rebondi en 2025-2026 (selon les indices publics). Mais 80 Go de mémoire vidéo constituent un plafond strict pour les modèles à centaines de milliards de paramètres — si la mémoire est le goulot d'étranglement, passez directement au H200.
Puissance de calcul équivalente, interconnexion de même génération (NVLink 4 · 900 Go/s), toute la différence tient à la mémoire : 80 Go HBM3 / 3,35 To/s contre 141 Go HBM3e / 4,8 To/s ; 640 Go au total en configuration 8 GPU contre 1,128 To — R1 en FP8 complet (environ 690 Go) ne tient pas sur H100, alors que le H200 se déploie sur une seule machine. En une phrase : le H200 vend de la mémoire, le H100 vend du budget.
Le H100 est soumis aux contrôles à l'exportation américains vers la Chine depuis octobre 2022 ; en décembre 2025, c'est le H200 qui a obtenu l'approbation pour la Chine, pas le H100. Aucune vente publique du H100 n'existe sur les canaux officiels de Chine continentale, la circulation en spot relève de circuits gris. Cette information reflète la couverture médiatique publique et ne constitue pas un avis juridique ; avant tout achat, référez-vous aux politiques des autorités compétentes et à un avis de conformité professionnel.
Les deux générations se ressemblent beaucoup et les photos seules ne suffisent pas : vérifiez les marquages sérigraphiés et les rapports du firmware officiel, authentifiez les numéros de série via un canal indépendant, puis tranchez avec un test réel de mémoire vidéo — 80 Go contre 141 Go se vérifient d'un seul test (voir « Achat et réception » et « Comment stresser »).
Version SXM : 700 W, HBM3 3,35 To/s, interconnexion complète NVSwitch, format dominant des systèmes 8 GPU HGX ; version PCIe : 350 W, HBM2e 2 To/s, pas d'interconnexion haut débit sans pont bi-GPU. Les « H100 à bas prix » sont souvent des versions PCIe : le devis et le contrat doivent préciser explicitement le format d'encapsulation.
Fiches associées SEE ALSO
Comparaison et sélection des modèles COMPARE
Références REFERENCES
- Site officiel NVIDIA — page produit H100 (source principale des spécifications, vérifiée en 2026-10) https://www.nvidia.com/en-us/data-center/h100/
- Tom's Hardware — Nvidia Reveals Hopper H100 GPU With 80 Billion Transistors (annonce GTC de mars 2022) https://www.tomshardware.com
- Nvidia Launches Hopper H100 GPU, New DGXs and More(2022-03-22) https://www.hpcwire.com
- CRN — Nvidia H100 GPUs In Full Production, Shipping In October(2022-09-20 keynote) https://www.crn.com/news/components-peripherals/nvidia-h100-…
- Relations investisseurs NVIDIA — NVIDIA Hopper GPUs Expand Reach as Demand for AI Grows (21-03-2023, production du DGX H100 / première unité OpenAI) https://investor.nvidia.com/news/press-release-details/2023/…
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (chronologie des contrôles à l'exportation vers la Chine) https://www.congress.gov/crs-product/R48642
- Silicon Data — indice des prix de location du H100 : +10 % (09-01-2026) https://www.silicondata.com
- Prix de location H100 : +40 %, contrats d'un an dépassant 2 $/GPU·h (04-2026, selon des relais de presse) https://semianalysis.com
- H200 approuvé pour la Chine, prix module en circuit de revente d'environ 1,4 M RMB/module (24-12-2025, cf. entrée H200 [2])
- Agrégation des devis des revendeurs — H100 neuf environ 31 000 $/GPU (2026) https://benchgecko.ai
- Checking out the NVIDIA H100 in Our First Look at Hopper (photos du module) https://www.servethehome.com/checking-out-the-nvidia-h100-in…
- A Look at the Liquid Cooled Supermicro SYS-821GE-TNHR 8x NVIDIA H100 AI Server (photos du serveur refroidi par liquide) https://www.servethehome.com/a-look-at-the-liquid-cooled-sup…
- Données du flux tarifaire — AIXX Exchange (devis en vente sur la plateforme et fourchettes constatées chez les revendeurs, mise à jour quotidienne) /hall.html