AIXX Pedia › Ficha de modelo › H100

H100
Resumen OVERVIEW
H100 (nombre completo NVIDIA H100, perteneciente a la serie «Hopper») es la GPU para centros de datos presentada por NVIDIA en 22 de marzo de 2022 en el GTC y anunciada en producción en masa en septiembre de 2022 (envíos desde octubre): la obra fundacional de la generación Hopper, primera GPU en integrar el Transformer Engine (estreno de la precisión FP8) y primera en equipar memoria HBM3 y PCIe Gen5[1][2]。
Es la tarjeta que «apalancó la era de los grandes modelos»: tras la explosión de la carrera armamentística global de cómputo IA provocada por ChatGPT, el H100 llegó a ser la unidad de cómputo IA más cotizada del mundo, y por las restricciones de exportación a China se convirtió en un símbolo del pulso chipero entre EE. UU. y China (véase «Historia» y «Limitaciones y controversias»).
En el mercado de contado de 2026, el papel del H100 es el de base de volumen : el cómputo sigue siendo Hopper a pleno rendimiento, con el ecosistema más maduro y una demanda de alquiler que en 2025-2026 se reactivó (según cifras de índices públicos[7][8]), pero el tope físico de 80GB de memoria está siendo desplazado en precio generación a generación por el H200 (141GB) y el B300 (288GB): antes de comprarlo, confirma que tu cuello de botella no es la memoria.
Casos de uso FIT
AIXX Index (0–100): esta base lo estima con ponderación de especificaciones públicas: memoria 40% + interconexión 30% + ecosistema 30%, ajustando pesos según el escenario. 90+ gama tope · 75+ Excelente · 60+ utilizable · por debajo de 60, no recomendado. Metodología transparente y verificable; no constituye una promesa de rendimiento.
Historia HISTORY
22 de marzo de 2022 , GTC presenta la arquitectura Hopper y el H100: 80.000 millones de transistores, proceso custom TSMC 4N; el Transformer Engine lleva el FP8 a la serie principal de precisiones de GPU por primera vez, y es la primera GPU con HBM3 + PCIe Gen5[2][3]。
20 de septiembre de 2022 El keynote de otoño del GTC anuncia la producción en masa y envíos desde octubre[4]; 21 de marzo de 2023 El DGX H100 entra en producción disponible y la primera unidad se entrega a OpenAI[5]; en el año siguiente, el H100 se convierte en el absoluto protagonista de la expansión del cómputo IA mundial.
7 de octubre de 2022 , el control de exportaciones estadounidense somete el H100 a licencias para China; NVIDIA lanza sucesivamente las variantes A800/H800 (finales de 2022) y la línea H20 (envíos en 2024) para mantener el suministro a China, con varias interrupciones tras el endurecimiento de octubre de 2023 y la gestión de licencias del H20 en abril de 2025[6]. El H100 en sí nunca volvió a la lista de aprobaciones para China; en diciembre de 2025 lo aprobado fue el H200[9]。
2025-2026 , el H100 entra en fase de «base instalada»: el H200 y el B300 se van quedando con las compras nuevas generación a generación, pero la demanda de inferencia vuelve a empujar los precios de alquiler; el índice de alquiler subió en torno a un 10% entre diciembre de 2025 y enero de 2026[7], y en abril de 2026 los contratos anuales superan los $2/GPU·hora (cifras de análisis público[8]); en el mercado de contado sigue siendo el modelo Hopper con mayor volumen.
Especificaciones técnicas SPECIFICATIONS
| Concepto | Especificación (H100 SXM · cifras oficiales) |
|---|---|
| Núcleo GPU | NVIDIA Hopper GH100(SXM5) |
| Memoria por tarjeta | 80GB HBM3 |
| Ancho de banda de memoria | 3,35TB/s / tarjeta |
| FP8 Tensor Core | 3.958 TFLOPS (cifra con dispersidad) |
| FP16 / BF16 Tensor Core | 1.979 TFLOPS (cifra con dispersidad) |
| TF32 Tensor Core | 989 TFLOPS (cifra con dispersidad) |
| FP64 / FP64 Tensor | 34 / 67 TFLOPS |
| Interconexión GPU-GPU | NVLink de cuarta generación · 900GB/s + NVSwitch fully-connected |
| Consumo de la tarjeta (TBP/TGP) | Hasta 700W (configurable; versión PCIe 350W / versión NVL 350-400W) |
| Formatos de sistema dominantes | Basetboard HGX H100 de 8 tarjetas (refrigerado por aire / refrigerado por líquido) · DGX H100 |
| Generación anterior / producto equivalente | A100 80GB(Ampere)/ H200、B300 |
Las especificaciones se basan en la información pública oficial de NVIDIA[1]; toda la potencia Tensor es la cifra oficial «con dispersidad» (dense se reduce a la mitad); la configuración del sistema varía según OEM y lote.
Comparativa de generaciones · cuatro generaciones de un vistazo GENERATIONS
| Concepto | A100 80GB | H100 80GB | H200 | B300 |
|---|---|---|---|---|
| Memoria por tarjeta | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| Ancho de banda de memoria | ≈ 2TB/s | 3.35TB/s | 4.8TB/s | ≈ 8TB/s |
| Precisión distintiva | FP16 | FP8(Transformer Engine) | FP8 | FP4 |
| Interconexión GPU-GPU | NVLink 3 · 600GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| Selección en una frase | Continuidad del parque instalado | Presupuesto ajustado · mayor ecosistema | Gran memoria · caballo de batalla | Compra tope · siguiente generación |
Las especificaciones se basan en la información pública oficial de NVIDIA; véase la comparativa en las fichas de A100/H200/B300.
Miembros de la familia FAMILY
La familia H100 se divide en cuatro ramas según encapsulado y formato; en el mercado de contado de China continental y global domina el sistema HGX de 8 tarjetas (las disponibles en esta base son los HGX H100 de 8 de Supermicro / Dell / H3C / Gigabyte):
Refrigeración y despliegue COOLING
El H100 predominante es en formato refrigerado por aire, HGX de 8 tarjetas : la solución de torre de disipación SXM5 de clase 700W está madura y puede desplegarse en salas existentes, una de las razones de que siga siendo «el cómputo con menor barrera de adaptación». Las variantes refrigerado por líquido se extendieron desde 2023 con proyectos de alta densidad (como el sistema refrigerado por líquido Supermicro SYS-821GE-TNHR[12]), mientras que la versión H100 PCIe es una tarjeta de doble ranura de 350W refrigerado por aire, sin interconexión de baseboard.


Adaptación de modelos MODEL FIT
| Modelo / escenario | Necesidad de memoria (estimación FP8) | Despliegue en H100 (8 tarjetas, 640GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 completo (671B) | ≈ 690GB | No cabe en ocho tarjetas : requiere cuantización INT4 (unos 350GB, cabría) o despliegue multinodo; para una sola máquina a pleno rendimiento, mira el H200/B300 | 41 |
| R1-Distill clase 70B | ≈ 70GB | Cabe en una tarjeta de 80GB, con margen ajustado (hay que afinar el KV cache) | 82 |
| Modelos open source clase 72B | ≈ 72GB | Umbral de una sola tarjeta; en la práctica se suele adoptar paralelismo tensorial de dos tarjetas | 75 |
| Nivel 7B-14B (incluye modelos pequeños de generación de vídeo) | Aprox. 8-30 GB | Una sola tarjeta lo maneja con holgura; las líneas de producción por lotes escalan concurrencia con varias tarjetas | 90 |
La VRAM se estima con pesos FP8 ≈ nº de parámetros × 1 byte (criterio de cálculo; no incluye KV cache ni margen de activaciones); el AIXX Index es un criterio estimado de esta biblioteca y se actualiza con las mediciones. El despliegue de nivel 70B en una sola tarjeta es un caso límite; considérense los resultados medidos como referencia.
Galería GALLERY


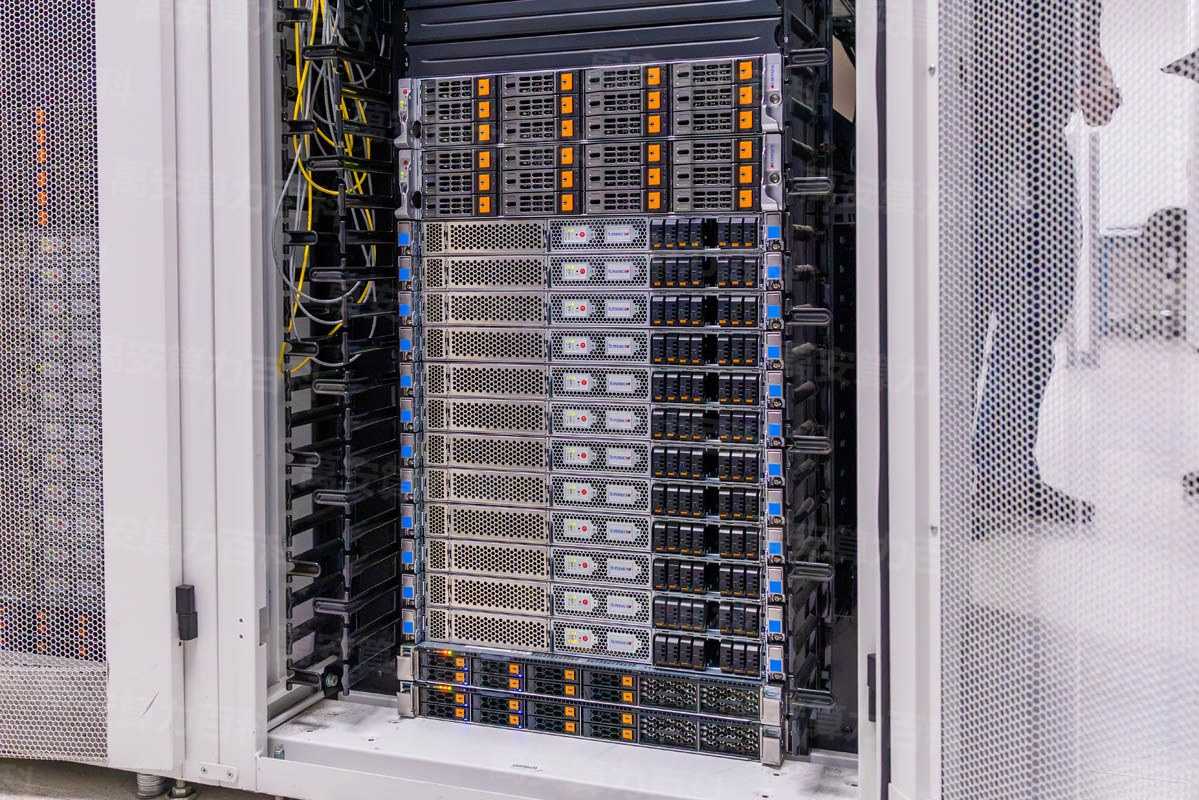
Las fotos reales se irán añadiendo con cada lote de inspección; no se publican imágenes generadas por IA haciéndolas pasar por fotos reales.
Vídeo explicativo VIDEO
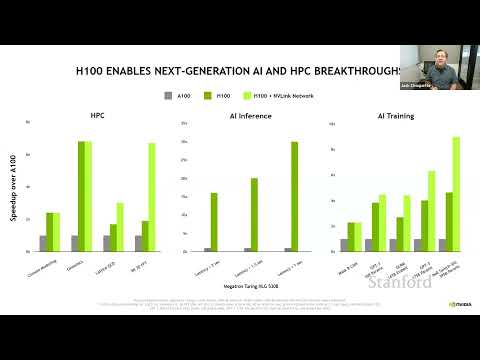
Este vídeo es una guía general de los seis criterios de prueba (los seis criterios son independientes del modelo); la versión específica de H100 está en cola de producción y, al publicarse, reemplazará a esta ficha con una portatura basada en datos reales de H100.
Equipo real de la comunidad · Fuente: YouTube COMMUNITY HANDS-ON
En algunas regiones puede que no se reproduzca directamente
Software y ecosistema ECOSYSTEM
| Concepto | Requisito / Situación actual |
|---|---|
| CUDA | Soporte Hopper desde la 11.8 (versión de lanzamiento); las actuales 12.x lo cubren por completo |
| Driver | Desde la serie 520 (lanzamiento); actualmente serie 550 o superior |
| Framework de entrenamiento | PyTorch / TensorFlow admiten Hopper oficialmente, el ecosistema más maduro |
| Motor de inferencia | vLLM / SGLang / TensorRT-LLM usan la H100 como modelo de referencia |
| Redes complementarias | ConnectX-7 400G o solución de interconexión equivalente |
| Sistema operativo | Distribuciones Linux principales (Ubuntu 22.04+ y similares) |
El ecosistema Hopper, tras más de tres años de maduración, es el más consolidado; la gran mayoría de benchmarks públicos de optimización de inferencia usan la H100 como modelo de referencia; las versiones del stack de software evolucionan con el tiempo, prevalece lo publicado oficialmente por NVIDIA.
Compra e inspección PROCUREMENT
Puntos clave de inspección para la compra de una H100 (tres):
Los seis criterios completos de prueba de burn-in (valores anclados a datos reales de la H100) se detallan en la sección «Cómo hacer la prueba de burn-in» de esta ficha.
Cómo hacer pruebas de estrés BENCH TEST
Seis criterios de prueba, todos con valores anclados a datos reales de la H100: identificación al desembalar → prueba de burn-in de una tarjeta (torre refrigerada por aire de 700 W, ≤85 ℃ y cero errores ECC = aprobado) → plena carga de todo el equipo → ancho de banda de memoria (nominal 3,35 TB/s, ≥85 % aprobado) → ancho de banda de interconexión (nccl-tests ≥750 GB/s, nominal 900 GB/s) → rendimiento de inferencia (≥80 % del benchmark público).
nvidia-smigpu-burn 3600 o dcgmi diag -r 3 · 30-60 minutosbandwidthTest(ejemplo incluido en CUDA)nccl-tests benchmark all_reducevLLM Cargar un modelo real y medirNota sobre criterios: las líneas de aprobado/excelente han sido elaboradas por esta biblioteca según criterios habituales de ingeniería (ancho de banda como porcentaje del valor nominal, temperatura según el límite habitual en centros de datos) y se irán calibrando con la acumulación de datos medidos de los informes de inspección; esta tabla no constituye compromiso alguno de aceptación; prevalece lo acordado en el contrato. Los apartados medidos del informe de inspección de esta biblioteca se registran según estos criterios; NOT_EXECUTED indica que la prueba no se ejecutó, y «no se ha medido» también es, en sí mismo, información relevante.
Transporte y entrega LOGISTICS
OEM y variantes VENDORS
Sobre una misma placa base HGX H100, los fabricantes de sistemas completos se diferencian en formato, refrigeración y servicios: al elegir, empieza por las diferencias (esta base de datos cubre cuatro de ellos):
| Fabricante | Formato representativo | Diferencias clave | Para quién |
|---|---|---|---|
| Supermicro | Sistema HGX H100 8 (doble formato: refrigerado por aire / refrigerado por líquido) | Caballo de batalla en volumen; los modelos refrigerados por líquido cuentan con reseñas completas de medios especializados[12] | Compra de stock disponible · búsqueda de relación calidad-precio |
| Dell | Serie PowerEdge (HGX H100 8) | Red de servicios global de primer nivel y soporte de nivel empresarial | Despliegues multinacionales · prioridad al servicio |
| H3C | Sistema HGX H100 8 | Red local de servicios y entrega, habitual en proyectos de Asia-Pacífico | Canales de Asia-Pacífico · servicio local |
| Gigabyte | Sistema HGX H100 8 | Configuración flexible, fuerte presencia en canales de Asia-Pacífico | Compras por canal de Asia-Pacífico |
| NVIDIA oficial | DGX H100 (sistema de 8 GPU) | Entrega integrada oficial, software full-stack y respaldo del fabricante; la primera unidad se entregó a OpenAI[5] | Quien quiera entrenar desde el primer día · soporte del fabricante |
AIXX Index · comparación de despliegue en cuatro dimensiones AIXX INDEX
| Fabricante | Facilidad de instalación | Facilidad de mantenimiento | Densidad de rendimiento | Expectativa de vida útil |
|---|---|---|---|---|
| Supermicro | 88 | 84 | 84 | 80 |
| Dell | 90 | 92 | 84 | 85 |
| H3C | 86 | 84 | 83 | 82 |
| Gigabyte | 85 | 80 | 85 | 80 |
| NVIDIA oficial | 92 | 88 | 82 | 85 |
El AIXX Index es la estimación de esta base de datos (0–100, basada en formato público, solución de refrigeración y diferencias en red de servicios), se actualiza con la verificación en unidades reales y no constituye un compromiso de compra. Las especificaciones concretas prevalecen según la publicación oficial del fabricante.
Fichas de términos GLOSSARY
Memoria HBM3
Memoria de alto ancho de banda apilada junto a la GPU. Cada H100 monta 80 GB de HBM3 con 3,35 TB/s de ancho de banda; hubo que esperar a la generación H200 para el salto a HBM3e. La capacidad de memoria es hoy el mayor punto débil del H100 al elegir configuración.
Interconexión NVLink 4
Cuarta generación de NVLink, con 900 GB/s de interconexión directa por GPU que, junto a NVSwitch, hace que ocho GPU operen como una sola; H100 y H200 comparten generación y velocidad.
Empaquetado SXM5 en placa
Las GPU se sueldan directamente a la placa base (no son tarjetas extraíbles); la placa HGX H100 de 8 GPU adopta justamente el formato SXM5. En la inspección debe verificarse también la placa base. El formato equivalente en tarjeta es la versión PCIe (350 W, HBM2e).
Transformer Engine / FP8
El motor de precisión mixta estrenado por el H100 consolidó el flotante de 8 bits como precisión dominante en entrenamiento e inferencia; estimación de memoria: pesos en FP8 ≈ nº de parámetros × 1 byte.
Controles de exportación y lotes de cumplimiento
Desde octubre de 2022 el H100 está sujeto al control de exportaciones de EE. UU. hacia China; las líneas de suministro ajustadas (A800/H800/H20) son variantes derivadas de ese control. Los lotes y la vía aduanera afectan la garantía y la retención de valor, y deben verificarse en la inspección. Esta base de datos se basa en información de reportes públicos y no constituye asesoría legal.
Novedades y eventos relacionados TIMELINE
Limitaciones y controversias LIMITS
- Techo duro de memoria : 80 GB HBM3 / 3,35 TB/s, ampliamente superado por el H200 (141 GB / 4,8 TB/s): DeepSeek R1 completo en FP8 requiere unos 690 GB, que los 640 GB de ocho H100 no alcanzan (estimación, véase «Adaptación de modelos»); esta es la raíz de la frontera de elección frente a los modelos sucesores.
- Protagonista del control de exportación a China : incluido en el primer lote de restricciones en octubre de 2022; después, líneas como A800/H800/H20 se ajustaron varias veces según las políticas. El H100 en sí aún no ha vuelto a la lista aprobada para China (lo aprobado en diciembre de 2025 fue el H200): no hay venta pública por canales regulados en China continental y el stock circulante pertenece a canales grises[6][9]. Esta base de datos solo recoge reportes públicos y no constituye asesoría legal.
- Presión de la generación Blackwell : el B300, con 288 GB de HBM3e, precisión FP4 y NVLink 5 (1,8 TB/s), abre una brecha de dos generaciones en precisión, y la cuota del H100 en las nuevas compras de cómputo sigue erosionándose.
- Riesgo de confusión entre versiones : la versión PCIe (HBM2e / 2 TB/s / 350 W / sin interconexión total NVSwitch) difiere mucho en rendimiento de la versión SXM; muchas cotizaciones de «H100 barato» corresponden a la versión PCIe. En cotización e inspección hay que identificar primero el formato de empaquetado.
- Riesgo de unidades reacondicionadas o suplantadas : el H100 y el H200 son exteriormente muy parecidos, y ya se han detectado casos de «H100 vendido como H200» en el mercado de stock (según informes de organismos de inspección); verificar la autenticidad del número de serie + medir la memoria real son pasos imprescindibles.
- Debate generacional sobre el cómputo : conviven la tesis del «H100 obsoleto» y la del «H100 que retiene valor»: la recuperación de tarifas de alquiler 2025-2026 (según índices públicos[7]) apoya lo segundo, mientras que la curva de reemplazo por Blackwell apoya lo primero; esta base de datos no toma partido, los datos están en «Tendencia de mercado».
Banda de mercado MARKET DATA
| Fecha | Criterio | Región | Banda de precio de referencia | Notas |
|---|---|---|---|---|
| 2026-10-20 | En vivo del hall | EE. UU. (USD) | $1,87 M – 1,87 M | 1 cotización › (criterio de precio por lote) |
| 2026-10-20 | En vivo del hall | China continental | ¥50.241.180 – 50.241.180 | 1 cotización › (criterio de precio por lote) |
| 2026-10-20 | En vivo del hall | Singapur (SGD) | S$3,60 M – 4,14 M | 3 cotizaciones (precio por lote) |
| 2026-10-20 | En vivo del hall | Oriente Medio (AED) | AED 3,60 M – 3,60 M | 1 cotización (precio por lote) |
| 2026-10-20 | En vivo del hall | Europa (EUR) | €2,91 M – 2,91 M | 1 cotización (precio por lote) |
| 2026-10-20 | En vivo del hall | Japón (JPY) | JPY 3,73 M – 3,73 M | 1 cotización (precio por lote) |
| 2026-10 | Referencia de canal | Global | Nueva, aprox. $31.000 por GPU | Agregación de cotizaciones públicas[10] · Sistemas en venta › |
| 2026-04 | Mercado de alquiler | Nube de Norteamérica | Contrato anual >$2 / GPU·h (+40 %) | Criterio de análisis público[8] |
| 2026-01 | Mercado de alquiler | Global | Índice de alquiler +10 % en un mes | Índice de alquiler de Silicon Data[7] |
| 2026-10 | Criterio regulatorio | China continental | Sin venta pública aprobada | El H100 no está en la lista aprobada para China; el stock circulante pertenece a canales grises (reportes públicos, no constituye asesoría legal) |
Criterio: Norteamérica es estimación anclada en 2023 a los precios públicos de sistemas completos ($28-35 mil por unidad) en los primeros envíos, con interpolación suave en la fase media; anclada al 2026-10 en la medición real en venta de $1,874 M por unidad (1 cotización), con sustitución punto a punto conforme se acumulan instantáneas diarias; China continental / Singapur / Europa / Japón / Oriente Medio son instantáneas reales en venta (CNY 5,024 M por unidad · 1 cotización · SGD 3,604-4,142 M · 3 cotizaciones · EUR 2,915 M / JPY 3,734 M / AED 3,601 M, 1 cotización cada una), todas en moneda original y sin conversión entre sí. Fuente de los datos de precios de esta base de datos: AIXX Exchange (intermediación sin comisión, no participa en las transacciones, no conoce ni especula con los precios de cierre; de ahí la neutralidad de los datos). La banda estimada es solo una referencia de tendencia; el precio real está sujeto a la cotización del vendedor.
Hitos de precios MILESTONES
Preguntas frecuentes FAQ
Analicemos el cuello de botella: para presupuestos ajustados, inferencia y fine-tuning de modelos por debajo del nivel 70B y escenarios HPC/FP64, la H100 sigue siendo la base con mayor ecosistema y mayor parque instalado del mercado de stock, y sus precios de alquiler incluso se recuperaron en 2025-2026 (según índices públicos). Pero 80 GB de VRAM son un límite duro para modelos de decenas de miles de millones de parámetros: si el cuello de botella es la memoria, mire directamente a la H200.
Potencia de cómputo equivalente e interconexión de la misma generación (NVLink 4 · 900GB/s); la diferencia está toda en la memoria: 80GB HBM3 / 3.35TB/s frente a 141GB HBM3e / 4.8TB/s; ocho tarjetas suman 640 GB frente a 1,128 TB: R1 completo en FP8 (unos 690 GB) no cabe en la H100, mientras que la H200 puede desplegarse en un solo nodo. En una frase: la H200 vende memoria, la H100 vende presupuesto.
La H100 está sujeta a los controles de exportación de EE. UU. hacia China desde octubre de 2022; en diciembre de 2025 el modelo aprobado para China fue la H200, y la H100 no está entre los aprobados; no hay venta pública por canales oficiales en China continental y la circulación de stock corresponde a canales grises. Este dato procede de informes públicos y no constituye asesoría legal: antes de comprar, aténgase a las políticas de las autoridades competentes y a un dictamen profesional de cumplimiento.
Ambas generaciones son muy parecidas exteriormente y las fotos no bastan: verifique el serigrafado y los informes de firmware oficiales, valide el número de serie por canales independientes y remate con una medición real de la VRAM: 80 GB frente a 141 GB se detectan de inmediato (véase «Compra e inspección» y «Cómo hacer pruebas de estrés»).
Versión SXM: 700 W, HBM3 a 3.35TB/s, malla completa NVSwitch; es el formato dominante en sistemas completos HGX de 8 tarjetas. Versión PCIe: 350 W, HBM2e a 2TB/s, sin interconexión de alta velocidad si no hay puente de doble tarjeta. Las «H100 baratas» suelen ser versión PCIe; cotización y contrato deben especificar siempre el formato de encapsulado.
Entradas relacionadas SEE ALSO
Comparativa y elección de modelos COMPARE
Referencias REFERENCES
- NVIDIA web oficial — página del producto H100 (archivo principal de especificaciones, verificado en 2026-10) https://www.nvidia.com/en-us/data-center/h100/
- Tom's Hardware — Nvidia Reveals Hopper H100 GPU With 80 Billion Transistors (cobertura de la presentación en GTC, 2022-03) https://www.tomshardware.com
- Nvidia Launches Hopper H100 GPU, New DGXs and More(2022-03-22) https://www.hpcwire.com
- CRN — Nvidia H100 GPUs In Full Production, Shipping In October(2022-09-20 keynote) https://www.crn.com/news/components-peripherals/nvidia-h100-…
- NVIDIA Relaciones con Inversores — NVIDIA Hopper GPUs Expand Reach as Demand for AI Grows (2023-03-21, producción en masa de la DGX H100 / primera unidad a OpenAI) https://investor.nvidia.com/news/press-release-details/2023/…
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (Cronología de los controles de exportación hacia China) https://www.congress.gov/crs-product/R48642
- Silicon Data — índice de precios de alquiler de la H100 +10% (2026-01-09) https://www.silicondata.com
- Alquiler de la H100 +40%, contratos anuales superan los $2/GPU·hora (2026-04, según fuentes citadas) https://semianalysis.com
- H200 aprobada para China, precio de canal de módulos de unos 1,4 millones de yenes por módulo (2025-12-24, ídem entrada H200 [2])
- Agregador de cotizaciones de canal — H100 nueva a unos $31,000/tarjeta (2026) https://benchgecko.ai
- Checking out the NVIDIA H100 in Our First Look at Hopper (fotos reales del módulo) https://www.servethehome.com/checking-out-the-nvidia-h100-in…
- A Look at the Liquid Cooled Supermicro SYS-821GE-TNHR 8x NVIDIA H100 AI Server (fotos del equipo refrigerado por líquido) https://www.servethehome.com/a-look-at-the-liquid-cooled-sup…
- Datos de la banda de cotizaciones — AIXX Exchange (cotizaciones a la venta en esta plataforma e intervalos conocidos de canal, actualización diaria) /hall.html