AIXX Pedia › Modelleintrag › H100

H100
ÜberblickOVERVIEW
H100(vollständig NVIDIA H100, aus der „Hopper“-Serie) ist eine von NVIDIA am 22. März 2022 auf der GTC vorgestellte und am 20. September 2022 offiziell zur Serienfertigung freigegebene (Auslieferung ab Oktober) Datacenter-GPU: das Gründungsmodell der Hopper-Generation, die erste GPU mit Transformer Engine (FP8-Premiere) sowie die erste mit HBM3-Grafikspeicher und PCIe Gen5[1][2]。
Es ist die Karte, die das Zeitalter der großen Modelle aufgestoßen hat: Nachdem ChatGPT das globale Rechenleistungs-Rüstungswettrennen entfacht hatte, wurde die H100 zeitweise zur begehrtesten Einheit für KI-Rechenleistung weltweit – und ist durch die Exportkontrollen nach China zum Sinnbild des Chip-Streits zwischen den USA und China geworden (siehe „Historie“ sowie „Grenzen und Kontroversen“).
Auf dem Spotmarkt 2026 ist die Rolle der H100 die des Massenware-Basisangebots: Die Rechenleistung ist weiterhin volle Hopper, das Ökosystem am ausgereiftesten, und die Mietnachfrage hat sich 2025–2026 sogar wieder erholt (öffentliche Indexdaten[7][8]), doch die harte Obergrenze von 80GB Videospeicher gerät durch die H200 (141GB) und B300 (288GB) zunehmend unter Preisdruck – prüfen Sie vor dem Kauf, ob Ihr Engpass wirklich nicht der Videospeicher ist.
EinsatzszenarienFIT
AIXX Index(0–100): gewichtete Schätzung auf Basis öffentlicher Spezifikationen — Speicher 40 % + Interconnect 30 % + Ökosystem 30 %, je nach Szenario angepasst. 90+ Flaggschiff · 75+ Ausgezeichnet · 60+ brauchbar · unter 60 nicht geeignet. Transparente, überprüfbare Methodik, keine Leistungs zusage.
EntwicklungsgeschichteHISTORY
22. März 2022, auf der GTC Vorstellung der Hopper-Architektur und der H100: 80 Milliarden Transistoren, TSMC-4N-Sonderprozess; die Transformer Engine brachte FP8 erstmals in die Hauptpräzisionsreihe von GPUs, zudem erste GPU mit HBM3 und PCIe Gen5[2][3]。
20. September 2022 Herbst-Keynote der GTC: offizielle Serienfertigung angekündigt, Auslieferung ab Oktober[4];21. März 2023 DGX H100 serienmäßig bestellbar, erstes System an OpenAI ausgeliefert[5]; in den folgenden Jahren wurde die H100 zur absoluten Hauptkraft des globalen KI-Rechenleistungsausbaus.
7. Oktober 2022, die US-Exportkontrollen stellten die H100 unter Lizenzpflicht für China; NVIDIA brachte nacheinander die Sondervarianten A800/H800 (Ende 2022) und die H20-Sonderlinie (ausgeliefert 2024) für die chinesische Versorgung, die mit der Verschärfung der Kontrollen im Oktober 2023 und der H20-Lizenzpflicht im April 2025 mehrfach unterbrochen wurden[6]. Die H100 selbst kehrte nie auf die Freigabeliste für China zurück – im Dezember 2025 freigegeben wurde die H200[9]。
2025–2026, trat die H100 in ihre „Bestands-Basisphase“ ein: H200/B300 übernahmen nach und nach die Neubeschaffungen, doch die Inferenznachfrage trieb die Mietpreise erneut nach oben – der Mietpreisindex stieg von Dezember 2025 bis Januar 2026 um rund 10%[7]; im April 2026 überstiegen Jahresvertragsmieten $2 pro GPU·Stunde (öffentliche Analysedaten[8]), am Spotmarkt bleibt sie die meistgehandelte Hopper-Variante.
Technische DatenSPECIFICATIONS
| Punkt | Spezifikationen (H100 SXM · offizielle Angaben) |
|---|---|
| GPU-Kern | NVIDIA Hopper GH100(SXM5) |
| Speicher pro Karte | 80GB HBM3 |
| Speicherbandbreite | 3,35TB/s / Karte |
| FP8 Tensor Core | 3.958 TFLOPS (mit Sparsity) |
| FP16 / BF16 Tensor Core | 1.979 TFLOPS (mit Sparsity) |
| TF32 Tensor Core | 989 TFLOPS (mit Sparsity) |
| FP64 / FP64 Tensor | 34 / 67 TFLOPS |
| GPU-zu-GPU-Interconnect | NVLink vierte Generation · 900GB/s + NVSwitch-Full-Mesh |
| Board-Power (TBP/TGP) | bis 700W (konfigurierbar; PCIe-Version 350W / NVL-Version 350–400W) |
| Übliche Systemformate | HGX H100 8-Karten-Baseboard (luftgekühlt / flüssigkeitsgekühlt) · DGX H100 |
| Vorgänger / Gegenstück | A100 80GB(Ampere)/ H200、B300 |
Spezifikationen gemäß offiziellen öffentlichen NVIDIA-Unterlagen[1]; sämtliche Tensor-Leistungsangaben sind offizielle Werte „mit Sparsity“, Dense-Werte halbiert; Systemkonfigurationen variieren je nach OEM und Charge.
Generationenvergleich · vier Generationen im ÜberblickGENERATIONS
| Punkt | A100 80GB | H100 80GB | H200 | B300 |
|---|---|---|---|---|
| Speicher pro Karte | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| Speicherbandbreite | ca. 2TB/s | 3.35TB/s | 4.8TB/s | ca. 8TB/s |
| Leitpräzision | FP16 | FP8(Transformer Engine) | FP8 | FP4 |
| GPU-zu-GPU-Interconnect | NVLink 3 · 600GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| Auswahl in einem Satz | Fortsetzung des installierten Bestands | Budgetlimit · größtes Ökosystem | Großer Speicher · Volumenmodell | Flaggschiff-Neukauf · nächste Generation |
Spezifikationen gemäß offiziellen NVIDIA-Veröffentlichungen; A100/H200/B300-Werte siehe jeweilige Einträge zum Vergleich.
FamilienmitgliederFAMILY
Die H100-Familie umfasst je nach Packaging und Formfaktor vier Zweige; auf dem Spotmarkt in China und weltweit dominieren HGX-8-Karten-Systeme (in diesem Shop erhältlich: HGX H100 8 von Supermicro / Dell / H3C / Gigabyte):
Kühlung und DeploymentCOOLING
Bei der H100 überwiegt luftgekühlte HGX-8-Karten-Konfiguration der Standard: Mit ausgereiften Kühlungslösungen für 700W-SXM5-Module ist der Einbau in bestehende Rechenzentren problemlos möglich – einer der Gründe, warum sie bis heute die „Rechenleistung mit den geringsten Umbauanforderungen“ bleibt. Flüssigkeitsgekühlte Varianten werden seit 2023 mit Hochdichte-Projekten ausgerollt (z. B. das flüssigkeitsgekühlte Komplettsystem Supermicro SYS-821GE-TNHR[12]), während die H100 PCIe als 350W-Doppelslot-Karte mit Luftkühlung ohne Baseboard-Full-Mesh auskommt.


ModellkompatibilitätMODEL FIT
| Modell / Szenario | Speicherbedarf (FP8-Schätzung) | H100-Bereitstellung (8 Karten, 640GB) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 in voller Größe (671B) | ca. 690GB | Acht Karten reichen nicht – es braucht INT4-Quantisierung (rund 350GB, passt) oder eine verteilte Bereitstellung über mehrere Maschinen; für die Vollversion auf einem System siehe H200/B300 | 41 |
| R1-Distill-70B-Klasse | ca. 70 GB | Auf Einzelkarte 80GB möglich, Reserve knapp (KV-Cache muss sorgfältig bemessen werden) | 82 |
| Open-Source-Modelle der 72B-Klasse | ca. 72GB | Grenzwertig auf Einzelkarte, in der Praxis meist Tensor-Parallelismus über zwei Karten | 75 |
| 7B–14B-Klasse (einschließlich kleiner Videogenerierungsmodelle) | rund 8–30GB | Auf Einzelkarte leicht möglich, für Batch-Pipelines werden mehrere Karten für Parallelität gestapelt | 90 |
Speicherbedarf geschätzt mit FP8-Gewichten ≈ Parameterzahl × 1 Byte (Schätzwert, ohne KV-Cache und Aktivierungsreserve); der AIXX Index ist eine Schätzgröße dieses Shops und wird mit Messungen aktualisiert. Der 70B-Einzelkarteneinsatz ist ein Grenzfall – maßgeblich sind Messwerte.
BildergalerieGALLERY


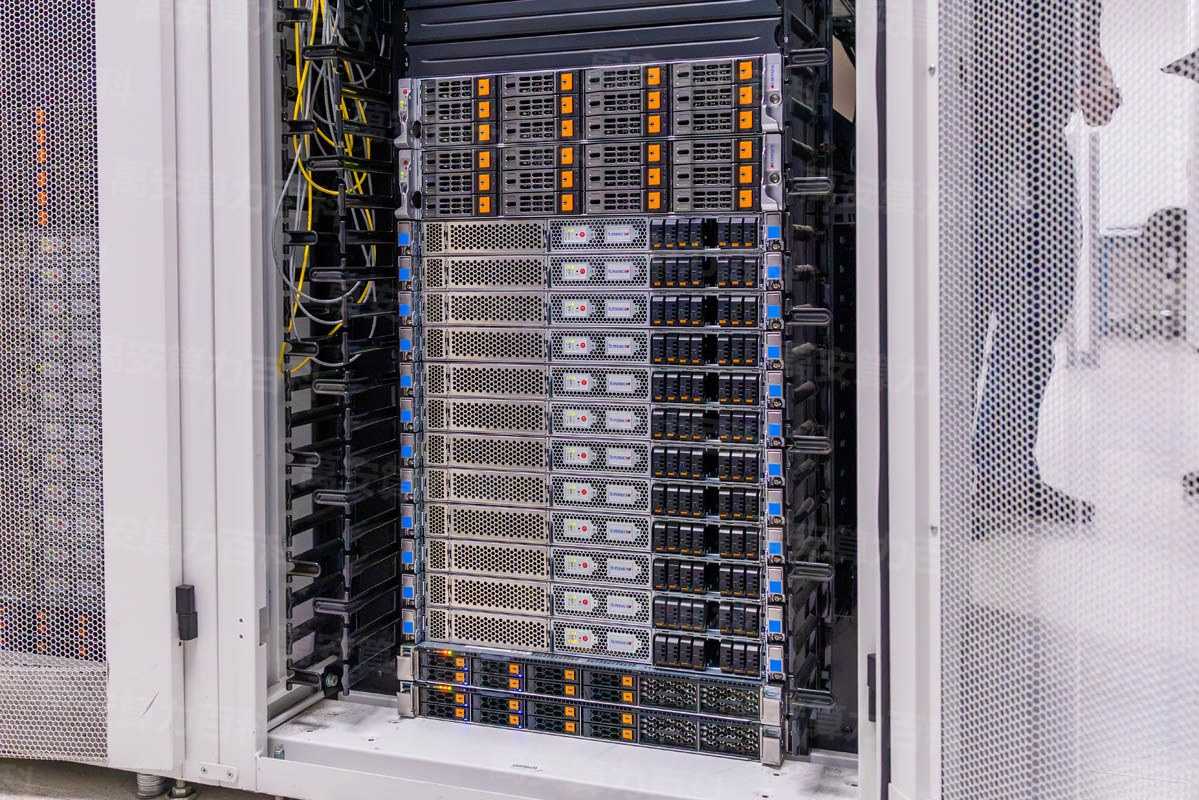
Echte Aufnahmen werden laufend mit den jeweiligen Prüfchargen ergänzt; KI-generierte Bilder werden nicht als echt ausgegeben.
Video-ErklärungVIDEO
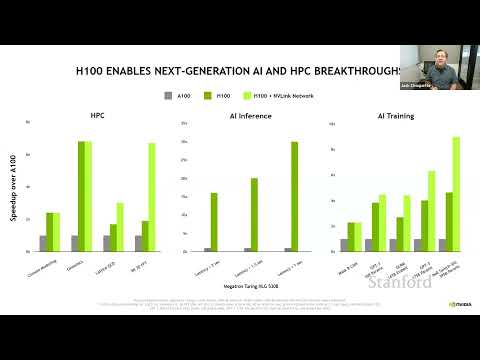
Dieses Video ist das allgemeine Burn-in-Test-Referenzvideo (die sechs Prüfkriterien sind modellunabhängig); die H100-spezifische Version ist in der Produktionspipeline und wird nach Veröffentlichung diese Karte ersetzen – mit H100-Messwert-Cover.
Community-Material · Quelle YouTubeCOMMUNITY HANDS-ON
In manchen Regionen ist die direkte Wiedergabe möglicherweise nicht verfügbar
Software und ÖkosystemECOSYSTEM
| Punkt | Anforderung / Status |
|---|---|
| CUDA | Ab 11.8 Hopper-Support (Premierversion), aktuelle 12.x vollständig abgedeckt |
| Treiber | Ab der 520er-Serie (Premiere), aktuell 550er-Serie und höher |
| Trainings-Frameworks | PyTorch / TensorFlow unterstützen Hopper offiziell – das ausgereifteste Ökosystem |
| Inferenz-Engines | vLLM / SGLang / TensorRT-LLM nutzen die H100 als Benchmark-Referenzmodell |
| Netzwerk-Infrastruktur | ConnectX-7 400G oder gleichwertige Interconnect-Lösung |
| Betriebssysteme | Gängige Linux-Distributionen (Ubuntu 22.04+ usw.) |
Das Hopper-Ökosystem ist nach über drei Jahren das ausgereifteste; die allermeisten öffentlichen Inferenz-Benchmarks nehmen die H100 als Referenz. Die Softwarestack-Versionen entwickeln sich weiter – maßgeblich sind die offiziellen NVIDIA-Veröffentlichungen.
Beschaffung und WarenprüfungPROCUREMENT
Drei Prüfpunkte beim H100-Einkauf:
Vollständige sechs Burn-in-Test-Kriterien (Werte: H100-Referenz) im Modelleintrag„Burn-in-Test durchführen“dieses Eintrags.
Burn-in-Tests durchführenBENCH TEST
Sechs Burn-in-Test-Kriterien, alle Wertbeispiele nach H100-Referenz: Auspack-Identifikation → Einzelkarten-Burn-in-Test (700W luftgekühlt, ≤85°C, null ECC-Fehler = Bestanden) → Volllast des Gesamtsystems → Speicherbandbreite (Nennwert 3,35TB/s, ≥85% = Bestanden) → Interconnect-Bandbreite (nccl-tests ≥750GB/s, Nennwert 900GB/s) → Inferenz-Durchsatz (≥80% des öffentlichen Benchmarks).
nvidia-smigpu-burn 3600 oder dcgmi diag -r 3 · 30–60 MinutenbandwidthTest(mitgeliefertes CUDA-Beispiel)nccl-tests all_reduce-BenchmarkvLLM Echtes Modell unter Last bringenMethodik-Hinweis: Die Grenzwerte für „Bestanden“/„Ausgezeichnet“ sind von dieser Datenbank nach gängigen technischen Kriterien zusammengestellt (Bandbreite anteilig zum Nennwert, Temperatur gemäß branchenüblichem Datacenter-Limit) und werden mit wachsender Zahl von Prüfberichten schrittweise kalibriert. Diese Tabelle stellt keinerlei Abnahmezusage dar; maßgeblich sind ausschließlich die vertraglichen Vereinbarungen.Die Messpunkte in den Prüfberichten dieser Datenbank werden exakt nach dieser Tabelle dokumentiert – NOT_EXECUTED bedeutet, der Punkt wurde nicht geprüft; auch ein „nicht gemessen“ ist eine wichtige Information.
Versand und LieferungLOGISTICS
OEM und VariantenVENDORS
Gleiches HGX-H100-Baseboard, die Systeme der Hersteller unterscheiden sich in Formfaktor, Kühlung und Service – die Auswahl beginnt mit den Unterschieden (in diesem Shop sind vier davon erhältlich):
| Systemhersteller | Leitformfaktor | Unterscheidungsmerkmale | Für wen geeignet |
|---|---|---|---|
| Supermicro | HGX H100 8 Systeme (luftgekühlt / flüssigkeitsgekühlt) | Massenware-Arbeitspferd; flüssigkeitsgekühlte Modelle wurden von Fachmedien ausführlich getestet[12] | Spot-Kauf · Fokus Preis-Leistung |
| Dell | PowerEdge-Serie (HGX H100 8) | Erstklassiges globales Servicenetzwerk und Enterprise-Support | Multinationale Bereitstellung · Service im Fokus |
| H3C | HGX H100 8 System | lokaler Service und Liefernetzwerk, häufig bei Projekten im asiatisch-pazifischen Raum | APAC-Kanal · lokaler Service |
| Gigabyte | HGX H100 8 System | Flexible Konfiguration, starker APAC-Kanal | Beschaffung über APAC-Kanäle |
| NVIDIA offiziell | DGX H100 (8-Karten-System) | offizielle Komplettlösung mit Full-Stack-Software und Hersteller-Backing, erstes System an OpenAI[5] | Wer sofort training will · Wer Herstellersupport braucht |
AIXX Index · Vierdimensionaler BereitstellungsvergleichAIXX INDEX
| Systemhersteller | Einfache Installation | Wartungsfreundlichkeit | Leistungsdichte | Erwartete Lebensdauer |
|---|---|---|---|---|
| Supermicro | 88 | 84 | 84 | 80 |
| Dell | 90 | 92 | 84 | 85 |
| H3C | 86 | 84 | 83 | 82 |
| Gigabyte | 85 | 80 | 85 | 80 |
| NVIDIA offiziell | 92 | 88 | 82 | 85 |
Der AIXX Index ist eine Schätzgröße dieser Datenbank (0–100, Grundlage: öffentliche Formfaktor-, Kühl- und Servicenetzdifferenzen) und wird mit der Praxisvalidierung aktualisiert; er stellt keine Kaufofferte dar. Maßgeblich für konkrete Modelle sind die offiziellen Herstellerangaben.
BegriffskartenGLOSSARY
HBM3-Speicher
Hochbandbreitspeicher, gestapelt neben dem GPU-Die. Die H100 bietet 80GB HBM3 pro Karte mit 3,35TB/s – erst die H200-Generation stieg auf HBM3e um. Die Speicherkapazität ist derzeit die größte Auswahlschwäche der H100.
NVLink-4-Interconnect
Vierte NVLink-Generation, 900GB/s direkte Verbindung pro Karte, die mit NVSwitch acht GPUs wie einen einzigen Verbund arbeiten lässt; H100 und H200 nutzen dieselbe Generation mit gleicher Geschwindigkeit.
SXM5-Sockelformat
Der GPU ist direkt auf das Baseboard gelötet (keine Steckkarte); das HGX-H100-8-Baseboard entspricht dem SXM5-Formfaktor – bei der Prüfung muss das Baseboard einbezogen werden. Das Gegenstück als Steckkarte ist die PCIe-Version (350W, HBM2e).
Transformer Engine / FP8
Die von der H100 eingeführte gemischte Präzision-Engine machte 8-Bit-Fließkomma zur Standardpräzision für Training und Inferenz; Speicherbedarf schätzen: FP8-Gewichte ≈ Parameterzahl × 1 Byte.
Exportkontrollen und Compliance-Chargen
Die H100 steht seit Oktober 2022 unter US-Exportkontrollen für China; die Sonderlinien (A800/H800/H20) sind daraus abgeleitete Anpassungsmodelle. Charge und Zollweg beeinflussen Garantie und Werterhalt und gehören zwingend in die Warenprüfung. Alle Angaben dieses Shops beruhen auf öffentlichen Berichten und stellen keine Rechtsberatung dar.
Grenzen und KontroversenLIMITS
- Harte Speicherobergrenze: 80GB HBM3 / 3,35TB/s, von der H200 (141GB / 4,8TB/s) deutlich überboten – DeepSeek R1 in voller FP8-Ausstattung benötigt rund 690GB, acht H100 mit 640GB reichen nicht (Schätzwert, siehe „Modellkompatibilität“). Dies ist der Kerngrund für die Auswahlgrenze zu den Nachfolgemodellen.
- Hauptfigur der Exportkontrollen nach China: im Oktober 2022 zuerst unter Kontrollen gestellt, danach wurden die Sonderlinien A800/H800/H20 mehrfach an die Politik angepasst; die H100 selbst steht bis heute nicht wieder auf den Freigabelisten für China (im Dezember 2025 wurde die H200 freigegeben) – auf dem regulierten chinesischen Markt kein offizieller Verkauf, Spotmarkt-Vertrieb läuft über Graukanäle[6][9]. Dieser Shop dokumentiert ausschließlich öffentliche Berichte und gibt keine Rechtsberatung.
- Verdrängung durch die Blackwell-Generation: Die B300 setzt mit 288GB HBM3e, FP4-Präzision und NVLink 5 (1,8TB/s) zwei Präzisionsstufen Generationsabstand – der Anteil der H100 an Neubeschaffungen von Rechenleistung sinkt kontinuierlich.
- Stolperfalle Versionsvielfalt: Die PCIe-Version (HBM2e / 2TB/s / 350W / ohne NVSwitch-Full-Mesh) weist einen großen Leistungsabstand zur SXM-Version auf; „günstige H100“-Angebote betreffen meist die PCIe-Version – bei Angebot und Warenprüfung zuerst den Formfaktor klären.
- Risiko von Refurbished und Fälschungen: H100 und H200 sehen extrem ähnlich aus; der Fall „H100 als H200 ausgeben“ ist bereits am Spotmarkt dokumentiert (Angaben von Prüfinstitutionen). Unabhängige Seriennummern-Verifikation plus Speichermessung sind Pflicht.
- Kontroverse um die Rechenleistung der Generation: Die These „H100 ist veraltet“ und die These „H100 hält ihren Wert“ existieren nebeneinander – die erholten Mietpreise 2025–2026 (öffentliche Indexdaten[7]) stützen Letzteres, die Blackwell-Verdrängungskurve Ersteres; dieser Shop trifft keine Festlegung, die Daten finden sich im „Marktdatenband“.
MarktdatenMARKET DATA
| Datum | Methodik | Region | Referenzpreis-Band | Anmerkung |
|---|---|---|---|---|
| 2026-10-14 | Live im Marktplatz | USA (USD) | $1,87 Mio. – 1,87 Mio. | 1 Angebot ›(Chargen-Angebotspreis) |
| 2026-10-14 | Live im Marktplatz | Festlandchina | ¥5.024.118 – 5.024.118 | 1 Angebot ›(Chargen-Angebotspreis) |
| 2026-10-14 | Live im Marktplatz | Singapur (SGD) | S$360 Tsd. – 414 Tsd. | 3 Angebote (Chargen-Angebotspreis-Basis) |
| 2026-10-14 | Live im Marktplatz | Naher Osten (AED) | AED 3,60 Mio. – 3,60 Mio. | 1 Angebot (Chargen-Angebotspreis-Basis) |
| 2026-10-14 | Live im Marktplatz | Europa (EUR) | €291.000 – 291.000 | 1 Angebot (Chargen-Angebotspreis-Basis) |
| 2026-10-14 | Live im Marktplatz | Japan (JPY) | JPY 3,73 Mio. – 3,73 Mio. | 1 Angebot (Chargen-Angebotspreis-Basis) |
| 2026-10 | Kanalreferenz | Global | Neukarte ca. $31.000 / Karte | Aggregierte öffentliche Angebotsbasis[10] · Verfügbare Systeme › |
| 2026-04 | Mietmarkt | Nordamerikanische Cloud | Einjahresvertrag >$2 / GPU·Std. (+40%) | Öffentliche Analysebasis[8] |
| 2026-01 | Mietmarkt | Global | Mietpreisindex +10% im Monatsvergleich | Silicon Data Mietpreisindex[7] |
| 2026-10 | Politikbasis | Festlandchina | Keine genehmigten öffentlichen Verkäufe | H100 ist nicht auf der Genehmigungsliste für China; der Spotmarkt läuft über Graukanäle (öffentliche Berichterstattung, keine Rechtsberatung) |
Methodik:Nordamerika als Schätzbasis— rückwirkend verankert am öffentlich berichteten Systempreis von $280.000–350.000 je Einheit zum Auslieferungsbeginn 2023, verankert am 2026-10 mit tatsächlich angebotenen Systemen am Verkaufsstart $1,874 Mio. je Einheit(1 Angebot), interpolierter langsamer Anstieg im mittleren Segment, schrittweise ersetzt durch tägliche Schnappschüsse; Festlandchina/Singapur/Europa/Japan/Naher Osten basieren auf tatsächlich angebotenen Schnappschüssen (CNY 5,024 Mio. je Einheit · 1 Angebot · SGD 3,604–4,142 Mio. · 3 Angebote · EUR 291.500 / JPY 3,734 Mio. / AED 3,601 Mio. je 1 Angebot), jeweils in Originalwährung, nicht umgerechnet. Preisdatenquellen dieser Datenbank:AIXX Börse(Provisionsfreie Vermittlung, keine Teilnahme an Transaktionen; Abschlusspreise werden weder erfasst noch spekuliert, weshalb die Daten neutral sind). Die berechnete Spanne dient ausschließlich der Trendreferenz; der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers.
Preis-MeilensteineMILESTONES
Häufige FragenFAQ
Es kommt auf den Engpass an: Bei budgetkritischen Workloads, Inferenz und Feintuning unterhalb des 70B-Segments sowie HPC/FP64-Szenarien bleibt der H100 die volumenstärkste Basis mit dem größten Ökosystem am Spotmarkt – die Mietpreise 2025–2026 haben sich sogar wieder erholt (öffentliche Indexbasis). Aber 80 GB Videospeicher sind für Modelle im hundert-Milliarden-Bereich eine harte Obergrenze – liegt der Engpass am Speicher, führt kein Weg am H200 vorbei.
Gleiche Rechenleistung, gleiche Interconnect-Generation (NVLink 4 · 900 GB/s) – der Unterschied liegt allein beim Speicher: 80 GB HBM3 / 3,35 TB/s gegenüber 141 GB HBM3e / 4,8 TB/s; acht Karten ergeben 640 GB gegenüber 1,128 TB – R1 in voller FP8-Ausbaustufe (ca. 690 GB) passt nicht auf H100, auf dem H200 lässt es sich auf einem Einzelknoten betreiben. Kurz gesagt: Das H200 verkauft Speicher, das H100 verkauft Budget.
Der H100 untersteht seit Oktober 2022 den US-Exportkontrollen für China; im Dezember 2025 wurde das H200 genehmigt, der H100 nicht. Auf dem chinesischen Festland gibt es keinen regulären öffentlichen Verkauf, der Spotmarkt läuft über Graukanäle. Diese Angabe basiert auf öffentlicher Berichterstattung und stellt keine Rechtsberatung dar; vor Beschaffung gelten die Vorgaben der zuständigen Behörden und professionelle Compliance-Einschätzungen.
Beide Generationen sehen sich zum Verwechseln ähnlich – Fotos allein sind nicht verlässlich: Aufdrucke prüfen, Firmware-Reports und Seriennummern über unabhängige Kanäle verifizieren und schließlich mit einem Speichertest Klarheit schaffen – 80 GB und 141 GB zeigen sich sofort (siehe „Beschaffung & Abnahme“ und „Stresstest“).
SXM-Version: 700 W, HBM3 mit 3,35 TB/s, vollständig vernetzt via NVSwitch – die dominierende Form des HGX-8-GPU-Systems; PCIe-Version: 350 W, HBM2e mit 2 TB/s, ohne Dual-Karten-Bridge keine High-Speed-Interconnect. „Günstige H100“ sind meist PCIe-Versionen; Angebot und Vertrag müssen die Package-Form ausdrücklich nennen.
Verwandte EinträgeSEE ALSO
Modellvergleich & AuswahlCOMPARE
QuellenREFERENCES
- NVIDIA-Website — H100-Produktseite (Spezifikationsreferenz, verifiziert 2026-10) https://www.nvidia.com/en-us/data-center/h100/
- Tom's Hardware — Nvidia Reveals Hopper H100 GPU With 80 Billion Transistors (GTC-Bericht, 2022-03) https://www.tomshardware.com
- Nvidia Launches Hopper H100 GPU, New DGXs and More(2022-03-22) https://www.hpcwire.com
- CRN — Nvidia H100 GPUs In Full Production, Shipping In October(2022-09-20 keynote) https://www.crn.com/news/components-peripherals/nvidia-h100-…
- NVIDIA Investor Relations — NVIDIA Hopper GPUs Expand Reach as Demand for AI Grows (2023-03-21, DGX-H100-Serienproduktion / erste Einheit an OpenAI) https://investor.nvidia.com/news/press-release-details/2023/…
- CRS R48642: U.S. Export Controls and China: Advanced Semiconductors (Chronologie der Exportkontrollen gegenüber China) https://www.congress.gov/crs-product/R48642
- Silicon Data — H100-Mietpreisindex +10% (2026-01-09) https://www.silicondata.com
- H100-Mietpreis +40%, Einjahresverträge übersteigen $2/GPU·Std. (2026-04, nach Berichten) https://semianalysis.com
- H200 für China genehmigt, Kanal-Modulpreis ca. 1,4 Mio. CNY je Modul (2025-12-24, siehe H200-Eintrag [2])
- Aggregierte Kanalangebote — Neuer H100 ca. $31.000/Karte (Basis 2026) https://benchgecko.ai
- Checking out the NVIDIA H100 in Our First Look at Hopper (Modulfotos) https://www.servethehome.com/checking-out-the-nvidia-h100-in…
- A Look at the Liquid Cooled Supermicro SYS-821GE-TNHR 8x NVIDIA H100 AI Server (flüssigkeitsgekühltes Komplettsystem, Fotos) https://www.servethehome.com/a-look-at-the-liquid-cooled-sup…
- Marktdatenband — AIXX Exchange (angebotene Preise und eingeholte Kanalbereiche dieser Plattform, täglich aktualisiert) /hall.html