Fiche technique SPEC CARD
NVIDIA L40S
GPU Ada 48 Go polyvalent pour l'inférence, le rendu et Omniverse en une seule carte, jusqu'à 1 466 TF en FP8 sparse + encodage/décodage AV1 — l'une des cartes Ada à grande mémoire les plus disponibles en stock sur le marché chinois
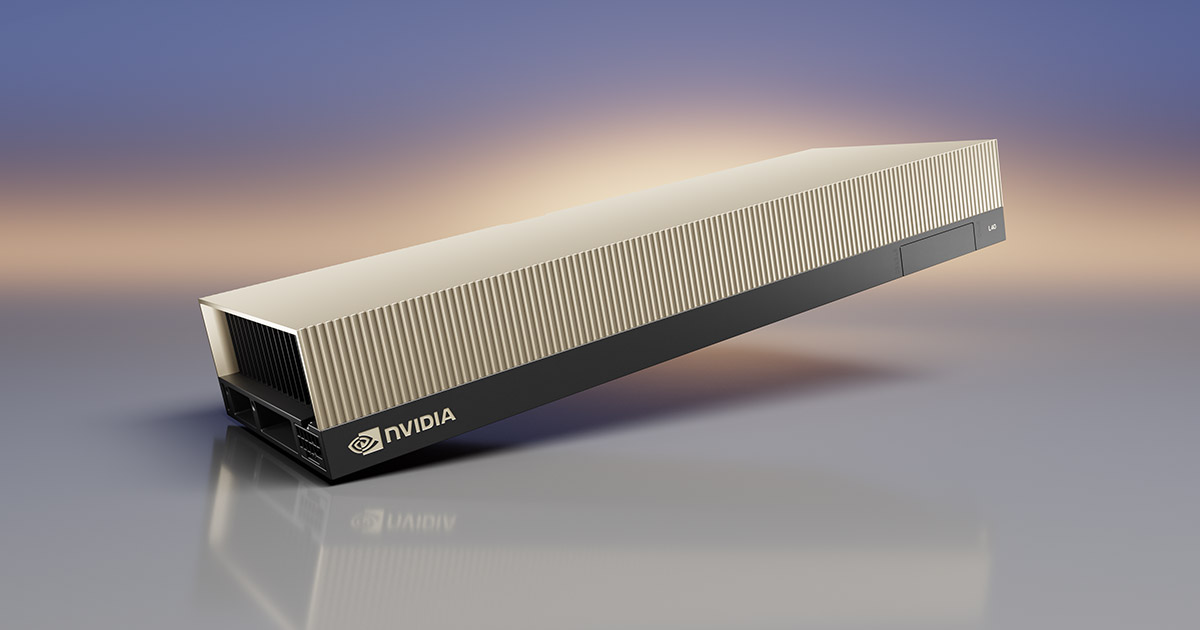
Image officielle du fabricant NVIDIA
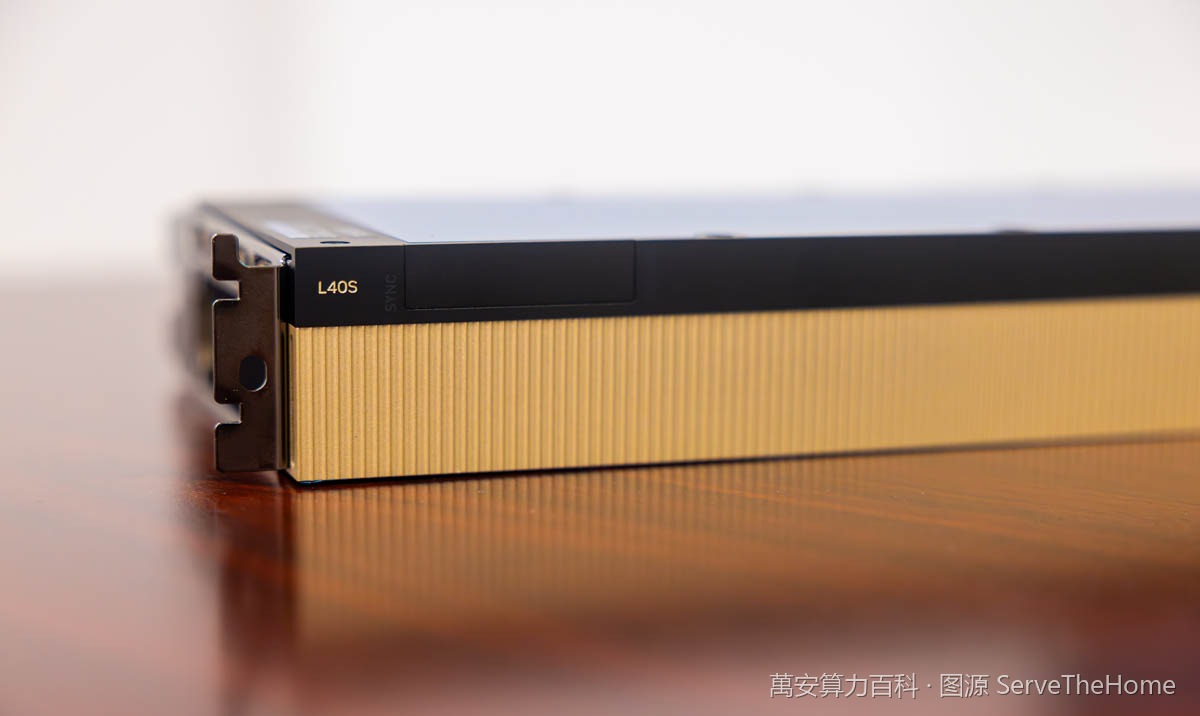
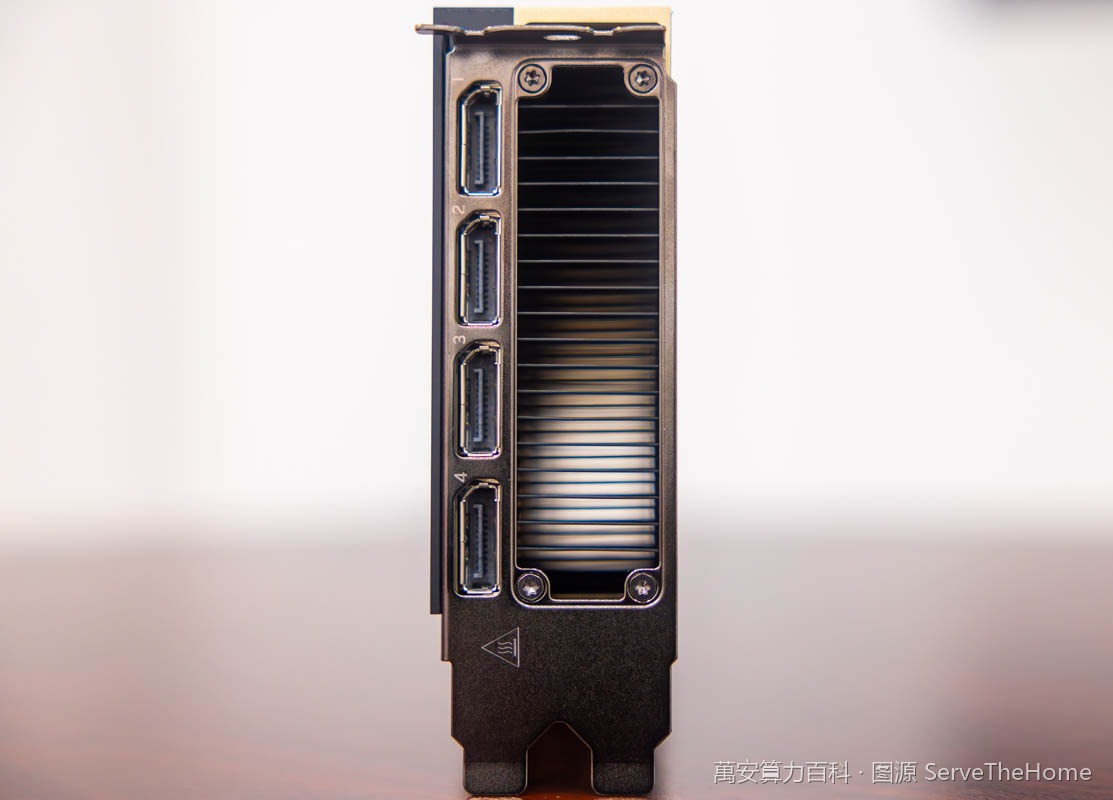
Photo réelle
Photos réelles
Vue d'ensemble
La NVIDIA L40S est un GPU datacenter PCIe double slot basé sur l'architecture Ada Lovelace, équipée de 48 Go de mémoire GDDR6 (avec ECC) et d'une bande passante mémoire de 864 Go/s, offrant une interconnexion bidirectionnelle de 64 Go/s via PCIe Gen4 x16. Elle intègre 18 176 cœurs CUDA, 142 RT Core de troisième génération et 568 Tensor Core de quatrième génération, avec une puissance de calcul FP8 Tensor Core pouvant atteindre 1 466 TFLOPS (sparse), ainsi que trois blocs NVENC/NVDEC prenant en charge l'encodage et le décodage AV1. Grâce à cette combinaison de grande mémoire, de haute puissance de calcul et de capacités de traitement vidéo, la L40S est couramment utilisée pour l'inférence de grands modèles, la génération d'images, le rendu en ray tracing et les charges de travail de jumeaux numériques comme Omniverse. Elle figure parmi les cartes Ada à grande mémoire les plus largement disponibles en stock sur le marché chinois.
Spécifications clés
| Architecture | NVIDIA Ada Lovelace architecture |
| Mémoire vidéo | 48 GB GDDR6 with ECC |
| Bande passante mémoire | 864 GB/s |
| Puissance FP32 | 91.6 teraFLOPS |
| Puissance FP16 | 733 teraFLOPS* |
| Puissance de calcul FP8 | 1,466 teraFLOPS* |
| Consommation TDP | 350 W |
| Interconnexion | PCIe Gen4 x16 |
| Format | 4.4" (H) x 10.5" (L), dual slot |
| Codecs | 3x (includes AV1 encode and decode) |
Spécifications vérifiées contre les sources officielles (
benchmarks officiels , mise à jour le 2026-10-09) · Le prix réel est soumis au devis du vendeur
Cas d'usage
- Déploiement d'inférence de modèles de langage et de modèles multimodaux sur une seule carte ou un petit cluster, avec 48 Go de mémoire pour accueillir des modèles à paramètres importants et de longs contextes
- Services d'inférence haute performance avec quantification FP8/INT8, en tirant parti des 1 466 TFLOPS (sparse) des Tensor Core pour améliorer le débit
- Rendu en ray tracing hors ligne et en temps réel, visualisation et production de contenu grâce aux 142 RT Core de troisième génération
- Applications Omniverse et jumeaux numériques, ainsi que transcodage vidéo massif et traitement de streaming via les trois blocs NVENC/NVDEC (AV1 inclus)
Modèles de la même famille
| Modèle | Mémoire vidéo | TDP |
|---|
| NVIDIA T4 Comparer | 16 Go GDDR6 avec ECC (activé par défaut) | 70 W (puissance totale de la carte, par défaut) |
| NVIDIA A100 Comparer | Double version 40 Go HBM2 / 80 Go HBM2e (version 80 Go annoncée le 2020-11-16 à SC20), avec ECC | SXM4 400 W (identique en 40 Go et 80 Go) ; version PCIe : 40 Go 250 W / 80 Go 300 W |
| NVIDIA H20 Comparer | 96 Go HBM3 (concordance Flopper/VipraTech/Tencent News) | 400 W TDP (Flopper/tableau VipraTech/'400 W TDP' Tencent News, triple concordance ; les 350 W mentionnés dans le corps du texte de VipraTech, contradictoires, ont été écartés) |
| NVIDIA GB300 Comparer | 288 Go HBM3e (par cœur GPU ; 576 Go pour la superpuce ; 2,1 To au niveau carte HGX / 20 To par baie, deux chiffres coexistant) | TGP jusqu'à 1400 W |
| NVIDIA A30 Comparer | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Comparer | 24GB GDDR6X | 450 W TGP (335 W en jeu en moyenne, alimentation système recommandée 850 W) |
Présentation vidéo VIDEO
Points d'achat et de vérification
- Attention à l'alimentation du serveur et de la salle : la L40S consomme jusqu'à 350 W par carte avec un connecteur d'alimentation 16 broches. Prévoyez les alimentations redondantes et les câbles appropriés, et dimensionnez la densité électrique du rack en conséquence
- Vérifiez le refroidissement et le format du châssis : cette carte est un modèle passif double slot full-height, d'environ 11,2 cm de haut et 26,7 cm de long. Elle doit être installée dans un serveur disposant d'un flux d'air suffisant et ne peut pas être utilisée directement dans un boîtier de bureau classique
- Interconnexion et topologie de déploiement : la L40S ne prend en charge que PCIe Gen4 x16 (64 Go/s bidirectionnels), sans NVLink ni partitionnement MIG. La communication entre cartes passe par PCIe et le réseau hôte ; lors de l'achat, tenez compte des besoins en bande passante inter-GPU de votre charge de travail. Notez également l'importance de Secure Boot et de la certification NEBS Level 3 pour les environnements de production
FAQ
Quelle est la taille de la mémoire de la NVIDIA L40S ? Est-elle suffisante pour l'inférence de grands modèles ?
La L40S est équipée de 48 Go de GDDR6 avec prise en charge ECC et une bande passante de 864 Go/s. Pour l'inférence, 48 Go permettent d'accueillir des modèles à paramètres importants, ou d'étendre la capacité via la quantification, ce qui convient à la plupart des déploiements mono-GPU.
La L40S prend-elle en charge NVLink et MIG ? Que faire pour l'entraînement multi-GPU ?
La L40S ne prend en charge ni l'interconnexion NVLink ni le partitionnement Multi-Instance GPU (MIG). La communication entre cartes ne peut passer que par PCIe Gen4 x16 (64 Go/s bidirectionnels) ; la carte est donc plus adaptée à l'inférence et au rendu. Si votre charge de travail est sensible à la bande passante inter-GPU (par exemple l'entraînement à grande échelle sur plusieurs cartes), une évaluation supplémentaire de l'architecture réseau s'impose.
Quelles sont les capacités de la L40S en encodage/décodage vidéo ? Gère-t-elle l'AV1 ?
Oui. La L40S intègre 3 encodeurs NVENC et 3 décodeurs NVDEC, avec une prise en charge matérielle de l'encodage et du décodage AV1, ce qui la rend adaptée au transcodage vidéo, au traitement de streaming et aux charges de travail de génération vidéo graphique combinées au rendu ou à Omniverse.