AIXX Pedia › Ficha de modelo › L40S
L40S
Visão geral OVERVIEW
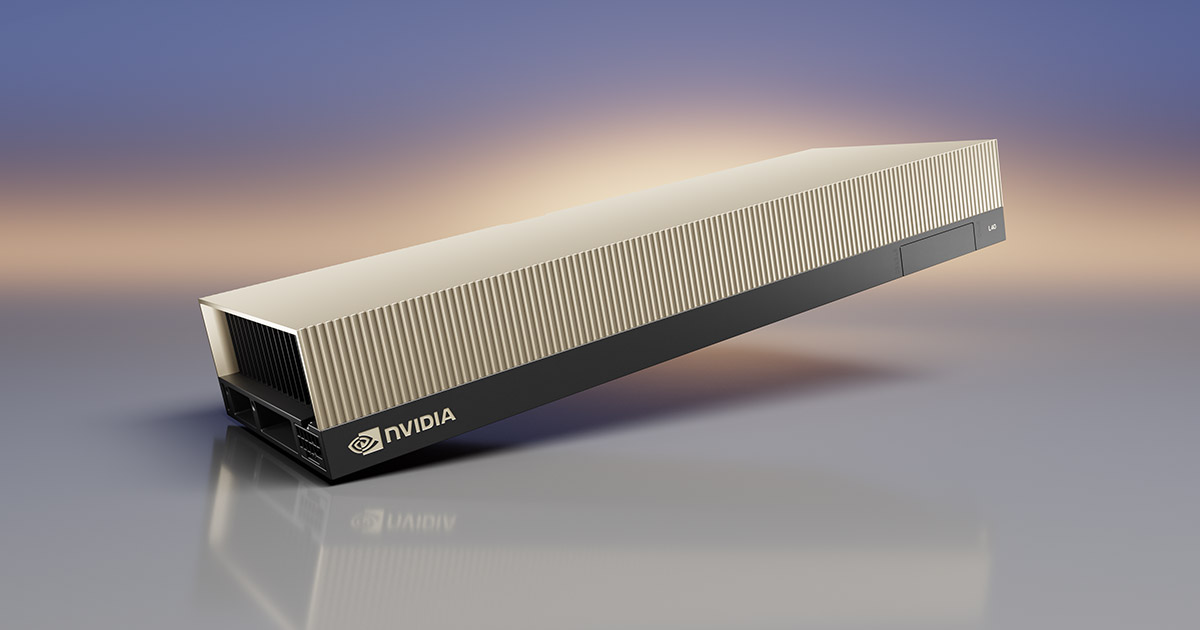
L40S baseada na arquitetura NVIDIA Ada Lovelace: GPU de datacenter PCIe de dois slots com 48 GB de GDDR6 ECC, 1.466 TFLOPS em FP8 Tensor Core (critério com sparsidade), 91,6 TFLOPS em FP32, num formato passivo de dois slots e 350 W — a posição oficial é a de 「placa de dupla vocação, combinando renderização e inferência」 : gráficos (3×NVENC/3×NVDEC com AV1, RT Core 212 TFLOPS) e inferência de IA (FP8/INT8) numa só máquina (de acordo com as especificações oficiais da NVIDIA[1]).
A lógica da sua popularidade no mercado de pronta-entrega nacional é simples: 48 GB de grande memória de vídeo + PCIe plug-and-play + sem ocupar recursos NVLink — sem necessidade de placa base HGX ou personalização do servidor inteiro; um servidor 2U comum com a placa instalada já roda inferência quantizada de nível 70B e pipelines de geração de SD/vídeo. É uma das placas de datacenter de maior volume no lado da inferência entre 2024 e 2026 (segundo a experiência de inspeção deste repositório), e também uma das melhores soluções para negócios híbridos de 「inferência de IA + render farm + transcodificação de vídeo」.
Três pontos ao comprar uma L40S: Verificação da diferença de preço entre L40/L40S (diferença de 2 TFLOPS em FP32 e 50 W de consumo; a diferença de preço deve ser proporcional), adaptador de alimentação de 16 pinos (fontes antigas exigem um adaptador compatível), status de certificação Secure Boot e NEBS (indicador essencial para cenários corporativos de conformidade, conforme especificações oficiais[1]). Esta entrada não traz faixa de preços — o valor real está sujeito à cotação do vendedor.
Cenários de uso FIT
AIXX Index (0–100): este repositório estima com ponderação baseada em especificações públicas — memória de vídeo 40% + interconexão 30% + ecossistema 30%, com pesos ajustados por cenário.
Histórico HISTORY
Em 2023 , lançamento do L40S: versão aprimorada do L40 com arquitetura Ada Lovelace — 91,6 TFLOPS FP32 (contra 90,5 do L40), os mesmos 48 GB de GDDR6 e 3×NVENC/3×NVDEC, com posicionamento duplo de "inferência de IA generativa + gráficos" (conforme especificações oficiais e portfólio de produtos da NVIDIA[1][2]).
Em 2024 , fase de alto volume na inferência: com a explosão da demanda por inferência de IA generativa, a L40S tornou-se a principal placa de volume no lado da inferência com a combinação 「48 GB + PCIe plug-and-play」 — pipelines de geração de vídeo (tipo SD/Kling), inferência quantizada de grandes modelos e farms de transcodificação avançando em três frentes (organizado por este repositório).
2025-2026 , a posição dominante em pronta-entrega continua: a mais recente RTX 6000 Ada (linha de workstations) e a L40 (versão original) circulam em paralelo, e a L40S mantém seu ponto ótimo de custo-benefício na inferência graças ao FP8 e à certificação NEBS. A linha sucessora da Ada evolui conforme o roteiro público da NVIDIA. As políticas de circulação transfronteiriça ainda estão em evolução; ao adquirir, siga as políticas das autoridades competentes e orientações profissionais (segundo relatos públicos).
Especificações técnicas SPECIFICATIONS
| Item | Especificações (NVIDIA L40S · fonte oficial) |
|---|---|
| Arquitetura da GPU | NVIDIA Ada Lovelace |
| Memória de vídeo por placa | 48GB GDDR6 with ECC |
| Largura de banda de memória | 864GB/s |
| Núcleos CUDA / Tensor / RT | 18.176 CUDA · 568 Tensor Cores de quarta geração · 142 RT Cores de terceira geração (desempenho RT de 212 TFLOPS) |
| FP32 | 91.6 TFLOPS |
| TF32 Tensor | 183 TFLOPS (366 com sparsidade) |
| BF16 / FP16 Tensor | 362,05 TFLOPS (733 com sparsidade) |
| FP8 / INT8 Tensor | 733 TFLOPS (1.466 com sparsidade) |
| Codecs | 3× NVENC | 3× NVDEC (com codificação/decodificação AV1) |
| Interface com o host | PCIe Gen4 x16 (64 GB/s bidirecional) |
| Consumo / alimentação | 350W · 1× 16-pin |
| Forma | 4,4"(A) × 10,5"(C) dois slots · resfriamento passivo |
| Saídas de vídeo | 4× DisplayPort 1.4a |
| Segurança / Certificações | Secure Boot with Root of Trust · NEBS Ready Level 3 |
| MIG / NVLink | Sem suporte a MIG · sem suporte a NVLink (posicionamento como placa PCIe independente) |
As especificações seguem o retrato oficial da NVIDIA (dados de outubro de 2026[1], verificados item a item com a ficha técnica); "sparse" é a indicação oficial marcada com asterisco, dense vale metade.
Comparação da família L40 L40 FAMILY
| Item | L40 | L40S (esta ficha) | L40S vs L40 em uma frase |
|---|---|---|---|
| FP32 | 90.5 TFLOPS | 91.6 TFLOPS | Diferença de um nível em FP32, 50 W a menos de consumo, diferença de preço deve ser proporcional — para inferência, prefira a L40S; para renderização pura com orçamento apertado, considere a L40 |
| Consumo | 300W | 350W | |
| Memória | 48GB GDDR6 ECC | 48GB GDDR6 ECC |
A comparação com a L40 usa o mesmo snapshot oficial da Ficha técnica deste repositório; os ganhos de FP8/INT8 da L40S vêm de frequência e alimentação reforçadas (mesma arquitetura).
Membros da família FAMILY
A família de placas de datacenter Ada Lovelace é dividida por posicionamento; a L40S está na faixa de dupla vocação inferência/gráficos:
Refrigeração e implantação COOLING
A L40S é uma placa passiva de dois slots de 4,4 polegadas de altura × 10,5 polegadas de comprimento (350 W, 1× alimentação de 16 pinos) — o resfriamento passivo depende do fluxo de ar forçado do servidor; workstations torre comuns precisam de uma solução com turbina. Três pontos de implantação: Alimentação (conector de 16 pinos, fontes antigas com adaptador compatível, verifique as especificações dos cabos para 350 W de carga máxima), conexão direta em slot PCIe Gen4 (x16 direto à CPU, sem switch para não perder banda), fluxo de ar (placas passivas de dois slots são sensíveis ao fluxo de ar do chassi; controle a temperatura de entrada com 350 W de carga máxima).
Implantação multi-GPU: em servidores 2U, configurações de 2 a 4 placas são comuns; a pressão térmica de 1,4 kW com quatro placas em carga máxima exige cálculo cuidadoso — a ausência de NVLink na L40S significa que múltiplas placas são 「computação paralela」 e não um 「domínio interconectado」, perfeito para inferência e renderização, inadequado para treinamento.
Compatibilidade de modelos MODEL FIT
| Modelo / cenário | Requisitos de memória (estimativa em FP16) | Critérios de implantação da L40S | AIXX Index |
|---|---|---|---|
| Inferência quantizada de nível 70B | INT4/FP8 ~35–40GB | Viável no limite com uma única placa de 48 GB (KV cache ajustado), com margem confortável em duas placas | 84 |
| Pipelines de geração de SD/vídeo | FP16 8-24GB | Múltiplas concorrências por placa, pipeline fluido com aceleração FP8 | 88 |
| Farm de transcodificação de vídeo | — (carga de codecs) | 3× NVENC/3× NVDEC com AV1, densidade de transcodificação referência no setor | 90 |
| Treinamento de grandes modelos | — | Sem NVLink/sem MIG — inadequada para treinamento (consulte as fichas A100/H100) | 45 |
Estimativa de memória de vídeo com pesos FP16 ≈ número de parâmetros × 2 bytes (estimativa, sem KV cache); a estratégia de precisão para implantação quantizada depende do framework.
Galeria GALLERY
Software e ecossistema ECOSYSTEM
| Item | Requisitos / situação atual |
|---|---|
| CUDA | Arquitetura Ada (compute capability 8.9) — suporte completo a partir do CUDA 11.8, coberta integralmente pela linha atual 12.x |
| Framework | Suporte total a PyTorch / TensorFlow / vLLM (ecossistema maduro no lado da inferência) |
| Stack gráfico | Suporte total a Omniverse / DCC — 4× DP 1.4a com conexão direta a monitores (raro em placas de datacenter) |
| Virtualização | Suporte a vGPU (licenças RTX vWS/vPC) — soluções maduras para VDI e estações de trabalho em nuvem |
| Driver | Linha de drivers de datacenter da NVIDIA (compartilhada com as séries A/H) |
O ecossistema Ada compartilha a linha principal do CUDA com Ampere; o tipo de licença vGPU é adquirido conforme o cenário de uso (fonte oficial). As versões de software evoluem com o tempo; prevalece o lançamento oficial da NVIDIA.
Aquisição e inspeção PROCUREMENT
Três pontos de inspeção na compra da L40S:
Os seis testes de estresse completos estão nesta ficha "Como testar" desta ficha.
Como fazer stress test BENCH TEST
Critério de seis testes de estresse, todos os valores ancorados na L40S real: reconhecimento na abertura → teste de burn-in de placa única (350 W) → computação FP8/INT8 → concorrência de codecs → renderização gráfica → teste de burn-in de longa duração.
Transporte e entrega LOGISTICS
Cartões de terminologia GLOSSARY
Placa de dupla vocação (renderização + IA)
O posicionamento da L40S: capacidade gráfica RT Core + capacidade de inferência de IA FP8 na mesma placa — render farm de dia, inferência à noite, uma máquina com dois usos (posicionamento oficial).
Codificação/decodificação AV1
Padrão de codificação de vídeo de nova geração (mesma qualidade com cerca de 30–50% menos taxa de bits que o H.264, segundo o setor): os 3× NVENC/3× NVDEC da L40S incluem AV1 — arma de redução de custos de banda para streaming e cloud gaming.
NEBS Level 3
Certificação de equipamento para telecomunicações (Network Equipment-Building System): resistência a vibração, resfriamento e confiabilidade em padrão de sala de telecomunicações — a certificação NEBS Ready da L40S permite sua instalação em salas de nível de operadora (especificações oficiais).
Secure Boot with Root of Trust
Inicialização segura com raiz de confiança em hardware: verificação de assinatura de firmware contra adulteração — item de segurança fundamental para conformidade corporativa e compras governamentais (fonte oficial); o estado do Secure Boot entra na inspeção.
Alimentação de 16 pinos
Novo conector de alimentação PCIe (família de especificação CEM5): mais de 350 W por conector — fontes antigas exigem adaptador compatível; a qualidade do adaptador é uma variável oculta da estabilidade da L40S.
Limitações e controvérsias LIMITS
- Sem NVLink nem MIG : múltiplas GPUs operam como poder computacional paralelo, não como domínio interconectado, e não há suporte a particionamento multilocatário — não serve para treinamento e é inferior às séries A/H em pooling multi-tenant (conforme especificações oficiais[1]), cuidado para não errar na escolha.
- Teto de largura de banda do PCIe Gen4 : Gen4 x16 com 64 GB/s bidirecional — cargas de inferência intensivas em dados (fluxo de grandes KV cache) são limitadas pela banda do host; apenas plataformas Gen5 as liberam (organizado por este repositório).
- Adaptadores são fontes ocultas de falhas : a qualidade dos adaptadores de 16 pinos para fontes antigas varia, com aquecimento sob carga máxima e folgas sendo causas comuns de retrabalho (experiência de inspeção deste repositório) — cabos originais e adaptadores compatíveis são o mínimo.
- Geração da memória de vídeo : GDDR6 com 864 GB/s contra os vários TB/s do HBM3e da série H — diferença evidente em treinamento de grandes modelos e cenários de KV cache gigantes; o ponto forte da L40S está na inferência e nos gráficos, não no treinamento.
- Variável de política de circulação internacional : placas de datacenter com arquitetura Ada estão dentro do escopo das listas de controle de exportação (segundo relatos públicos) — a conformidade da compra internacional deve seguir orientação profissional; este repositório não constitui aconselhamento jurídico.
Notas de mercado MARKET NOTE
O pronta-entrega da L40S combina novas unidades de fábrica e retiradas de servidores inteiros, com variações de estado e canal — sem snapshot de mercado uniforme e verificável por enquanto, Princípio de honestidade da AIXX Pedia: sem faixa de mercado; o preço está sujeito à cotação do vendedor 。
Busca de ofertas: Salão da AIXX Exchange › (intermediação sem comissão, sem participação nas transações; os dados permanecem, por isso, neutros). Assim que os registros de mercado se acumularem, esta seção passará à faixa de mercado padrão.
Marcos históricos de preço MILESTONES
Perguntas frequentes FAQ
Para inferência e IA, escolha a L40S: computação FP8/INT8 duplicada (733/1.466 contra 362/733 da L40, critério esparso), 350 W contra 300 W — a diferença de throughput de inferência supera a diferença de preço; para renderização pura com orçamento apertado, considere a L40.
Após a quantização: com INT4/FP8, cerca de 35-40 GB numa VRAM de 48 GB roda no limite (com KV cache ajustado); com duas placas, a folga é confortável; a versão original em FP16, com 140 GB, não cabe — a implantação quantizada é a abordagem predominante para a L40S.
Não é recomendado: sem NVLink (sem interconexão entre placas) e sem MIG (sem particionamento) — em cenários de treinamento faltam tanto a interconexão quanto a capacidade de divisão. O posicionamento da L40S está em inferência, transcodificação e gráficos; para treinamento, consulte as entradas A100/H100/B300.
Três pontos: usar o nvidia-smi para identificar falsificações com L40 (FP32 91,6 vs 90,5; 350 W vs 300 W), o estado do conector de alimentação 16-pin e dos adaptadores (causa comum de retornos) e um teste real de codificação/decodificação NVENC/AV1 (argumento central em cenários de transcodificação). Inspecionar visualmente os contatos dourados e a originalidade do dissipador.
É preciso adicionar ventiladores de turbina: a L40S é uma placa passiva de duplo slot (sem ventoinha), e o fluxo de ar de uma estação de trabalho torre não dá conta de 350 W com refrigeração passiva — um adaptador com refrigeração ativa ou um servidor rack é a solução correta; verifique também a alimentação 16-pin e um slot Gen4 x16.
Entradas relacionadas SEE ALSO
Comparação e escolha de modelos COMPARE
Referências REFERENCES
- NVIDIA oficial — snapshot de especificações da L40S (coerente item a item com a Ficha técnica, dados de 10/2026) https://www.nvidia.com/en-us/data-center/l40s/
- Site oficial NVIDIA — página do produto L40 (referência da família) https://www.nvidia.com/en-us/data-center/l40/
- Busca de ofertas — AIXX Exchange (Intermediação sem comissão; sem snapshot de mercado para a L40S no momento, o preço real está sujeito à cotação do vendedor) https://www.aixx.vip/hall.html?model=L40S