L40S
概要OVERVIEW
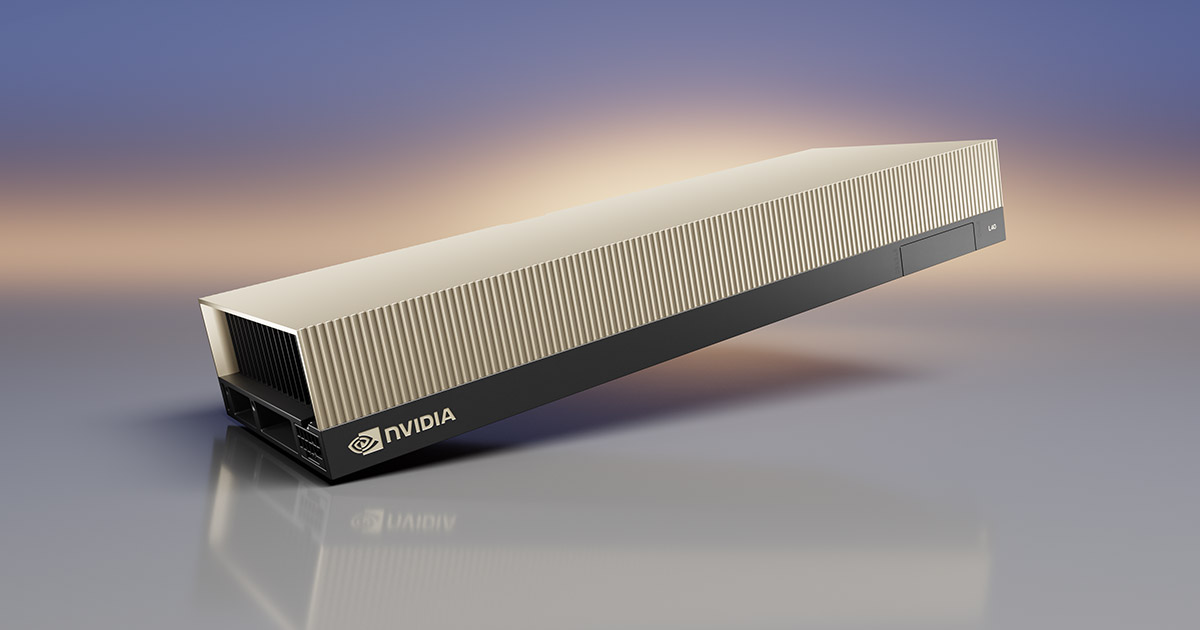
L40SNVIDIA Ada Lovelace アーキテクチャ採用のPCIe 2スロット データセンターGPU:48GB GDDR6 ECC、FP8 Tensor Core 1,466 TFLOPS(スパース表記)、FP32 91.6 TFLOPS、350W の 2スロット パッシブタイプ——公式の位置づけは「レンダリングと推論を両立するデュアルユースカード」:グラフィックス(3×NVENC/3×NVDEC、AV1対応、RT Core 212 TFLOPS)とAI推論(FP8/INT8)を1台でまるごとカバー(NVIDIA公式スペース基準[1])。
国内現物市場で人気を集めた理由はシンプル:48GB の大容量 VRAM + PCIe の挿すだけで使える手軽さ + NVLink リソースを消費しない——HGX ベースボードも筐体のカスタムも不要で、一般的な 2U サーバーに挿すだけで 70B クラスの量子化推論や SD/動画生成パイプラインが動く。2024〜2026年の推論側で最も出荷の大きいデータセンターカードの一つ(当ライブラリの検品実績ベース)であり、「AI 推論 + レンダリングファーム + 動画トランスコード」の混在業務に対する最適解の一つ。
L40S 購入前に確認すべき3点:L40 との価格差の整合確認(FP32 で 2 TFLOPS 差・消費電力 50W 差、価格差が釣り合うかチェック)、16-pin 電源変換ケーブル(旧電源には準拠の変換ケーブルが必要)、Secure Boot と NEBS 認証の状況(企業コンプライアンス用途で問われる硬指標、公式スペック基準[1])。本項では市況帯は扱いません——実際の価格は出品者の提示価格によります。
適用シーンFIT
AIXX Index(0〜100):当ライブラリが公開仕様から加重算出——VRAM 40% + インターコネクト 30% + エコシステム 30%、用途に応じて重みを調整。
沿革HISTORY
2023 年、L40S登場:Ada LovelaceアーキテクチャのL40のアップグレード版——FP32 91.6 TFLOPS(L40は90.5)、同サービスの48GB GDDR6と3×NVENC/3×NVDECを踏襲し、「生成AI推論+グラフィックス」の二刀流を主軸に据えた(NVIDIA公式スペック・製品ライン基準[1][2])。
2024 年、推論需要の拡大期:生成AI推論の需要が爆発し、L40S は「48GB + PCIe 挿してすぐ使える」の組み合わせで推論側の出荷主力に——動画生成パイプライン(SD/可靈系)、大規模モデルの量子化推論、トランスコードファームの三本柱(当ライブラリ整理ベース)。
2025〜2026 年、現物市場での主力地位が継続:後継の RTX 6000 Ada(ワークステーションライン)と L40(初代)が並行流通し、L40S は FP8 と NEBS 認証で推論側のコスパ sweetspot を維持。以降の Ada 後継製品ラインは NVIDIA 公開ロードマップに沿って展開。越境流通政策は依然流動的で、調達時は主管当局の方針と専門家の見解に従うこと(公開報道ベース)。
技術仕様SPECIFICATIONS
| 項目 | 仕様(NVIDIA L40S · 公式定義) |
|---|---|
| GPU アーキテクチャ | NVIDIA Ada Lovelace |
| 単体メモリ | 48GB GDDR6 with ECC |
| メモリ帯域幅 | 864GB/s |
| CUDA / Tensor / RT コア | 18,176 CUDA · 568 個の第4世代 Tensor Core · 142 個の第3世代 RT Core(RT性能 212 TFLOPS) |
| FP32 | 91.6 TFLOPS |
| TF32 Tensor | 183 TFLOPS(スパース 366) |
| BF16 / FP16 Tensor | 362.05 TFLOPS(スパース 733) |
| FP8 / INT8 Tensor | 733 TFLOPS(スパース 1,466) |
| コーデック | 3× NVENC | 3× NVDEC(AV1 コーデック対応) |
| ホストインターフェース | PCIe Gen4 x16(双方向 64GB/s) |
| 消費電力 / 電源供給 | 350W · 1× 16-pin |
| フォームファクター | 4.4"(H) × 10.5"(L) 2スロット · パッシブ冷却 |
| 映像出力 | 4× DisplayPort 1.4a |
| セキュリティ / 認証 | Secure Boot with Root of Trust · NEBS Ready Level 3 |
| MIG / NVLink | MIG 非対応 · NVLink 非対応(PCIe 単体カードの位置づけ) |
スペックはNVIDIA公式スナップショットを基準とする(2026-10時点[1]、スペックカードと項目単位で突き合わせ済み)。「スパース」は公式がアスタリスク付きで明示する基準で、dense時は半分。
L40 ファミリー比較L40 FAMILY
| 項目 | L40 | L40S(本項目) | L40S vs L40 一言で |
|---|---|---|---|
| FP32 | 90.5 TFLOPS | 91.6 TFLOPS | FP32 で1段差・消費電力 50W 差・価格差は見合うか——推論優先なら L40S、純レンダリングで予算重視なら L40 |
| 消費電力 | 300W | 350W | |
| メモリ | 48GB GDDR6 ECC | 48GB GDDR6 ECC |
L40 の比較は当ライブラリのスペックカードと同じ公式スナップショット基準;L40S の FP8/INT8 向上はクロックと電源強化によるもの(同一アーキテクチャ)。
ファミリー構成FAMILY
Ada Lovelace データセンターカードファミリーは位置づけで分類;L40S は推論/グラフィックス両用ポジション:
冷却と導入COOLING
L40S は 高さ 4.4インチ × 長さ 10.5インチの 2スロット パッシブカード(350W、16-pin 電源×1)——パッシブ冷却はサーバーの強制風路に依存するため、一般のタワークライアントに挿す場合はターボファン対策が必要。展開時の3つの突き合わせ項目:電源(16-pin インターフェース、旧電源は準拠変換ケーブル、350W フルロード時のケーブル規格を確認)、PCIe Gen4 スロットへの直挿し(x16でCPUに直結、スイッチ経由は帯域をロス)、エアフロー(2スロット パッシブカードは筐体風路に敏感、フルロード 350W 時の吸気温度を管理)。
マルチカード構成:2U サーバーでは 2〜4 枚構成が一般的、4枚フルロードで 1.4kW の風路圧は真剣に計算を——L40S は NVLink 非搭載のため複数枚は「並列演算」であり「インターコネクトドメイン」ではない。推論とレンダリングには最適、学習用途には不適。
モデル対応MODEL FIT
| モデル / シナリオ | メモリ需要(FP16 推計) | L40S 展開の目安 | AIXX Index |
|---|---|---|---|
| 70B クラス量子化推論 | INT4/FP8 で約 35-40GB | 1枚 48GB でギリギリ稼働可(KV cache を精査)、2枚なら余裕 | 84 |
| SD / 動画生成パイプライン | FP16 8-24GB | 1枚で多重同時実行、FP8 加速でパイプライン滑らか | 88 |
| 動画トランスコードファーム | —(コーデック負荷) | 3×NVENC/3×NVDEC AV1対応、トランスコード密度は業界標準 | 90 |
| 大規模モデル学習 | — | NVLink 非対応/MIG 非対応——学習用途には不適(A100/H100 項目と比較) | 45 |
VRAM は FP16 重みで ≈ パラメータ数 × 2バイトで概算(推算ベース、KV cache は未含み);量子化展開の精度戦略はフレームワーク次第。
ギャラリーGALLERY
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| CUDA | Ada アーキテクチャ(コンピュート能力 8.9)——CUDA 11.8 からフル対応、現行 12.x で完全カバー |
| フレームワーク | PyTorch / TensorFlow / vLLM すべて対応(推論側エコシステムは成熟) |
| グラフィックススタック | Omniverse / DCC フル対応——4×DP 1.4a でモニター直結(データセンターカードとしては稀) |
| 仮想化 | vGPU 対応(RTX vWS/vPC ライセンス基準)——VDI とクラウドワークステーション構成は成熟 |
| ドライバー | NVIDIA データセンタードライバーライン(A/H 系と共通) |
Ada エコシステムは Ampere と CUDA メインラインを共有;vGPU ライセンス種別は利用形態に応じて調達(公式定義)。ソフトウェアバージョンは時期により変化、NVIDIA 公式リリースを基準に。
調達と検品PROCUREMENT
L40S 購入時の検品ポイント(3項目):
完全な6項ストレステストの判例は本項を参照「ストレステストの方法」節を参照。
ストレステストの方法BENCH TEST
6項目のストレステスト基準、数値判定例はすべて L40S 実機に準拠:開梱認識 → 1枚焼き込みテスト(350W)→ FP8/INT8 演算性能 → コーデック同時処理 → グラフィックスレンダリング → 長時間安定焼き込みテスト。
輸送と納品LOGISTICS
用語カードGLOSSARY
両用カード(レンダリング+AI)
L40S の製品ポジション:RT Core のグラフィックス能力 + FP8 AI 推論能力を1枚で兼備——レンダリングファームは昼にレンダリング、夜に推論、1台で二役(公式の位置づけ定義)。
AV1 コーデック
次世代動画符号化規格(同画質で H.264 比べ約 30〜50% ビットレート削減、業界基準):L40S の 3×NVENC/3×NVDEC はいずれも AV1 対応——ストリーミングとクラウドゲームの帯域コスト削減の切り札。
NEBS Level 3
通信事業者級機器認証(Network Equipment-Building System):耐振動、冷却、信頼性が通信機室基準を満たす——L40S の NEBS Ready 認証によりキャリア級機室への導入が可能(公式仕様の定義)。
Secure Boot with Root of Trust
ハードウェア信頼ルートのセキュアブート:ファームウェア署名検証で改ざん防止——企業コンプライアンスと官公庁調達のセキュリティ最低ライン項目(公式仕様の定義)、検品時はセキュアブート状態を検査リストに含める。
16-pin 電源
次世代 PCIe 電源インターフェース(CEM5 規格系):1接口で 350W+ を供給——旧電源には準拠変換ケーブルが必要、ケーブル品質は L40S の安定稼働に影響する潜在変数。
限界と論点LIMITS
- NVLink なし MIG なし:複数GPUは並列な演算資源であって相互接続ドメインではないうえ、マルチテナントへの分割も不可——学習用途には不向きで、マルチテナントのプール化でもA/Hシリーズに及ばない(公式スペック基準[1])。選定で取り違えないこと。
- PCIe Gen4 の帯域上限:Gen4 x16 双方向 64GB/s——データスループットが密な推論ワークロード(大規模 KV cache の受け渡し)はホスト帯域に制約され、Gen5 プラットフォームで初めて解放される(当ライブラリ整理ベース)。
- 変換ケーブルは潜在的故障源:16-pin 電源の旧電源向け変換ケーブルは品質がまちまち、フルロード時の発熱と緩みは修理持ち込みのよくある原因(当ライブラリの検品実績ベース)——純正ケーブルと準拠変換が最低ライン。
- VRAM の世代差:GDDR6 864GB/s 対 H 系 HBM3e の数 TB/s 帯域——大規模モデル学習と超大容量 KV cache の場面では差が顕著、L40S の sweetspot は学習ではなく推論とグラフィックス。
- 越境流通の政策変数:Ada アーキテクチャ データセンターカードは輸出管理のリスト文脈内(公開報道ベース)——越境調達のコンプライアンスは専門家の見解に従い、当ライブラリは法的助言を構成しない。
相場情報MARKET NOTE
L40S の現物は原厂新品と筐体取り外し品が並行し、状態と流通経路で価格差が存在——現時点で検証可能な統一市況スナップショットはなし、本ライブラリの誠実さの原則:相場帯を設けず、価格は出品者の実際の提示価格によります。
販売検索:AIXX 取引所ロビー ›(手数料ゼロのマッチング、取引には関与しないため、データは中立)。市況スナップショットが十分に蓄積された後、本セクションは標準の市況帯へ切り替わります。
価格イベント年表MILESTONES
よくある質問FAQ
推論と AI 用途なら L40S:FP8/INT8 演算性能が倍増(733/1,466 対 L40 の 362/733 スパース表記)、消費電力 350W 対 300W——推論スループットの差は価格差より大きい;純レンダリングで予算重視なら L40。
量子化後なら可能:INT4/FP8 で約 35〜40GB、48GB VRAM ギリギリで動作可(KV キャッシュの細かい調整が必要)、2枚構成なら余裕を持って稼働。FP16 素の 140GB では収まらない――量子化デプロイが L40S の主流な使い方です。
非推奨:NVLink 非搭載(マルチGPU間のインターコネクトなし)、MIG 非対応(分割不可)――学習用途にはインターコネクトも分割機能も欠けています。L40S の立ち位置は推論・トランスコード・グラフィックスで、学習は A100/H100/B300 の項目を参照。
3点:nvidia-smi で L40 の偽装確認(FP32 が 91.6 対 90.5、350W 対 300W)、16-pin 電源と変換ケーブルの状態(修理歴でよくある故障箇所)、NVENC/AV1 コーデックの実測テスト(トランスコード用途の核心的セールスポイント)。金端子と放熱器の純正性も目視確認を。
タービンファンの追加が必要:L40S は 2スロットのパッシブカード(ファンなし)。タワーク型ワークステーションのエアフローでは 350W のパッシブ放熱は追いきれない――アクティブ冷却変換ブラケットまたはラック型サーバーが正解。加えて 16-pin 電源と Gen4 x16 スロットの確認も必要。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- NVIDIA 公式 ― L40S スペックスナップショット(スペックカードと全項目照合済み、2026-10 時点) https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA 公式サイト ― L40 製品ページ(ファミリー対照の基準) https://www.nvidia.com/en-us/data-center/l40/
- 出品検索 ― AIXX Exchange(手数料ゼロのマッチング;L40S は現在マーケットスナップショットなし、実際の価格は出品者の提示価格によります) https://www.aixx.vip/hall.html?model=L40S