AIXX Pedia › Ficha de modelo › L40S
L40S
Resumen OVERVIEW
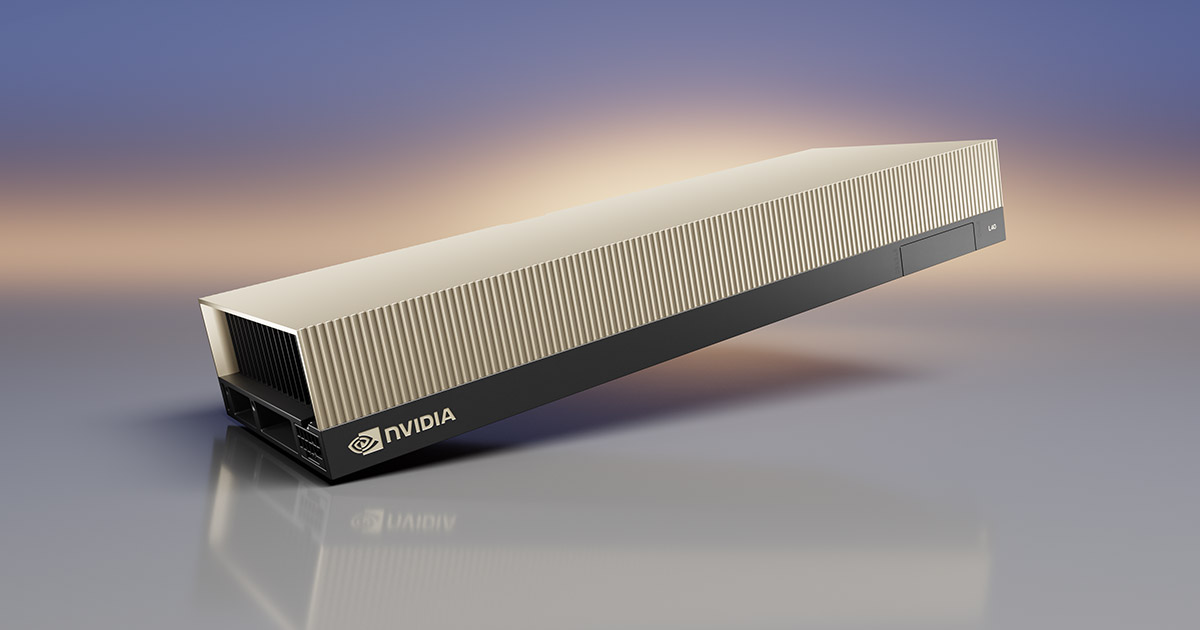
L40S basado en la arquitectura NVIDIA Ada Lovelace, GPU de doble ranura PCIe para centros de datos : 48GB GDDR6 ECC, FP8 Tensor Core 1,466 TFLOPS (cifra con dispersión), FP32 91.6 TFLOPS, formato pasivo de doble ranura y 350W: la posición oficial es la de una «tarjeta de doble función: renderizado e inferencia» : gráficos (3×NVENC/3×NVDEC con AV1, RT Core 212 TFLOPS) e inferencia de IA (FP8/INT8), todo en una sola máquina (cifras oficiales de NVIDIA[1]).
Su lógica de popularidad en el mercado de stock nacional es sencilla: 48GB de gran memoria + PCIe plug-and-play + sin consumir recursos de NVLink : no necesita placa base HGX ni configuraciones personalizadas de chasis; un servidor 2U común basta para ejecutar inferencia cuantizada de clase 70B y pipelines de generación SD/vídeo. Es una de las tarjetas de centro de datos con mayor volumen en inferencia de 2024-2026 (según la experiencia de verificación de esta biblioteca) y una de las mejores soluciones para negocios híbridos de «inferencia de IA + render farm + transcodificación de vídeo».
Tres cosas al comprar una L40S: verificar la diferencia de precio con la L40/L40S (1 TFLOPS menos de FP32 y 50W menos; la diferencia de precio debe corresponder), adaptador de alimentación 16-pin (las fuentes antiguas requieren un cable adaptador conforme), estado de Secure Boot y certificación NEBS (un indicador clave en escenarios de cumplimiento empresarial, según las especificaciones oficiales[1]). Esta entrada no incluye banda de mercado: el precio real está sujeto a la cotización del vendedor.
Casos de uso FIT
AIXX Index (0–100): esta biblioteca lo estima ponderando las especificaciones públicas: memoria 40% + interconexión 30% + ecosistema 30%, ajustando pesos según el escenario.
Historia HISTORY
En 2023 , lanzamiento del L40S: la versión mejorada del L40 con arquitectura Ada Lovelace: 91.6 TFLOPS FP32 (frente a 90.5 del L40), los mismos 48GB de GDDR6 y 3×NVENC/3×NVDEC, con posicionamiento dual orientado a «inferencia de IA generativa + gráficos» (según especificaciones oficiales de NVIDIA y su línea de producto[1][2]).
En 2024 , periodo de auge en inferencia: con la explosión de la demanda de inferencia de IA generativa, la L40S se convirtió en una referencia de volumen gracias a la combinación «48GB + PCIe plug-and-play»: pipelines de generación de vídeo (SD y similares), inferencia cuantizada de grandes modelos y granjas de transcodificación avanzando en paralelo (según datos recopilados por esta biblioteca).
2025-2026 , mantiene su posición en el mercado de stock: la nueva RTX 6000 Ada (línea de estación de trabajo) y la L40 (original) circulan en paralelo; la L40S conserva su punto óptimo de relación precio-rendimiento en inferencia gracias al FP8 y la certificación NEBS. La sucesora de Ada evolucionará según la hoja de ruta pública de NVIDIA. Las políticas de circulación transfronteriza siguen evolucionando; al comprar, atente a las políticas de las autoridades competentes y a asesoramiento profesional (según informes públicos).
Especificaciones técnicas SPECIFICATIONS
| Concepto | Especificaciones (NVIDIA L40S · cifras oficiales) |
|---|---|
| Arquitectura GPU | NVIDIA Ada Lovelace |
| Memoria por tarjeta | 48GB GDDR6 with ECC |
| Ancho de banda de memoria | 864GB/s |
| Núcleos CUDA / Tensor / RT | 18,176 CUDA · 568 Tensor Core de cuarta generación · 142 RT Core de tercera generación (rendimiento RT 212 TFLOPS) |
| FP32 | 91.6 TFLOPS |
| TF32 Tensor | 183 TFLOPS (366 con dispersión) |
| BF16 / FP16 Tensor | 362.05 TFLOPS (733 con dispersión) |
| FP8 / INT8 Tensor | 733 TFLOPS (1,466 con dispersión) |
| Códecs | 3× NVENC | 3× NVDEC (con códec AV1) |
| Interfaz de host | PCIe Gen4 x16 (64GB/s bidireccionales) |
| Consumo / alimentación | 350W · 1× 16-pin |
| Formato | 4.4"(alto) × 10.5"(largo), doble ranura · refrigeración pasiva |
| Salidas de vídeo | 4× DisplayPort 1.4a |
| Seguridad / certificaciones | Secure Boot with Root of Trust · NEBS Ready Level 3 |
| MIG / NVLink | Sin soporte MIG · sin soporte NVLink (enfoque de tarjeta PCIe independiente) |
Las especificaciones se basan en la captura oficial de NVIDIA (cifras de octubre de 2026[1], verificadas punto por punto con la ficha técnica); «sparse» corresponde a la notación oficial con asterisco; dense se reduce a la mitad.
Comparativa de la familia L40 L40 FAMILY
| Concepto | L40 | L40S (esta ficha) | L40S vs L40 en una frase |
|---|---|---|---|
| FP32 | 90.5 TFLOPS | 91.6 TFLOPS | 1 nivel menos de FP32, 50W menos de consumo; la diferencia de precio debe corresponder: para inferencia elige la L40S; si solo renderizas y el presupuesto importa, mira la L40 |
| Consumo | 300W | 350W | |
| Memoria | 48GB GDDR6 ECC | 48GB GDDR6 ECC |
La comparativa con la L40 usa la misma instantánea oficial de esta biblioteca; la mejora FP8/INT8 de la L40S proviene de frecuencias y alimentación reforzadas (misma arquitectura).
Miembros de la familia FAMILY
La familia de tarjetas de centro de datos Ada Lovelace se divide por posición; la L40S está en el segmento de doble función inferencia/gráficos:
Refrigeración y despliegue COOLING
La L40S es una tarjeta pasiva de doble ranura de 4.4 pulgadas de alto × 10.5 de largo (350W, 1× alimentación 16-pin); la refrigeración pasiva depende del flujo de aire forzado del servidor; en torres de trabajo convencionales hace falta un kit de turbina. Lista de comprobación de despliegue: Alimentación (interfaz 16-pin; las fuentes antiguas necesitan adaptadores conformes; verifica las especificaciones del cableado para 350W en plena carga), conexión directa a ranura PCIe Gen4 (x16 directa a la CPU, sin pasar por switch para no perder ancho de banda), flujo de aire (la tarjeta pasiva de doble ranura es sensible al flujo de aire del chasis; controla la temperatura del aire de entrada con 350W en plena carga).
Despliegue multi-GPU: en servidores 2U lo habitual son configuraciones de 2-4 tarjetas; con 4 tarjetas a plena carga (1.4 kW), calcula bien la presión sobre el flujo de aire. Sin NVLink, las L40S múltiples son «cómputo en paralelo», no un «dominio de interconexión»: perfecto para inferencia y renderizado, no apto para entrenamiento.
Adaptación de modelos MODEL FIT
| Modelo / escenario | Requisitos de memoria (estimación FP16) | Marco de despliegue de la L40S | AIXX Index |
|---|---|---|---|
| Inferencia cuantizada de clase 70B | INT4/FP8, unos 35–40GB | una tarjeta de 48GB al límite (optimizando el KV cache), dos tarjetas con margen cómodo | 84 |
| Pipelines SD / generación de vídeo | FP16 8-24GB | una tarjeta con múltiples ejecuciones concurrentes; el FP8 acelera el pipeline con fluidez | 88 |
| Granja de transcodificación de vídeo | — (carga de códecs) | 3×NVENC/3×NVDEC con AV1: referencia del sector en densidad de transcodificación | 90 |
| Entrenamiento de grandes modelos | — | Sin NVLink ni MIG: no apta para entrenamiento (ver fichas A100/H100) | 45 |
La memoria se estima como pesos FP16 ≈ nº de parámetros × 2 bytes (cálculo aproximado, sin KV cache); la estrategia de precisión en despliegues cuantizados depende del framework.
Galería GALLERY
Software y ecosistema ECOSYSTEM
| Concepto | Requisito / Situación actual |
|---|---|
| CUDA | Arquitectura Ada (compute capability 8.9): soporte completo desde CUDA 11.8, cubierta por las versiones actuales 12.x |
| Frameworks | PyTorch / TensorFlow / vLLM totalmente soportados (ecosistema maduro en inferencia) |
| Pila gráfica | Omniverse / DCC totalmente soportados: 4×DP 1.4a con conexión directa a monitores (poco común en tarjetas de centro de datos) |
| Virtualización | Soporte vGPU (según licencias RTX vWS/vPC): soluciones maduras de VDI y estaciones de trabajo en la nube |
| Driver | Línea de drivers de centro de datos de NVIDIA (compartida con la serie A/H) |
El ecosistema Ada comparte la línea principal de CUDA con Ampere; las licencias vGPU se compran según el escenario de uso (cifras oficiales). Las versiones de software evolucionan con el tiempo; prevalece lo publicado oficialmente por NVIDIA.
Compra e inspección PROCUREMENT
Puntos de verificación al comprar una L40S (tres):
Los seis casos completos de pruebas de estrés están en esta ficha «Cómo hacer la prueba de burn-in» de esta ficha.
Cómo hacer pruebas de estrés BENCH TEST
Protocolo de seis pruebas, con todos los valores anclados a la L40S real: identificación al abrir → burn-in de una tarjeta (350W) → cómputo FP8/INT8 → concurrencia de códecs → renderizado gráfico → burn-in de larga duración.
Transporte y entrega LOGISTICS
Fichas de términos GLOSSARY
Tarjeta de doble función (render + IA)
La posición de la L40S: capacidades gráficas RT Core e inferencia de IA FP8 en la misma tarjeta; de día renderiza la granja, de noche hace inferencia; una máquina, dos usos (según la posición oficial).
Códec AV1
Nuevo estándar de codificación de vídeo (a igual calidad ahorra un 30-50% de bitrate frente a H.264, según cifras del sector): los 3×NVENC/3×NVDEC de la L40S incluyen AV1, un arma para reducir costes de ancho de banda en streaming y cloud gaming.
NEBS Level 3
Certificación de equipos de telecomunicaciones (Network Equipment-Building System): resistencia a vibraciones, refrigeración y fiabilidad al estándar de salas de telecomunicaciones; la certificación NEBS Ready de la L40S le permite entrar en salas de operadores (según especificaciones oficiales).
Secure Boot with Root of Trust
Arranque seguro con raíz de confianza de hardware: verificación de firma de firmware contra manipulación; el suelo de seguridad para cumplimiento corporativo y compras gubernamentales (según especificaciones oficiales); incluye el estado de Secure Boot en la inspección.
Alimentación 16-pin
Nueva interfaz de alimentación PCIe (familia de especificación CEM5): más de 350W por un solo conector; las fuentes antiguas requieren adaptadores conformes, y su calidad es una variable oculta para la estabilidad de la L40S.
Limitaciones y controversias LIMITS
- Sin NVLink ni MIG : múltiples GPU funcionan como cómputo en paralelo, no como dominio interconectado, y no admiten división multiusuario: no es apto para entrenamiento y su agrupación multiusuario es inferior a la de las series A/H (según las especificaciones oficiales[1]); evita errores al elegir.
- El techo de ancho de banda de PCIe Gen4 : Gen4 x16 son 64GB/s bidireccionales; cargas de inferencia intensivas en datos (rotación de grandes KV cache) quedan limitadas por el ancho de banda del host; solo una plataforma Gen5 lo libera (según datos recopilados por esta biblioteca).
- Los adaptadores son una fuente oculta de fallos : la calidad de los adaptadores 16-pin para fuentes antiguas es dispar; el sobrecalentamiento en plena carga y las conexiones flojas son causas frecuentes de devolución (según la experiencia de esta biblioteca): cables originales y adaptadores conformes son el mínimo.
- El salto generacional de memoria : GDDR6 con 864GB/s frente a varios TB/s de los HBM3e de la serie H: la diferencia es notable en entrenamiento de grandes modelos y KV cache muy grandes; el punto óptimo de la L40S está en inferencia y gráficos, no en entrenamiento.
- Variable política del comercio transfronterizo : las tarjetas de centro de datos Ada están dentro del ámbito de las listas de control de exportación (según informes públicos): la conformidad de compras internacionales depende de asesoramiento profesional; esta biblioteca no constituye asesoría legal.
Notas de mercado MARKET NOTE
El stock de L40S combina unidades nuevas de fábrica y recicladas de equipos completos, con diferencias de precio por estado y canal; aún no hay una instantánea de mercado verificable. Principio de honestidad de este repositorio: no publicamos bandas de mercado; el precio real está sujeto a la cotización del vendedor 。
Búsqueda de unidades en venta: AIXX Exchange Hall › (intermediación sin comisión y sin participación en las transacciones; por eso los datos son neutrales). Cuando se acumulen suficientes instantáneas de mercado, esta sección pasará a la banda de mercado estándar.
Hitos de precios MILESTONES
Preguntas frecuentes FAQ
Para inferencia e IA, la L40S: cómputo FP8/INT8 duplicado (733/1,466 frente a 362/733 de la L40, cifras con dispersión) y 350W frente a 300W; la brecha en rendimiento de inferencia supera la diferencia de precio; para render puro con presupuesto ajustado, la L40.
Tras la cuantización es posible: con INT4/FP8, unos 35-40 GB frente a 48 GB de VRAM funcionan al límite (con KV cache muy ajustado), y con dos tarjetas el margen es cómodo; la versión FP16 de 140 GB no cabe; la cuantización es el despliegue predominante en la L40S.
No es recomendable: sin NVLink (sin interconexión multi-GPU) y sin MIG (sin capacidad de particionado); en entrenamiento faltan tanto la interconexión como el particionado. La L40S está orientada a inferencia, transcodificación y gráficos; para entrenamiento, consulte las fichas de A100/H100/B300.
Tres puntos: usar nvidia-smi para descartar una L40 disfrazada (FP32 91,6 frente a 90,5; 350 W frente a 300 W), revisar el conector de alimentación de 16 pines y el cable adaptador (causa frecuente de devoluciones por reparación) y probar en real la codificación/decodificación NVENC/AV1 (el argumento clave en transcodificación). Inspeccionar visualmente el originalidad de los contactos dorados y del disipador.
Hay que añadir turbinas de ventilación: la L40S es una tarjeta pasiva de doble ranura (sin ventilador), y el flujo de aire de una torre no soporta 350 W de disipación pasiva; un adaptador con refrigeración activa o un servidor de rack es la solución correcta. Verificar también la alimentación de 16 pines y una ranura PCIe Gen4 x16.
Entradas relacionadas SEE ALSO
Comparativa y elección de modelos COMPARE
Referencias REFERENCES
- NVIDIA oficial — instantánea de especificaciones de la L40S (coincide ítem a ítem con la Ficha técnica, cifras de octubre de 2026) https://www.nvidia.com/en-us/data-center/l40s/
- Web oficial de NVIDIA — página de producto L40 (criterios comparativos de la familia) https://www.nvidia.com/en-us/data-center/l40/
- Búsqueda en venta — AIXX Pedia (intermediación sin comisión; sin instantánea de precios para la L40S por ahora, el precio real está sujeto a la cotización del vendedor) https://www.aixx.vip/hall.html?model=L40S