AIXX Pedia › Modelleintrag › L40S
L40S
Überblick OVERVIEW
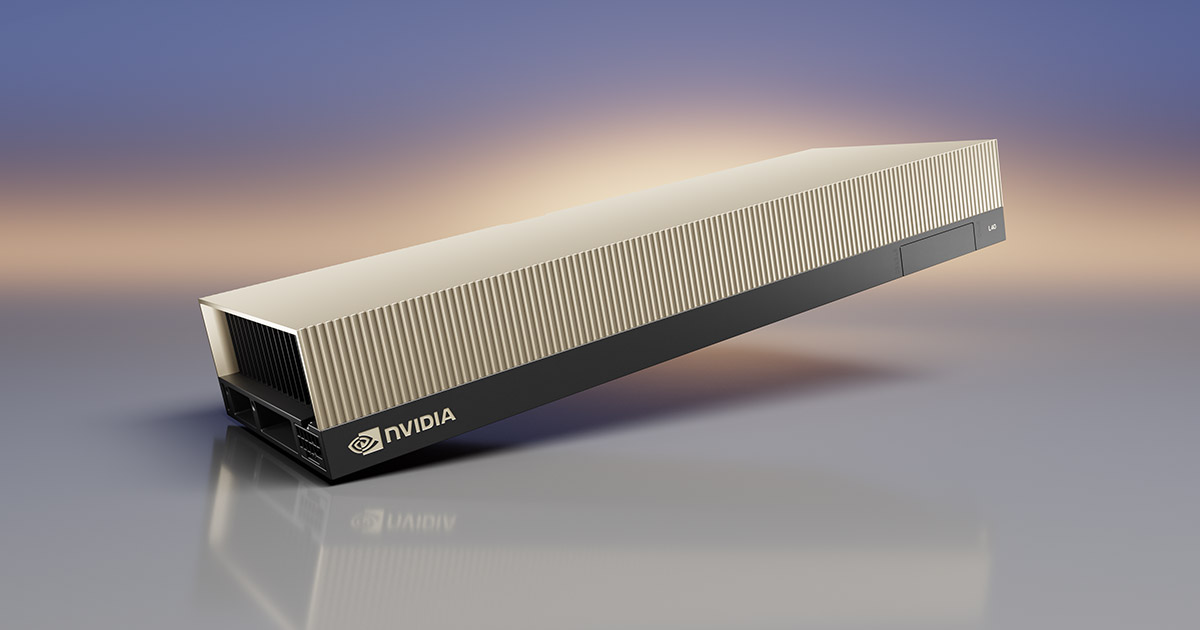
L40S auf Basis der NVIDIA-Architektur Ada Lovelace Dual-Slot-Datacenter-GPU mit PCIe : 48GB GDDR6 ECC, FP8 Tensor Core 1.466 TFLOPS (Sparse-Angabe), FP32 91,6 TFLOPS, 350W im passiven Dual-Slot-Format — der offizielle Hersteller setzt sie an als „Doppel begabte Karte für Rendering und Inferenz“ : Grafik (3×NVENC/3×NVDEC inkl. AV1, RT Core 212 TFLOPS) und KI-Inferenz (FP8/INT8) in einer einzigen Maschine (gemäß offiziellen NVIDIA-Spezifikationen[1]).
Der Erfolg der Karte am Spotmarkt in China folgt einer simplen Logik: 48GB großer Videospeicher + PCIe-Plug-and-Play + keine NVLink-Ressourcenbelegung — kein HGX-Substrat, keine maßgeschneiderte Gesamtsystem-Integration nötig; ein gewöhnlicher 2U-Server nimmt die Karte auf und läuft damit quantisierte 70B-Inferenz sowie SD-/Videogenerierungs-Pipelines. Sie war 2024–2026 eine der volumenstärksten Datacenter-Karten auf der Inferenzseite (Erfahrungswerte dieser Datenbank) und zählt zu den besten Lösungen für gemischte Workloads aus „KI-Inferenz + Renderfarm + Videotranskodierung“.
Drei Dinge beim Kauf einer L40S: Preisdifferenz zu L40/L40S prüfen (Unterschied: 2 TFLOPS FP32 und 50W Leistungsaufnahme — die Preisdifferenz muss dazu passen), 16-pin-Stromadapter (ältere Netzteile benötigen konforme Adapterkabel), Secure-Boot- und NEBS-Zertifizierungsstatus (Ein hartes Kriterium für Enterprise-Compliance-Szenarien, gemäß offiziellen Spezifikationen[1]). Dieser Eintrag enthält keine Marktleiste – der Preis richtet sich nach dem tatsächlichen Angebot des Verkäufers.
Einsatzszenarien FIT
AIXX Index (0–100): Diese Datenbank gewichtet öffentlich verfügbare Spezifikationen — Videospeicher 40 % + Interconnect 30 % + Ökosystem 30 %, je nach Szenario angepasst.
Historie HISTORY
2023 , Launch der L40S: Das Ada-Lovelace-Upgrade der L40 – FP32 91,6 TFLOPS (L40: 90,5), dieselben 48 GB GDDR6 und 3×NVENC/3×NVDEC, positioniert als Dual-Purpose-Lösung für „generative KI-Inferenz + Grafik“ (gemäß offiziellen NVIDIA-Spezifikationen und Produktlinienangaben[1][2]).
2024 , Volumenphase auf der Inferenzseite: Der Bedarf an generativer KI-Inferenz explodierte, und die L40S wurde mit der Kombination „48GB + PCIe-Plug-and-Play“ zum Volumen-Treiber auf der Inferenzseite — Videogenerierungs-Pipelines (SD/verwandte Tools), quantisierte LLM-Inferenz und Transkodierungsfarmen liefen auf drei Gleisen gleichzeitig (Zusammenstellung dieser Datenbank).
2025–2026 , Spotmarkt-Dominanz hält an: Die neuere RTX 6000 Ada (Workstation-Linie) und das L40-Original zirkulieren parallel; die L40S behauptet dank FP8 und NEBS-Zertifizierung ihren Sweet Spot auf der Inferenzseite. Die Ada-Nachfolgelinie entwickelt sich gemäß der öffentlichen NVIDIA-Roadmap weiter. Die Regulierung des grenzüberschreitenden Handels befindet sich noch im Wandel; beim Einkauf gelten behördliche Richtlinien und professionelle Beratung (öffentliche Berichterstattung).
Technische Daten SPECIFICATIONS
| Position | Spezifikationen (NVIDIA L40S · offizielle Angaben) |
|---|---|
| GPU-Architektur | NVIDIA Ada Lovelace |
| Speicher pro Karte | 48GB GDDR6 with ECC |
| VRAM-Bandbreite | 864GB/s |
| CUDA / Tensor / RT-Cores | 18.176 CUDA · 568 Tensor Cores der vierten Generation · 142 RT Cores der dritten Generation (RT-Leistung 212 TFLOPS) |
| FP32 | 91.6 TFLOPS |
| TF32 Tensor | 183 TFLOPS (sparse 366) |
| BF16 / FP16 Tensor | 362,05 TFLOPS (sparse 733) |
| FP8 / INT8 Tensor | 733 TFLOPS (sparse 1.466) |
| Codecs | 3× NVENC | 3× NVDEC (inkl. AV1-Encoding/Decoding) |
| Host-Interface | PCIe Gen4 x16 (bidirektional 64 GB/s) |
| Leistungsaufnahme / Stromversorgung | 350W · 1× 16-pin |
| Formfaktor | 4,4" (H) × 10,5" (L) Dual-Slot · passive Kühlung |
| Displayausgänge | 4× DisplayPort 1.4a |
| Sicherheit / Zertifizierung | Secure Boot with Root of Trust · NEBS Ready Level 3 |
| MIG / NVLink | Kein MIG · kein NVLink (positioniert als eigenständige PCIe-Karte) |
Spezifikationen gemäß dem offiziellen NVIDIA-Schnappschuss (Stand: 10/2026[1], punktweise mit der Spec-Card abgeglichen); „Sparse“ bezeichnet die offizielle, mit Sternchen gekennzeichnete Angabe, dense ist halb so hoch.
L40-Familienvergleich L40 FAMILY
| Position | L40 | L40S (dieser Eintrag) | L40S vs. L40 in einem Satz |
|---|---|---|---|
| FP32 | 90.5 TFLOPS | 91.6 TFLOPS | FP32 um eine Stufe besser, 50W Mehrverbrauch, Preisdifferenz muss dazu passen — für Inferenz die L40S, bei reinem Rendering und knappem Budget die L40 |
| Verbrauch | 300W | 350W | |
| Speicher | 48GB GDDR6 ECC | 48GB GDDR6 ECC |
Der L40-Vergleich basiert auf demselben offiziellen Schnappschuss wie die Spec-Card dieser Datenbank; die FP8/INT8-Zuwächse der L40S stammen aus erhöhten Taktraten und verbesserter Stromversorgung (gleiche Architektur).
Familienmitglieder FAMILY
Die Ada-Lovelace-Datacenter-Kartenfamilie gliedert sich nach Ausrichtung; die L40S ist die Doppel begabte Klasse für Inferenz/Grafik:
Kühlung und Deployment COOLING
Die L40S ist eine passive Dual-Slot-Karte mit 4,4 Zoll Höhe × 10,5 Zoll Länge (350W, 1× 16-pin-Stromanschluss) — passive Kühlung ist auf den erzwungenen Luftstrom des Servers angewiesen; wer die Karte in einen gewöhnlichen Tower-Workstation einbaut, benötigt eine Turbolüfter-Lösung. Drei Punkte für die Bereitstellung: Stromversorgung (16-pin-Anschluss; ältere Netzteile mit konformen Adapterkabeln, Kabelquerschnitt für 350W Volllast vorher prüfen), direkte Bestückung in PCIe-Gen4-Slots (x16 direkt an die CPU; über einen Switch leidet die Bandbreite), Luftführung (passive Dual-Slot-Karten reagieren empfindlich auf den Gehäuse-Luftstrom; die Lufteinlasstemperatur bei 350W Volllast muss kontrolliert werden).
Multi-GPU-Bereitstellung: 2U-Server tragen üblicherweise 2–4 Karten; der Kühlungsdruck von 1,4 kW bei Volllast mit vier Karten muss ernsthaft kalkuliert werden — da die L40S kein NVLink besitzt, sind mehrere Karten „parallele Rechenleistung“ statt einer „Interconnect-Domäne“, ideal für Inferenz und Rendering, ungeeignet für Training.
Modellkompatibilität MODEL FIT
| Modell / Szenario | Speicherbedarf (FP16-Schätzung) | L40S-Einsatzprofil | AIXX Index |
|---|---|---|---|
| Quantisierte 70B-Inferenz | INT4/FP8 ca. 35–40GB | Mit einer einzelnen Karte gerade noch möglich (KV-Cache rationieren), mit zwei Karten komfortabel | 84 |
| SD-/Videogenerierungs-Pipelines | FP16 8-24GB | Mehrere gleichzeitige Instanzen pro Karte, FP8 beschleunigt die Pipelines flüssig | 88 |
| Videotranskodierungsfarm | — (Codec-Last) | 3×NVENC/3×NVDEC inkl. AV1, branchenführende Transkodierungsdichte | 90 |
| 256GB KV-Cache-Raum sind die Stärke der MI-Serie | — | Kein NVLink/kein MIG — ungeeignet für Training (Vergleich: A100/H100-Einträge) | 45 |
Videospeicherbedarf bei FP16-Gewichten ≈ Parameterzahl × 2 Bytes (Schätzung, ohne KV-Cache); die Quantisierungsstrategie hängt vom Framework ab.
Bildergalerie GALLERY
Software & Ökosystem ECOSYSTEM
| Position | Anforderung / Status |
|---|---|
| CUDA | Ada-Architektur (Compute Capability 8.9) — vollständig unterstützt ab CUDA 11.8, aktuelle 12.x komplett abgedeckt |
| Frameworks | PyTorch / TensorFlow / vLLM vollständig unterstützt (reifes Inferenz-Ökosystem) |
| Grafik-Stack | Omniverse / DCC vollständig unterstützt — 4× DP 1.4a mit direktem Monitoranschluss (bei Datacenter-Karten selten) |
| Virtualisierung | vGPU-Unterstützung (nach RTX-vWS/vPC-Lizenzierung) — ausgereifte VDI- und Cloud-Workstation-Lösungen |
| Treiber | NVIDIA-Datacenter-Treiberlinie (gemeinsam mit der A/H-Serie) |
Das Ada-Ökosystem teilt sich die CUDA-Hauptlinie mit Ampere; die vGPU-Lizenzart richtet sich nach dem Nutzungsszenario (offizielle Angabe). Softwareversionen entwickeln sich weiter; maßgeblich sind die offiziellen NVIDIA-Veröffentlichungen.
Beschaffung und Warenprüfung PROCUREMENT
Drei Prüfpunkte beim L40S-Einkauf:
Das vollständige Sechs-Punkte-Burn-in-Test-Urteil findet sich in diesem Eintrag „Burn-in-Test“ dieses Eintrags.
Stresstests BENCH TEST
Sechsstufiges Burn-in-Test-Profil, alle Urteilswerte fest an der L40S verankert: Auspacken und Identifikation → Einzelkarten-Burn-in-Test (350W) → FP8/INT8-Rechenleistung → Codec-Gleichzeitigkeit → Grafikrendering → Langzeit-Burn-in-Test.
Versand & Auslieferung LOGISTICS
Glossarkarten GLOSSARY
Doppel begabte Karte (Rendering + KI)
Die Produktpositionierung der L40S: RT-Core-Grafikleistung und FP8-KI-Inferenzleistung in einer Karte — die Renderfarm rendert tagsüber und fährt nachts Inferenz; ein System, doppelt genutzt (offizielle Positionierung).
AV1-Encoding/Decoding
Neuer Video-Codec-Standard (bei gleicher Qualität etwa 30–50 % weniger Bitrate als H.264, Branchenangabe): Die 3×NVENC/3×NVDEC der L40S beherrschen alle AV1 — ein Bandbreiten-Kostensparer für Streaming und Cloud-Gaming.
NEBS Level 3
Telekommunikationsgeräte-Zertifizierung (Network Equipment-Building System): Erschütterungsfestigkeit, Kühlung und Zuverlässigkeit auf Telefonzentralen-Niveau — dank NEBS-Ready-Zertifizierung darf die L40S in Netzbetreiber-Rechenzentren laufen (offizielle Spezifikation).
Secure Boot with Root of Trust
Hardware Root of Trust mit Secure Boot: Firmware-Signaturprüfung gegen Manipulation — Sicherheitsgrundlinie für Enterprise-Compliance und Behördenbeschaffung (offizielle Spezifikation); beim Wareneingang ist der Secure-Boot-Status in die Prüfung aufzunehmen.
16-pin-Stromversorgung
Neue PCIe-Stromschnittstelle (CEM5-Spezifikationsfamilie): 350W+ über einen einzelnen Anschluss — ältere Netzteile benötigen konforme Adapterkabel; deren Qualität ist eine versteckte Variable für den stabilen Betrieb der L40S.
Grenzen & Kontroversen LIMITS
- Kein NVLink, kein MIG : Mehrere Karten sind parallele Rechenleistung und keine Interconnect-Domain, zudem ist kein Multi-Tenant-Slicing möglich – für Training ungeeignet, beim Multi-Tenant-Pooling schwächer als die A/H-Serie (gemäß offiziellen Spezifikationen[1]). Bei der Auswahl nicht verzetteln.
- Die Bandbreitengrenze von PCIe Gen4 : Gen4 x16 bidirektional 64 GB/s — datenintensive Inferenz-Workloads (großer KV-Cache-Durchsatz) stoßen an die Host-Bandbreite; erst Gen5-Plattformen schaffen Abhilfe (Zusammenstellung dieser Datenbank).
- Adapterkabel als versteckte Fehlerquelle : Die Qualität der 16-pin-Adapterkabel für ältere Netzteile schwankt stark; Hitze bei Volllast und Lockerung sind häufige Rücklaufursachen (Erfahrungswerte dieser Datenbank) — Originalkabel und konforme Adapter sind die Untergrenze.
- Speichergenerations-Rückstand : GDDR6 mit 864 GB/s gegen die mehreren TB/s von HBM3e der H-Serie — bei großem Modelltraining und sehr großen KV-Caches ist der Abstand deutlich; der Sweet Spot der L40S liegt bei Inferenz und Grafik, nicht beim Training.
- Politische Variablen des grenzüberschreitenden Handels : Ada-Datacenter-Karten fallen im Kontext der Exportkontrolllisten darunter (öffentliche Berichterstattung) — für die Compliance beim grenzüberschreitenden Einkauf gilt professionelle Beratung; diese Datenbank stellt keine Rechtsberatung dar.
Marktlage MARKET NOTE
Beim L40S-Spotmarkt laufen Original-Neuware und aus Gesamt Systemen ausgebaute Karten parallel; Zustand und Kanal bedingen Preisdifferenzen — ein überprüfbarer einheitlicher Marktschnappschuss liegt noch nicht vor, Ehrlichkeitsprinzip dieser Datenbank: kein Marktdatenband; der Preis richtet sich nach dem tatsächlichen Angebot des Verkäufers 。
Angebotssuche: AIXX Markthalle › (provisionsfreie Vermittlung, keine Teilnahme am Handel, daher neutrale Daten). Nach ausreichender Akkumulation von Marktdaten wird dieser Abschnitt auf eine Standard-Marktkurve umgestellt.
Wichtige Preisereignisse MILESTONES
FAQ FAQ
Für Inferenz und KI die L40S: FP8/INT8-Rechenleistung verdoppelt (733/1.466 vs. 362/733 bei der L40, Sparse-Angaben), 350W vs. 300W — der Durchsatzabstand ist größer als die Preisdifferenz; bei reinem Rendering und knappem Budget die L40.
Nach Quantisierung möglich: INT4/FP8 ca. 35–40 GB gegen 48 GB VRAM – grenzwertig lauffähig (KV-Cache knapp kalkuliert), mit zwei Karten komfortabel bemessen; die FP16-Originalfassung mit 140 GB passt nicht – Quantisierte Auslieferung ist der gängige Weg für die L40S.
Nicht empfohlen: kein NVLink (keine Interconnect über mehrere Karten), kein MIG (keine Aufteilung) – im Trainingsszenario fehlt es sowohl an Interconnect als auch an Partitionierung. Die L40S ist für Inferenz, Transcoding und Grafik positioniert; für Training siehe die Einträge zu A100/H100/B300.
Drei Dinge: per nvidia-smi eine L40 als Fälschung entlarven (FP32 91,6 vs. 90,5; 350 W vs. 300 W), Zustand des 16-Pin-Stromanschlusses und der Adapterkabel (häufiger Reklamationsgrund), NVENC/AV1-Code-/Decode in der Praxis testen (Kernargument beim Transcoding). Zusätzlich Goldkontakte und Kühlkörper auf Originalität sichten.
Turbolüfter nachrüsten: Die L40S ist eine passiv gekühlte Dual-Slot-Karte (ohne Lüfter); der Airflow von Tower-Workstations schafft 350 W Passivkühlung nicht – ein Aktivkühl-Adapterrahmen oder ein Rack-Server ist der richtige Weg; außerdem 16-Pin-Stromanschluss und PCIe-Gen4-x16-Slot prüfen.
Verwandte Einträge SEE ALSO
Modellvergleich und Auswahl COMPARE
Quellen REFERENCES
- NVIDIA offiziell – L40S-Spezifikations-Snapshot (stimmt Posten für Posten mit der Spec-Card überein, Stand 10/2026) https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA-Website – L40-Produktseite (Familienvergleich) https://www.nvidia.com/en-us/data-center/l40/
- Angebotssuche – AIXX Börse (provisionsfreie Vermittlung; für die L40S liegt derzeit kein Marktpreis-Snapshot vor, der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers) https://www.aixx.vip/hall.html?model=L40S