AIXX Pedia › Статья о модели › GB300 NVL72
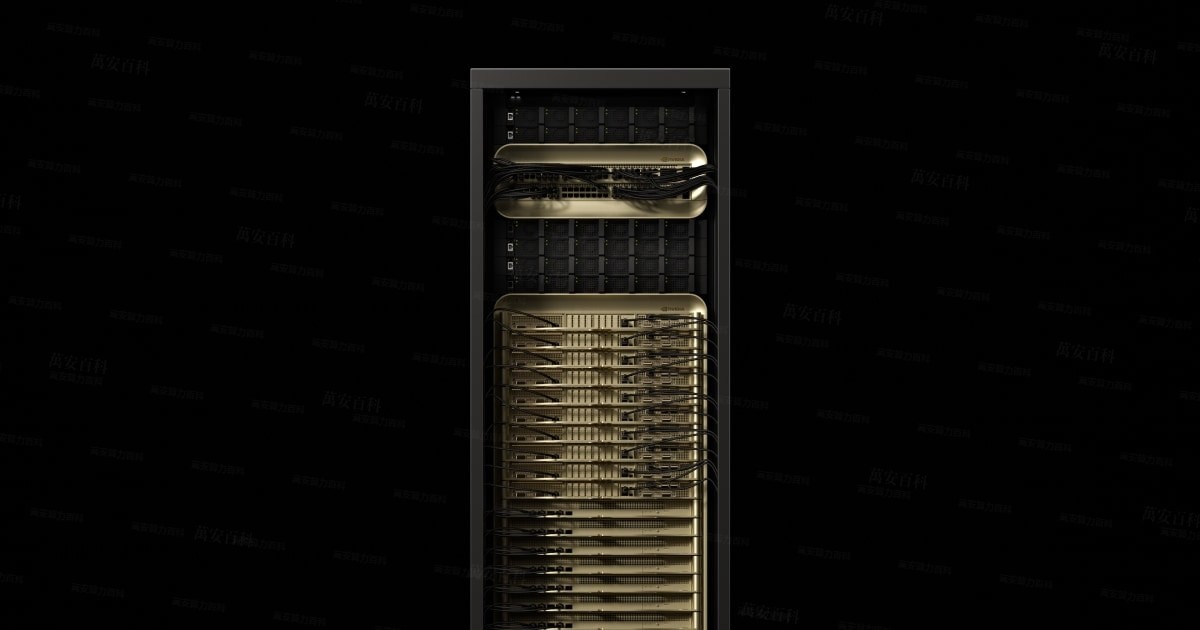
GB300 NVL72
Обзор OVERVIEW
GB300 NVL72 (Полное название — NVIDIA GB300 NVL72, флагманская форма платформы Blackwell Ultra)— это 18 марта 2025 года представленный на GTC суперузел уровня стойки :в один полностью охлаждаемый жидкостью шкаф помещаются 72 GPU Blackwell Ultra и 36 CPU Grace , с полностью связанной пятой версией NVLink суммарной пропускной способностью 130 ТБ/с — весь шкаф для ПО выглядит как один ускоритель[1][3]。
Это носитель букв «NVL72» из названия: N = NVLink-домен, 72 = число GPU в домене. По официальным данным прирост к GB200 NVL72 предыдущего поколения — в 1,5 раза двухколоночный формат официальной страницы по FP4 Tensor Core 1,440 | 10,802 PFLOPS (проверка официальной страницы, октябрь 2026; обе колонки — по официальным сноскам), суммарный объём памяти GPU 20TB HBM3e , питание уровня 132 кВт — поставка на уровне стойки означает, что перед покупкой нужно располагать серверной, в которую её можно разместить[1][2][3].
На рынке наличия 2026 года GB300 NVL72 — это флагманский корабль флота для масштабного обучения и инференс-фабрик : в августе 2025 года CoreWeave первой вывела его в публичное облако, в сентябре 2026 года дебютный публичный результат в MLPerf Inference v6.1, а в том же раунде уже показана и следующее поколение Vera Rubin NVL72 (до 3,7× к GB300, по публичным данным[6]) — место флагмана никого не ждёт, но порог развёртывания и цена системы того же порядка (см. «Охлаждение и развёртывание» и «Рыночный блок»).
Сценарии применения FIT
AIXX Index (0–100): оценка в базе — взвешенный расчёт по открытым спецификациям: объём памяти стойки 40% + интерконнект 30% + экосистема 30%, веса корректируются по сценарию, методика оценки уровня стойки (несопоставима с методикой карточных статей). 90+ флагманский уровень · 75+ Отлично · 60+ пригодно · ниже 60 неприменимо. Методика прозрачна и проверяема, но не является обещанием производительности.
Хронология HISTORY
18 марта 2025 года : в августе 2025 года на GTC keynote представлена платформа Blackwell Ultra: по официальным данным GB300 NVL72 в 1,5 раза быстрее GB200 NVL72, 16 партнёров, включая Cisco / Dell / HPE / Lenovo / Supermicro, поставляют целые стойки со второй половины того же года, на каждый GPU приходится ConnectX-8 SuperNIC 800Gb/s[3].
Июль–сентябрь 2025 , первые системы на месте: CoreWeave объявила о поступлении первых GB300 NVL72 в июле, 19 августа первый в мире коммерческий облачный инстанс GB300 NVL72 (поставка Dell), в её квартальном отчёте зафиксировано «First to deploy NVIDIA GB300 NVL72 systems»; Quanta отгружает с сентября[8].
Сентябрь 2026 , MLPerf Inference v6.1: GB300 NVL72 дебютирует в MLPerf, в MoE-бенчмарках прирост к предыдущему поколению до 2,5 раза ; в том же раунде дебютирует следующее поколение Vera Rubin NVL72, в интерактивных сценариях Qwen3-VL до 3,7 раза к GB300 (по официальному блогу NVIDIA) — впервые в публичных бенчмарках «действующий флагман против преемника» на одной сцене[6][7].
Китайский аспект (нейтрально) : GB300 подпадает под американский экспортный контроль и отсутствует в списке одобренных поставок в Китай (публичные данные на октябрь 2026; США придерживаются политики «презумпции отказа» по лицензиям на топовые чипы для Китая, рамки новых правил BIS от января 2026 сохраняются); в июле 2026 года разрешение на масштабные поставки в Китай получил H200, уровень GB300 одобрен не был — наличный оборот идёт в основном по зарубежным каналам и через зоны свободной торговли. База фиксирует только публично сообщаемые данные и не является юридической консультацией[10].
Технические характеристики SPECIFICATIONS
| Параметр | Спецификации (стойка GB300 NVL72 · официальные данные) |
|---|---|
| Конфигурация | 72× GPU Blackwell Ultra + 36× CPU Grace (2,592× ядра Arm Neoverse V2) |
| FP4 Tensor Core | 1,440 PFLOPS (dense) / 10,802 PFLOPS (разреженно) — в публикациях о релизе и каталогах партнёров фигурирует также «FP4-инференс уровня 1.1 EFLOPS» |
| FP8 / FP6 Tensor Core | 720 PFLOPS |
| FP16 / BF16 · TF32 | 360 / 180 PFLOPS |
| FP64 | 100 TFLOPS |
| Суммарная память GPU | 20TB HBM3e (288 ГБ/карта × 72 = 20.7 ТБ, расчётная оценка), полоса до 576 ТБ/с |
| Суммарная память CPU | 17 ТБ LPDDR5X (полоса 14 ТБ/с); быстрая память суммарно 37 ТБ |
| Интерконнект GPU-GPU | NVLink пятое поколение · суммарно 130 ТБ/с (1.8 ТБ/с на GPU) + 9 полок NVSwitch с полной связностью |
| Конструкция стойки | 18× вычислительных полок (по 4 GPU + 2 Grace в каждой) + 9× полок NVSwitch + 8× стоек питания 33 кВт |
| Охлаждение | полностью с жидкостным охлаждением; внутренний CDU уровня 250 кВт; детекция утечек на уровне полок и стойки |
| Питание | конфигурация 132 кВт (8× стоек 33 кВт); в референс-архитектуре NVIDIA до 142 кВт при полной нагрузке |
| Внешняя сеть | 800 Гбит/с на GPU (ConnectX-8 SuperNIC ×4/полка) + BlueField-3 DPU; масштабирование через Quantum-X800 InfiniBand / Spectrum-X Ethernet |
| Предыдущее / следующее поколение | GB200 NVL72 (разница — прирост в 1,5 раза) / Vera Rubin NVL72 (дебют 2026-09) |
характеристики — по официальным открытым материалам NVIDIA[1][2]; FP4 dense — по официальной странице спецификаций без учёта sparsity, 1,1 EFLOPS — по данным анонса/каталогов партнёров, обе цифры приводятся с указанием источника; тензорная производительность, если не оговорено иное, указана с учётом sparsity; конфигурации стоек различаются в зависимости от OEM и партии.
Разбивка на одну Compute Tray PER TRAY
| Параметр | Одна вычислительная полка (×18) |
|---|---|
| GPU | 4× Blackwell Ultra (суммарно 1,152 ГБ HBM3e) |
| CPU | 2× Grace (72 ядра ×2, суммарно 1 ТБ LPDDR5X) |
| Внутренняя сеть | 4× ConnectX-8 (по 800 Гбит/с) + 1× BlueField-3 DPU |
| Интерфейсы связи | Сзади кабельный картридж NVLink (cable cartridge) с слепым подключением к полке NVSwitch; жидкостные интерфейсы слепо стыкуются с коллектором стойки |
| Эксплуатационный смысл | Вычислительную полку можно менять по отдельности — серийный номер и отчёт прошивки полки — минимальная единица приёмки (см. «Закупка и приёмка») |
данные уровня лотка — из документа референс-архитектуры NVIDIA[2].
Поколения · два NVL72 рядом GENERATIONS
| Параметр | GB200 NVL72 | GB300 NVL72 |
|---|---|---|
| GPU | 72× Blackwell | 72× Blackwell Ultra |
| Память на плату | 192GB HBM3e | 288GB HBM3e |
| Суммарная память GPU | 13.8 ТБ (расчётная оценка) | 20.7 ТБ (расчётная оценка; на официальной странице 20 ТБ) |
| Официальная относительная производительность | Бенчмарк | 1.5× AI performance (по пресс-релизу) |
| Сеть | ConnectX-7 400G | ConnectX-8 800G |
GB200 приведён как публичный ориентир, подробности — в официальных материалах NVIDIA; оба поколения — полностью с жидкостным охлаждением, архитектура 36× Grace.
Модели семейства FAMILY
Семейство GB300 делится по форм-фактору на четыре ветки; в обороте базы — в основном полная стойка GB300 NVL72 и DGX GB300 (системы B300 NVL8 с воздушным охлаждением в контексте материкового Китая см. в статье B300):
Охлаждение и развёртывание COOLING & DEPLOYMENT
GB300 NVL72 Только жидкостное охлаждение :вычислительные полки и полки NVSwitch полностью на жидкостном охлаждении с холодной плитой; жидкостные интерфейсы — сзади полок, слепые разъёмы стыкуются с коллектором стойки, внутренний CDU уровня 250 кВт (данные Supermicro, резервированное питание) гоняет вторичный контур; референс-архитектура NVIDIA требует двухуровневую детекцию утечек — на уровне полок и стойки[2][4]. Развёртывание — не «покупка сервера», а инженерный проект уровня серверной :


Модель и адаптация к кластерам MODEL & CLUSTER FIT
| Модель / сценарий | Требования к памяти (оценка FP8) | Развёртывание GB300 NVL72 (одна стойка, 20.7 ТБ расчётной оценки) | AIXX Index |
|---|---|---|---|
| Многорепликарный инференс полноразмерной DeepSeek R1 (671B) | ~690 ГБ / реплика | В одной стойке 20+ реплик одновременно (расчёт по весам, без KV cache) — запас прочности для высококонкурентной инференс-фабрики | 96 |
| Обучение MoE триллионного масштаба | Веса + состояние оптимизатора — ТБ-уровень | Тензорный/экспертный параллелизм внутри NVLink-домена из 72 GPU, градиенты не выходят из стойки; несколько стоек — через масштабирование 800G | 95 |
| Длинный контекст (уровень миллиона токенов) | KV-кэш растёт линейно с длиной контекста | 20 ТБ пулинговой памяти дают достаточный запас под KV-кэш: одна стойка выдерживает крупномасштабные параллельные нагрузки с длинным контекстом | 92 |
| Конвейеры пакетного инференса малых моделей уровня 7B–14B | Около 8–30 ГБ на инстанс | Работать может, но «стрелять из пушки по воробьям» — для таких конвейеров B300 NVL8 / H200 выгоднее (экономический аспект) | 58 |
Объём видеопамяти оценивается исходя из FP8-весов ≈ число параметров × 1 байт (расчётная оценка, без учёта KV-кэша и запаса на активации); AIXX Index — это стойковая оценка данной базы, обновляется по мере измерений. Конфигурации масштабирования кластера (DGX SuperPOD / межстоечное соединение InfiniBand) — согласно референс-дизайну NVIDIA.
Галерея GALLERY


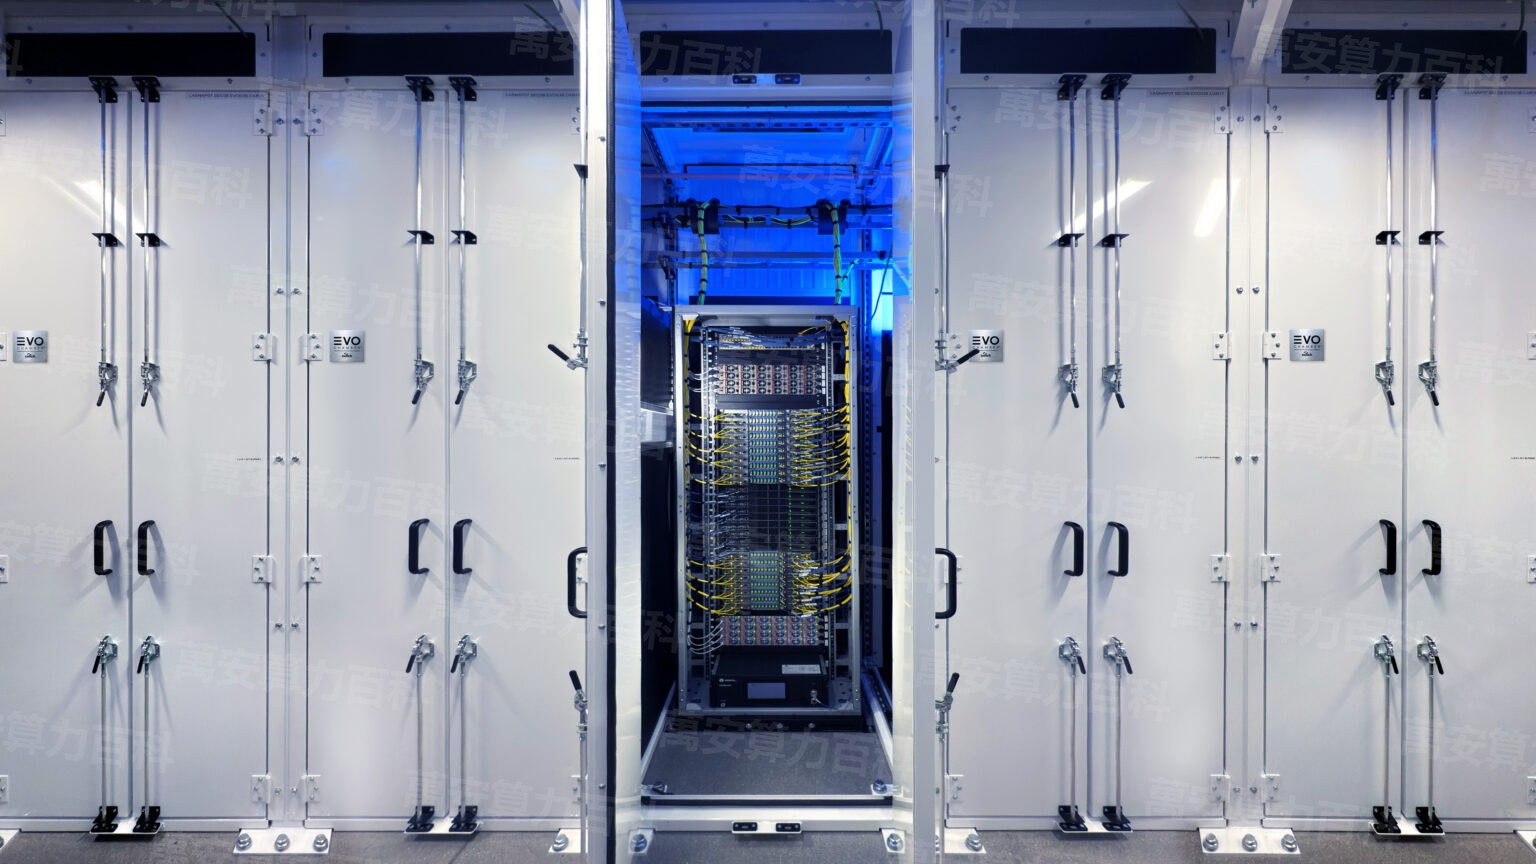
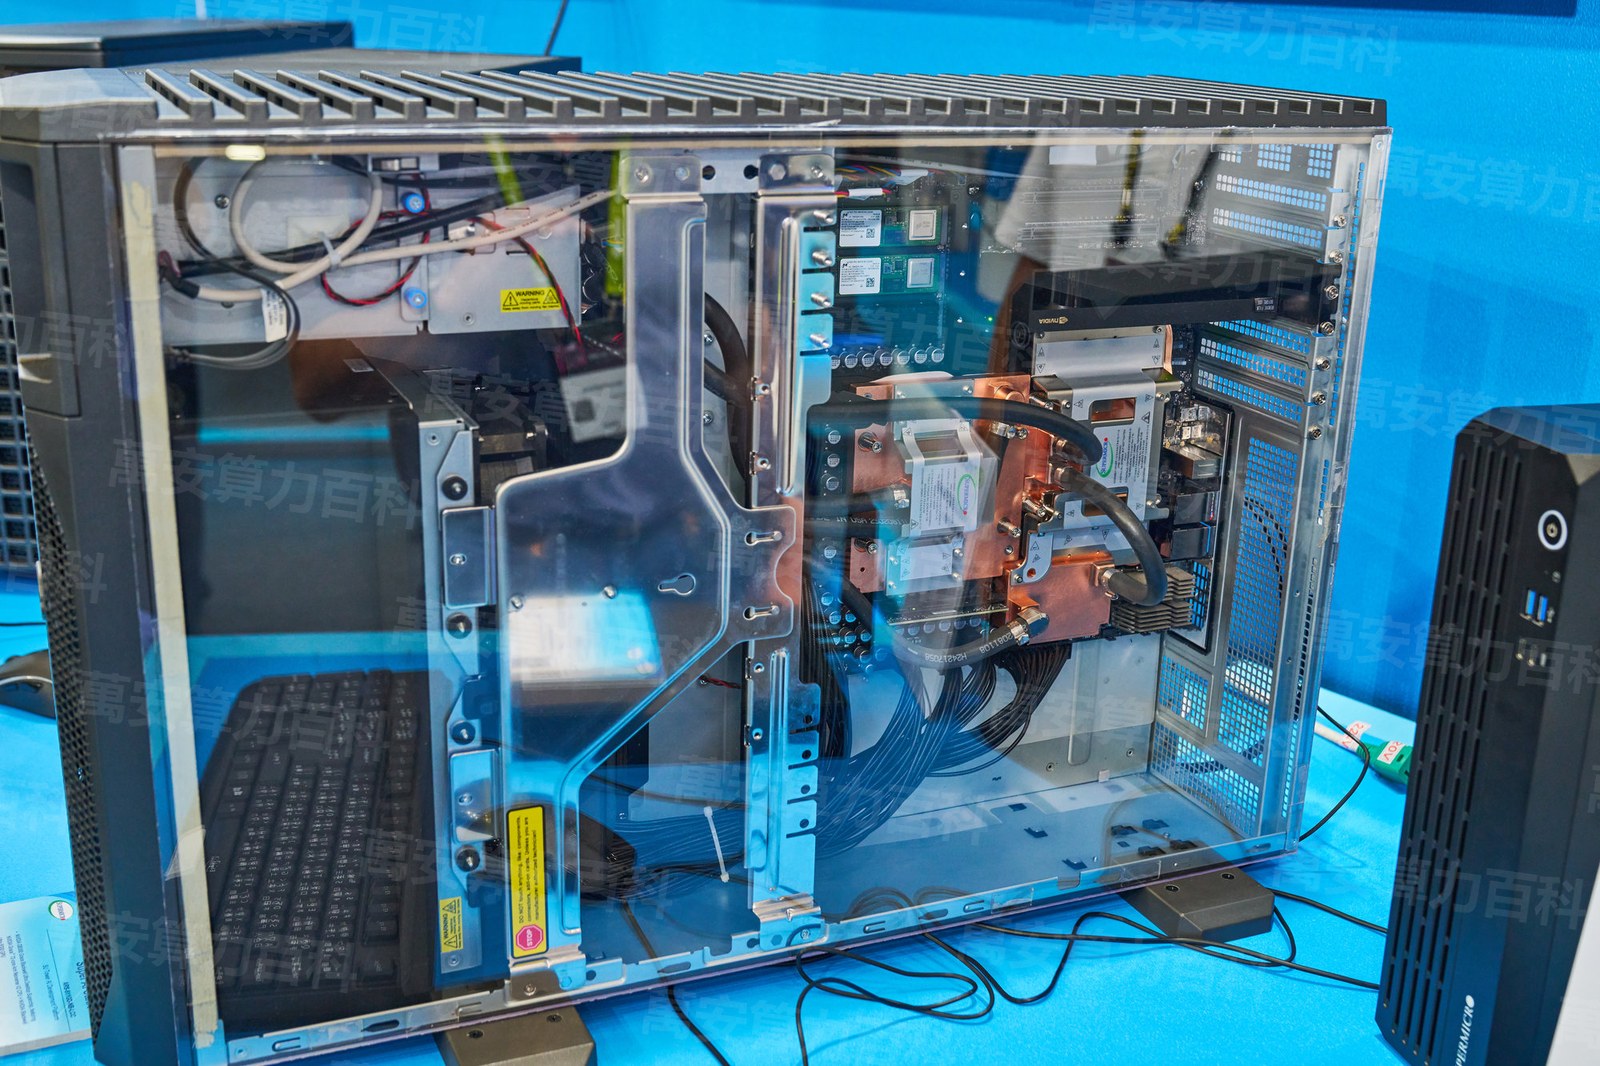
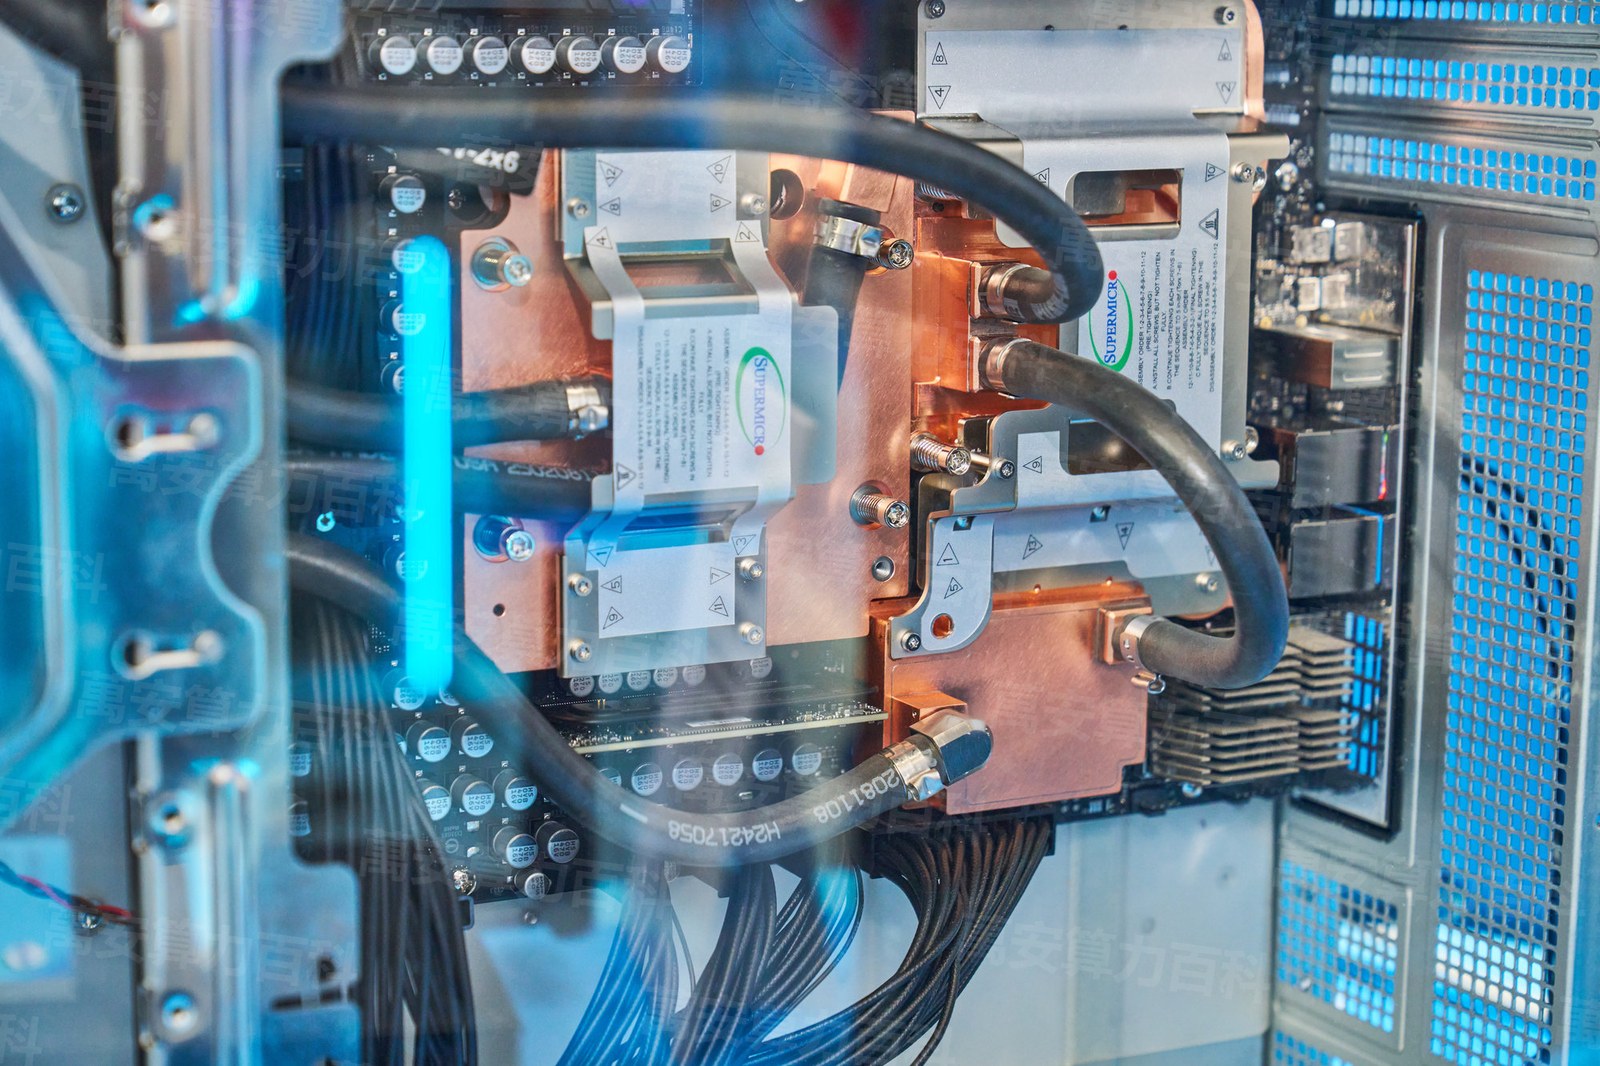
Реальные фотографии постоянно пополняются по мере поступления партий на проверку; официальные рендеры и изображения, созданные ИИ, не выдаются за реальные снимки.
Видеообзор VIDEO
Это видео посвящено стойковому развёртыванию именно GB300 NVL72 (установка стойки → электропитание → жидкостное охлаждение → сеть → приёмка после включения); параметры и критерии привязаны к GB300 NVL72, текст закадровой озвучки и сцен хранится в репозитории _wiki_work_1006/gen_tts_gb300.py.
Реальная машина от сообщества · источник YouTube COMMUNITY HANDS-ON
В некоторых регионах воспроизведение может быть недоступно
Софт и экосистема ECOSYSTEM
| Параметр | Требования / Текущее состояние |
|---|---|
| CUDA / драйверы | То же поколение и тот же стек, что и B300: линия поддержки поколения Blackwell (полная поддержка начиная с CUDA 12.8), подробнее в статье о B300 и в официальной документации NVIDIA |
| Коллективные коммуникации | NCCL имеет нативную оптимизацию для полносвязной топологии NVLink5 / NVSwitch — стоечная приёмка проводится по итогам полного межмашинного теста nccl-tests (см. «Как проводить приёмку») |
| Управление кластером | NVIDIA Base Command / референс-дизайн DGX SuperPOD; сторонние экосистемы Slurm / Kubernetes универсальны (публичные данные) |
| Движки инференса | vLLM / SGLang / TensorRT-LLM — все поддерживают Blackwell Ultra (путь FP4 — новое поколенческое свойство, смотрите релизы конкретных движков) |
| Сетевое оснащение | Quantum-X800 InfiniBand / Spectrum-X Ethernet, 800G оптические соединения (межстоечное масштабирование) |
| Мониторинг эксплуатации | DCGM / лотковое out-of-band управление (out-of-band коммутатор SN2201) — счётчики RAS-событий являются жёстким критерием стоечной приёмки |
Версии программного стека развиваются со временем, ориентируйтесь на официальные релизы NVIDIA; оценка зрелости экосистемы — в статье о B300 (общее для поколения).
Закупка и приёмка PROCUREMENT
Ключевые пункты приёмки GB300 NVL72 при покупке (три пункта, стойковый масштаб):
Пять критериев стоечной приёмки — в этой статье «Как проводить приёмку» этой статьи.
Как проводить приёмку (уровень стойки) RACK ACCEPTANCE
Пять критериев стоечной приёмки (это отдельная система, не совпадающая со стресс-тестами одиночных карт; все числовые критерии привязаны к GB300 NVL72): самотестирование после включения → калибровка жидкостного охлаждения → энергопотребление системы → полный межмашинный тест NCCL → подсчёт RAS-событий.
Этот раздел — стоечный масштаб приёмки; он не совпадает с шестью критериями стресс-тестов в статьях об одиночных картах; порог ≥85% — расчётный критерий данной базы, окончательным является регламент приёмки OEM.
Доставка и приёмка LOGISTICS
OEM и варианты VENDORS
Единая референс-архитектура GB300 NVL72, различия стоек разных вендоров — в доставке, комплектации жидкостного охлаждения и сервисе — при выборе сначала смотрите отличия (в обороте базы уже представлены конфигурации Supermicro / Dell):
| Производитель систем | Форм-фактор | Отличия | Кому подходит |
|---|---|---|---|
| Supermicro | SRS-GB300-NVL72 (оборот базы) | CDU внутри стойки уровня 250 кВт, 8× 33 кВт полки питания, поставка стойки целиком, замкнутый комплект охлаждения собственного производства[4] | Покупка со склада · комплект охлаждения «под ключ» |
| Dell | Стойка GB300 NVL72 (оборот базы; первый поставщик — CoreWeave) | Сервисная сеть первой величины по всему миру, опыт крупных поставок для публичных облаков[8] | Транснациональное развёртывание · Важен сервис |
| Официальная версия AIXX | DGX GB300 / DGX SuperPOD | Официальная поставка «под ключ» + стек ПО (в обороте базы 31 позиция в USD) | Нужен запуск «из коробки» · Нужна поддержка вендора |
| Lenovo / HPE / Cisco | Стойка GB300 NVL72 целиком | Корпоративная сервисная сеть (по спискам партнёров в пресс-релизах[3]) | Закупка через корпоративные каналы |
| Wiwynn / Pegatron / Quanta и др. | Стойки ODM / контрактное производство | Бэкенд-цепочки поставок облачных провайдеров (одна из форм поставки для CoreWeave и др.) | Крупные заказы облачных провайдеров · канал ODM |
AIXX Index · сравнение по четырём осям развёртывания (стоечный уровень) AIXX INDEX
| Производитель систем | Простота установки | Удобство обслуживания | Плотность производительности | Ожидаемый срок службы |
|---|---|---|---|---|
| Supermicro | 72 | 80 | 95 | 82 |
| Dell | 78 | 88 | 95 | 85 |
| Официальная версия AIXX | 82 | 85 | 94 | 85 |
| Lenovo / HPE / Cisco | 76 | 86 | 94 | 84 |
| ODM (Wiwynn/Pegatron/Quanta) | 68 | 72 | 95 | 80 |
AIXX Index — это стоечная оценка нашей базы (0–100; основания оценки = форма поставки стойки целиком, комплект жидкостного охлаждения и различия сервисных сетей; «простота установки» в целом ниже, чем у 8-карточных систем с воздушным охлаждением — это объективное свойство стоечного развёртывания, а не недостаток вендора), обновляется по мере проверки реальных машин и не является обязательством по покупке. Конкретные модели — по официальным данным производителей.
Терминологические карточки GLOSSARY
NVL72 / супернатч
N — это NVLink-домен, 72 — число GPU в домене. 72 GPU через NVSwitch объединены в один NVLink-домен и для ПО выглядят как один «гигантский ускоритель» — в этом смысл термина «супернатч» и принципиальное отличие стоечных продуктов от 8-карточных систем.
Compute Tray — вычислительный лоток
Минимальная вычислительная единица стойки: 4× Blackwell Ultra (суммарно 1 152 ГБ HBM3e) + 2× Grace (суммарно 1 ТБ LPDDR5X) на лоток, всего 18 лотков. Лотки можно менять по отдельности — лотковый серийный номер и отчёт прошивки — минимальная единица доверия при приёмке стойки.
NVSwitch Tray — коммутационный лоток
9 коммутационных лотков обеспечивают полносвязность 72 карт: вычислительные лотки слепо стыкуются с коммутационными через задние NVLink-картриджи (cable cartridge), образуя неблокирующую P2P-матрицу — отсюда и суммарные 130 ТБ/с NVLink5.
CDU и слепое жидкостное охлаждение
CDU (Coolant Distribution Unit, блок распределения хладагента) внутри стойки — уровня 250 кВт, он приводит в движение контур жидкостного охлаждения вторичной стороны; между вычислительными лотками и манифолдом стойки — слепые (blind-mate) разъёмы: лоток вставляется, и контур охлаждения подключается автоматически. Двухуровневая (лотковая + стоечная) детекция протечек — стандарт.
Grace CPU
Процессор NVIDIA на архитектуре Arm (Neoverse V2, 72 ядра): 36 штук на стойку, 2 на лоток, с памятью LPDDR5X (суммарно 17 ТБ). Задача Grace — «кормить» GPU: предобработка данных, коммуникации и диспетчеризация; связь GPU↔CPU — через NVLink-C2C.
Экспортный контроль и партии соответствия
GB300 подпадает под американский экспортный контроль и не входит в список, одобренный для поставок в Китай (публичные данные на 2026-10); оборот наличного товара идёт в основном через зарубежные и зоны свободной торговли. Партия и маршрут таможенного оформления влияют на гарантию и сохранность стоимости — обязательный пункт проверки. Все формулировки нашей базы основаны на публичных сообщениях и не являются юридической консультацией.
Новости и связанные события TIMELINE
Ограничения и споры LIMITS
- Оборотная сторона — порог входа в развёртывание : полностью жидкостное охлаждение + питание уровня 132 кВт (референсная архитектура, максимум 142 кВт под полной нагрузкой) + стойка весом в тонну — существующим машинным залам с воздушным охлаждением это почти недоступно, реконструкция идёт месяцами; если бюджет на переделку машинного зала не заложен, реальнее начать с B300 NVL8 с воздушным охлаждением (см. «Охлаждение и развёртывание»).
- Сжатие поколениями уже стало публичным : в сентябре 2026 года в том же раунде MLPerf новое поколение Vera Rubin NVL72 уже на дебюте обошло GB300 с показателем до 3,7× (Qwen3-VL, по официальному блогу NVIDIA[6]) — окно лидерства флагманских стоек измеряется кварталами, при закупке просчитывайте график амортизации.
- Объект экспортного контроля для Китая (нейтральная формулировка) : GB300 отсутствует в списке одобренных поставок в Китай (публичные данные на октябрь 2026), наличный оборот идёт в основном по зарубежным каналам и через зоны свободной торговли, путь таможенного оформления и статус соответствия напрямую влияют на гарантию и сохранность стоимости[10]. База фиксирует только публично сообщаемые данные и не является юридической консультацией.
- Масштаб цены и ликвидность : единицы миллионов долларов за стойку (по публичным сообщениям о предыдущем поколении GB200 NVL72 — около $3 млн за стойку[9]); господствуют цены за целую партию — вторичный рынок одиночных стоек крайне незрелый, остаточная стоимость сильно зависит от условий серверной и continuity заводской гарантии, издержки перепродажи заметно выше, чем у одиночной карты.
- Разночтения по объёму памяти (18 ТБ против 20 ТБ) : по официальной странице — 20TB (сходится с расчётом 288ГБ×72=20,7TB), в ранних материалах каналов встречается вариант 18TB — в прайсах и контрактах сверяйте с официальными 20TB, приёмку проводите по фактическим данным отчёта прошивки уровня лотка (в config-строках оборота базы всё ещё встречается 18TB, это отмечено в примечаниях к статье).
- Оборотная сторона «одного большого ускорителя» : NVLink-домен — источник его производительности и одновременно граница его рисков — отказ внутри домена затрагивает всю стойку, для эксплуатации нужны лотковая изоляция и быстрая замена лотков (см. RAS в «Как проводить приёмку»), что предъявляет реальные требования к команде эксплуатации.
Рыночный диапазон цен MARKET DATA
| Дата | Методика | Регион | Диапазон ориентировочной цены | Примечание |
|---|---|---|---|---|
| 2026-10-30 | Данные зала в реальном времени | США (USD) | $7,23 млн – 9,18 млн | 48 предложений › (оптовые цены на стойку целиком) |
| 2026-10 | Рыночные ориентиры | Материковый Китай | ¥110 млн – 130 млн | Ориентир по наличным каналам материкового Китая (оптовые цены на стойку целиком) · Стойки в обороте › |
| 2026-10-30 | Данные зала в реальном времени | Ближний Восток (AED) | 48,16–62,64 млн AED | 70 предложений (цены за целую стойку) |
| 2026-10-30 | Данные зала в реальном времени | Европа (EUR) | €9,98 млн – 12,67 млн | 60 предложений (цены за целую стойку) |
| 2026-10-30 | Данные зала в реальном времени | Сингапур (SGD) | 20,69–26,01 млн S$ | 55 предложений (цены за целую стойку) |
| 2026-10-30 | Данные зала в реальном времени | Япония (JPY) | JPY 2 261,01 млн – 2 868,80 млн | 49 предложений (цены за целую стойку) |
| 2025-12 | Рыночные ориентиры | Глобально | Прошлое поколение GB200 NVL72 — около $3 млн за стойку | по публичным сообщениям[9] · официальной цены на GB300 нет · Стойки в обороте › |
| 2026-10-30 | Регуляторный статус | Материковый Китай | Не входит в одобренный для Китая список | GB300 подпадает под американский экспортный контроль; оборот наличного товара идёт в основном через зарубежные и зоны свободной торговли (по публичным сообщениям, не является юридической консультацией) |
Методика: Расчётный диапазон по каналам наличного рынка материкового Китая —— на старте продаж в 2025-08 — расчётный диапазон от референсной цены (зарубежный ориентир $3,4M за стойку ≈ ¥24,5–27 млн; NVIDIA официально цену не объявляла; разброс зависит от канала/конфигурации), с 2026-10 — данные по каналам наличного рынка материкового Китая ( ¥110–130 млн за стойку ); зарубежный ориентир ($3,4 млн уровень) и наличный рынок материкового Китая — два параллельных рынка, между собой не конвертируются. Северная Америка/Европа/Сингапур/Япония/Ближний Восток накапливаются по ежедневным снимкам (USD 3,444–4,229 млн · 25 позиций и др., с 08.10.2026, все в исходных валютах, без пересчёта). GB300 отсутствует в списке одобренных поставок в Китай, цены на материке — в контексте зарубежных каналов и зон свободной торговли (по публичным сообщениям, не является юридической консультацией). Обзор цен базы: AIXX Exchange (сведение сделок без комиссии, не участвует в сделках, не знает и не прогнозирует цен сделок — отсюда нейтральность данных). Фактическая цена определяется предложением продавца.
Ключевые ценовые события MILESTONES
Частые вопросы FAQ
Суперузловая стойка Blackwell Ultra, представленная NVIDIA на GTC в марте 2025 года: 72 GPU Blackwell Ultra + 36 CPU Grace в одной стойке с полностью жидкостным охлаждением, полносвязная топология NVLink5 с суммарной пропускной способностью 130 ТБ/с — для ПО вся система выглядит как один ускоритель. Официальная спецификация FP4 Tensor Core — 1440 PFLOPS (dense), суммарный объём памяти GPU — 20 ТБ HBM3e.
Смотрите по серверной и масштабу: NVL72 требует питания уровня 132 кВт, жидкостного охлаждения с CDU и усиления перекрытий — взамен даёт 20TB памяти в одном домене NVLink, формат для крупномасштабного обучения и инференс-фабрик; NVL8 — 288ГБ на карту, 2,3TB на систему, поэтапное развёртывание в существующих серверных. Есть бюджет на модернизацию серверной — берите NVL72, нет — начинайте с NVL8 (в обороте базы есть оба формата, см. рыночный блок).
GB300 подпадает под американский экспортный контроль и не входит в список одобренных к поставкам в Китай (открытые данные на 2026-10; в июле 2026 одобрение на массовые поставки в Китай получил H200); наличный оборот идёт в основном через зарубежные и зоны свободной торговли. Данная информация — по открытым сообщениям, не является юридической консультацией; перед закупкой руководствуйтесь политикой надзорных органов и профессиональным комплаенс-заключением.
По официальной странице NVIDIA — 20TB HBM3e (288ГБ/карта × 72 = 20,7TB, расчёт сходится; каталог сертификации Red Hat — те же данные); в ранних материалах каналов встречается 18TB (в части config-строк оборота базы тоже). Ориентир — официальные 20TB, прайсы и контракты сверяйте по ним, приёмку проводите по фактическим данным отчёта прошивки уровня лотка.
Нет — для уровня стойки действует другая система приёмки: самотестирование при подаче питания (18+9 лотков поочерёдно подтверждают готовность), калибровка жидкостного охлаждения (расход/перепад температур CDU, детекция утечек — ноль тревог), энергопотребление системы (сходимость на уровне 132–142 кВт полной нагрузки), полный NCCL-тест связности (all_reduce на 72 картах против заявленных характеристик NVLink5), счётчики RAS-событий (ноль неисправимых ошибок ECC и прерываний). Посерийная проверка подлинности каждого лотка — минимальная доверительная единица приёмки стойки (см. «Как принимать»).
Связанные статьи SEE ALSO
Сравнение моделей и выбор COMPARE
Источники REFERENCES
- Официальный сайт NVIDIA — страница продукта GB300 NVL72 (основной источник спецификаций, проверено 2026-10) https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- NVIDIA — Enterprise Reference Architecture NVL72 AI Factory: компоненты системы (лотки/питание/жидкостное охлаждение, проверено 2026-10) https://docs.nvidia.com/enterprise-reference-architectures/n…
- Пресс-центр NVIDIA — NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning (пресс-релиз 2025-03-18: 1,5×/H2 2025/16 партнёров/CX-8 800G) https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Supermicro — официальная страница SRS-GB300-NVL72 (132 кВт / CDU 250 кВт / габариты) https://www.supermicro.com/en/products/rack/srs-gb300-nvl72
- Каталог сертификации Red Hat — GB300 NVL72 (1,1 ExaFLOPS / 20,7 ТБ HBM3e, данные каталога партнёров) https://catalog.redhat.com/en/hardware/system/detail/307917
- Официальный блог NVIDIA — дебют Vera Rubin NVL72 в MLPerf, Qwen3-VL до 3,7× против GB300 (2026-09-16) https://blogs.nvidia.com
- MLCommons — результаты MLPerf Inference v6.1 (дебют GB300 NVL72, до 2,5× на MoE, 2026-09-17) https://mlcommons.org
- CoreWeave — GA облачных инстансов GB300 NVL72 (changelog 2025-08-19) и «First to deploy» в квартальном отчёте за Q3 2025 https://docs.coreweave.com
- Forbes — около $3 млн за стойку GB200 NVL72 (2025-12-23, ценовой якорь предыдущего поколения) https://www.forbes.com
- CNBC / США — экспортный контроль в отношении Китая и новые правила BIS от 2026-01 (по открытым сообщениям) https://www.cnbc.com
- Pegatron NVIDIA GB300 NVL72 and More at NVIDIA GTC 2025 (фото вычислительных лотков) https://www.servethehome.com/pegatron-nvidia-gb300-nvl72-and…
- Supermicro NVIDIA B300 и обзор AI Factory (фото стойки GB300 NVL72 от Supermicro) https://www.servethehome.com/checking-out-the-supermicro-nvi…
- Данные рыночного блока — AIXX Exchange (диапазоны цен в обороте платформы и сведения о каналах, обновляется ежедневно) /hall.html