AIXX Pedia › Ficha de modelo › GB300 NVL72
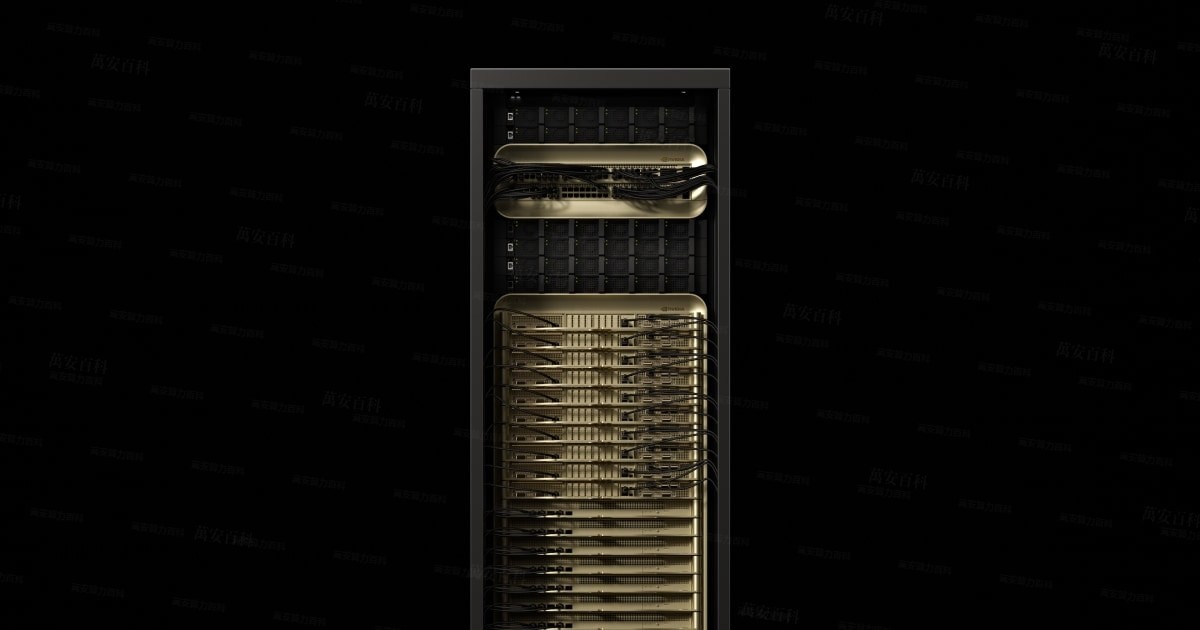
GB300 NVL72
Visão geral OVERVIEW
GB300 NVL72 (nome completo NVIDIA GB300 NVL72, a forma topo de gama da plataforma Blackwell Ultra) é um supernó ao nível de rack lançado pela NVIDIA na GTC a 18 de março de 2025 : coloca 72 GPUs Blackwell Ultra e 36 CPUs Grace num único rack totalmente refrigerado a líquido, com a quinta geração de NVLink a fornecer 130 TB/s agregados de interligação total — aos olhos do software, todo o rack é um único acelerador[1][3]。
. É o veículo das três letras «NVL72» do nome: N = domínio NVLink, 72 = número de GPUs num domínio. Segundo os números oficiais, oferece 1,5× , Tensor Core FP4 página oficial de duas colunas 1,440 | 10,802 PFLOPS (verificação da página oficial em out/2026; os critérios das duas colunas seguem as notas de rodapé oficiais), total de memória de GPU 20TB HBM3e , alimentação na faixa de 132 kW — a entrega ao nível de rack significa que, antes de comprá-lo, é preciso já ter uma sala de servidores que o acomode[1][2][3].
e alimentação na ordem dos 132 kW — a entrega ao nível de rack significa que, antes de o comprar, é preciso ter uma sala de máquinas capaz de o alojar No mercado de stock de 2026, o GB300 NVL72 é : em agosto de 2025, a CoreWeave foi a primeira a levá-lo à nuvem pública; em setembro de 2026, a estreia no MLPerf Inference v6.1 trouxe resultados públicos, e na mesma rodada a próxima geração Vera Rubin NVL72 já apareceu (até 3,7× sobre o GB300, segundo dados públicos[6]) — o posto de flagship não espera por ninguém, mas os requisitos de implantação e o preço do sistema completo estão na mesma ordem de grandeza (veja «Refrigeração e Implantação» e «Faixa de Mercado»).
Cenários de uso FIT
AIXX Index ). O trono de topo de gama não espera por ninguém — mas a barreira de implantação e o preço do conjunto completo estão na mesma ordem de grandeza (ver «Refrigeração e implantação» e «Faixa de mercado»). (0–100): estimativa ponderada desta base a partir de especificações públicas — 40% memória do rack + 30% interligação + 30% ecossistema, com pesos ajustados por cenário, segundo o critério de estimativa ao nível de rack (não comparável com o critério das fichas de GPU individual). 90+ nível flagship · 75+ Excelente · 60+ utilizável · abaixo de 60 não recomendado. Metodologia transparente e verificável; não constitui promessa de desempenho.
Histórico HISTORY
supernó ao nível de rack , no keynote da GTC, foi lançada a plataforma Blackwell Ultra: segundo a cifra oficial, o GB300 NVL72 é 1,5× mais rápido que o GB200 NVL72; 16 parceiros, incluindo Cisco / Dell / HPE / Lenovo / Supermicro, passaram a entregar racks completos a partir do segundo semestre do mesmo ano, com ConnectX-8 SuperNIC de 800 Gb/s por GPU[3].
Julho-setembro de 2025 , primeiros sistemas em produção: a CoreWeave anunciou em julho a chegada dos primeiros GB300 NVL72, a 19 de agosto a primeira instância cloud GB300 NVL72 do mundo entrou em produção comercial (entrega da Dell), seu relatório trimestral ficou registrado como «First to deploy NVIDIA GB300 NVL72 systems»; a Quanta começou a expedir em setembro[8].
Setembro de 2026 , MLPerf Inference v6.1: o GB300 NVL72 estreia-se no MLPerf com ganho de até 2,5× nos benchmarks MoE face à geração anterior; na mesma ronda estreia-se também o sucessor Vera Rubin NVL72, com até 3,7× sobre o GB300 (segundo o blog oficial da NVIDIA) — a primeira vez em benchmarks públicos que «flagship em atividade vs. sucessor» aparecem lado a lado[6][7].
Panorama para a China (neutro) : o GB300 está sujeito ao controle de exportação dos EUA e não consta na lista de licenças aprovadas para a China (dados públicos de out/2026; os EUA mantêm uma política de «recusa presumida» para licenças de chips de ponta destinados à China, com o novo arcabouço da BIS de janeiro de 2026 em vigor); em julho de 2026, o H200 foi o chip aprovado em volume para a China, sem aprovação para a classe do GB300 — a circulação spot concentra-se em canais no exterior e zonas de livre comércio. Esta base registra apenas dados de fontes públicas e não constitui parecer jurídico[10].
Especificações técnicas SPECIFICATIONS
| Item | Especificações (rack GB300 NVL72 · números oficiais) |
|---|---|
| Configuração | 72× GPU Blackwell Ultra + 36× CPU Grace (2.592 núcleos Arm Neoverse V2) |
| FP4 Tensor Core | 1.440 PFLOPS (denso) / 10.802 PFLOPS (esparso) — comunicados de lançamento e catálogos de parceiros citam também «1,1 EFLOPS de inferência FP4» |
| FP8 / FP6 Tensor Core | 720 PFLOPS |
| FP16 / BF16 · TF32 | 360 / 180 PFLOPS |
| FP64 | 100 TFLOPS |
| Memória total das GPUs | 20TB HBM3e (288 GB/GPU × 72 = 20,7 TB, estimativa), largura de banda até 576 TB/s |
| Memória total das CPUs | 17 TB LPDDR5X (14 TB/s de largura de banda); 37 TB de memória rápida no total |
| Interconexão GPU-GPU | NVLink de 5.ª geração · 130 TB/s agregados (1,8 TB/s por GPU) + 9 bandejas NVSwitch em malha completa |
| Estrutura do rack | 18× bandejas de computação (4 GPUs + 2 Grace por bandeja) + 9× bandejas NVSwitch + 8× prateleiras de alimentação de 33 kW |
| Refrigeração | totalmente refrigerado a líquido (fully liquid-cooled); CDU interno na ordem dos 250 kW; deteção de fugas ao nível de bandeja e de rack |
| Alimentação | configuração de 132 kW (8× prateleiras de 33 kW); arquitetura de referência NVIDIA até 142 kW em Carga máxima |
| Rede externa | 800 Gb/s por GPU (ConnectX-8 SuperNIC ×4/bandeja) + BlueField-3 DPU; expansão Quantum-X800 InfiniBand / Spectrum-X Ethernet |
| Geração anterior / seguinte | GB200 NVL72 (1,5× de diferença de desempenho) / Vera Rubin NVL72 (estreia em 2026-09) |
As especificações seguem os dados públicos oficiais da NVIDIA[1][2]; o FP4 dense vem da página oficial de especificações sem esparsidade, o valor de 1,1 EFLOPS vem dos comunicados/catálogos de parceiros, ambas as cifras coexistem com fonte indicada; o desempenho Tensor, salvo indicação, considera esparsidade; a configuração do rack varia conforme OEM e lote.
Critério de desagregação por Compute Tray PER TRAY
| Item | Uma bandeja de computação (×18) |
|---|---|
| GPU | 4× Blackwell Ultra (1.152 GB HBM3e no total) |
| CPU | 2× Grace (72 núcleos ×2, 1 TB LPDDR5X no total) |
| Rede interna | 4× ConnectX-8 (800 Gb/s cada) + 1× BlueField-3 DPU |
| Interfaces de interligação | cartucho de cabos NVLink traseiro (cable cartridge) com conexão cega às bandejas NVSwitch; interfaces líquidas de conexão cega ao manifold do rack |
| Implicações operacionais | as bandejas de computação podem ser retiradas e substituídas individualmente — o número de série e o reporte de firmware ao nível de bandeja são a menor unidade de verificação na receção (ver «Aquisição e inspeção») |
Os dados ao nível de bandeja saem dos documentos de arquitetura de referência da NVIDIA[2].
Comparação geracional · duas gerações de NVL72 lado a lado GENERATIONS
| Item | GB200 NVL72 | GB300 NVL72 |
|---|---|---|
| GPU | 72× Blackwell | 72× Blackwell Ultra |
| Memória de vídeo por placa | 192GB HBM3e | 288GB HBM3e |
| Memória total das GPUs | 13,8 TB (estimativa) | 20,7 TB (estimativa; página oficial indica 20 TB) |
| Desempenho relativo oficial | Benchmark | 1,5× AI performance (segundo o comunicado de imprensa) |
| Rede | ConnectX-7 400G | ConnectX-8 800G |
GB200 indicado como referência de números públicos, ver documentação oficial da NVIDIA; ambas as gerações são totalmente refrigeradas a líquido, com arquitetura de 36× Grace.
Membros da família FAMILY
A família GB300 divide-se em quatro variantes por formato; a circulação nesta base concentra-se no rack completo GB300 NVL72 e no DGX GB300 (o sistema B300 NVL8 refrigerado a ar, no contexto chinês, veja a entrada B300):
Refrigeração e implantação COOLING & DEPLOYMENT
GB300 NVL72 Um único formato: refrigerado a líquido : as bandejas de computação e as NVSwitch são todas com refrigeração líquida por placa fria; a interface líquida fica na parte traseira das bandejas, com conectores de inserção cega para o manifold do rack; o CDU interno, na ordem dos 250 kW (números da Supermicro, com alimentação redundante), aciona o circuito secundário; a arquitetura de referência da NVIDIA exige deteção de fugas em dois níveis, por bandeja e por rack[2][4]. Implantá-lo não é «comprar um servidor», é um projeto de engenharia de sala de máquinas :


Modelo e adequação a clusters MODEL & CLUSTER FIT
| Modelo / cenário | Necessidade de memória (estimativa FP8) | Implantação do GB300 NVL72 (20,7 TB por rack, estimativa) | AIXX Index |
|---|---|---|---|
| Inferência multi-réplica do DeepSeek R1 completo (671B) | cerca de 690 GB / réplica | um rack co-hospeda 20+ réplicas (estimativa pelos pesos, sem contar KV cache) — a base de qualquer fábrica de inferência de alta concorrência | 96 |
| Treino MoE ao nível de triliões de parâmetros | pesos + estados de otimizador na ordem dos TB | paralelismo tensorial/de especialistas dentro do domínio NVLink das 72 GPUs, gradientes nunca saem do rack; expansão multi-rack via 800G | 95 |
| Contextos longos (na escala de milhões de tokens) | O KV cache cresce linearmente com o contexto | 20TB de memória em pool deixam folga suficiente para o KV; um único rack já suporta grande concorrência de contextos longos | 92 |
| Linhas de produção em lote para pequenos modelos de 7B-14B | Cerca de 8-30GB / instância | Dá para rodar, mas é «usar canhão para matar passarinho» — para esse tipo de linha, B300 NVL8 / H200 sai mais em conta (critério de custo-benefício) | 58 |
Memória estimada com pesos em FP8 ≈ n.º de parâmetros × 1 byte (estimativa, sem incluir KV cache nem margem de ativações); o AIXX Index é uma estimativa ao nível de rack desta base, atualizada conforme medições reais. As topologias de expansão em cluster (DGX SuperPOD / interconexão InfiniBand multi-rack) seguem os designs de referência da NVIDIA.
Galeria GALLERY
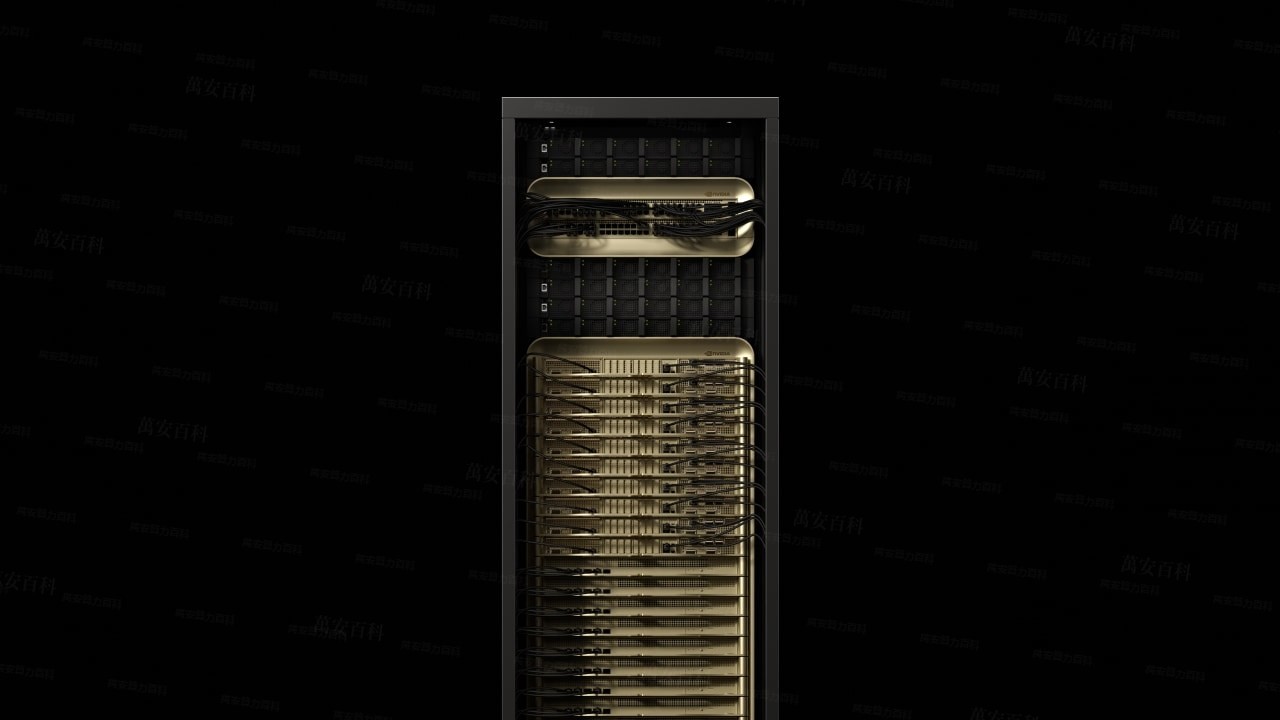


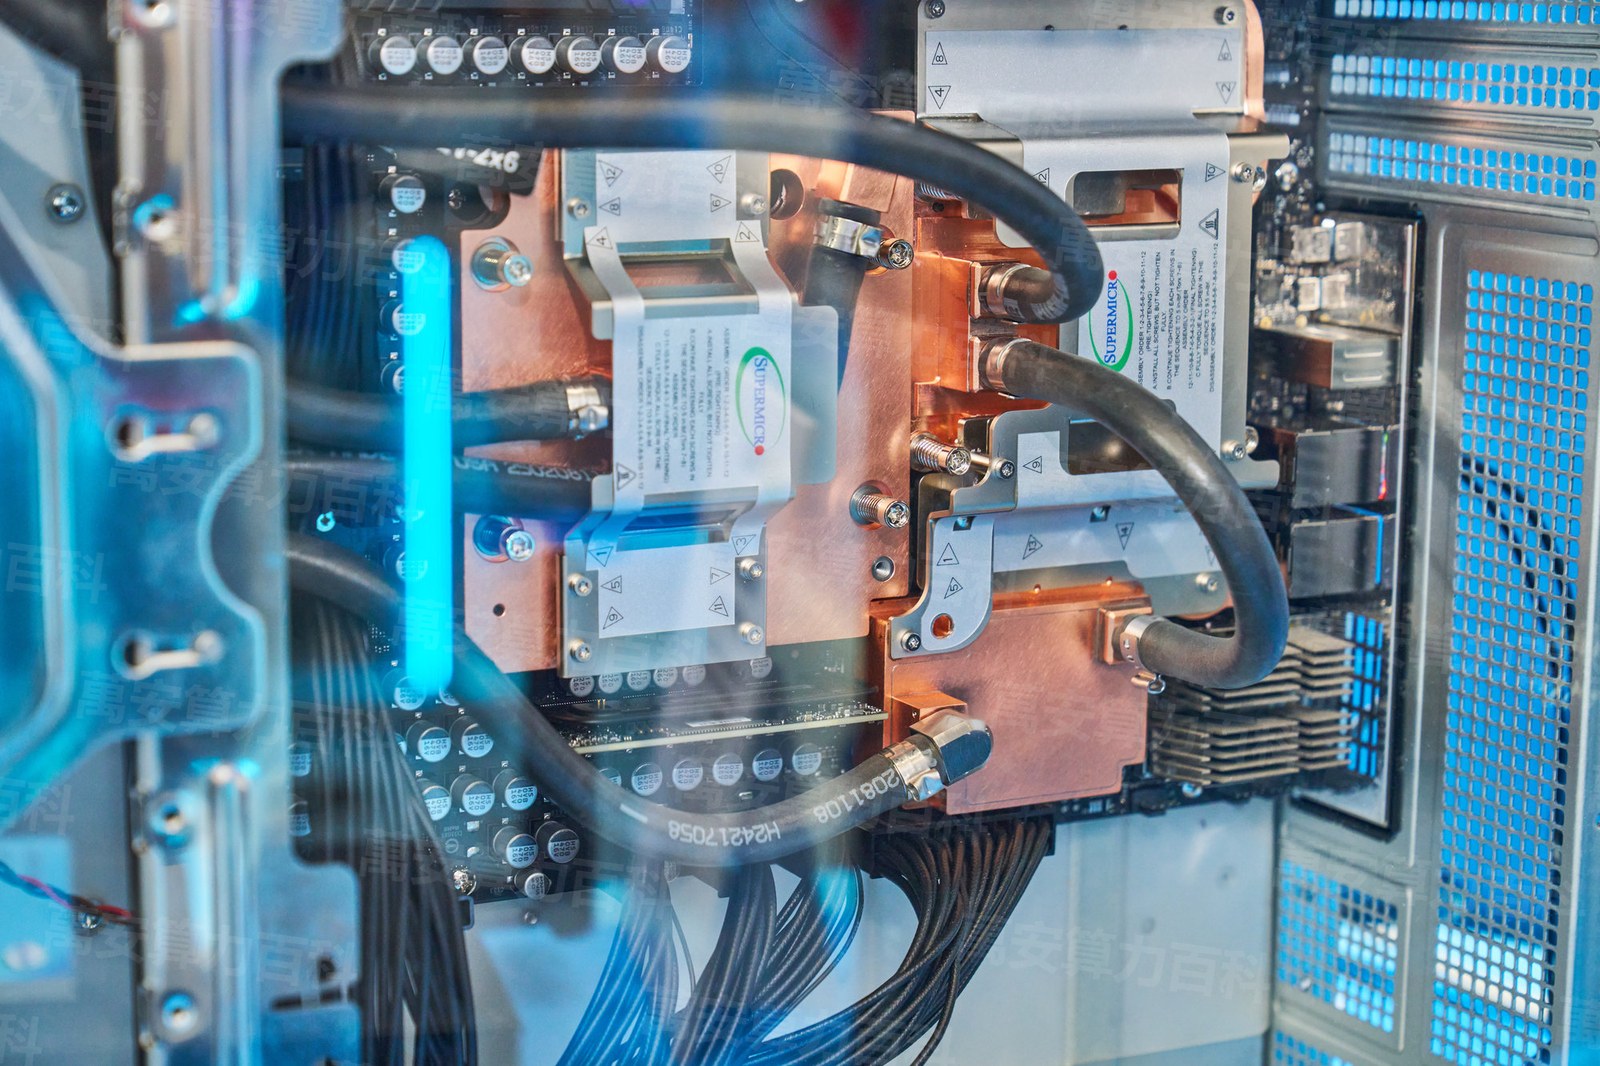
As fotos reais são continuamente atualizadas a cada lote de inspeção; renders oficiais não são apresentados como fotos reais, e imagens geradas por IA não são apresentadas como fotos reais.
Vídeo explicativo VIDEO
Este vídeo apresenta a perspetiva de implantação exclusiva do GB300 NVL72 ao nível de rack (posicionamento do rack → alimentação → refrigeração líquida → rede → verificação na ligação); os parâmetros e critérios estão ancorados no GB300 NVL72; o texto da narração e das legendas está arquivado em _wiki_work_1006/gen_tts_gb300.py.
Máquina real da comunidade · fonte: YouTube COMMUNITY HANDS-ON
Em algumas regiões pode não ser possível reproduzir diretamente
Software e ecossistema ECOSYSTEM
| Item | Requisitos / situação atual |
|---|---|
| CUDA / drivers | Mesma geração e mesma stack do B300: a linha de suporte da geração Blackwell (suporte completo a partir do CUDA 12.8); ver a ficha do B300 e a documentação oficial da NVIDIA |
| Comunicação coletiva | O NCCL tem otimização nativa para a interconexão total NVLink5 / NVSwitch — a aceitação ao nível de rack valida-se com o teste de conexão total de todas as GPUs via nccl-tests (ver «Como aceitar») |
| Gestão de cluster | NVIDIA Base Command / design de referência DGX SuperPOD; ecossistemas de terceiros como Slurm / Kubernetes compatíveis de forma geral (informação pública) |
| Motores de inferência | vLLM / SGLang / TensorRT-LLM suportam todos Blackwell Ultra (o caminho FP4 é uma novidade da geração, conforme os lançamentos de cada engine) |
| Infraestrutura de rede | Quantum-X800 InfiniBand / Spectrum-X Ethernet, interconexão ótica de 800G (expansão multi-rack) |
| Operação e monitorização | DCGM / gestão out-of-band ao nível da bandeja (switch out-of-band SN2201) — a contagem de eventos RAS é um indicador duro na aceitação do rack |
As versões do stack de software evoluem com o tempo, prevalecendo os lançamentos oficiais da NVIDIA; a avaliação da maturidade do ecossistema consta na ficha do B300 (partilhada na mesma geração).
Aquisição e inspeção PROCUREMENT
Pontos de inspeção na compra de um GB300 NVL72 (três itens, critério ao nível de rack):
Cinco critérios de aceitação ao nível de rack constam desta ficha «Como aceitar» desta ficha.
Como realizar a inspeção (nível rack) RACK ACCEPTANCE
Cinco critérios de aceitação ao nível de rack (sistema distinto dos testes de stress por placa; todos os valores de referência ancorados no GB300 NVL72 real): autoteste na ligação → calibração do líquido → consumo do sistema completo → teste de conexão total NCCL → contagem de eventos RAS.
Esta secção aplica critérios de aceitação ao nível de rack, não intercambiáveis com os seis critérios de «Como testar» da ficha por placa; a linha proporcional de ≥85% é critério desta base (estimativa), prevalecendo a norma de aceitação do OEM.
Transporte e entrega LOGISTICS
OEM e variantes VENDORS
A mesma arquitetura de referência GB300 NVL72, e as diferenças entre os racks de cada fornecedor estão na entrega, no suporte de refrigeração a líquido e nos serviços — antes de escolher, veja as distinções (a circulação nesta base já cobre as versões Supermicro / Dell):
| Fabricante | Formato representativo | Diferenciais | Para quem |
|---|---|---|---|
| Supermicro | SRS-GB300-NVL72 (critério de circulação nesta base) | CDU interno classe 250kW, 8× bastidores de 33kW, entrega de rack completo, pacote de refrigeração líquida fechado da própria casa[4] | Compra em stock · solução de refrigeração líquida completa num só ponto |
| Dell | Rack completo GB300 NVL72 (critério de circulação nesta base; primeiro cliente de entrega: CoreWeave) | Rede de serviço global de primeira linha, experiência em entregas de grandes encomendas de nuvem pública[8] | Implantação multinacional · foco em serviços |
| Oficial NVIDIA | DGX GB300 / DGX SuperPOD | Entrega integrada oficial + stack de software completo (31 registros em USD na circulação desta base) | Treino pronto para uso · suporte do fabricante |
| Lenovo / HPE / Cisco | Rack completo GB300 NVL72 | Rede de serviços corporativos (conforme lista de parceiros dos comunicados à imprensa[3]) | Compra por canal de clientes empresariais |
| Wiwynn / Pegatron / Quanta, entre outros | Rack completo ODM / fabricação por encomenda | Backend da cadeia de fornecimento dos cloud providers (uma das formas de entrega da CoreWeave, etc.) | Grandes encomendas de cloud · canal ODM |
AIXX Index · comparação de implantação em quatro dimensões (nível de rack) AIXX INDEX
| Fabricante | Facilidade de instalação | Facilidade de manutenção | Densidade de desempenho | Expectativa de vida útil |
|---|---|---|---|---|
| Supermicro | 72 | 80 | 95 | 82 |
| Dell | 78 | 88 | 95 | 85 |
| Oficial NVIDIA | 82 | 85 | 94 | 85 |
| Lenovo / HPE / Cisco | 76 | 86 | 94 | 84 |
| ODM (Wiwynn/Pegatron/Quanta) | 68 | 72 | 95 | 80 |
O AIXX Index é uma estimativa desta base ao nível de rack (0–100, com base na forma de entrega do rack completo, no pacote de refrigeração líquida e nas diferenças de rede de serviços; «facilidade de instalação» é geralmente inferior à de sistemas de 8 placas refrigerados a ar — atributo objetivo da implantação ao nível de rack, e não uma falha do fabricante), atualizado conforme verificação em equipamento real, sem constituir compromisso de compra. Os modelos específicos prevalecem conforme o lançamento oficial do fabricante.
Cartões de terminologia GLOSSARY
NVL72 / supernó
N = domínio NVLink, 72 = número de GPUs no domínio. As 72 GPUs são totalmente interligadas via NVSwitch num único domínio NVLink, apresentando-se ao software como um único «acelerador gigante» — é este o significado de «supernó», e a diferença essencial entre produtos ao nível de rack e sistemas de 8 placas.
Bandeja de computação (Compute Tray)
A menor unidade de computação do rack: cada bandeja tem 4× Blackwell Ultra (1.152GB de HBM3e no total) + 2× Grace (1TB de LPDDR5X no total), num total de 18 bandejas. As bandejas podem ser substituídas individualmente — o número de série e o relatório de firmware ao nível da bandeja são a menor unidade fiável de inspeção do rack.
Bandeja de comutação (NVSwitch Tray)
9 bandejas de comutação suportam a interconexão total das 72 GPUs: as bandejas de computação ligam-se por blind-mate às bandejas de comutação via cartuchos de cabos NVLink (cable cartridge) na traseira, formando uma matriz P2P sem bloqueio — daí os 130TB/s de largura de banda NVLink5.
CDU e refrigeração líquida blind-mate
O CDU (Coolant Distribution Unit, unidade de distribuição de refrigerante) de classe 250kW dentro do rack move o circuito secundário de refrigeração líquida; entre as bandejas de computação e o manifold do rack há conectores blind-mate — basta empurrar a bandeja para ligar o circuito de líquido. Deteção de fugas em dois níveis (bandeja + rack) é de série.
Grace CPU
CPU Arm da NVIDIA (Neoverse V2, 72 núcleos), 36 por rack, 2 por bandeja, com memória LPDDR5X (17TB no total). A Grace «alimenta» as GPUs: pré-processamento de dados, comunicação e agendamento; a ligação GPU↔CPU faz-se via NVLink-C2C.
Controles de exportação e lotes de conformidade
O GB300 está sujeito ao controlo de exportação dos EUA e não consta da lista aprovada para o mercado chinês (informação pública de 2026-10); a circulação em stock dá-se sobretudo por canais no estrangeiro e em zonas francas. Lotes e caminho aduaneiro afetam garantia e retenção de valor — verificação obrigatória na inspeção. Todas as afirmações desta base seguem relatos públicos e não constituem parecer jurídico.
Novidades e eventos relacionados TIMELINE
Limitações e controvérsias LIMITS
- A barreira de implantação é o outro lado da moeda : refrigeração totalmente líquida + alimentação de classe 132kW (até 142kW em carga máxima na arquitetura de referência) + carga de piso de toneladas — salas de servidores refrigeradas a ar existentes ficam praticamente de fora, e a remodelação mede-se frequentemente em meses; para quem não tem orçamento para remodelar, o sistema refrigerado a ar B300 NVL8 é um primeiro passo mais realista (ver «Refrigeração e implantação»).
- A compressão geracional já é pública : na mesma rodada do MLPerf de setembro de 2026, a próxima geração Vera Rubin NVL72 estreou superando o GB300 com até 3,7× (Qwen3-VL, segundo o blog oficial da NVIDIA[6]) — a janela de vantagem de um rack flagship se mede em trimestres; a decisão de compra precisa levar em conta o ritmo de depreciação.
- Modelo sujeito a controlo de exportação para a China (formulação neutra) : o GB300 não consta na lista de aprovações para a China (dados públicos de out/2026); a circulação spot concentra-se em canais no exterior e zonas de livre comércio, e o caminho aduaneiro e o status de conformidade afetam diretamente a garantia e a retenção de valor[10]. Esta base registra apenas dados de fontes públicas e não constitui parecer jurídico.
- Magnitude de preço e liquidez : na faixa de vários milhões de dólares por rack (reportagens públicas sobre a geração anterior, GB200 NVL72, apontavam cerca de US$ 3 milhões por rack[9]), com ofertas predominantes por lote completo — o mercado de revenda de racks individuais é extremamente imaturo, o valor residual depende muito das condições da sala de servidores e da continuidade da garantia do fabricante, e o custo de revenda é muito maior que o de uma placa avulsa.
- Divergência de critérios na capacidade de memória (18TB vs 20TB) : a página oficial indica 20 TB (288 GB × 72 = 20,7 TB, consistente com o cálculo); materiais iniciais de canal trazem a cifra de 18 TB — verifique cotações e contratos pela cifra oficial de 20 TB, e a aceitação deve se basear em medições do relatório de firmware ao nível de bandeja (ainda se vê a cifra de 18 TB em strings de config em circulação nesta base, devidamente anotada no critério desta entrada).
- O outro lado de «um único cartão gigante» : o domínio NVLink é simultaneamente a sua fonte de desempenho e o limite do seu risco — uma falha no domínio afeta todo o rack, e a operação exige capacidade de isolamento ao nível da bandeja e troca rápida de bandejas (ver item RAS em «Como aceitar»), um requisito real para a equipa de operações.
Faixa de mercado MARKET DATA
| Data | Critério | Região | Faixa de preço de referência | Observação |
|---|---|---|---|---|
| 2026-10-30 | Salão em tempo real | EUA (USD) | $7,23M – 9,18M | 48 cotações › (critério de preço por rack completo) |
| 2026-10 | Referência de canal | China continental | ¥110M – ¥130M | Critério de canal em stock no continente (critério de preço por rack completo) · Racks em circulação › |
| 2026-10-30 | Salão em tempo real | Oriente Médio (AED) | AED 48,16 – 62,64 milhões | 70 cotações (critério de oferta por rack completo) |
| 2026-10-30 | Salão em tempo real | Europa (EUR) | €9,98M – 12,67M | 60 cotações (critério de preço por rack completo) |
| 2026-10-30 | Salão em tempo real | Singapura (SGD) | S$ 20,69 – 26,01 milhões | 55 cotações (critério de oferta por rack completo) |
| 2026-10-30 | Salão em tempo real | Japão (JPY) | JPY 2.261,01M – 2.868,8M | 49 cotações (critério de oferta por rack completo) |
| 2025-12 | Referência de canal | Global | Geração anterior GB200 NVL72 cerca de $3 milhões / rack | Critério de reportagens públicas[9] · o GB300 não tem preço oficial · Racks em circulação › |
| 2026-10-30 | Critério de política | China continental | Não consta da lista aprovada para a China | O GB300 está sujeito a controlo de exportação dos EUA; a circulação em stock dá-se sobretudo por canais no estrangeiro e em zonas francas (critério de relatos públicos, sem constituir parecer jurídico) |
Critério: Faixa estimada pelo canal de spot do mercado continental —— a faixa de lançamento de 2025-08 parte de preço de referência estimado (com base na referência de canal no exterior de $3.4M/rack ≈¥24,5-27 milhões; NVIDIA não publicou preço oficial; largura da faixa = flutuação de canal/configuração); a partir de 2026-10, dados segundo o canal de spot do mercado continental ( ¥110-130 milhões/rack ); o critério de referência dos canais no exterior (faixa de US$ 3,4 M) e o spot na China continental são dois mercados paralelos, sem conversão entre si. América do Norte/Europa/Singapura/Japão/Oriente Médio acumulados diariamente conforme retratos de mercado (US$ 3,444–4,229 milhões · 25 registros, etc., desde 08/10/2026, todos nas moedas originais, sem conversão). O GB300 não consta na lista de aprovações para a China, e as cotações na China continental situam-se no contexto dos canais no exterior e zonas de livre comércio (critério de reportagens públicas, sem constituir parecer jurídico). Levantamento de preços desta base: Bolsa de Cálculo AIXX (intermediação sem comissão, não participa de transações, não conhece nem especula preços de fechamento, daí a neutralidade dos dados). O preço real está sujeito à cotação do vendedor.
Marcos históricos de preço MILESTONES
Perguntas frequentes FAQ
Rack supernó Blackwell Ultra anunciado pela NVIDIA na GTC de março de 2025: 72 GPUs Blackwell Ultra + 36 CPUs Grace em um único rack refrigerado a líquido, totalmente interconectados via NVLink5 com 130 TB/s agregados, apresentando-se ao software como um único acelerador. Especificação oficial de FP4 Tensor Core: 1.440 PFLOPS (dense), com 20 TB de HBM3e somados nas GPUs.
Veja sala de servidores e escala: o NVL72 exige alimentação na faixa de 132 kW, refrigeração a líquido com CDU e adaptações de carga no piso, em troca de 20 TB de memória em um único domínio NVLink — formato para treinamento em larga escala e fábricas de inferência; o NVL8 tem 288 GB por placa e 2,3 TB por sistema, implantável em etapas em salas existentes. Com orçamento para adaptação da sala, vá de NVL72; sem ele, comece pelo NVL8 (ambos os formatos circulam nesta base, veja a faixa de mercado).
O GB300 está sujeito ao controle de exportações dos EUA e não consta na lista aprovada para a China (dados públicos de 2026-10; o aprovado para entrada em volume na China em julho de 2026 foi o H200); a circulação no spot ocorre principalmente via canais no exterior e zonas de livre comércio. Esta informação baseia-se em reportagens públicas e não constitui parecer jurídico; antes de adquirir, consulte as políticas dos órgãos competentes e assessoria especializada em compliance.
Critério da página oficial da NVIDIA: 20 TB de HBM3e (288 GB/placa × 72 = 20,7 TB, consistente com o cálculo; o catálogo de certificação da Red Hat traz a mesma cifra); materiais iniciais de canal trazem a cifra de 18 TB (ainda presente em parte das strings de config em circulação nesta base). Prevalece a cifra oficial de 20 TB, contra a qual cotações e contratos devem ser conferidos; a aceitação baseia-se em medições do relatório de firmware ao nível de bandeja.
Não vale — o nível rack segue outro regime de aceitação: autoteste na energização (confirmação uma a uma das 18+9 bandejas), calibração do resfriamento a líquido (vazão/ΔT/detecção de vazamento no CDU sem alarmes), consumo do conjunto (alinhado na faixa de 132-142 kW em carga máxima), teste completo de interconexão NCCL (all_reduce das 72 placas contra o nominal do NVLink5) e contagem de eventos RAS (sem ECC não corrigido nem interrupções). A verificação dos números de série bandeja a bandeja é a menor unidade de confiança da inspeção de rack (veja «Como aceitar»).
Entradas relacionadas SEE ALSO
Comparação e escolha de modelos COMPARE
Referências REFERENCES
- Site oficial da NVIDIA — página do produto GB300 NVL72 (arquivo principal de especificações, verificado em 2026-10) https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- NVIDIA — Enterprise Reference Architecture NVL72 AI Factory: componentes do sistema (bandejas/alimentação/refrigeração a líquido, verificado em 2026-10) https://docs.nvidia.com/enterprise-reference-architectures/n…
- Sala de imprensa da NVIDIA — NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning (release de 2025-03-18: 1,5×/2º sem. 2025/16 parceiros/CX-8 800G) https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Supermicro — página oficial do SRS-GB300-NVL72 (132 kW / CDU 250 kW / dimensões) https://www.supermicro.com/en/products/rack/srs-gb300-nvl72
- Catálogo de certificação Red Hat — GB300 NVL72 (1,1 ExaFLOPS / 20,7 TB HBM3e, segundo o catálogo de parceiros) https://catalog.redhat.com/en/hardware/system/detail/307917
- Blog oficial da NVIDIA — estreia do Vera Rubin NVL72 no MLPerf, Qwen3-VL até 3,7× sobre o GB300 (2026-09-16) https://blogs.nvidia.com
- MLCommons — resultados do MLPerf Inference v6.1 (estreia do GB300 NVL72, até 2,5× em MoE, 2026-09-17) https://mlcommons.org
- CoreWeave — GA das instâncias em nuvem GB300 NVL72 (changelog de 2025-08-19) e «First to deploy» no relatório trimestral do 3T 2025 https://docs.coreweave.com
- Forbes — GB200 NVL72 a cerca de $3 milhões por rack (2025-12-23, âncora de preço da geração anterior) https://www.forbes.com
- CNBC / EUA — controles de exportação para a China e novas regras BIS de 2026-01 (segundo reportagens públicas) https://www.cnbc.com
- Pegatron NVIDIA GB300 NVL72 and More at NVIDIA GTC 2025 (fotos reais da bandeja de computação) https://www.servethehome.com/pegatron-nvidia-gb300-nvl72-and…
- Supermicro NVIDIA B300 e tour pela AI Factory (fotos reais do rack GB300 NVL72 da Supermicro) https://www.servethehome.com/checking-out-the-supermicro-nvi…
- Dados da faixa de mercado — AIXX Exchange (intervalos de cotações em circulação e de canais conhecidos desta plataforma, atualização diária) /hall.html