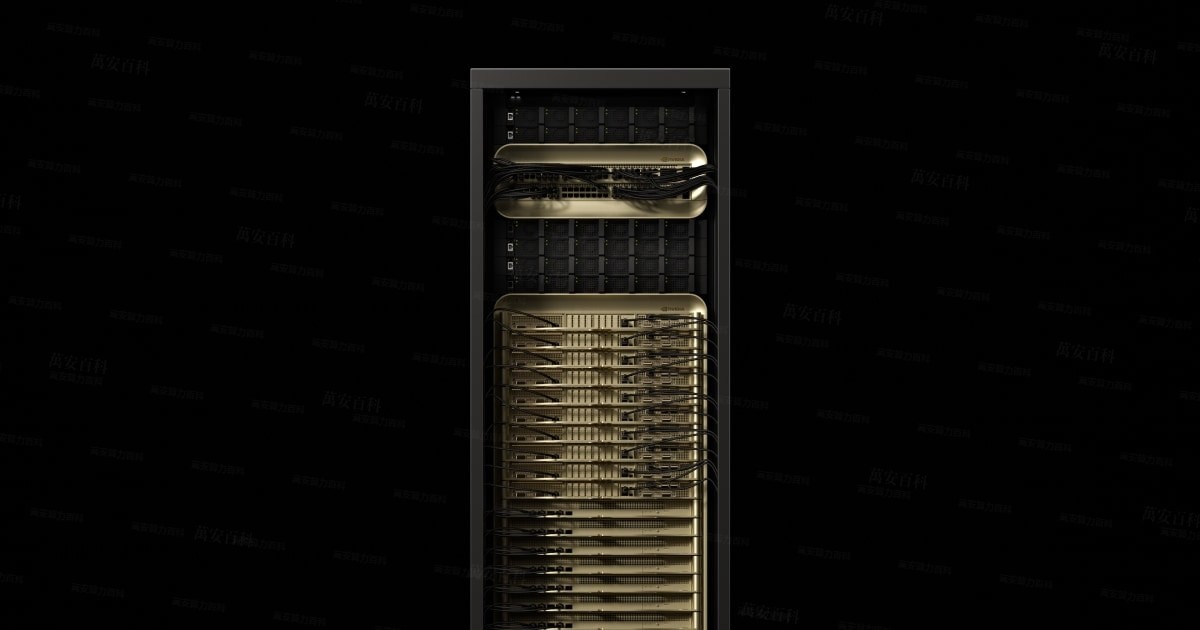
GB300 NVL72
概要OVERVIEW
GB300 NVL72(正式名称 NVIDIA GB300 NVL72、Blackwell Ultra プラットフォームのフラッグシップ形態)は NVIDIA が 2025 年 3 月 18 日GTC で発表したラックレベルのスーパーノード: 72基の Blackwell Ultra GPU と 36基の Grace CPU を1台の完全液冷ラックに収め、第5世代 NVLink フルインターコネクトで合計130TB/s——ラック全体がソフトウェアからは1基のアクセラレータ[1][3]。
に見える。会話でいう「NVL72」の文字通り、NはNVLinkドメイン、72は1ドメイン内のGPU数。公式見解では前世代 GB200 NVL72 比 1.5倍FP4 Tensor Core 公式ページの2列表記 1,440 | 10,802 PFLOPS(2026年10月時点の公式ページ検証、2列の数値は公式脚注の条件に準拠)、GPU 合計 20TB 相当のメモリ 20TB HBM3e、電力 132kW クラス——ラック全体での納品を意味し、購入前にそれを収められる機械室が先に必要になる[1][2][3]。
2026年の現貨市場で、GB300 NVL72 は大規模トレーニング・推論ファクトリーの艦隊旗艦:2025年8月に CoreWeave が真っ先にパブリッククラウドへ搭載し、2026年9月の MLPerf Inference v6.1 でデビューし公開スコアを提示、同ラウンドで次世代の Vera Rubin NVL72 も公開された(GB300 比で最大 3.7×、公開情報[6])——フラッグシップの座は待ってくれないが、導入ハードルとシステム一式の価格も同じオーダーで存在する(「冷却と導入」および「相場帯」参照)。
適用シーンFIT
AIXX Index(0–100):本データベースは公開スペックからの加重推定——ラックメモリ規模 40% + インターコネクト 30% + エコシステム 30%、ユースケース別に重みを調整、ラックレベルの推定基準(単体GPU項目の基準とは相互比較不可)。90+ フラッグシップ級 · 75+ 優秀 · 60+ 実用 · 60未満は不適用。手法は透明で検証可能だが、性能の保証にはならない。
沿革HISTORY
2025 年 3 月 18 日GTC 基調講演で Blackwell Ultra プラットフォームを発表:公式見解では GB300 NVL72 は GB200 NVL72 比 1.5 倍の高速化、Cisco / Dell / HPE / Lenovo / Supermicro など16社のパートナーが同年後半からラック全体の納品を開始、GPU あたり ConnectX-8 SuperNIC 800Gb/s を装備[3]。
2025年7〜9月、初期システムが稼働:CoreWeave が7月に最初の GB300 NVL72 到着を発表、8月19日に世界初の GB300 NVL72 クラウドインスタンスが商用開始(Dell が納品)、同社第3四半期決算は「First to deploy NVIDIA GB300 NVL72 systems」として記録;Quanta は9月から出荷[8]。
2026年9月、MLPerf Inference v6.1:GB300 NVL72 が MLPerf デビューを果たし、MoE ベンチマークで前世代比最高 2.5倍の向上;同ラウンドで次世代 Vera Rubin NVL72 もデビュー、Qwen3-VL のインタラクティブ用途で GB300 比最高 3.7倍GB300 比で(NVIDIA 公式ブログの見解)——公開ベンチマークで「現役フラッグシップ vs 後継者」が初めて同じ舞台に並んだ[6][7]。
中国市場向け見解(中立的):GB300 は米国輸出規制の対象であり、対中承認リストには含まれていない(2026年10月時点の公開情報;米側は最先端チップの対中許可について「推定拒否」方針を維持、2026年1月の BIS 新規則の枠組みを踏襲);2026年7月に対中輸出が承認・拡大したのは H200 で、GB300 クラスは未承認——現物流通は海外および自由貿易区ルートが中心。当ライブラリは公開報道の見解を記録するのみで、法的助言を構成しない[10]。
技術仕様SPECIFICATIONS
| 項目 | スペック(GB300 NVL72 ラックレベル · 公式見解) |
|---|---|
| 構成 | 72× Blackwell Ultra GPU + 36× Grace CPU(2,592× Arm Neoverse V2 コア) |
| FP4 Tensor Core | 1,440 PFLOPS(dense)/ 10,802 PFLOPS(スパース)——発表報道とパートナーカタログには「1.1 EFLOPS 級 FP4 推論」との記載も |
| FP8 / FP6 Tensor Core | 720 PFLOPS |
| FP16 / BF16 · TF32 | 360 / 180 PFLOPS |
| FP64 | 100 TFLOPS |
| GPUメモリ合計 | 20TB HBM3e(288GB/GPU × 72 = 20.7TB、推算基準)、帯域最大576TB/s |
| CPUメモリ合計 | 17TB LPDDR5X(帯域14TB/s);高速メモリ合計37TB |
| GPU間インターコネクト | NVLink 第5世代 · 合計130TB/s(GPUあたり1.8TB/s)+ 9× NVSwitch トレイでフルインターコネクト |
| ラック構造 | 18× コンピュートトレイ(各トレイに GPU 4基 + Grace 2基)+ 9× NVSwitch トレイ + 8× 33kW 電源シェルフ |
| 冷却 | 完全液冷(fully liquid-cooled);ラック内 CDU 250kW 級;トレイレベル + ラックレベルの漏液検知 |
| 電源 | 132kW 構成レベル(8× 33kW 電源シェルフ);NVIDIA リファレンスアーキテクチャでフルロード時最大142kW |
| 外部ネットワーク | GPUあたり800Gb/s(ConnectX-8 SuperNIC ×4/トレイ)+ BlueField-3 DPU;Quantum-X800 InfiniBand / Spectrum-X Ethernet で拡張 |
| 前世代 / 次世代 | GB200 NVL72(1.5倍高速化の差)/ Vera Rubin NVL72(2026-09 デビュー) |
スペックは NVIDIA 公開資料に準拠[1][2];FP4 dense は公式スペックページの非スパース条件、1.1 EFLOPS は発表/パートナーカタログの条件で、両条件を併記し各出典を注記;Tensor 演算性能は特記なき場合スパース込みの条件;ラック構成は OEM やロットにより差異がある。
単一 Compute Tray の分解基準PER TRAY
| 項目 | 1つのコンピュートトレイ(×18) |
|---|---|
| GPU | 4× Blackwell Ultra(合計1,152GB HBM3e) |
| CPU | 2× Grace(72コア ×2、合計1TB LPDDR5X) |
| ラック内ネットワーク | 4× ConnectX-8(各800Gb/s)+ 1× BlueField-3 DPU |
| インターコネクト界面 | 背面の NVLink ケーブルカートリッジ(cable cartridge)を NVSwitch トレイに盲挿接続;液冷接口は盲挿でラック manifold に接続 |
| 運用上の意味 | コンピュートトレイは個別に引き抜いて保守可能——トレイ単位のシリアル番号とファームウェア報告が検品の最小単位(「調達と検品」を参照) |
トレイ単位の数値は NVIDIA リファレンスアーキテクチャ文書による[2]。
世代比較 · 両世代 NVL72 を同時に見るGENERATIONS
| 項目 | GB200 NVL72 | GB300 NVL72 |
|---|---|---|
| GPU | 72× Blackwell | 72× Blackwell Ultra |
| 単体メモリ | 192GB HBM3e | 288GB HBM3e |
| GPUメモリ合計 | 13.8TB(推算基準) | 20.7TB(推算基準;公式ページは20TB) |
| 公式相対性能 | ベンチマーク | 1.5× AI performance(プレスリリースの見解) |
| ネットワーク | ConnectX-7 400G | ConnectX-8 800G |
GB200 は公開見解として参考掲載、詳細は NVIDIA 公式資料を参照;両世代とも完全液冷、36× Grace アーキテクチャ。
ファミリー構成FAMILY
GB300 ファミリーはフォームファクタにより4系列に分かれ、当ライブラリの流通は GB300 NVL72 ラック一式と DGX GB300 が主力(大陸市場で言う B300 NVL8 空冷システムは B300 の項目を参照):
冷却と導入COOLING & DEPLOYMENT
GB300 NVL72 液冷という1形態のみ:コンピュートトレイと NVSwitch トレイはすべてコールドプレート液冷、液冷界面はトレイ背面の盲挿コネクタでラック manifold に接続、ラック内 CDU 250kW 級(Supermicro の見解、電源冗長)が二次側ループを駆動;NVIDIA リファレンスアーキテクチャはトレイレベル + ラックレベルの2段漏液検知[2][4]を要求。導入は「サーバーを1台買う」ことではなく、1件の機室エンジニアリングプロジェクト:


モデルとクラスタ適合性MODEL & CLUSTER FIT
| モデル / シナリオ | メモリ必要量(FP8 概算) | GB300 NVL72 の導入例(1ラック20.7TB 推算基準) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 フルスペック(671B)多レプリカ推論 | 約690GB / レプリカ | 1ラックに20以上のレプリカを同一搭載可能(重みの推算基準、KV cache を除く)——高並行推論ファクトリーの自信 | 96 |
| 数兆パラメータ級 MoE トレーニング | 重み+オプティマイザ状態でTB級 | 72GPUの NVLink ドメイン内でテンソル/エキスパート並列、勾配はラック外に出ない;複数ラックは800Gで拡張 | 95 |
| 長コンテキスト(百万トークン級) | KV cache はコンテキストに比例して膨張 | 20TB のプール型メモリが KV に十分な余裕を確保し、1ラックで大規模同時長コンテキスト処理に対応 | 92 |
| 7B-14B クラス小型モデルのバッチ推論向けライン | 約 8-30GB / インスタンス | 動作はするが「牛刀で鶏を割る」状態——この種の用途には B300 NVL8 / H200 のほうが割に合う(経済性の観点) | 58 |
メモリ容量は FP8 重み ≈ パラメータ数 × 1 バイトで概算(推定ベース、KV cache とアクティベーションの余裕は含まず);AIXX Index は当ライブラリのラック級推定基準であり、実測に応じて更新。クラスタ拡張構成(DGX SuperPOD / 複数ラック InfiniBand 接続)は NVIDIA のリファレンスデザインに準拠。
ギャラリーGALLERY


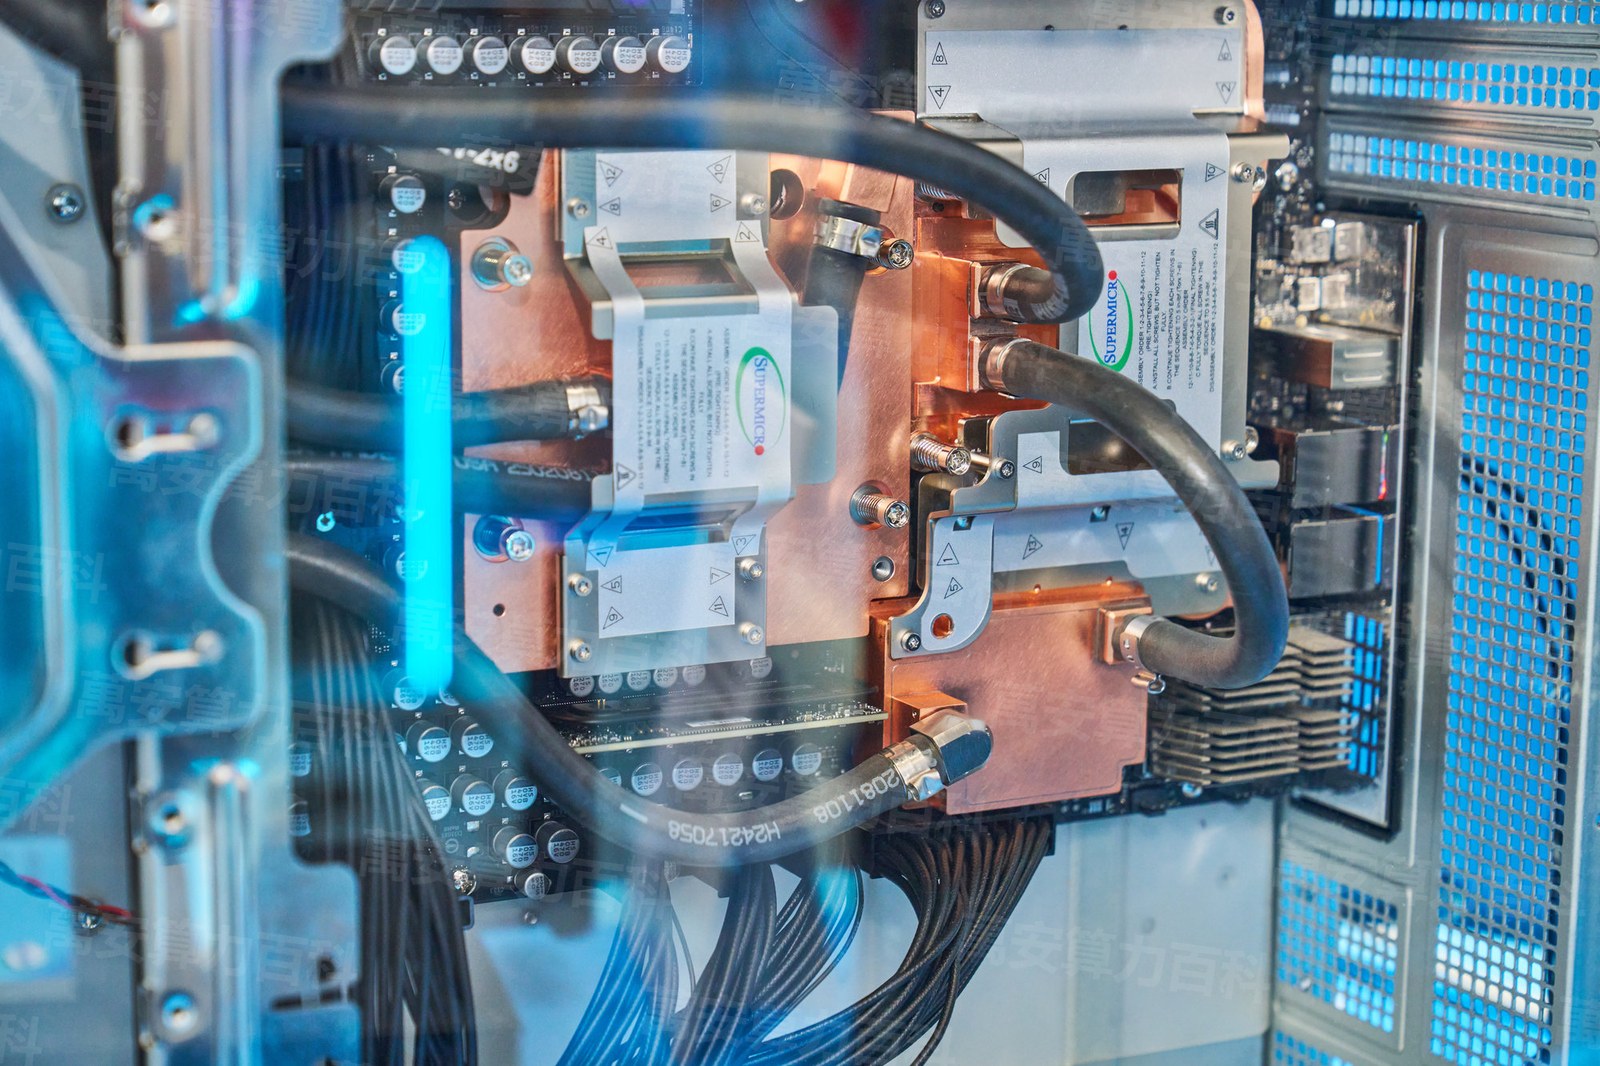
実写画像は検品ロットごとに順次追加予定;公式レンダリング画像は実写と偽らず、AI 生成画像も実写と偽らない。
動画解説VIDEO
本動画は GB300 NVL72 専用のラック級導入視点(ラック搬入 → 給電 → 液冷 → ネットワーク → 通電検収)で、パラメータと判定基準はすべて GB300 NVL72 の実機に基づく。ナレーションとシーンテキストのアーカイブはリポジトリ _wiki_work_1006/gen_tts_gb300.py を参照。
コミュニティ実機 · 出典 YouTubeCOMMUNITY HANDS-ON
地域によっては直接再生できない場合があります
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| CUDA / ドライバー | B300 と同世代・同スタック:Blackwell 世代のサポートライン(CUDA 12.8 以降で完全対応)、詳細は B300 の項目と NVIDIA 公式ドキュメントを参照 |
| 集合通信 | NCCL は NVLink5 / NVSwitch フルメッシュにネイティブ最適化——ラック級検収は nccl-tests による全機接続テストを基準とする(「検収方法」参照) |
| クラスタ管理 | NVIDIA Base Command / DGX SuperPOD リファレンスデザイン;サードパーティの Slurm / Kubernetes エコシステムも共通で利用可能(公開情報ベース) |
| 推論エンジン | vLLM / SGLang / TensorRT-LLM いずれも Blackwell Ultra に対応(FP4 パスは本世代の新機能で、各エンジンのリリース状況による) |
| ネットワーク構成 | Quantum-X800 InfiniBand / Spectrum-X Ethernet 800G 光接続(複数ラック拡張) |
| 運用監視 | DCGM / トレイ級アウトオブバンド管理(SN2201 帯域外スイッチ)——RAS イベントカウントはラック検収のハードル基準 |
ソフトウェアスタックのバージョンは時期により変化するため、NVIDIA の公式リリースを基準とすること;エコシステム成熟度の判断は B300 の項目(同世代共通)を参照。
調達と検品PROCUREMENT
GB300 NVL72 購入時の検品ポイント(3 項目、ラック級基準):
ラック級検収の 5 項目判定基準は本項目参照「検収方法」節を参照。
検収の進め方(ラックレベル)RACK ACCEPTANCE
ラック級検収の 5 項目基準(1 枚あたりのストレステストとは別体系で、数値判定はすべて GB300 NVL72 実機に基づく):通電セルフチェック → 液冷キャリブレーション → システム全体消費電力 → NCCL 全機接続テスト → RAS イベントカウント。
本節はラック級検収基準であり、1 枚あたり項目の「ストレステスト方法」6 項目判定とは通用しない;≥85% などの比率ラインは当ライブラリの検収基準(推定)で、最終的には OEM の検収規範を優先。
輸送と納品LOGISTICS
OEM とバリエーションVENDORS
同一の GB300 NVL72 リファレンスアーキテクチャでも、各社のラック一式は納品体制、液冷セットアップ、サービスが異なる——選定はまず違いを確認(当ライブラリの流通は Supermicro / Dell の条件をカバー済み):
| 一体機メーカー | 代表形態 | 差別化ポイント | 向いているケース |
|---|---|---|---|
| Supermicro 超微 | SRS-GB300-NVL72(当ライブラリ流通条件) | 機内 CDU 250kW クラス、8× 33kW 電源シェルフでのラック全体納品、液冷周辺は自社で完結[4] | 現物購入 · 液冷周辺装備ワンストップ |
| Dell Dell | GB300 NVL72 ラック一式(当ライブラリ流通条件;CoreWeave 初回納品先) | グローバルトップクラスのサービスネットワーク、パブリッククラウド大口納品の実績[8] | 越境展開 · サービス重視 |
| NVIDIA 純正 | DGX GB300 / DGX SuperPOD | 公式の一体型納品 + フルスタックソフトウェア(当ライブラリ流通は31件の USD 条件) | 開梱即学習 · 純正サポート重視 |
| Lenovo / HPE / Cisco | GB300 NVL72 ラック全体 | エンタープライズ級のサービスネットワーク(プレスリリースのパートナーリスト条件[3]) | エンタープライズ顧客チャネルでの購入 |
| Wiwynn / Pegatron / Quanta など | ODM ラック全体 / 受託製造 | クラウドベンダーサプライチェーンのバックエンド(CoreWeave 等の納品形態の一つ) | クラウドベンダー大口 · ODM チャネル |
AIXX Index · 導入 4 軸比較(ラック級)AIXX INDEX
| 一体機メーカー | 導入の容易さ | 保守のしやすさ | 性能密度 | 寿命見込み |
|---|---|---|---|---|
| Supermicro 超微 | 72 | 80 | 95 | 82 |
| Dell Dell | 78 | 88 | 95 | 85 |
| NVIDIA 純正 | 82 | 85 | 94 | 85 |
| Lenovo / HPE / Cisco | 76 | 86 | 94 | 84 |
| ODM(Wiwynn/Pegatron/Quanta) | 68 | 72 | 95 | 80 |
AIXX Index は当ライブラリのラック級推定基準(0–100、評価根拠=ラック全体納品形態、液冷周辺装備とサービスネットワークの差異;「設置の容易さ」は空冷 8 GPU 一体型より総じて低く、これはベンダーの弱点ではなくラック級導入の客観的属性)、実機検証に応じて更新し、購入の確約を構成しない。具体的型番はベンダーの公式発表を優先。
用語カードGLOSSARY
NVL72 / スーパーノード
N=NVLink ドメイン、72=ドメイン内 GPU 数。72 基の GPU が NVSwitch でフルメッシュ接続され 1 つの NVLink ドメインを構成し、ソフトウェアには 1 基の「巨大アクセラレータ」として見える——これが「スーパーノード」の意味であり、ラック級製品と 8 GPU 一体型の本質的な違い。
Compute Tray コンピュートトレイ
ラックの最小計算単位:各トレイに 4× Blackwell Ultra(合計 1,152GB HBM3e)+ 2× Grace(合計 1TB LPDDR5X)、全 18 トレイ。トレイは個別に着脱可能——トレイ級シリアル番号とファームウェアレポートがラック検品の最小信頼単位。
NVSwitch Tray スイッチトレイ
9 枚のスイッチトレイが 72 GPU のフルメッシュ接続を担う:コンピュートトレイは背面の NVLink ケーブルカートリッジ(cable cartridge)経由でブラインド挿入によりスイッチトレイと対接し、ノンブロッキング P2P マトリクスを構成——合計 130TB/s の NVLink5 帯域はここから生まれる。
CDU とブラインド挿入液冷
CDU(Coolant Distribution Unit、冷媒分配ユニット)は機内 250kW クラスで、二次側液冷ループを駆動;コンピュートトレイとラックマニホールドの間はブラインド挿入(blind-mate)コネクタ——トレイを押し込むと液路が接続される。トレイ級 + ラック級の二段階漏液検知が標準装備。
Grace CPU
NVIDIA の Arm アーキテクチャ CPU(Neoverse V2、72 コア)、ラックあたり 36 基、トレイあたり 2 基、LPDDR5X メモリ搭載(合計 17TB)。Grace は GPU を「満たす」役割:データ前処理、通信、スケジューリングを担い、GPU↔CPU は NVLink-C2C で接続。
輸出規制とコンプライアンス ロット
GB300 は米国の対中輸出規制対象であり、対中承認リストに含まれない(2026-10 公開基準);現物流通は海外および自由貿易区チャネルが中心。ロットと通関経路は保証と価値維持に影響するため、検品時に必ず確認。当ライブラリの記述はすべて公開報道に基づくもので、法的助言を構成しない。
動向と関連イベントTIMELINE
限界と論点LIMITS
- 導入のハードルはそのもう一面:全液冷 + 132kW 級給電(リファレンスアーキテクチャのフルロード最大 142kW)+ トン級ラック全体の床荷重——既存の空冷機室では基本的に導入不可、機室改修は月単位を要することも;機室改修の予算が足りない場合、B300 NVL8 空冷一体型がより現実的な第一歩(「冷却と導入」参照)。
- 世代間の圧迫はすでに公然化:2026年9月の MLPerf 同一ラウンドで、次世代 Vera Rubin NVL72 がデビュー早々に最大 3.7× で GB300 を上回った(Qwen3-VL、NVIDIA 公式ブログの見解[6])——フラッグシップラックの優位期間は四半期単位であり、調達判断は減価ペースまで織り込む必要がある。
- 対中輸出規制対象(中立的表記):GB300 は対中承認リストに含まれず(2026年10月時点の公開情報)、現物流通は海外および自由貿易区ルートが中心で、通関経路とコンプライアンス状態が保証と資産価値に直結する[10]。当ライブラリは公開報道の見解を記録するのみで、法的助言を構成しない。
- 価格帯と流動性:1ラック数百万米ドル級(前世代 GB200 NVL72 の公開報道では約 $300万/ラック[9])、一括での売り要望条件が中心——単ラックでの転売流通市場は極めて未成熟で、残存価値は機械室環境とメーカー保証の引き継ぎに大きく依存し、転売コストは単体 GPU よりはるかに高い。
- メモリ容量基準の差(18TB vs 20TB):公式ページ条件で 20TB(288GB×72=20.7TB の推算と整合)、チャネル初期資料には 18TB の記載もあった——見積もりと契約は公式の 20TB 条件で照合し、検収はトレイレベルのファームウェアレポート実測に準拠(当ライブラリ流通の config 文字列には依然 18TB の記載が見られ、本項目の条件注記に明記済み)。
- 「1 枚の巨大カード」のもう一面:NVLink ドメインは性能の源泉であると同時にリスクの境界でもある——ドメイン内障害の影響範囲はラック全体に及び、運用にはトレイ級の隔離と迅速なトレイ交換能力が必要(「検収方法」の RAS 項参照)。これは運用チームにとって実質的な能力要件。
相場帯MARKET DATA
| 日付 | 基準 | 地域 | 参考価格帯 | 備考 |
|---|---|---|---|---|
| 2026-10-29 | マーケットリアルタイム | 米国(USD) | $723万 – 918万 | 48件の見積もり ›(ラック全体要価基準) |
| 2026-10 | チャネル参考 | 中国本土 | ¥11,000万 – ¥13,000万 | 大陸現物チャネル把握基準(ラック全体要価基準)· 流通ラック一式 › |
| 2026-10-29 | マーケットリアルタイム | 中東(AED) | AED 4,816万 – 6,264万 | 69件の見積もり(ラック一式の売り要望条件) |
| 2026-10-29 | マーケットリアルタイム | 欧州(EUR) | €998万 – 1,267万 | 60件の見積もり(ラック全体の要価ベース) |
| 2026-10-29 | マーケットリアルタイム | シンガポール(SGD) | S$2,069万 – 2,601万 | 55件の見積もり(ラック一式の売り要望条件) |
| 2026-10-29 | マーケットリアルタイム | 日本(JPY) | JPY 226,101万 – 286,880万 | 49件の見積もり(ラック一式の売り要望条件) |
| 2025-12 | チャネル参考 | グローバル | 前世代 GB200 NVL72 は約 300 万ドル / ラック | 公開報道条件[9]・ GB300 に公式価格設定なし · 流通ラック一式 › |
| 2026-10-29 | 政策ベース | 中国本土 | 対中承認リスト未掲載 | GB300 は米国輸出規制対象であり、現物流通は海外および自由貿易区チャネルが中心(公開報道基準、法的助言を構成しない) |
算定基準:大陸現物チャネル推定帯——2025-08 上市時の参考価格からは推定帯(海外チャネル参考基準 $3.4M/ラック級換算 ≈¥2,450-2,700 万、NVIDIA 公式定価なし;帯域幅=チャネル/構成変動)、2026-10 以降は大陸現物チャネル把握基準(¥1.1億〜1.3億/ラック);海外チャネルの参考条件($3.4M クラス)と大陸の現貨は並行する2つの市場であり、相互に換算しない。北米/欧州/シンガポール/日本/中東は相場スナップショットとして日々蓄積(USD 344.4万–422.9万・25件など、2026年10月8日以降、いずれも現地通貨条件で相互換算なし)。GB300 は対中承認リストに含まれず、大陸の報価は海外および自由貿易区ルートの文脈による(公開報道条件、法的助言を構成しない)。当ライブラリの価格総覧:AIXX 取引所(手数料ゼロのマッチング、取引には関与せず、成交価格も把握・推測しないため、データは中立的)。実際の価格は出品者の提示価格によります。
価格イベント年表MILESTONES
よくある質問FAQ
NVIDIA が 2025 年 3 月の GTC で発表した Blackwell Ultra スーパーノードラック:72 基の Blackwell Ultra GPU と 36 基の Grace CPU を完全液冷ラック 1 台に収め、NVLink5 フルメッシュ接続の合計帯域は 130TB/s、ソフトウェアからは 1 基のアクセラレータとして見える。FP4 Tensor Core の公式スペックは 1,440 PFLOPS(dense ベース)、GPU メモリ合計は 20TB の HBM3e。
機械室と規模で見る:NVL72 は 132kW クラスの給電、CDU 液冷、耐重改修が必要だが、その見返りに 20TB のメモリを1つの NVLink ドメインとして実現し、大規模学習と推論ファブリックの形態となる;NVL8 は1枚288GB、システム全体で2.3TB で、既存機械室に段階的に導入可能。機械室改修の予算があれば NVL72、なければ NVL8 から始めるのが妥当(当ライブラリには両形態が流通しており、相場帯を参照)。
GB300 は米国の輸出規制対象であり、中国市場向け承認リストに含まれていない(2026-10 公開情報、2026 年 7 月に承認され中国供給が拡大したのは H200);現貨の流通は主に海外および自由貿易区チャネルによる。本項は公開報道ベースであり、法的助言を構成しない。調達前に主管当局の方針と専門のコンプライアンス意見を確認すること。
NVIDIA 公式ページ条件で 20TB HBM3e(288GB/枚 × 72 = 20.7TB、推算と整合;Red Hat 認証カタログも同条件);チャネル初期資料には 18TB の記載もあった(当ライブラリの一部流通 config 文字列に残る)。公式の 20TB を正とし、見積もりと契約はこれに基づき照合、検収はトレイレベルのファームウェアレポート実測に準拠。
有効ではない——ラック単位では別の検収体系が適用される:通電自己診断(18+9 トレイが逐一応答を報告)、液冷較正(CDU 流量/温度差/漏液検知の警報ゼロ)、システム消費電力(フルロード 132-142kW 級との整合)、NCCL 全機接続テスト(72 枚 all_reduce が NVLink5 の公称値に対して)、RAS イベントカウント(未訂正 ECC や割り込みなし)。トレイ単位のシリアル番号照合がラック検品の最小信頼単位(「検収方法」参照)。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- NVIDIA 公式サイト — GB300 NVL72 製品ページ(スペック主資料、2026-10 検証) https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- NVIDIA — エンタープライズリファレンスアーキテクチャ NVL72 AI Factory:システム構成要素(トレイ/給電/液冷の表記、2026-10 検証) https://docs.nvidia.com/enterprise-reference-architectures/n…
- NVIDIA ニュースルーム — NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning(2025-03-18 発表:1.5×/2025 年下半期/16 社パートナー/CX-8 800G) https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Supermicro — SRS-GB300-NVL72 公式ページ(132kW / CDU 250kW / 寸法) https://www.supermicro.com/en/products/rack/srs-gb300-nvl72
- Red Hat 認証カタログ — GB300 NVL72(1.1 ExaFLOPS / 20.7TB HBM3e パートナーカタログ表記) https://catalog.redhat.com/en/hardware/system/detail/307917
- NVIDIA 公式ブログ — Vera Rubin NVL72 の MLPerf 初参戦、Qwen3-VL は GB300 比最大 3.7×(2026-09-16) https://blogs.nvidia.com
- MLCommons — MLPerf Inference v6.1 結果(GB300 NVL72 初参戦、MoE 最大 2.5×、2026-09-17) https://mlcommons.org
- CoreWeave — GB300 NVL72 クラウドインスタンス GA(2025-08-19 changelog)および 2025 年 Q3 四半期報告「First to deploy」 https://docs.coreweave.com
- Forbes — GB200 NVL72 1 ラック約 $300 万(2025-12-23、前世代の価格アンカー) https://www.forbes.com
- CNBC / 米国 — 対中輸出規制と 2026-01 BIS 新規則(公開報道ベース) https://www.cnbc.com
- Pegatron NVIDIA GB300 NVL72 and More at NVIDIA GTC 2025(コンピュートトレイ実写) https://www.servethehome.com/pegatron-nvidia-gb300-nvl72-and…
- Supermicro NVIDIA B300 と AI Factory 概観(Supermicro GB300 NVL72 ラック実写) https://www.servethehome.com/checking-out-the-supermicro-nvi…
- 相場帯データ — AIXX 取引所(当プラットフォームの流通見積もりとチャネル把握レンジ、毎日更新) /hall.html