AIXX Pedia › Fiche modèle › GB300 NVL72
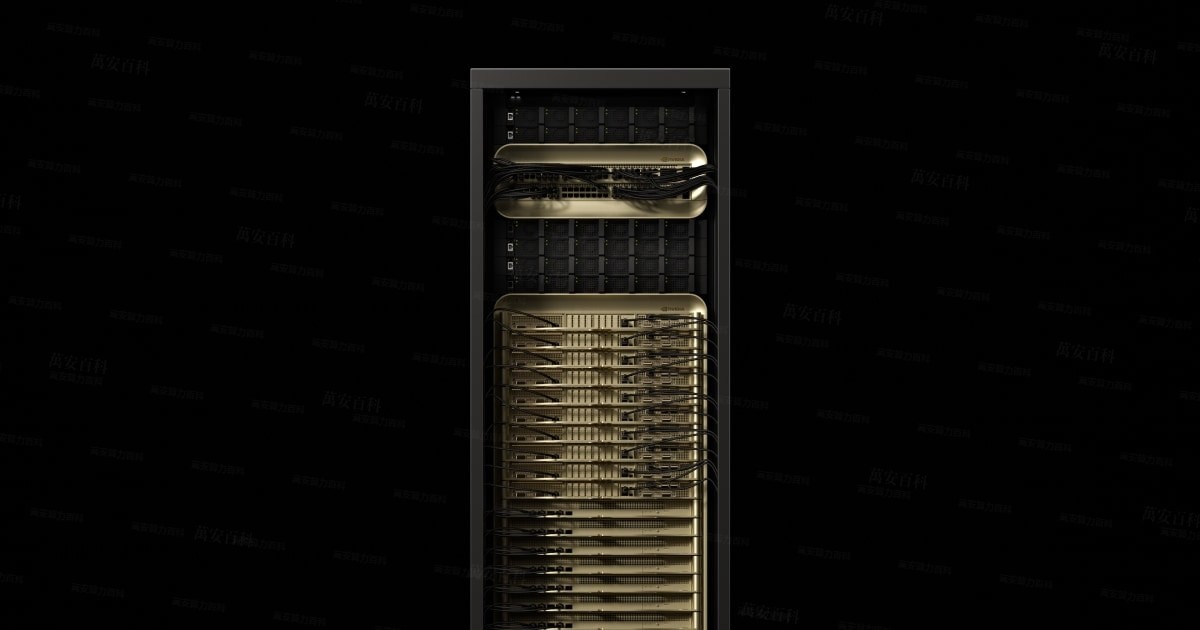
GB300 NVL72
Vue d'ensemble OVERVIEW
GB300 NVL72 (nom complet NVIDIA GB300 NVL72, forme phare de la plateforme Blackwell Ultra) est un Le 18 mars 2025 rack supernœud publié par NVIDIA au GTC : il intègre 72 GPU Blackwell Ultra et 36 CPU Grace dans un rack entièrement refroidi par liquide, avec une interconnexion NVLink de cinquième génération totalisant 130 TB/s — aux yeux du logiciel, tout le rack se comporte comme un seul accélérateur[1][3]。
C'est le support des trois lettres « NVL72 » : N = domaine NVLink, 72 = nombre de GPU dans un domaine. Selon les chiffres officiels, il offre un gain de 1,5× par rapport au GB200 NVL72 de génération précédente ; la page officielle liste en double colonne les Tensor Core FP4 1,440 | 10,802 PFLOPS (vérification de la page officielle en 2026-10 ; les deux colonnes font référence aux notes de bas de page officielles) et la mémoire GPU totale 20TB HBM3e , avec une alimentation de l'ordre de 132 kW — une livraison au niveau rack implique de disposer d'une salle capable de l'accueillir avant l'achat[1][2][3].
Sur le marché du spot en 2026, le GB300 NVL72 est le navire amiral des flottes d'entraînement à grande échelle et d'usines d'inférence : en août 2025, CoreWeave fut le premier à le déployer sur cloud public ; en septembre 2026, ses débuts dans MLPerf Inference v6.1 ont fourni des résultats publics, et lors de la même session, le prochain Vera Rubin NVL72 s'est déjà dévoilé (jusqu'à 3,7× vs GB300, chiffres publics[6]) — la place de flagship n'attend personne, mais le seuil de déploiement et le prix de l'ensemble sont d'un autre ordre de grandeur (voir « Refroidissement et déploiement » et « Fourchettes de prix »).
Cas d'usage FIT
AIXX Index (0–100) : cette base l'estime par pondération des spécifications publiques — mémoire du rack 40 % + interconnexion 30 % + écosystème 30 %, avec pondérations ajustées par scénario, estimation au niveau rack (non comparable aux fiches mono-GPU). 90+ flagship · 75+ Excellent · 60+ utilisable · en dessous de 60 non pertinent. Méthode transparente et vérifiable, ne constitue pas une promesse de performance.
Historique HISTORY
Le 18 mars 2025 , keynote du GTC présentant la plateforme Blackwell Ultra : selon les chiffres officiels, le GB300 NVL72 offre 1,5× de gain sur le GB200 NVL72 ; Cisco / Dell / HPE / Lenovo / Supermicro et 16 partenaires au total livrent des racks complets à partir du second semestre de l'année, chaque GPU étant doté d'un ConnectX-8 SuperNIC 800 Gb/s[3].
Juillet–septembre 2025 , premières mises en service : CoreWeave annonce en juillet l'arrivée des premiers GB300 NVL72, le 19 août, la première instance cloud GB300 NVL72 au monde entre en service commercial (livraison Dell), consignée dans son rapport trimestriel sous « First to deploy NVIDIA GB300 NVL72 systems » ; Quanta expédie à partir de septembre[8].
Septembre 2026 , MLPerf Inference v6.1 : le GB300 NVL72 fait ses débuts dans MLPerf, avec jusqu'à 2,5× sur les benchmarks MoE vs génération précédente ; lors de la même session, le successeur Vera Rubin NVL72 débute aussi, jusqu'à 3,7× vs GB300 sur les scénarios interactifs Qwen3-VL (chiffres du blog officiel NVIDIA) — première fois qu'un benchmark public voit cohabiter « flagship en exercice vs successeur »[6][7].
Volet Chine (neutre) : le GB300 relève des contrôles à l'export américains et ne figure pas sur la liste des licences approuvées vers la Chine (chiffres publics en 2026-10 ; Washington maintient une politique de « présomption de refus » pour les licences de puces de pointe vers la Chine, cadre prolongé par la nouvelle réglementation BIS de janvier 2026) ; en juillet 2026, c'est le H200 qui a été approuvé en volume vers la Chine, pas les produits de classe GB300 — la circulation en spot passe donc essentiellement par des canaux étrangers et zones franches. Cette base ne consigne que les informations publiques et ne constitue pas un avis juridique[10].
Spécifications techniques SPECIFICATIONS
| Élément | Spécifications (GB300 NVL72 niveau rack · chiffres officiels) |
|---|---|
| Config | 72× GPU Blackwell Ultra + 36× CPU Grace (2 592 cœurs Arm Neoverse V2) |
| FP4 Tensor Core | 1 440 PFLOPS (dense) / 10 802 PFLOPS (creux) — les annonces et catalogues partenaires mentionnent aussi « 1,1 EFLOPS d'inférence FP4 » |
| FP8 / FP6 Tensor Core | 720 PFLOPS |
| FP16 / BF16 · TF32 | 360 / 180 PFLOPS |
| FP64 | 100 TFLOPS |
| Mémoire GPU totale | 20TB HBM3e (288 Go/carte × 72 = 20,7 To, estimation), bande passante jusqu'à 576 To/s |
| Mémoire CPU totale | 17 To LPDDR5X (bande passante 14 To/s) ; mémoire rapide totale 37 To |
| Interconnexion GPU-GPU | NVLink cinquième génération · 130 To/s au total (1,8 To/s par GPU) + 9 plateaux NVSwitch tout interconnectés |
| Structure du rack | 18× plateaux de calcul (4 GPU + 2 Grace chacun) + 9× plateaux NVSwitch + 8× étagères d'alimentation 33 kW |
| Refroidissement | Tout refroidi par liquide (fully liquid-cooled) ; CDU interne ~250 kW ; détection de fuite aux niveaux plateau et rack |
| Alimentation | 132 kW au niveau configuration (8× étagères 33 kW) ; jusqu'à 142 kW en pleine charge selon l'architecture de référence NVIDIA |
| Réseau externe | 800 Gb/s par GPU (ConnectX-8 SuperNIC ×4/plateau) + BlueField-3 DPU ; extension Quantum-X800 InfiniBand / Spectrum-X Ethernet |
| Génération précédente / suivante | GB200 NVL72 (écart de 1,5×) / Vera Rubin NVL72 (début 2026-09) |
Spécifications selon les données publiques officielles NVIDIA[1][2] ; FP4 dense selon la page de spécifications officielle sans chiffre creux, 1,1 EFLOPS selon les annonces/catalogues partenaires, les deux niveaux coexistant avec leurs sources ; la puissance Tensor est comptée avec creux sauf mention contraire ; la configuration du rack varie selon l'OEM et le lot.
Décomposition par Compute Tray PER TRAY
| Élément | Un plateau de calcul (×18) |
|---|---|
| GPU | 4× Blackwell Ultra (1 152 Go HBM3e au total) |
| CPU | 2× Grace (72 cœurs ×2, 1 To LPDDR5X au total) |
| Réseau interne | 4× ConnectX-8 (800 Gb/s chacun) + 1× BlueField-3 DPU |
| Interface d'interconnexion | Cartouche de câbles NVLink à l'arrière (cable cartridge) se branchant en aveugle sur le plateau NVSwitch ; interfaces liquide en blind-mate sur le manifold du rack |
| Implication opérationnelle | Les plateaux de calcul sont extractibles individuellement — le numéro de série et le firmware au niveau plateau constituent l'unité minimale de contrôle à réception (voir « Achat et réception ») |
Chiffres par plateau issus de la documentation d'architecture de référence NVIDIA[2].
Comparatif générationnel · deux générations de NVL72 côte à côte GENERATIONS
| Élément | GB200 NVL72 | GB300 NVL72 |
|---|---|---|
| GPU | 72× Blackwell | 72× Blackwell Ultra |
| Mémoire par carte | 192GB HBM3e | 288GB HBM3e |
| Mémoire GPU totale | 13,8 To (estimation) | 20,7 To (estimation ; page officielle : 20 To) |
| Performance relative officielle | Référence | 1,5× AI performance (chiffres du communiqué) |
| Réseau | ConnectX-7 400G | ConnectX-8 800G |
Le GB200 est cité comme repère public, voir la documentation officielle NVIDIA ; les deux générations sont refroidies par liquide, architecture 36× Grace.
Membres de la famille FAMILY
La famille GB300 se décline en quatre formes ; la circulation dans cette base est dominée par le rack complet GB300 NVL72 et le DGX GB300 (le B300 NVL8 refroidi par air du contexte continental voit la fiche B300) :
Refroidissement et déploiement COOLING & DEPLOYMENT
GB300 NVL72 Une seule forme : le refroidissement par liquide : plateaux de calcul et plateaux NVSwitch sont tous en refroidissement liquide à plaque froide ; l'interface liquide se fait à l'arrière des plateaux via des raccords en blind-mate sur le manifold du rack ; le CDU interne ~250 kW (chiffres Supermicro, alimentation redondante) pilote le circuit secondaire ; l'architecture de référence NVIDIA exige une détection de fuite à deux niveaux, plateau et rack[2][4]. Le déployer n'est pas « acheter un serveur », mais un véritable projet d'ingénierie de salle :


Modèle et adéquation cluster MODEL & CLUSTER FIT
| Modèle / scénario | Besoin mémoire (estimation FP8) | Déploiement GB300 NVL72 (20,7 To par rack, estimation) | AIXX Index |
|---|---|---|---|
| Inférence multi-réplicas DeepSeek R1 complet (671B) | Environ 690 Go / réplica | 20+ réplicas co-hébergés par rack (estimation en poids, hors KV cache) — la force des usines d'inférence à haute concurrence | 96 |
| Entraînement MoE à l'échelle du billion de paramètres | Poids + états d'optimiseur : ordre du To | Parallélisme tenseur/experts dans le domaine NVLink des 72 GPU, gradients qui ne sortent pas du rack ; extension multi-racks via 800G | 95 |
| Longs contextes (échelle du million de tokens) | Le KV cache croît linéairement avec le contexte | Les 20 To de mémoire mutualisée laissent une large marge au KV cache ; un seul rack suffit pour un long contexte massivement concurrent | 92 |
| Chaînes de production de petits modèles 7B-14B | Environ 8-30 Go / instance | Fonctionne, mais c'est « tuer une mouche avec un marteau » — pour ces chaînes, B300 NVL8 / H200 est plus rentable (critère économique) | 58 |
La mémoire vidéo est estimée avec des poids FP8 ≈ nombre de paramètres × 1 octet (méthode d'estimation, hors KV cache et marge d'activation) ; l'AIXX Index est une estimation au niveau baie de ce répertoire, mise à jour au fil des mesures. Pour les topologies d'extension en cluster (DGX SuperPOD / interconnexion InfiniBand multi-baies), se référer aux architectures de référence NVIDIA.
Galerie GALLERY
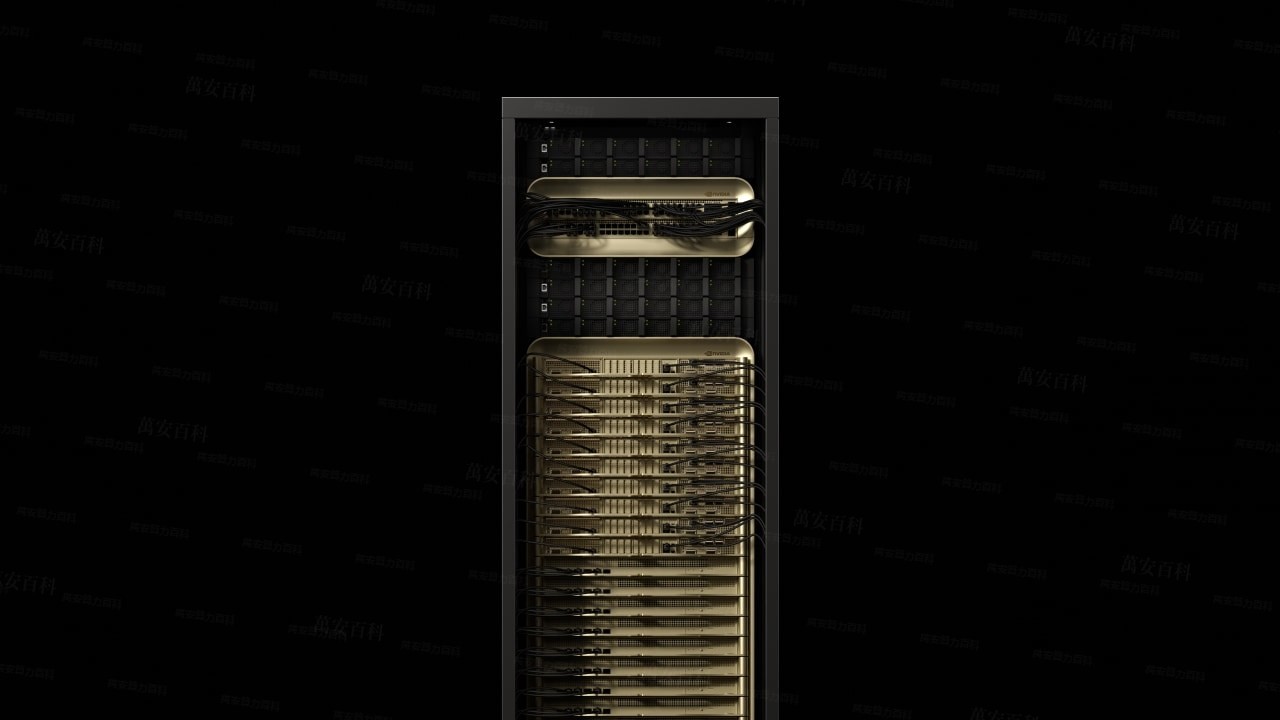


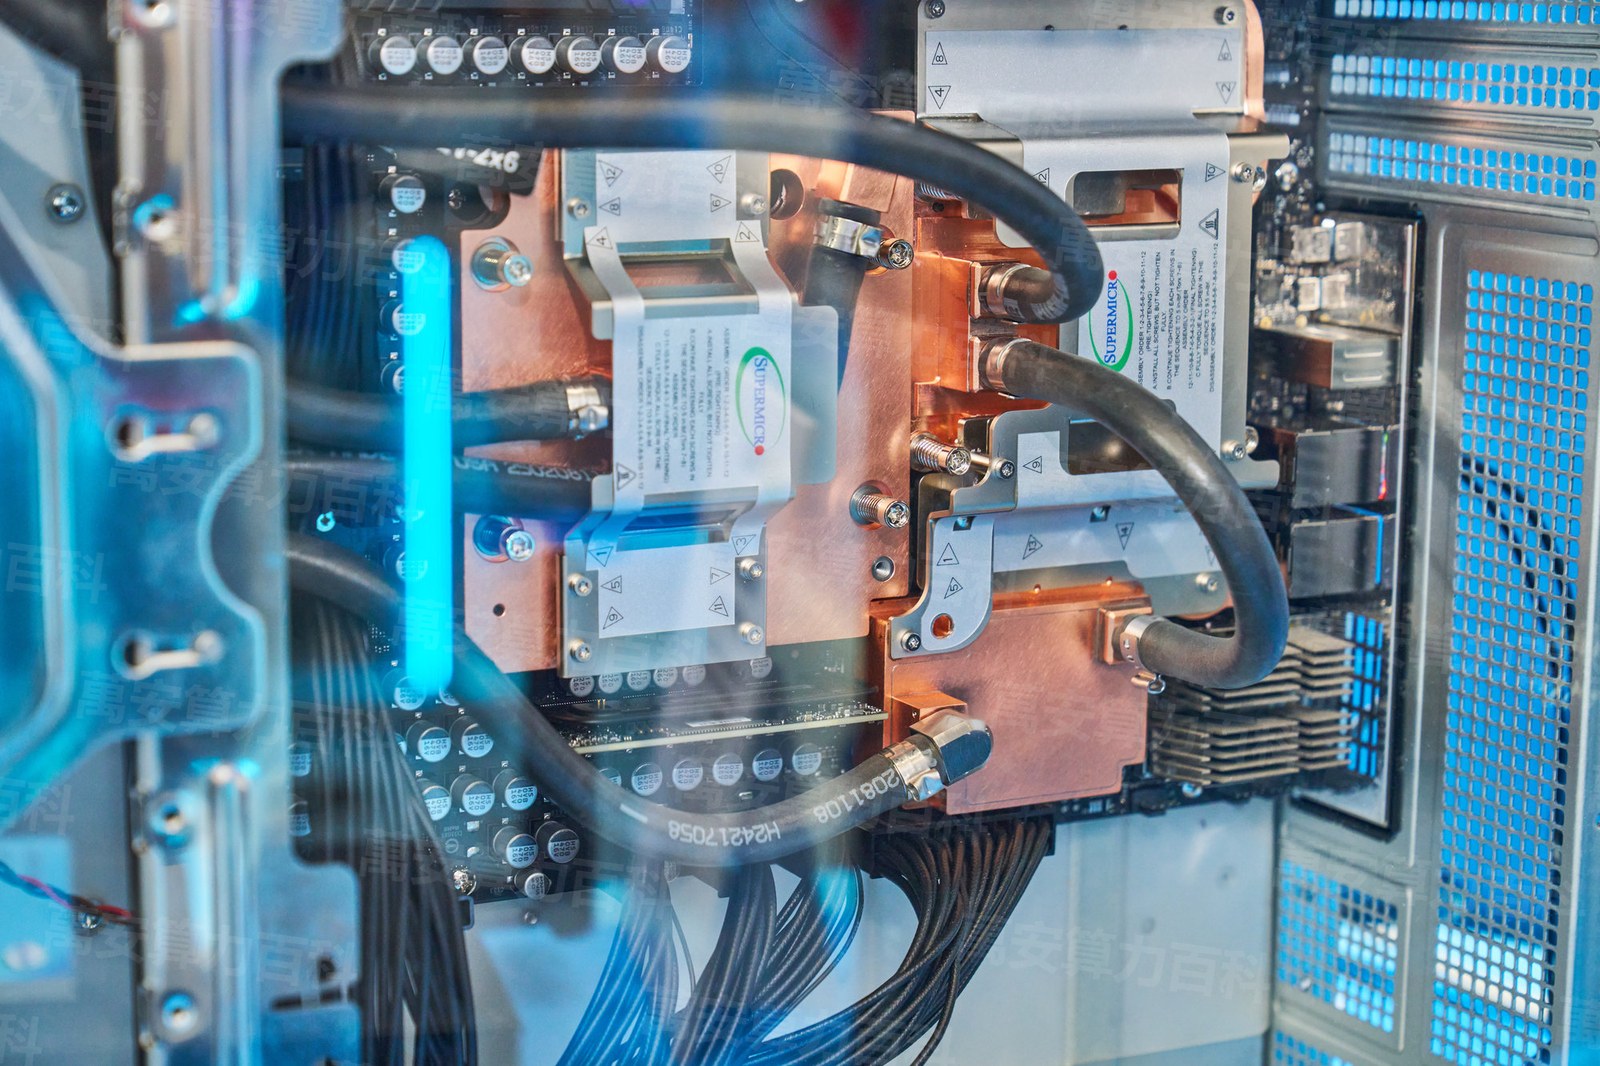
Les photos réelles sont enrichies au fil des lots d'inspection ; les rendus officiels ne sont pas présentés comme des photos réelles, les images générées par IA non plus.
Présentation vidéo VIDEO
Cette vidéo adopte une perspective de déploiement au niveau baie, exclusive au GB300 NVL72 (mise en place de la baie → alimentation → refroidissement liquide → réseau → mise sous tension et validation) ; les paramètres et cas de validation sont ancrés sur le GB300 NVL72 réel, la narration et les textes de scène sont archivés dans _wiki_work_1006/gen_tts_gb300.py du dépôt.
Machine réelle de la communauté · Source YouTube COMMUNITY HANDS-ON
La lecture directe peut être indisponible dans certaines régions
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| CUDA / pilotes | Même génération et même pile logicielle que le B300 : la ligne de support de la génération Blackwell (support complet à partir de CUDA 12.8), voir la fiche B300 et la documentation officielle NVIDIA |
| Communications collectives | Optimisation native de NCCL pour l'interconnexion complète NVLink5 / NVSwitch — la validation au niveau baie repose sur un test complet nccl-tests de toute la machine (voir « Comment valider ») |
| Gestion de cluster | NVIDIA Base Command / architectures de référence DGX SuperPOD ; écosystème Slurm / Kubernetes tiers universel (périmètre public) |
| Moteurs d'inférence | vLLM / SGLang / TensorRT-LLM prennent tous en charge Blackwell Ultra (le chemin FP4 étant une nouveauté de génération, se référer aux publications de chaque moteur) |
| Infrastructure réseau | Quantum-X800 InfiniBand / Spectrum-X Ethernet interconnexion optique 800G (extension multi-baies) |
| Supervision d'exploitation | DCGM / gestion hors bande au niveau plateau (commutateur hors bande SN2201) — le comptage des événements RAS est un critère dur de validation de baie |
Les versions de la pile logicielle évoluent avec le temps, se référer aux publications officielles NVIDIA ; pour l'évaluation de la maturité de l'écosystème, voir la fiche B300 (génération partagée).
Achat et réception PROCUREMENT
Points d'inspection à l'achat d'une baie GB300 NVL72 (trois points, périmètre baie) :
Voir la fiche pour les cinq cas de validation au niveau baie « Comment réceptionner » de cette entrée.
Comment réceptionner (niveau rack) RACK ACCEPTANCE
Cinq critères de validation au niveau baie (système distinct des tests de charge par carte, tous les seuils ancrés sur le GB300 NVL72 réel) : autotest à la mise sous tension → calibrage du refroidissement liquide → consommation de la baie complète → test NCCL de toute la machine → comptage des événements RAS.
Cette section relève du périmètre de validation au niveau baie, non transposable aux six critères de test « Comment tester » des fiches par carte ; le seuil proportionnel ≥85 % est le critère de validation de ce répertoire (extrapolé), les spécifications de validation OEM prévalent en dernier ressort.
Transport et livraison LOGISTICS
OEM et variantes VENDORS
Même architecture de référence GB300 NVL72, les baies des différents acteurs se distinguent par la livraison, l'écosystème de refroidissement liquide et les services — comparer les différences avant de choisir (la circulation de ce répertoire couvre déjà les périmètres Supermicro / Dell) :
| Intégrateur | Format représentatif | Points de différenciation | Pour qui ? |
|---|---|---|---|
| Supermicro | SRS-GB300-NVL72 (périmètre de circulation de ce répertoire) | CDU interne classe 250 kW, 8× étagères d'alimentation 33 kW en livraison baie complète, écosystème de refroidissement liquide intégré verticalement[4] | Achat sur stock · refroidissement liquide clé en main |
| Dell | Baie complète GB300 NVL72 (périmètre de circulation de ce répertoire ; premier livreur CoreWeave) | Réseau de services mondial de premier plan, expérience des grandes commandes cloud publiques[8] | Déploiement multinational · priorité au service |
| NVIDIA officiel | DGX GB300 / DGX SuperPOD | Livraison intégrée officielle + pile logicielle complète (31 références en circulation dans ce répertoire, en USD) | Entraînement prêt à l'emploi · support constructeur |
| Lenovo / HPE / Cisco | Baie complète GB300 NVL72 | Réseau de services de niveau entreprise (périmètre de la liste de partenaires des communiqués[3]) | Achat via canaux grands comptes |
| Wiwynn / Pegatron / Quanta, etc. | Baie complète ODM / sous-traitance | Arrière-boutique des chaînes d'approvisionnement des fournisseurs cloud (l'une des formes de livraison de CoreWeave, etc.) | Grandes commandes cloud · canal ODM |
AIXX Index · comparaison à quatre dimensions du déploiement (niveau baie) AIXX INDEX
| Intégrateur | Facilité d'installation | Facilité de maintenance | Densité de performance | Durée de vie attendue |
|---|---|---|---|---|
| Supermicro | 72 | 80 | 95 | 82 |
| Dell | 78 | 88 | 95 | 85 |
| NVIDIA officiel | 82 | 85 | 94 | 85 |
| Lenovo / HPE / Cisco | 76 | 86 | 94 | 84 |
| ODM (Wiwynn/Pegatron/Quanta) | 68 | 72 | 95 | 80 |
L'AIXX Index est une estimation au niveau baie de ce répertoire (0–100, critères = forme de livraison de la baie complète, écosystème de refroidissement liquide et différences de réseau de services ; « facilité d'installation » généralement inférieure aux machines 8 cartes refroidies par air, attribut objectif du déploiement au niveau baie et non faiblesse du fabricant), mis à jour au fil des vérifications sur machine réelle, sans engagement d'achat. Les modèles concrets prévalent selon les publications officielles des fabricants.
Fiches terminologie GLOSSARY
NVL72 / supernœud
N = domaine NVLink, 72 = nombre de GPU dans le domaine. 72 GPU interconnectés intégralement via NVSwitch forment un seul domaine NVLink, présenté au logiciel comme un « accélérateur géant » unique — c'est le sens de « supernœud », et la différence fondamentale entre produit au niveau baie et machine 8 cartes.
Compute Tray : plateau de calcul
L'unité de calcul minimale de la baie : chaque plateau 4× Blackwell Ultra (1 152 Go de HBM3e au total) + 2× Grace (1 To de LPDDR5X au total), 18 plateaux en tout. Les plateaux sont extractibles individuellement — les numéros de série et rapports de firmware au niveau plateau sont la plus petite unité fiable de l'inspection de baie.
NVSwitch Tray : plateau de commutation
9 plateaux de commutation portent l'interconnexion complète des 72 GPU : les plateaux de calcul se raccordent aux plateaux de commutation par insertion aveugle via les cartouches de câbles NVLink à l'arrière, formant une matrice P2P non bloquante — d'où les 130 To/s de bande passante NVLink5 au total.
CDU et refroidissement liquide à insertion aveugle
La CDU (Coolant Distribution Unit, unité de distribution de liquide de refroidissement), classe 250 kW en baie, pilote le circuit de refroidissement secondaire ; entre les plateaux de calcul et le manifold de la baie se trouvent des connecteurs à insertion aveugle (blind-mate) — le plateau se branche hydrauliquement dès son insertion. La détection de fuite à deux niveaux (plateau + baie) est de série.
Grace CPU
CPU Arm de NVIDIA (Neoverse V2, 72 cœurs), 36 par baie, 2 par plateau, avec mémoire LPDDR5X (17 To au total). Grace a pour mission de « nourrir » les GPU : prétraitement des données, communications et ordonnancement, interconnexion GPU↔CPU via NVLink-C2C.
Contrôle des exportations et lots de conformité
Le GB300 relève du contrôle américain des exportations vers la Chine et ne figure pas sur la liste des modèles approuvés pour le marché chinois (périmètre public d'octobre 2026) ; la circulation sur stock passe principalement par les canaux à l'étranger et en zones franches. Lots et chemin de dédouanement impactent garantie et conservation de valeur, à vérifier impérativement à l'inspection. Les formulations de ce répertoire suivent les informations publiées, sans constituer un avis juridique.
Actualités et événements liés TIMELINE
Limites et controverses LIMITS
- La barrière au déploiement est son autre visage : tout refroidi par liquide + alimentation de classe 132 kW (jusqu'à 142 kW en Pleine charge selon l'architecture de référence) + charge au sol d'une tonne par baie — les salles informatiques refroidies par air existantes sont quasiment exclues, et la rénovation d'une salle se compte souvent en mois ; pour les budgets ne couvrant pas la rénovation, la machine refroidie par air B300 NVL8 est une première étape plus réaliste (voir « Refroidissement et déploiement »).
- L'écrasement générationnel est devenu public : en septembre 2026, lors d'une même session MLPerf, le Vera Rubin NVL72 de prochaine génération a dominé le GB300 dès ses débuts avec jusqu'à 3,7× (Qwen3-VL, périmètre du blog officiel NVIDIA[6]) — la fenêtre d'avance d'une baie flagship se compte en trimestres, la décision d'achat doit intégrer le rythme d'amortissement.
- Modèle soumis au contrôle des exportations vers la Chine (formulation neutre) : le GB300 ne figure pas sur la liste des modèles approuvés pour le marché chinois (périmètre public d'octobre 2026), la circulation sur stock passe principalement par les canaux à l'étranger et en zones franches, le chemin de dédouanement et le statut de conformité impactent directement garantie et conservation de valeur[10]. Ce répertoire se limite aux informations publiées, sans constituer un avis juridique.
- Volume de prix et liquidité : plusieurs millions de dollars par baie (pour la génération précédente, le GB200 NVL72 était rapporté publiquement à environ 3 M$/baie[9]), avec une dominante d'offres par lot — le marché de la revente à la baie unitaire est très immature, la valeur résiduelle dépend fortement des conditions de la salle informatique et de la continuité de la garantie constructeur, les coûts de revente dépassent largement ceux d'une carte.
- Écart de périmètre sur la capacité mémoire (18 To vs 20 To) : la page officielle indique 20 To (288 Go × 72 = 20,7 To, cohérent par extrapolation), des documents de canal anciens mentionnent 18 To — vérifier devis et contrat sur le périmètre officiel de 20 To, la validation reposant sur les mesures des rapports de firmware au niveau plateau (la chaîne config en circulation dans ce répertoire mentionne encore 18 To, noté dans les remarques de périmètre de la fiche).
- L'autre face d'« une seule grosse carte » : le domaine NVLink est à la fois sa source de performance et sa frontière de risque — une défaillance dans le domaine impacte toute la baie, l'exploitation exige une capacité d'isolation au niveau plateau et de remplacement rapide de plateau (voir l'entrée RAS de « Comment valider »), une exigence bien réelle pour l'équipe d'exploitation.
Encadré marché MARKET DATA
| Date | Périmètre | Région | Fourchette de prix de référence | Remarque |
|---|---|---|---|---|
| 2026-10-30 | Temps réel marketplace | États-Unis (USD) | 72,3 M$ – 91,8 M$ | 48 offres › (offres à la baie complète) |
| 2026-10 | Référence canal | Chine continentale | 110 M¥ – 130 M¥ | Périmètre du marché de stock en Chine continentale (offres à la baie complète) · Baies en circulation › |
| 2026-10-30 | Temps réel marketplace | Moyen-Orient (AED) | 48,16 M AED – 62,64 M AED | 70 offres (offres à la baie complète) |
| 2026-10-30 | Temps réel marketplace | Europe (EUR) | 9,98 M€ – 12,67 M€ | 60 offres (offres à la baie complète) |
| 2026-10-30 | Temps réel marketplace | Singapour (SGD) | 20,69 M S$ – 26,01 M S$ | 55 offres (offres à la baie complète) |
| 2026-10-30 | Temps réel marketplace | Japon (JPY) | 2 261,01 M JPY – 2 868,80 M JPY | 49 offres (offres à la baie complète) |
| 2025-12 | Référence canal | Monde | Génération précédente GB200 NVL72 : environ 3 M$ / baie | Périmètre des informations publiées[9] · aucun prix officiel pour le GB300 · Baies en circulation › |
| 2026-10-30 | Statut réglementaire | Chine continentale | Non approuvé pour le marché chinois | Le GB300 relève du contrôle américain des exportations, la circulation sur stock passe principalement par les canaux à l'étranger et en zones franches (périmètre des informations publiées, sans constituer un avis juridique) |
Périmètre : Fourchette extrapolée du marché de stock en Chine continentale — à partir du prix de lancement d'août 2025, fourchette extrapolée (référence des canaux étrangers à l'échelle 3,4 M$/baie convertie ≈ 24,5-27 M¥, sans prix officiel NVIDIA ; la fourchette = fluctuations de canal/configuration), et depuis octobre 2026, périmètre du marché de stock en Chine continentale ( 110-130 M¥/baie ) ; la référence des canaux étrangers (échelle 3,4 M$) et le stock en Chine continentale sont deux marchés parallèles, sans conversion mutuelle. Amérique du Nord / Europe / Singapour / Japon / Moyen-Orient : accumulation quotidienne par instantanés de marché (3,444-4,229 M USD · 25 références, etc., depuis le 8 octobre 2026, toutes en monnaies d'origine, sans conversion mutuelle). Le GB300 n'est pas approuvé pour le marché chinois, les cotations en Chine continentale relèvent du contexte des canaux étrangers et de zones franches (périmètre des informations publiées, sans constituer un avis juridique). Inventaire des prix de ce répertoire : AIXX Exchange (Mise en relation sans commission, sans participation aux transactions, sans connaissance ni spéculation sur les prix de transaction, d'où la neutralité des données). Le prix réel est soumis au devis du vendeur.
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Rack supernœud Blackwell Ultra dévoilé par NVIDIA au GTC de mars 2025 : 72 GPU Blackwell Ultra + 36 CPU Grace intégrés dans un rack entièrement refroidi par liquide, interconnexion complète NVLink5 totalisant 130 To/s, présenté au logiciel comme un seul accélérateur. FP4 Tensor Core : 1 440 PFLOPS en spécification officielle (dense), avec 20 To de HBM3e de mémoire GPU au total.
Tout dépend de la salle et de l'échelle : le NVL72 exige une alimentation de classe 132 kW, un refroidissement liquide via CDU et des travaux de renforcement au sol, en échange de 20 To de mémoire dans un seul domaine NVLink — la forme idéale pour l'entraînement à grande échelle et les usines d'inférence ; le NVL8 offre 288 Go par carte, 2,3 To par serveur, pour un déploiement progressif dans des salles existantes. Avec un budget de refonte de salle, visez le NVL72 ; sinon, démarrez avec le NVL8 (les deux formes circulent dans cette base, voir la fourchette de marché).
Le GB300 relève des contrôles à l'exportation américains et ne figure pas sur la liste d'approbation pour la Chine (selon les informations publiques d'octobre 2026 ; c'est le H200 qui a été approuvé pour une entrée massive en juillet 2026) ; le marché spot passe essentiellement par des canaux à l'étranger et en zones franches. Cette information provient de rapports publics et ne constitue pas un avis juridique ; avant tout achat, référez-vous aux politiques des autorités compétentes et à un avis professionnel de conformité.
La page officielle NVIDIA indique 20 To de HBM3e (288 Go/carte × 72 = 20,7 To, cohérent avec l'estimation ; le catalogue de certification Red Hat indique la même chose) ; certains documents de canal anciens mentionnent 18 To (encore visible dans certaines chaînes de config en circulation dans cette base). Retenez la valeur officielle de 20 To, vérifiez les devis et contrats sur cette base, et validez la réception par les mesures réelles des rapports firmware au niveau des tray.
Non — au niveau rack, c'est un autre protocole de réception : autotest à la mise sous tension (18+9 tray déclarés un par un), étalonnage du refroidissement liquide (débit/écart de température/détection de fuite du CDU, zéro alerte), consommation du système complet (alignée sur 132-142 kW en pleine charge), tests NCCL de l'ensemble (all_reduce 72 cartes conforme au NVLink5 annoncé), compteurs d'événements RAS (aucune ECC non corrigée ni interruption). La vérification des numéros de série tray par tray constitue l'unité minimale de confiance pour la réception d'un rack (voir « Comment réceptionner »).
Fiches liées SEE ALSO
Comparaison et choix de machines COMPARE
Références REFERENCES
- Site officiel NVIDIA — page produit GB300 NVL72 (spécifications de référence, vérifié en octobre 2026) https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- NVIDIA — Architecture de référence entreprise NVL72 AI Factory : composants système (tray/alimentation/refroidissement liquide, vérifié en octobre 2026) https://docs.nvidia.com/enterprise-reference-architectures/n…
- Salle de presse NVIDIA — NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning (communiqué du 18/03/2025 : 1,5×/S2 2025/16 partenaires/CX-8 800G) https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Supermicro — page officielle SRS-GB300-NVL72 (132 kW / CDU 250 kW / dimensions) https://www.supermicro.com/en/products/rack/srs-gb300-nvl72
- Catalogue de certification Red Hat — GB300 NVL72 (1,1 ExaFLOPS / 20,7 To HBM3e, selon le catalogue partenaire) https://catalog.redhat.com/en/hardware/system/detail/307917
- Blog officiel NVIDIA — Première MLPerf du Vera Rubin NVL72, Qwen3-VL jusqu'à 3,7× vs GB300 (16/09/2026) https://blogs.nvidia.com
- MLCommons — Résultats MLPerf Inference v6.1 (première du GB300 NVL72, jusqu'à 2,5× sur MoE, 17/09/2026) https://mlcommons.org
- CoreWeave — GA des instances cloud GB300 NVL72 (changelog du 19/08/2025) et rapport trimestriel T3 2025 « First to deploy » https://docs.coreweave.com
- Forbes — environ 3 millions $ par rack GB200 NVL72 (23/12/2025, ancre de prix génération précédente) https://www.forbes.com
- CNBC / États-Unis — Contrôles à l'exportation vers la Chine et nouvelles règles BIS de janvier 2026 (selon les rapports publics) https://www.cnbc.com
- Pegatron NVIDIA GB300 NVL72 and More at NVIDIA GTC 2025 (photos du tray de calcul) https://www.servethehome.com/pegatron-nvidia-gb300-nvl72-and…
- Supermicro NVIDIA B300 et visite de l'AI Factory (photos du rack GB300 NVL72 Supermicro) https://www.servethehome.com/checking-out-the-supermicro-nvi…
- Données de fourchette de marché — AIXX Exchange (offres en circulation sur cette plateforme et fourchettes selon le canal, mise à jour quotidienne) /hall.html