AIXX Pedia › Ficha de modelo › GB300 NVL72
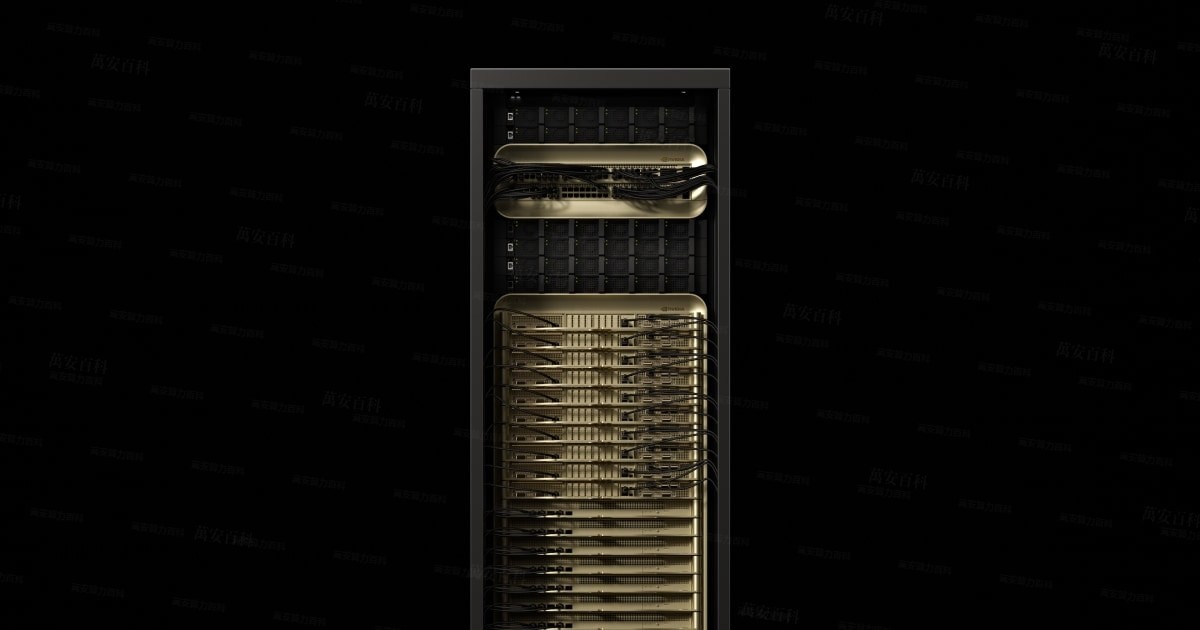
GB300 NVL72
Resumen OVERVIEW
GB300 NVL72 (nombre completo NVIDIA GB300 NVL72, la forma insignia de la plataforma Blackwell Ultra) es un supernodo a nivel de bastido presentado por NVIDIA el 18 de marzo de 2025 en GTC: integra 72 GPU Blackwell Ultra y 36 CPU Grace en un bastido íntegramente refrigerado por líquido, con la interconexión NVLink de quinta generación que suma 130 TB/s: ante el software, todo el bastido es un único acelerador[1][3]。
Es el vehículo de las tres letras «NVL72» del nombre: N = dominio NVLink, 72 = número de GPU por dominio. Según cifras oficiales, es 1,5 veces FP4 Tensor Core, doble columna en la página oficial 1,440 | 10,802 PFLOPS (verificado en la página oficial de octubre de 2026; ambas columnas se rigen por las notas al pie oficiales), suma de memoria de GPU 20TB HBM3e y alimentación de nivel 132 kW — la entrega a nivel de rack implica que, antes de comprarlo, hay que disponer de una sala de equipos capaz de albergarlo[1][2][3].
En el mercado de stock de 2026, el GB300 NVL72 es el buque insignia de las flotas de entrenamiento a gran escala y fábricas de inferencia : en agosto de 2025, CoreWeave fue la primera en llevarlo a la nube pública; en septiembre de 2026 debutó en MLPerf Inference v6.1 con resultados públicos, y en la misma ronda ya se presentó el sucesor Vera Rubin NVL72 (hasta 3.7× frente al GB300, según cifras públicas[6]) — el trono de buque insignia no espera a nadie, pero el umbral de despliegue y el precio del sistema completo son igualmente de otro orden (véase «Refrigeración y despliegue» y la «Banda de mercado»).
Casos de uso FIT
AIXX Index (0–100): estimación ponderada de esta base según especificaciones públicas: memoria del bastido 40 % + interconexión 30 % + ecosistema 30 %, con pesos ajustados por escenario, bajo criterio de estimación a nivel de bastido (no comparable con el criterio de fichas de GPU individual). 90+ nivel insignia · 75+ Excelente · 60+ utilizable · por debajo de 60 no aplicable. Metodología transparente y verificable; no constituye una promesa de rendimiento.
Historia HISTORY
supernodo a nivel de bastido : en el keynote del GTC se presentó la plataforma Blackwell Ultra: según cifras oficiales, GB300 NVL72 es 1,5 veces más rápido que GB200 NVL72; Cisco / Dell / HPE / Lenovo / Supermicro y otros 16 socios entregarían racks completos a partir del segundo semestre del mismo año, cada GPU con un ConnectX-8 SuperNIC de 800 Gb/s[3].
Julio-septiembre de 2025 , primeros sistemas en producción: CoreWeave anunció en julio la llegada de sus primeros GB300 NVL72, y el 19 de agosto puso en producción comercial la primera instancia cloud de GB300 NVL72 del mundo (entregado por Dell), su informe trimestral quedó registrado con el lema «First to deploy NVIDIA GB300 NVL72 systems»; Quanta comenzó los envíos en septiembre[8].
Septiembre de 2026 , MLPerf Inference v6.1: el GB300 NVL72 debuta en MLPerf, con hasta 2,5 veces de mejora en benchmarks MoE frente a la generación anterior; en la misma ronda debutó también el sucesor Vera Rubin NVL72, con hasta 3,7 veces frente al GB300 (según el blog oficial de NVIDIA) — la primera vez que «buque insignia vigente vs. sucesor» compiten en benchmarks públicos[6][7].
Situación para el mercado chino (neutra) : el GB300 está sujeto al control de exportaciones de EE. UU. y no figura en la lista aprobada para China (cifras públicas de octubre de 2026; EE. UU. mantiene una política de «rechazo presunto» para licencias de chips de máxima gama hacia China, marco continuado por la nueva normativa BIS de enero de 2026); en julio de 2026 se aprobó la entrada masiva del H200, mientras que el nivel GB300 no obtuvo aprobación — la circulación en el mercado secundario se concentra en canales extranjeros y zonas francas. Esta biblioteca solo recoge cifras de informes públicos y no constituye asesoría legal[10].
Especificaciones técnicas SPECIFICATIONS
| Concepto | Especificaciones (GB300 NVL72 a nivel de bastido · cifras oficiales) |
|---|---|
| Configuración | 72× GPU Blackwell Ultra + 36× CPU Grace (2.592 núcleos Arm Neoverse V2) |
| FP4 Tensor Core | 1.440 PFLOPS (denso) / 10.802 PFLOPS (con sparsity); los informes de lanzamiento y catálogos de partners citan además «1,1 EFLOPS de inferencia FP4» |
| FP8 / FP6 Tensor Core | 720 PFLOPS |
| FP16 / BF16 · TF32 | 360 / 180 PFLOPS |
| FP64 | 100 TFLOPS |
| Memoria total de GPU | 20TB HBM3e (288 GB por GPU × 72 = 20,7 TB, criterio estimado), con hasta 576 TB/s de ancho de banda |
| Memoria total de CPU | 17 TB LPDDR5X (14 TB/s de ancho de banda); 37 TB de memoria rápida en total |
| Interconexión GPU-GPU | NVLink de quinta generación · 130 TB/s en total (1,8 TB/s por GPU) + 9 bandejas NVSwitch totalmente interconectadas |
| Estructura del bastido | 18× bandejas de cómputo (4 GPU + 2 Grace por bandeja) + 9× bandejas NVSwitch + 8× bastidores de alimentación de 33 kW |
| Refrigeración | Totalmente refrigerado por líquido (fully liquid-cooled); CDU interno de nivel 250 kW; detección de fugas a nivel de bandeja y de bastido |
| Alimentación | Configuración de 132 kW (8× bastidores de 33 kW); hasta 142 kW en plena carga según la arquitectura de referencia de NVIDIA |
| Red externa | 800 Gb/s por GPU (ConnectX-8 SuperNIC ×4 por bandeja) + BlueField-3 DPU; escalado vía Quantum-X800 InfiniBand / Spectrum-X Ethernet |
| Generación anterior / siguiente | GB200 NVL72 (diferencia de 1,5×) / Vera Rubin NVL72 (debut en 09/2026) |
Las especificaciones se rigen por los materiales públicos oficiales de NVIDIA[1][2]; el FP4 dense corresponde a la página de especificaciones oficial sin sparse, los 1.1 EFLOPS corresponden a la presentación/catálogo de socios; ambas cifras coexisten con su fuente anotada; salvo indicación contraria, el cómputo Tensor incluye sparse; la configuración del rack varía según OEM y lote.
Desglose de una bandeja de cómputo PER TRAY
| Concepto | Bandeja de cómputo individual (×18) |
|---|---|
| GPU | 4× Blackwell Ultra (1.152 GB de HBM3e en total) |
| CPU | 2× Grace (72 núcleos ×2, 1 TB de LPDDR5X en total) |
| Red interna | 4× ConnectX-8 (800 Gb/s cada uno) + 1× BlueField-3 DPU |
| Interfaz de interconexión | Cartucho de cables NVLink trasero (cable cartridge) con conexión ciega a la bandeja NVSwitch; acoples de refrigeración líquida de conexión ciega al manifold del bastido |
| Implicación operativa | Las bandejas de cómputo pueden extraerse y sustituirse individualmente: el número de serie y el firmware a nivel de bandeja son la unidad mínima de verificación (véase «Compra y validación») |
La cifra a nivel de bandeja procede del documento de arquitectura de referencia de NVIDIA[2].
Comparativa generacional · dos generaciones de NVL72 de un vistazo GENERATIONS
| Concepto | GB200 NVL72 | GB300 NVL72 |
|---|---|---|
| GPU | 72× Blackwell | 72× Blackwell Ultra |
| Memoria por tarjeta | 192GB HBM3e | 288GB HBM3e |
| Memoria total de GPU | 13,8 TB (criterio estimado) | 20,7 TB (criterio estimado; página oficial: 20 TB) |
| Rendimiento relativo oficial | Benchmark | 1,5× de rendimiento de IA (cifra del comunicado de prensa) |
| Red | ConnectX-7 400G | ConnectX-8 800G |
El GB200 se incluye como referencia pública; véanse los materiales oficiales de NVIDIA. Ambas generaciones son totalmente refrigeradas por líquido y con arquitectura de 36× Grace.
Miembros de la familia FAMILY
La familia GB300 se divide en cuatro variantes según formato; la circulación en esta biblioteca se concentra en el rack completo GB300 NVL72 y el DGX GB300 (para el sistema B300 NVL8 refrigerado por aire, habitual en el contexto continental, véase la entrada B300):
Refrigeración y despliegue COOLING & DEPLOYMENT
GB300 NVL72 Solo existe en formato de refrigeración líquida : las bandejas de cómputo y las NVSwitch son íntegramente de refrigeración líquida por placa fría, con la interfaz de líquido en la parte trasera de la bandeja mediante acoples de conexión ciega al manifold del bastido; el CDU interno de nivel 250 kW (cifra de Supermicro, con alimentación redundante) impulsa el circuito secundario; la arquitectura de referencia de NVIDIA exige detección de fugas en dos niveles: bandeja y bastido[2][4]. Desplegarlo no es «comprar un servidor», sino un proyecto de ingeniería de sala de datos :


Modelo y adaptación a clústeres MODEL & CLUSTER FIT
| Modelo / escenario | Necesidad de memoria (estimación FP8) | Despliegue del GB300 NVL72 (20,7 TB por bastido, criterio estimado) | AIXX Index |
|---|---|---|---|
| Inferencia multi-réplica de DeepSeek R1 completo (671B) | ≈ 690 GB por réplica | Más de 20 réplicas en coexistencia por bastido (estimación por pesos, sin incluir la KV cache): la base de una fábrica de inferencia de alta concurrencia | 96 |
| Entrenamiento MoE a escala de billones de parámetros | Pesos + estados del optimizador en escala de TB | Paralelismo tensorial/experto dentro del dominio NVLink de 72 GPU, los gradientes no salen del bastido; escalado multi-bastido vía 800G | 95 |
| Contextos largos (a escala de millones de tokens) | La KV cache crece linealmente con el contexto | 20TB de memoria agrupada dejan margen suficiente para la KV cache; un solo rack soporta grandes cargas de contexto largo concurrente | 92 |
| Líneas de producción por lotes con modelos pequeños de 7B-14B | Aprox. 8-30GB / instancia | Funciona, pero es «matar moscas a cañonazos»: para este tipo de cargas, B300 NVL8 / H200 resulta más rentable (criterio de economía) | 58 |
Memoria estimada según pesos FP8 ≈ nº de parámetros × 1 byte (criterio de estimación, sin incluir KV cache ni margen de activaciones); el AIXX Index es el criterio de estimación a nivel de rack de esta base, actualizado con mediciones reales. Las formas de escalado en clúster (DGX SuperPOD / interconexión InfiniBand multirack) siguen los diseños de referencia de NVIDIA.
Galería GALLERY


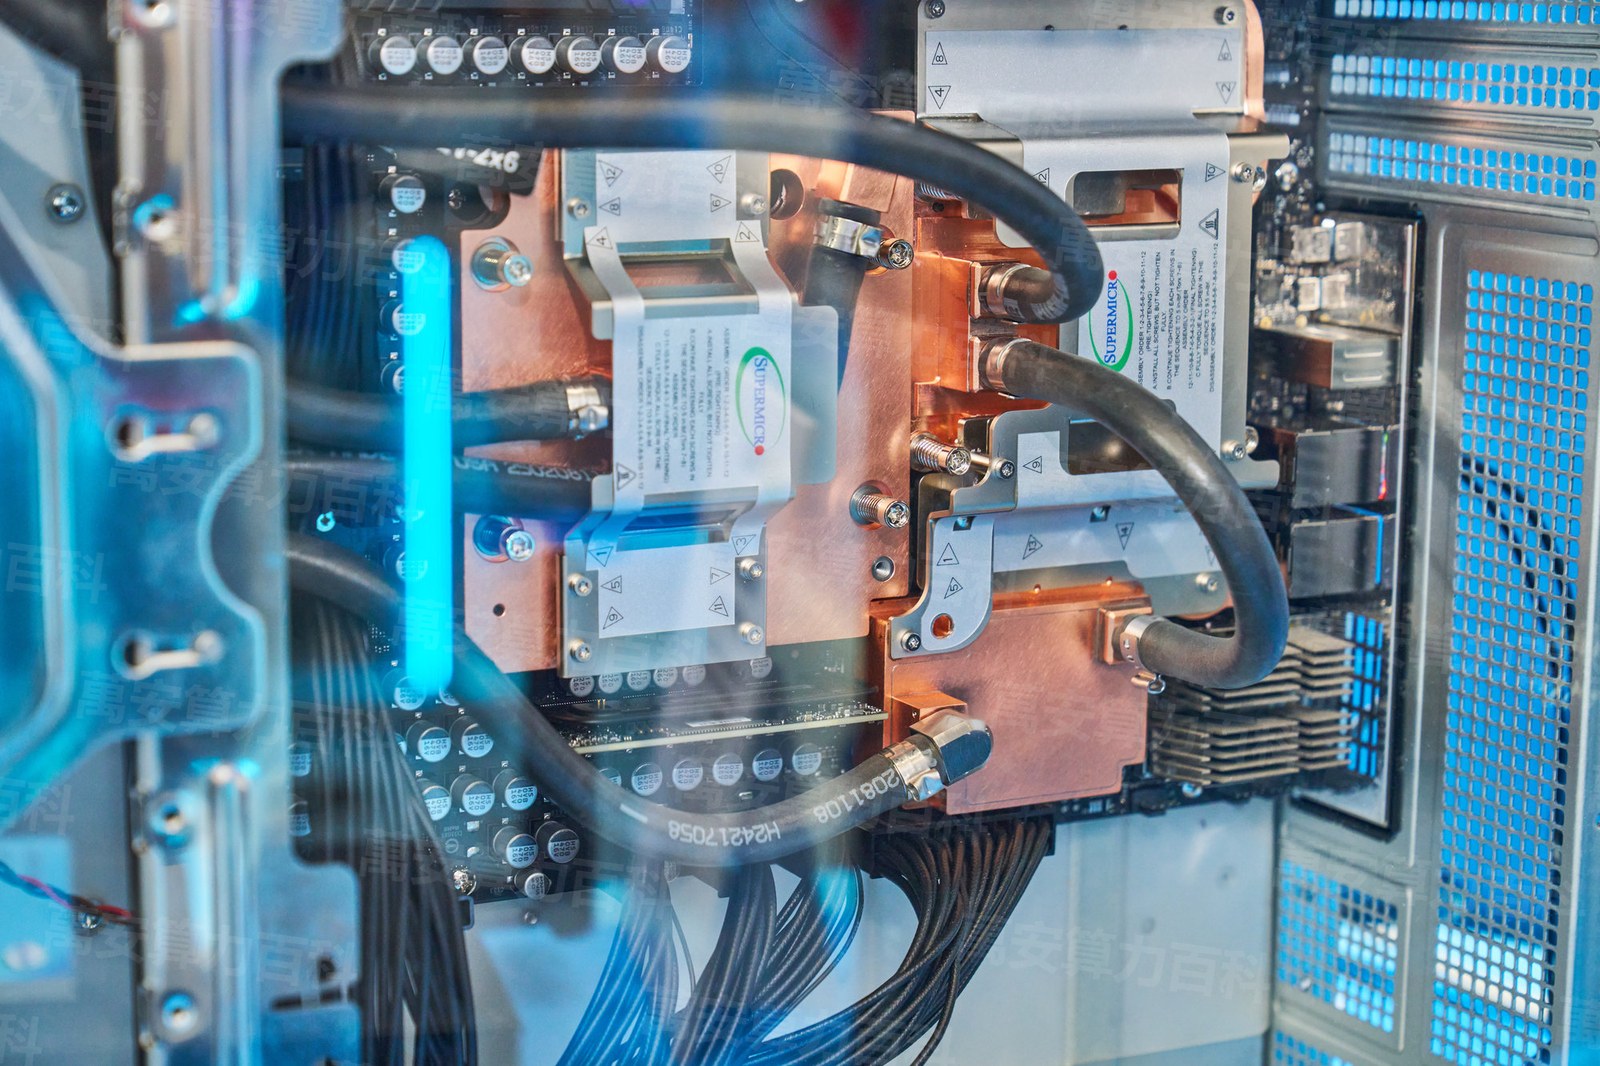
Las fotos reales se irán añadiendo progresivamente con cada lote de inspección; no se presentan renders oficiales como fotos reales, ni imágenes generadas por IA como fotos reales.
Vídeo explicativo VIDEO
Este vídeo ofrece una perspectiva de despliegue a nivel de rack exclusiva del GB300 NVL72 (posicionamiento del rack completo → alimentación → refrigerado por líquido → red → verificación tras el encendido); los parámetros y criterios están anclados al GB300 NVL72 real; la narración y los textos de escena archivados en _wiki_work_1006/gen_tts_gb300.py.
Equipo real de la comunidad · Fuente: YouTube COMMUNITY HANDS-ON
En algunas regiones puede que no se reproduzca directamente
Software y ecosistema ECOSYSTEM
| Concepto | Requisito / Situación actual |
|---|---|
| CUDA / drivers | Misma generación y mismo stack que el B300: línea de soporte de la generación Blackwell (soporte completo desde CUDA 12.8); consulte la ficha del B300 y la documentación oficial de NVIDIA |
| Comunicaciones colectivas | NCCL optimizado nativamente para la interconexión completa NVLink5 / NVSwitch: la aceptación a nivel de rack se realiza mediante pruebas de interconexión completas con nccl-tests (véase «Cómo verificar») |
| Gestión de clúster | NVIDIA Base Command / diseños de referencia DGX SuperPOD; ecosistema Slurm / Kubernetes de terceros de uso general (criterio público) |
| Motor de inferencia | vLLM / SGLang / TensorRT-LLM soportan Blackwell Ultra (la ruta FP4 es una novedad generacional, según las versiones de cada motor) |
| Redes complementarias | Quantum-X800 InfiniBand / Spectrum-X Ethernet, interconexión óptica de 800G (escalado multirack) |
| Supervisión de operaciones | DCGM / gestión fuera de banda a nivel de bandeja (conmutador fuera de banda SN2201): los contadores de eventos RAS son un indicador duro en la aceptación del rack |
Las versiones del stack de software evolucionan con el tiempo; prevalece lo publicado oficialmente por NVIDIA. La valoración de madurez del ecosistema se detalla en la ficha del B300 (compartida en la misma generación).
Compra e inspección PROCUREMENT
Puntos clave de inspección al comprar un GB300 NVL72 (tres puntos, criterio a nivel de rack):
Los cinco criterios de aceptación a nivel de rack se detallan en esta ficha «Cómo verificar» de esta ficha.
Cómo validar la recepción (a nivel de bastido) RACK ACCEPTANCE
Cinco criterios de aceptación a nivel de rack (un sistema distinto de las pruebas por tarjeta; todos los criterios numéricos anclados al GB300 NVL72 real): autodiagnóstico al encender → calibración del refrigerado por líquido → consumo del sistema completo → prueba de interconexión NCCL completa → contadores de eventos RAS.
Esta sección aplica el criterio de aceptación a nivel de rack; no es intercambiable con los seis criterios de «Cómo hacer pruebas de estrés» de la ficha por tarjeta; el umbral proporcional de ≥85% es el criterio de esta base (estimación) y prevalece la normativa de aceptación del OEM.
Transporte y entrega LOGISTICS
OEM y variantes VENDORS
La misma arquitectura de referencia GB300 NVL72; las diferencias entre racks de cada fabricante están en la entrega, el equipamiento de refrigerado por líquido y el servicio — a la hora de elegir, conviene ver las diferencias (la circulación en esta biblioteca ya cubre Supermicro / Dell):
| Fabricante | Formato representativo | Diferencias clave | Para quién |
|---|---|---|---|
| Supermicro | SRS-GB300-NVL72 (criterio de circulación de esta biblioteca) | Entrega de rack completo con CDU interna de 250kW y bastidores de alimentación 8× 33kW, soporte de refrigerado por líquido cerrado del propio fabricante[4] | Compra en stock · soporte de refrigerado por líquido llave en mano |
| Dell | Rack completo GB300 NVL72 (criterio de circulación de esta biblioteca; primer entregador: CoreWeave) | Red de servicios de primer nivel mundial, con experiencia en grandes entregas de nube pública[8] | Despliegues multinacionales · prioridad al servicio |
| NVIDIA oficial | DGX GB300 / DGX SuperPOD | Entrega integral oficial + software de pila completa (31 registros en USD en la circulación de esta biblioteca) | Quien quiera entrenar desde el primer día · soporte del fabricante |
| Lenovo / HPE / Cisco | Rack completo GB300 NVL72 | Red de servicios de nivel empresarial (según la lista de socios del comunicado de prensa[3]) | Compra por canal de clientes corporativos |
| Wiwynn / Pegatron / Quanta, etc. | Rack ODM / fabricación por encargo | Backend de la cadena de suministro de proveedores de nube (una de las formas de entrega de CoreWeave, etc.) | Grandes pedidos de proveedores de nube · canal ODM |
AIXX Index · comparativa de despliegue en cuatro dimensiones (nivel de rack) AIXX INDEX
| Fabricante | Facilidad de instalación | Facilidad de mantenimiento | Densidad de rendimiento | Expectativa de vida útil |
|---|---|---|---|---|
| Supermicro | 72 | 80 | 95 | 82 |
| Dell | 78 | 88 | 95 | 85 |
| NVIDIA oficial | 82 | 85 | 94 | 85 |
| Lenovo / HPE / Cisco | 76 | 86 | 94 | 84 |
| ODM (Wiwynn/Pegatron/Quanta) | 68 | 72 | 95 | 80 |
El AIXX Index es el criterio de estimación a nivel de rack de esta base (0–100; bases de la puntuación: forma de entrega del rack completo, soporte de refrigerado por líquido y diferencias en la red de servicios; «facilidad de instalación» generalmente inferior a los equipos de 8 tarjetas refrigerados por aire, atributo objetivo del despliegue a nivel de rack, no una carencia del fabricante), actualizado con verificaciones en equipos reales; no constituye un compromiso de compra. Los modelos específicos prevalecen según lo publicado oficialmente por los fabricantes.
Fichas de términos GLOSSARY
NVL72 / supernodo
N = dominio NVLink, 72 = número de GPUs en el dominio. 72 GPUs interconectadas por completo vía NVSwitch forman un único dominio NVLink, que ante el software se presenta como un «acelerador gigante»: este es el significado de «supernodo» y la diferencia esencial entre un producto a nivel de rack y un equipo de 8 tarjetas.
Compute Tray: bandeja de cómputo
La unidad mínima de cómputo del rack: cada bandeja lleva 4× Blackwell Ultra (1.152GB de HBM3e en total) + 2× Grace (1TB de LPDDR5X en total), con 18 bandejas en total. Las bandejas se pueden extraer y sustituir individualmente: los números de serie y los informes de firmware a nivel de bandeja son la unidad mínima de confianza en la inspección del rack.
NVSwitch Tray: bandeja de conmutación
9 bandejas de conmutación soportan la interconexión completa de las 72 GPUs: las bandejas de cómputo se conectan a ciegas a las bandejas de conmutación mediante los cartuchos de cable NVLink traseros (cable cartridge), formando una matriz P2P sin bloqueos: de ahí los 130TB/s agregados de ancho de banda NVLink5.
CDU y refrigerado por líquido de conexión ciega
La CDU (Coolant Distribution Unit, unidad de distribución de refrigerante) es de 250kW dentro del rack e impulsa el circuito secundario de refrigerado por líquido; entre las bandejas de cómputo y el manifold del rack hay conectores ciegos (blind-mate): al insertar la bandeja, el circuito de líquido se conecta. La detección de fugas en dos niveles (bandeja + rack) es de serie.
Grace CPU
CPU de NVIDIA con arquitectura Arm (Neoverse V2, 72 núcleos), 36 por rack y 2 por bandeja, con memoria LPDDR5X (17TB en total). Grace se encarga de «alimentar» a las GPUs: preprocesamiento de datos, comunicaciones y planificación; la conexión GPU↔CPU se realiza vía NVLink-C2C.
Controles de exportación y lotes de cumplimiento
El GB300 está sujeto a los controles de exportación de EE. UU. hacia China y no figura en la lista aprobada para el mercado chino (criterio público de octubre de 2026); la circulación en stock se concentra en canales internacionales y de zonas francas. El lote y la ruta aduanera afectan la garantía y el valor de reventa: imprescindible verificarlo en la inspección. Las afirmaciones de esta base siguen criterios de reportes públicos y no constituyen asesoramiento legal.
Novedades y eventos relacionados TIMELINE
Limitaciones y controversias LIMITS
- El otro lado: la barrera de despliegue : refrigerado por líquido en su totalidad + alimentación de 132kW (hasta 142kW a plena carga según la arquitectura de referencia) + carga estructural del rack completo de toneladas: los centros de datos refrigerados por aire existentes prácticamente quedan descartados, y las obras de adecuación suelen tardar meses; si el presupuesto no alcanza para acondicionar la sala, el equipo refrigerado por aire B300 NVL8 es un primer paso más realista (véase «Refrigeración y despliegue»).
- El apretón generacional ya es público : en la misma ronda de MLPerf de septiembre de 2026, el sucesor Vera Rubin NVL72 debutó superando al GB300 con hasta 3.7× (Qwen3-VL, según el blog oficial de NVIDIA[6]) — la ventana de ventaja de un rack insignia se mide en trimestres; al comprar, hay que calcular bien el ritmo de depreciación.
- Objeto de controles de exportación hacia China (formulación neutra) : el GB300 no figura en la lista aprobada para China (cifras públicas de octubre de 2026); la circulación en el mercado secundario se concentra en canales extranjeros y zonas francas, y la vía aduanera y el estado de cumplimiento afectan directamente a la garantía y al valor de reventa[10]. Esta biblioteca solo recoge cifras de informes públicos y no constituye asesoría legal.
- Volumen de precio y liquidez : varios millones de dólares por rack (el GB200 NVL72 de la generación anterior se reportó públicamente en unos 3 millones de USD por rack[9]); predominan las cotizaciones por lote completo — el mercado de reventa de racks individuales es sumamente inmaduro, el valor residual depende en gran medida de las condiciones de la sala de equipos y de la continuidad de la garantía del fabricante, y el costo de reventa es muy superior al de una tarjeta suelta.
- Discrepancia en la capacidad de memoria (18TB vs 20TB) : la página oficial indica 20 TB (288 GB × 72 = 20,7 TB, cálculo coincidente); materiales tempranos de canal mencionaban 18 TB — cotizaciones y contratos deben cotejarse con la cifra oficial de 20 TB, y la aceptación se rige por mediciones reales del informe de firmware a nivel de bandeja (en algunas cadenas config de la circulación de esta biblioteca aún aparece 18 TB, ya anotado en las notas de esta entrada).
- El otro lado de «una sola gran tarjeta» : el dominio NVLink es su fuente de rendimiento y también su frontera de riesgo: un fallo dentro del dominio afecta a todo el rack, y las operaciones requieren capacidad de aislamiento a nivel de bandeja y de cambio rápido de bandejas (véase el apartado RAS de «Cómo verificar»), lo que supone una exigencia real para el equipo de operaciones.
Banda de mercado MARKET DATA
| Fecha | Criterio | Región | Banda de precio de referencia | Notas |
|---|---|---|---|---|
| 2026-10-30 | En vivo del hall | EE. UU. (USD) | $7,23M – 9,18M | 48 cotizaciones › (criterio de cotización por rack completo) |
| 2026-10 | Referencia de canal | China continental | ¥110M – ¥130M | criterio de canales en stock en China continental (cotización por rack completo) · Racks en circulación › |
| 2026-10-30 | En vivo del hall | Oriente Medio (AED) | 48,16 – 62,64 millones AED | 70 cotizaciones (criterio de precio por rack completo) |
| 2026-10-30 | En vivo del hall | Europa (EUR) | €9,98M – 12,67M | 60 cotizaciones (cotización por rack completo) |
| 2026-10-30 | En vivo del hall | Singapur (SGD) | 20,69 – 26,01 millones S$ | 55 cotizaciones (criterio de precio por rack completo) |
| 2026-10-30 | En vivo del hall | Japón (JPY) | JPY 2.261,01M – 2.868,80M | 49 cotizaciones (criterio de precio por rack completo) |
| 2025-12 | Referencia de canal | Global | GB200 NVL72 de la generación anterior: unos $3M / rack | Criterio de informes públicos[9] · El GB300 no tiene precio oficial · Racks en circulación › |
| 2026-10-30 | Criterio regulatorio | China continental | No figura en la lista aprobada para el mercado chino | El GB300 está sujeto a los controles de exportación de EE. UU.; la circulación en stock se concentra en canales internacionales y de zonas francas (criterio de reportes públicos, sin constituir asesoramiento legal) |
Criterio: Banda estimada del canal spot de China continental —desde agosto de 2025, banda estimada a partir del precio de referencia de lanzamiento (criterio de referencia del canal overseas de nivel $3.4M/rack ≈ ¥24,5-27 millones; NVIDIA no publicó precio oficial; la banda refleja fluctuaciones de canal/configuración); desde octubre de 2026, criterio conocido del canal spot de China continental ( ¥110-130 millones/rack ); los canales extranjeros (nivel 3,4 M USD) y el mercado de existencias del continente son dos mercados paralelos que no se convierten entre sí. Norteamérica/Europa/Singapur/Japón/Oriente Medio se acumulan día a día según instantáneas de mercado (3,444–4,229 M USD · 25 registros, entre otros, desde el 08-10-2026, todos en moneda original y sin conversión mutua). El GB300 no figura en la lista aprobada para China; las cotizaciones del continente corresponden al contexto de canales extranjeros y zonas francas (criterio de informes públicos, sin constituir asesoría legal). Inventario de precios de esta biblioteca: AIXX Exchange (intermediación sin comisión, no participa en transacciones, no conoce ni especula precios de cierre, por lo que los datos son neutrales). El precio real está sujeto a la cotización del vendedor.
Hitos de precios MILESTONES
Preguntas frecuentes FAQ
Rack supernodo Blackwell Ultra presentado por NVIDIA en el GTC de marzo de 2025: 72 GPUs Blackwell Ultra + 36 CPUs Grace en un rack totalmente refrigerado por líquido, con interconexión NVLink5 total de 130 TB/s, que se presenta al software como un único acelerador. FP4 Tensor Core con especificación oficial de 1,440 PFLOPS (criterio dense), y 20 TB de HBM3e de memoria total de GPU.
Según sala y escala: el NVL72 exige alimentación de nivel 132 kW, refrigerado por líquido con CDU y refuerzo estructural, a cambio de 20 TB de memoria en un solo dominio NVLink, con forma de fábrica de entrenamiento e inferencia a gran escala; el NVL8 ofrece 288 GB por tarjeta y 2,3 TB por sistema, desplegable por lotes en salas existentes. Con presupuesto para remodelar la sala, NVL72; sin él, empezar por NVL8 (ambos formatos están en circulación en esta biblioteca, véase la banda de mercado).
El GB300 está sujeto al control de exportaciones de EE. UU. y no figura en la lista aprobada para China (criterio público de octubre de 2026; lo aprobado para entrada en volumen en julio de 2026 fue el H200); la circulación spot se da principalmente por canales overseas y de zonas francas. Este apartado refleja criterio de reportes públicos y no constituye asesoría legal; antes de comprar, rija por las políticas de las autoridades competentes y un dictamen profesional de cumplimiento.
Según la página oficial de NVIDIA: 20 TB HBM3e (288 GB/tarjeta × 72 = 20,7 TB, cálculo coincidente; el catálogo de certificación de Red Hat coincide); materiales tempranos de canal mencionaban 18 TB (aún visible en algunas cadenas config de la circulación de esta biblioteca). Rige la cifra oficial de 20 TB: cotizaciones y contratos deben cotejarse con ella, y la aceptación se rige por mediciones reales del informe de firmware a nivel de bandeja.
No: el nivel de rack sigue otro sistema de aceptación: autotest al encender (18+9 bandejas verificadas una a una), calibración del circuito de refrigerado por líquido (caudal/ΔT del CDU/detección de fugas sin alarmas), consumo del sistema completo (alineado a 132-142 kW en plena carga), pruebas de conectividad NCCL de todo el equipo (all_reduce de 72 tarjetas según lo nominal de NVLink5) y contadores de eventos RAS (sin ECC no corregido ni interrupciones). La verificación de números de serie bandeja por bandeja es la unidad mínima de confianza en la inspección de racks (ver «Cómo aceptar»).
Entradas relacionadas SEE ALSO
Comparativa y elección de modelos COMPARE
Referencias REFERENCES
- NVIDIA.com — página de producto GB300 NVL72 (archivo principal de especificaciones, verificado 2026-10) https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- NVIDIA — Arquitectura de referencia empresarial NVL72 AI Factory: componentes del sistema (criterio de bandejas/alimentación/refrigerado por líquido, verificado 2026-10) https://docs.nvidia.com/enterprise-reference-architectures/n…
- Sala de prensa de NVIDIA — NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning (nota de lanzamiento 18-03-2025: 1.5×/H2 2025/16 socios/CX-8 800G) https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Supermicro — página oficial SRS-GB300-NVL72 (132 kW / CDU 250 kW / dimensiones) https://www.supermicro.com/en/products/rack/srs-gb300-nvl72
- Catálogo de certificación de Red Hat — GB300 NVL72 (1.1 ExaFLOPS / 20.7 TB HBM3e, criterio del catálogo de socios) https://catalog.redhat.com/en/hardware/system/detail/307917
- Blog oficial de NVIDIA — debut en MLPerf de Vera Rubin NVL72, Qwen3-VL hasta 3.7× frente a GB300 (16-09-2026) https://blogs.nvidia.com
- MLCommons — resultados de MLPerf Inference v6.1 (debut del GB300 NVL72, hasta 2.5× en MoE, 17-09-2026) https://mlcommons.org
- CoreWeave — GA de instancias cloud GB300 NVL72 (changelog 19-08-2025) y informe trimestral Q3 2025 «First to deploy» https://docs.coreweave.com
- Forbes — GB200 NVL72 a unos $3 millones por rack (23-12-2025, ancla de precio de la generación anterior) https://www.forbes.com
- CNBC / EE. UU. — control de exportaciones a China y nueva norma BIS de enero de 2026 (criterio de reportes públicos) https://www.cnbc.com
- Pegatron NVIDIA GB300 NVL72 and More at NVIDIA GTC 2025 (fotos de la bandeja de cómputo) https://www.servethehome.com/pegatron-nvidia-gb300-nvl72-and…
- Supermicro NVIDIA B300 y recorrido AI Factory (fotos del rack GB300 NVL72 de Supermicro) https://www.servethehome.com/checking-out-the-supermicro-nvi…
- Datos de la banda de mercado — AIXX Exchange (rango de cotizaciones en circulación de esta plataforma y de conocimiento de canales, actualizado a diario) /hall.html