AIXX Pedia › Modelleintrag › GB300 NVL72
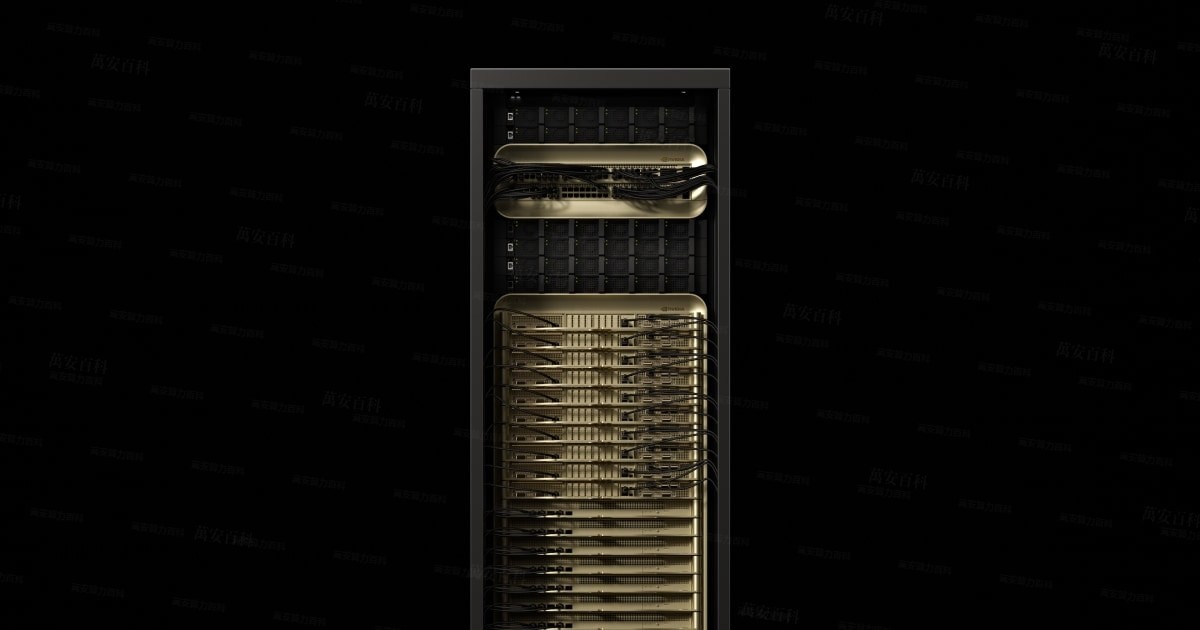
GB300 NVL72
ÜberblickOVERVIEW
GB300 NVL72(Vollständige Bezeichnung NVIDIA GB300 NVL72, die Flaggschiff-Variante der Blackwell-Ultra-Plattform) ist ein von NVIDIA am 18. März 2025 auf der GTC vorgestelltes Rack-gebundenes Supernode-System: Es bringt 72 Blackwell-Ultra-GPUs und 36 Grace-CPUs in einem vollständig flüssigkeitsgekühlten Rack unter, mit fünfter NVLink-Generation und insgesamt 130 TB/s Aggregate-Bandbreite – für die Software ist das gesamte Rack ein einzelner Beschleuniger[1][3]。
Es ist der Träger der drei Buchstaben „NVL72“ aus dem Namen: N = NVLink-Domain, 72 = Anzahl der GPUs pro Domain. Nach offiziellen Angaben liegt es 1,5-fach über dem Vorgänger GB200 NVL72, die offiziellen FP4-Tensor-Core-Spezifikationen 1,440 PFLOPS(dense) und die aggregierte GPU-Grafikspeicherkapazität 20TB HBM3e sowie die Leistungsaufnahme im 132-kW-Bereich stehen in den Datenblättern – die Auslieferung auf Rack-Ebene bedeutet: Bevor man es kauft, braucht man einen Serverraum, der es aufnehmen kann[1][2][3]。
Auf dem Spot-Markt 2026 ist das GB300 NVL72 der Flottillen-Flaggschiff-Kandidat für große Trainings- und Inferenz-Fabriken: Im August 2025 brachte CoreWeave es als Erster in die Public Cloud, im September 2026 gab es sein Debüt in MLPerf Inference v6.1 mit öffentlichen Ergebnissen, und im selben Durchgang zeigte sich bereits der Nachfolger Vera Rubin NVL72 (bis zu 3,7× gegenüber dem GB300, öffentliche Angabe[6]) – der Flaggschiff-Posten wartet auf niemanden, doch Einstiegshürde und Komplettpreis bewegen sich gleichermaßen in einer eigenen Größenordnung (siehe „Kühlung und Deployment“ sowie „Marktspanne“).
EinsatzszenarienFIT
AIXX Index(0–100): Diese Datenbank gewichtet öffentliche Spezifikationen – Rack-Grafikspeicher 40 %, Interconnect 30 %, Ökosystem 30 %, mit szenariobedingter Anpassung,Rack-Ebene-Schätzmethodik(nicht direkt vergleichbar mit der Methodik der Einzel-GPU-Einträge). 90+ Flaggschiff-Niveau · 75+ Ausgezeichnet · 60+ brauchbar · unter 60 nicht einsatzgerecht. Die Methodik ist transparent und nachprüfbar, stellt aber keine Leistungszusage dar.
EntwicklungsgeschichteHISTORY
18. März 2025 Auf der GTC-Keynote wird die Blackwell-Ultra-Plattform vorgestellt: Offiziell beschleunigt das GB300 NVL72 gegenüber dem GB200 NVL72 um Faktor 1,5; Cisco / Dell / HPE / Lenovo / Supermicro und weitere 16 Partner liefern ab der zweiten Jahreshälfte komplette Racks aus, mit je ConnectX-8-SuperNIC mit 800 Gb/s pro GPU[3]。
Juli–September 2025, die ersten Systeme gehen live: CoreWeave kündigt im Juli den Eingang der ersten GB300-NVL72-Systeme an,am 19. August geht die weltweit erste GB300-NVL72-Cloud-Instanz in den Betrieb(geliefert von Dell); im Quartalsbericht wird sie als „First to deploy NVIDIA GB300 NVL72 systems“ dokumentiert; Quanta liefert ab September aus[8]。
September 2026, MLPerf Inference v6.1: Das GB300 NVL72 gibt sein MLPerf-Debüt, im MoE-Benchmark bis zu 2,5-fache Steigerung gegenüber dem Vorgänger; im selben Durchgang debütiert auch der Nachfolger Vera Rubin NVL72, im Qwen3-VL-Interaktionsszenario bis zu 3,7-fach über dem GB300 (laut NVIDIA-Offiziellem Blog) – das erste Mal, dass in öffentlichen Benchmarks „amtierendes Flaggschiff vs. Nachfolger“ gleichzeitig auftreten[6][7]。
China-Bezugsrahmen (neutral): Das GB300 unterliegt den US-Exportkontrollen und steht nicht auf der für China genehmigten Liste (Stand 10/2026, öffentliche Angabe; die US-Seite verfolgt für Spitzenchips eine „Presumption of Denial“-Politik, der neue BIS-Regelrahmen von Januar 2026 bleibt bestehen); im Juli 2026 wurden H200-Mengen für China genehmigt, die GB300-Klasse nicht – der Spot-Handel läuft überwiegend über Auslands- und Freihandelszonen-Kanäle. Diese Datenbank dokumentiert nur öffentlich berichtete Angaben und stellt keine Rechtsberatung dar[10]。
Technische DatenSPECIFICATIONS
| Punkt | Spezifikationen (GB300 NVL72 Rack-Ebene · offizielle Angaben) |
|---|---|
| Konfiguration | 72× Blackwell Ultra GPU + 36× Grace CPU (2.592× Arm-Neoverse-V2-Kerne) |
| FP4 Tensor Core | 1.440 PFLOPS (dense) / 10.802 PFLOPS (sparse) – Veröffentlichungsberichte und Partnerkataloge nennen zusätzlich „rund 1,1 EFLOPS FP4-Inferenz“ |
| FP8 / FP6 Tensor Core | 720 PFLOPS |
| FP16 / BF16 · TF32 | 360 / 180 PFLOPS |
| FP64 | 100 TFLOPS |
| GPU-Gesamtspeicher | 20TB HBM3e(288 GB/Karte × 72 = 20,7 TB, Schätzung), Bandbreite bis zu 576 TB/s |
| CPU-Gesamtspeicher | 17 TB LPDDR5X (Bandbreite 14 TB/s); Schnellspeicher gesamt 37 TB |
| GPU-zu-GPU-Interconnect | NVLink fünfte Generation · insgesamt 130 TB/s (je GPU 1,8 TB/s) + 9 NVSwitch-Trays voll vernetzt |
| Rack-Aufbau | 18× Compute-Tray (je Tray 4 GPUs + 2 Grace) + 9× NVSwitch-Tray + 8× 33-kW-Power-Shelf |
| Kühlung | Voll flüssigkeitsgekühlt (fully liquid-cooled); In-Rack-CDU im 250-kW-Bereich; Leckageerkennung auf Tray- und Rack-Ebene |
| Stromversorgung | 132-kW-Konfigurationsebene (8× 33-kW-Power-Shelf); NVIDIA-Referenzarchitektur bis zu 142 kW bei Volllast |
| Externes Netzwerk | Je GPU 800 Gb/s (ConnectX-8 SuperNIC ×4 pro Tray) + BlueField-3 DPU; Skalierung über Quantum-X800 InfiniBand / Spectrum-X Ethernet |
| Vorgänger / Nachfolger | GB200 NVL72 (Faktor 1,5 Unterschied) / Vera Rubin NVL72 (Debüt 09/2026) |
Spezifikationen gemäß offiziellen öffentlichen NVIDIA-Unterlagen[1][2]; FP4-dense stammt aus der offiziellen Spezifikationsseite ohne Sparse-Angabe, 1,1 EFLOPS aus Veröffentlichung/Partnerkatalog – beide Angaben existieren parallel mit Quellen; Tensor-Leistungswerte sind, sofern nicht anders angegeben, inklusive Sparse; die Rack-Konfiguration variiert je nach OEM und Fertigungscharge.
Compute-Tray-AuflösungPER TRAY
| Punkt | Ein Compute-Tray (×18) |
|---|---|
| GPU | 4× Blackwell Ultra (insgesamt 1.152 GB HBM3e) |
| CPU | 2× Grace (72 Kerne ×2, insgesamt 1 TB LPDDR5X) |
| Internes Netzwerk | 4× ConnectX-8 (je 800 Gb/s) + 1× BlueField-3 DPU |
| Interconnect-Schnittstelle | NVLink-Kabelcartridge an der Tray-Rückseite, blindefähig an das NVSwitch-Tray; Flüssigkeitsanschlüsse blindefähig an den Rack-Manifold |
| Betriebsbedeutung | Compute-Trays lassen sich einzeln ziehen und warten – Tray-Seriennummer und Firmware-Report sind die minimale Abnahmeeinheit (siehe „Beschaffung und Abnahme“) |
Tray-Angaben aus der NVIDIA-Referenzarchitektur-Dokumentation[2]。
Generationenvergleich · zwei NVL72 im ÜberblickGENERATIONS
| Punkt | GB200 NVL72 | GB300 NVL72 |
|---|---|---|
| GPU | 72× Blackwell | 72× Blackwell Ultra |
| Speicher pro Karte | 192GB HBM3e | 288GB HBM3e |
| GPU-Gesamtspeicher | 13,8 TB (Schätzung) | 20,7 TB (Schätzung; offizielle Seite: 20 TB) |
| Offizielle relative Leistung | Benchmark | 1,5× AI performance (Pressemitteilung) |
| Netzwerk | ConnectX-7 400G | ConnectX-8 800G |
GB200 als öffentliche Vergleichsangabe geführt, Details in den offiziellen NVIDIA-Unterlagen; beide Generationen sind vollständig flüssigkeitsgekühlt mit 36×-Grace-Architektur.
FamilienmitgliederFAMILY
Die GB300-Familie gliedert sich in vier Formfaktoren; im Verkauf dieser Datenbank stehen vor allem das komplette GB300-NVL72-Rack und das DGX GB300 (das luftgekühlte B300-NVL8-Komplettsystem siehe B300-Eintrag):
Kühlung und DeploymentCOOLING & DEPLOYMENT
GB300 NVL72 Nur eine Bauform: Flüssigkeitskühlung: Compute-Trays und NVSwitch-Trays sind vollständig mit Kaltplatten-Flüssigkeitskühlung versehen; die Kühlanschlüsse an der Tray-Rückseite sind Blinde Steckverbinder gegenüber dem Rack-Manifold, die In-Rack-CDU im 250-kW-Bereich (Supermicro-Angabe, redundante Stromversorgung) treibt den Sekundärkreis; die NVIDIA-Referenzarchitektur verlangt Leckageerkennung auf zwei Ebenen, Tray und Rack[2][4]. Der Einsatz ist kein „Serverkauf“, sondern ein Rechenzengineering-Projekt:


Modell- und Cluster-EignungMODEL & CLUSTER FIT
| Modell / Szenario | Speicherbedarf (FP8-Schätzung) | GB300-NVL72-Deployment (ein Rack, 20,7 TB, Schätzung) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 vollständig (671B) in mehreren Instanzen | ca. 690 GB / Instanz | Ein Rack kann 20+ Instanzen gleichzeitig hosten (Gewichtsrechnung, ohne KV-Cache) – das Rückgrat einer hochparallelen Inferenz-Fabrik | 96 |
| Training von MoE im Billionen-Parameter-Maßstab | Gewichte + Optimizer-Status im TB-Bereich | Tensor-/Expert-Parallelität innerhalb der 72-GPU-NVLink-Domain, Gradienten bleiben im Rack; mehrere Racks über 800G skalieren | 95 |
| Lange Kontexte (Millionen-Token-Bereich) | KV-Cache wächst linear mit dem Kontext | 20 TB gepoolter Grafikspeicher lassen ausreichend Reserve für KV-Caches – ein einzelnes Rack trägt groß angelegte Concurrency mit langen Kontexten | 92 |
| Produktionslinien für kleine Modelle der 7B-14B-Klasse | ca. 8–30 GB / Instanz | Läuft zwar, ist aber „mit Kanonen auf Spatzen geschossen“ – für solche Linien sind B300 NVL8 / H200 die wirtschaftlichere Wahl (Wirtschaftlichkeitsbetrachtung) | 58 |
Speicherbedarf bei FP8-Gewichten grob ≈ Parameterzahl × 1 Byte (Schätzung, ohne KV-Cache und Aktivierungsreserve); der AIXX Index ist eine Rack-Ebene-Schätzmethode dieser Datenbank und wird mit Messdaten aktualisiert. Cluster-Erweiterungsformen (DGX SuperPOD / Multi-Rack-InfiniBand-Verkabelung) folgen den NVIDIA-Referenzdesigns.
BildergalerieGALLERY
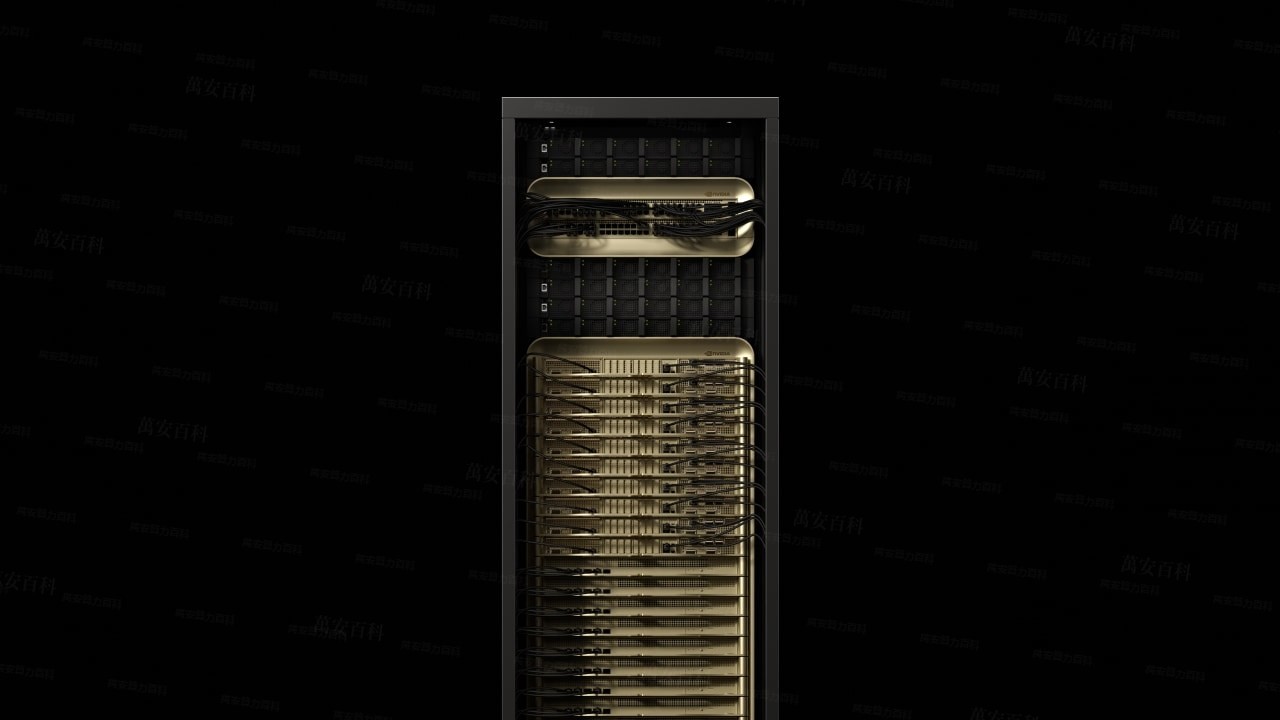


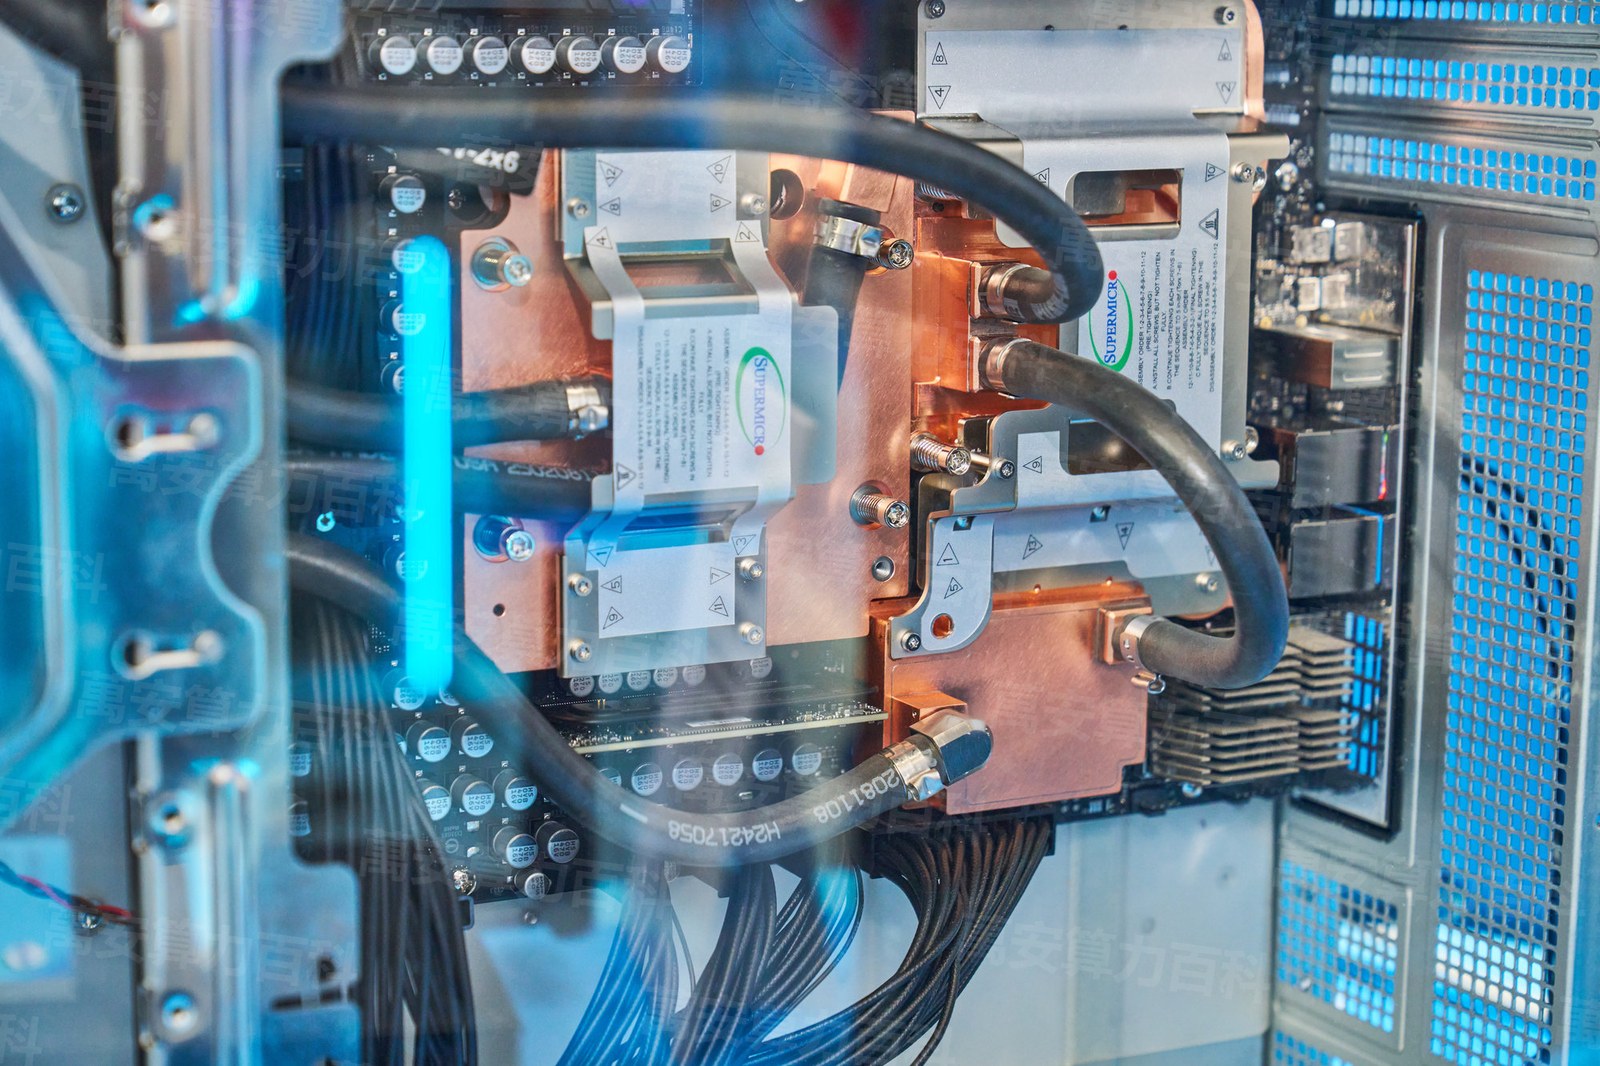
Originalfotos werden laufend nach und nach mit jeder Prüfcharge ergänzt; offizielle Renderings werden nicht als Originalfotos ausgegeben, KI-generierte Bilder nicht als echte Aufnahmen.
Video-ErklärungVIDEO
Dieses Video zeigt die rack-spezifische Deploy-Perspektive des GB300 NVL72 (Rack-Positionierung → Stromversorgung → Flüssigkeitskühlung → Netzwerk → Inbetriebnahme und Abnahme); Parameter und Bewertungsmaßstäbe beziehen sich ausschließlich auf das GB300 NVL72. Voiceover- und Szenentext-Archiv: _wiki_work_1006/gen_tts_gb300.py.
Community-Material · Quelle YouTubeCOMMUNITY HANDS-ON
In manchen Regionen ist die direkte Wiedergabe möglicherweise nicht verfügbar
Software und ÖkosystemECOSYSTEM
| Punkt | Anforderung / Status |
|---|---|
| CUDA / Treiber | Gleiche Generation und derselbe Software-Stack wie der B300: Die Blackwell-Generation wird ab CUDA 12.8 vollständig unterstützt, Details im B300-Eintrag und in der offiziellen NVIDIA-Dokumentation |
| Kollektive Kommunikation | NCCL ist nativ für NVLink5 / NVSwitch-Vollvernetzung optimiert – die Rack-Abnahme erfolgt über einen nccl-tests-Gesamtverbundtest (siehe „Wie wird abgenommen“) |
| Clusterverwaltung | NVIDIA Base Command / DGX SuperPOD-Referenzdesign; Drittanbieter-Ökosysteme Slurm / Kubernetes allgemein nutzbar (öffentliche Angaben) |
| Inferenz-Engines | vLLM / SGLang / TensorRT-LLM unterstützen alle Blackwell Ultra (FP4-Pfad als Generationseigenschaft, maßgeblich sind die jeweiligen Engine-Releases) |
| Netzwerk-Infrastruktur | Quantum-X800 InfiniBand / Spectrum-X Ethernet, 800G optische Interconnects (Multi-Rack-Skalierung) |
| Betriebsüberwachung | DCGM / Tray-Level-Out-of-Band-Verwaltung (SN2201-Management-Switch) – RAS-Ereigniszähler sind ein hartes Abnahmekriterium auf Rack-Ebene |
Software-Stack-Versionen entwickeln sich weiter, maßgeblich sind die offiziellen NVIDIA-Releases; zur Einschätzung der Ökosystemreife siehe den B300-Eintrag (gleiche Generation).
Beschaffung und WarenprüfungPROCUREMENT
Prüfpunkte beim Einkauf eines GB300 NVL72 (drei Punkte, Rack-Ebene):
Fünf Abnahmekriterien auf Rack-Ebene in diesem Eintrag„Wie nimmt man ab?“dieses Eintrags.
So nehmen Sie es ab (Rack-Ebene)RACK ACCEPTANCE
Fünf Bewertungsmaßstäbe der Rack-Abnahme (ein eigenes System gegenüber Einzel-GPU-Tests, alle Zahlenkriterien verankert am GB300 NVL72): Inbetriebnahme-Selbsttest → Kühlungskalibrierung → Gesamtleistungsaufnahme → NCCL-Gesamtverbundtest → RAS-Ereigniszähler.
Dieser Abschnitt beschreibt Rack-Level-Abnahmekriterien und gilt nicht für die sechs Einzel-GPU-Stresstest-Kriterien; die ≥85-%-Quote ist ein Abnahmemaßstab dieser Datenbank (Schätzung), maßgeblich ist letztlich die OEM-Abnahmespezifikation.
Versand und LieferungLOGISTICS
OEM und VariantenVENDORS
Dieselbe GB300-NVL72-Referenzarchitektur – die Komplettrack-Anbieter unterscheiden sich in Lieferung, Kühlzubehör und Service; vor der Auswahl zuerst die Unterschiede ansehen (im Angebot dieser Datenbank: Supermicro / Dell):
| Systemhersteller | Leitformfaktor | Unterscheidungsmerkmale | Für wen geeignet |
|---|---|---|---|
| Supermicro | SRS-GB300-NVL72 (Angebot dieser Datenbank) | In-Rack-CDU der 250-kW-Klasse, 8× 33-kW-Power-Shelves als Komplettauslieferung, Kühlzubehör komplett aus einer Hand[4] | Sofort verfügbar · Kühlzubehör aus einer Hand |
| Dell | GB300 NVL72 Komplettrack (Angebot dieser Datenbank; CoreWeave als Erstauslieferer) | Globales Service-Netz erster Klasse, Erfahrung mit großen Public-Cloud-Aufträgen[8] | Multinationale Bereitstellung · Service im Fokus |
| NVIDIA offiziell | DGX GB300 / DGX SuperPOD | Offizielle Komplettlieferung + Full-Stack-Software (31 USD-Angebote in dieser Datenbank) | Wer sofort training will · Wer Herstellersupport braucht |
| Lenovo / HPE / Cisco | GB300 NVL72 Komplettrack | Enterprise-Service-Netz (Pressemitteilungen der Partner[3]) | Beschaffung über Enterprise-Kanäle |
| Wiwynn / Pegatron / Quanta u. a. | ODM-Komplettrack / Auftragsfertigung | Supply-Chain-Backend der Cloud-Anbieter (eine der Lieferformen von CoreWeave u. a.) | Großaufträge der Cloud-Anbieter · ODM-Kanal |
AIXX Index · Vierdimensionaler Deployment-Vergleich (Rack-Ebene)AIXX INDEX
| Systemhersteller | Einfache Installation | Wartungsfreundlichkeit | Leistungsdichte | Erwartete Lebensdauer |
|---|---|---|---|---|
| Supermicro | 72 | 80 | 95 | 82 |
| Dell | 78 | 88 | 95 | 85 |
| NVIDIA offiziell | 82 | 85 | 94 | 85 |
| Lenovo / HPE / Cisco | 76 | 86 | 94 | 84 |
| ODM (Wiwynn/Pegatron/Quanta) | 68 | 72 | 95 | 80 |
Der AIXX Index ist eine Rack-Level-Schätzmethode dieser Datenbank (0–100, Bewertungsgrundlage = Komplettrack-Lieferform, Kühlzubehör und Service-Netz; „Installationsfreundlichkeit“ liegt generell unter luftgekühlten 8-GPU-Systemen – eine objektive Eigenschaft des Rack-Deployments, kein Herstellermangel) und wird mit realer Verifikation aktualisiert; keine Kaufzusage. Konkrete Modelle maßgeblich nach offiziellen Herstellerangaben.
BegriffskartenGLOSSARY
NVL72 / Supernode
N = NVLink-Domain, 72 = GPU-Anzahl in der Domain. 72 GPUs sind über NVSwitch zu einer NVLink-Domain vollvernetzt und erscheinen der Software als ein „riesiger Beschleuniger“ – das ist die Bedeutung von „Supernode“ und der wesentliche Unterschied zwischen Rack-Produkten und 8-GPU-Systemen.
Compute Tray
Kleinste Recheneinheit des Racks: je Tray 4× Blackwell Ultra (gesamt 1.152 GB HBM3e) + 2× Grace (gesamt 1 TB LPDDR5X), insgesamt 18 Trays. Trays sind einzeln austauschbar – Tray-Seriennummern und Firmware-Berichte sind die kleinste vertrauenswürdige Einheit der Rack-Abnahme.
NVSwitch Tray
9 Switch-Trays tragen die Vollvernetzung der 72 GPUs: Die Compute-Trays docken über hintere NVLink-Cable-Cartridges blind an die Switch-Trays an und bilden eine nicht blockierende P2P-Matrix – daher die insgesamt 130 TB/s NVLink5-Bandbreite.
CDU und Blind-Mate-Kühlung
Die CDU (Coolant Distribution Unit) in der 250-kW-Klasse im Rack treibt den Sekundärkreis der Flüssigkeitskühlung; zwischen Compute-Trays und Rack-Manifold sitzen Blind-Mate-Anschlüsse – das Tray wird eingeschoben und der Kühlkreis ist verbunden. Zweistufige Leckageerkennung (Tray + Rack) ist Standard.
Grace CPU
NVIDIAs Arm-CPU (Neoverse V2, 72 Kerne), 36 Stück pro Rack, 2 pro Tray, mit LPDDR5X-Speicher (gesamt 17 TB). Grace „füttert“ die GPUs: Datenvorverarbeitung, Kommunikation und Scheduling; die GPU↔CPU-Anbindung erfolgt über NVLink-C2C.
Exportkontrollen und Compliance-Chargen
Der GB300 unterliegt den US-Exportkontrollen nach China und ist nicht auf der Freigabeliste (öffentliche Angaben Stand 2026-10); der Spot-Markt läuft überwiegend über Auslands- und Freihandelszonen-Kanäle. Charge und Zollweg beeinflussen Garantie und Werterhalt – bei der Abnahme zwingend prüfen. Alle Aussagen hier sind öffentlich berichtete Angaben und stellen keine Rechtsberatung dar.
Neuigkeiten und relevante EreignisseTIMELINE
Grenzen und KontroversenLIMITS
- Die Deployment-Hürde ist die andere Seite der Medaille: Komplett flüssigkeitsgekühlt + Stromversorgung der 132-kW-Klasse (Referenzarchitektur max. 142 kW bei Volllast) + Rack-Gewicht im Tonnenbereich – bestehende luftgekühlte Rechenzentren fallen praktisch aus, Umbauten dauern oft Monate; wem das Budget für den Umbau fehlt, ist mit einem B300-NVL8-luftgekühlten System realistischer beraten (siehe „Kühlung und Deployment“).
- Die generationenbedingte Verdrängung ist offen ausgebrochen: Im selben MLPerf-Durchlauf im September 2026 übertraf der Nachfolger Vera Rubin NVL72 bei seinem Debüt den GB300 um bis zu 3,7× (Qwen3-VL, NVIDIA-Offiziellblog[6]) – der Vorsitzsfenster eines Flaggschiff-Racks zählt in Quartalen; bei der Beschaffung den Abschreibungsrhythmus einplanen.
- Exportkontrollobjekt nach China (neutrale Formulierung): Der GB300 ist nicht auf der Freigabeliste (öffentliche Angaben Stand 2026-10); der Spot-Markt läuft überwiegend über Auslands- und Freihandelszonen-Kanäle; Zollweg und Compliance-Status wirken direkt auf Garantie und Werterhalt[10]. Dieser Shop dokumentiert ausschließlich öffentliche Berichte und gibt keine Rechtsberatung.
- Preisgröße und Liquidität: Ein Rack im Bereich mehrerer Millionen US-Dollar (Vorgänger GB200 NVL72 öffentlich berichtet bei ca. 3 Mio. $/Rack[9]), Ausschreibung in Gesamtpaketen üblich – der Gebrauchtmarkt für einzelne Racks ist äußerst unreif, der Restwert hängt stark von Rechenzentrumsbedingungen und Herstellergarantie ab; die Weiterverkaufskosten liegen weit über denen einzelner GPUs.
- Speicherkapazitäts-Diskrepanz (18 TB vs. 20 TB): Offizielle Seite nennt 20 TB (288 GB × 72 = 20,7 TB, Schätzung deckt sich), frühere Kanalunterlagen nannten 18 TB – bei Anfrage und Vertrag die offiziellen 20 TB abgleichen, die Abnahme erfolgt über gemessene Firmware-Berichte auf Tray-Ebene (in laufenden Konfigurationsstrings dieser Datenbank steht noch 18 TB, im Glossar des Eintrags vermerkt).
- Die Kehrseite von „einer großen Karte“: Die NVLink-Domain ist seine Leistungsquelle und zugleich seine Risikogrenze – ein Fehler in der Domain wirkt auf das ganze Rack; der Betrieb erfordert Tray-Isolation und schnellen Tray-Tausch (siehe RAS-Punkt unter „Wie wird abgenommen“) – eine echte Anforderung an das Betriebsteam.
MarktdatenMARKET DATA
| Datum | Methodik | Region | Referenzpreis-Band | Anmerkung |
|---|---|---|---|---|
| 2026-10-14 | Live im Marktplatz | USA (USD) | 3,23 Mio. $ – 8,25 Mio. $ | 34 Angebote ›(Gesamtangebotspreis pro Rack) |
| 2026-10 | Kanalreferenz | Festlandchina | 110 Mio. ¥ – 130 Mio. ¥ | Spot-Kanäle Festlandchina (Gesamtangebotspreis pro Rack) · Verfügbare Racks › |
| 2026-10-14 | Live im Marktplatz | Naher Osten (AED) | 22,92 Mio. AED – 55,01 Mio. AED | 46 Angebote (Gesamtrack-Asking-Preis) |
| 2026-10-14 | Live im Marktplatz | Europa (EUR) | 4,67 Mio. € – 10,96 Mio. € | 45 Angebote (Gesamtrack-Asking-Preis) |
| 2026-10-14 | Live im Marktplatz | Singapur (SGD) | 9,43 Mio. S$ – 22,97 Mio. S$ | 45 Angebote (Gesamtrack-Asking-Preis) |
| 2026-10-14 | Live im Marktplatz | Japan (JPY) | JPY 1.053,99 Mio. – 2.468,80 Mio. | 35 Angebote (Gesamtrack-Asking-Preis) |
| 2025-12 | Kanalreferenz | Global | Vorgänger GB200 NVL72 ca. 3 Mio. $ / Rack | Öffentlich berichtete Angaben[9] · GB300 hat keinen offiziellen Listenpreis · Verfügbare Racks › |
| 2026-10-14 | Politikbasis | Festlandchina | Nicht auf der China-Freigabeliste | Der GB300 unterliegt den US-Exportkontrollen; der Spot-Markt läuft überwiegend über Auslands- und Freihandelszonen-Kanäle (öffentlich berichtete Angaben, keine Rechtsberatung) |
Methodik:Preisband für Spotkanäle auf dem chinesischen Festland—— Bis 2025-08 geschätztes Band auf Basis des Launch-Referenzpreises (Übersee-Kanal-Referenz: $3,4 Mio./Rack-Ebene, umgerechnet ≈¥24,5–27 Mio.; NVIDIA hat keinen offiziellen Preis genannt; Bandbreite = Kanal-/Konfigurationsschwankung), ab 2026-10 Erkenntnisstand der Spotkanäle auf dem chinesischen Festland (¥110–130 Mio./Rack); die Übersee-Kanal-Referenz ($3,4-Mio.-Ebene) und der Festland-Spotmarkt sind zwei parallele Märkte und werden nicht gegeneinander umgerechnet. Nordamerika/Europa/Singapur/Japan/Naher Osten werden als tagesaktuelle Marktschnappschüsse fortlaufend erfasst (USD 3,444–4,229 Mio. · 25 Standorte u. a., ab 2026-10-08, jeweils in Originalwährung, ohne Umrechnung). Der GB300 ist nicht auf der Genehmigungsliste für China; Festlandpreise sind im Kontext von Übersee- und Freihandelszonen-Kanälen zu verstehen (öffentliche Berichterstattung, keine Rechtsberatung). Preisdatenquelle dieser Datenbank: AIXX Börse (provisionsfreie Vermittlung, keine Transaktionsteilnahme; keine Kenntnis und keine Spekulation über Abschlusspreise – daher neutrale Daten). Der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers.
Preis-MeilensteineMILESTONES
Häufige FragenFAQ
Ein von NVIDIA auf der GTC im März 2025 vorgestellter Blackwell Ultra Supernode-Rack: 72 Blackwell Ultra GPUs plus 36 Grace CPUs in einem vollständig flüssigkeitsgekühlten Rack, vollständig über NVLink5 mit insgesamt 130 TB/s vernetzt – für die Software erscheint es als ein einziger Beschleuniger. FP4 Tensor Core offiziell mit 1.440 PFLOPS (dense), GPU-Gesamtspeicher 20 TB HBM3e.
Es kommt auf Rechenzentrum und Skalierung an: Das NVL72 benötigt 132-kW-Stromversorgung, CDU-Flüssigkeitskühlung und bauliche Anpassungen der Tragfähigkeit, bietet dafür 20 TB Speicher in einer NVLink-Domäne – die Form für großes Training und Inferenz-Fabriken. Das NVL8 hat 288 GB pro Karte und 2,3 TB pro Gerät und lässt sich schrittweise in bestehenden Rechenzentren ausrollen. Mit Budget für den Umbau: NVL72; ohne: mit NVL8 starten (beide Formate sind in dieser Datenbank im Angebot, siehe Preisband).
Der GB300 unterliegt den US-Exportkontrollen und ist nicht auf der Genehmigungsliste für China (Stand 2026-10, öffentliche Berichterstattung; die H200 erhielt im Juli 2026 die Genehmigung für Mengenlieferungen nach China); der Spotmarkt läuft überwiegend über Übersee- und Freihandelszonen-Kanäle. Diese Angabe beruht auf öffentlicher Berichterstattung und ist keine Rechtsberatung; vor einer Beschaffung gelten die Vorgaben der zuständigen Behörden und eine professionelle Compliance-Einschätzung.
Die offizielle NVIDIA-Seite nennt 20 TB HBM3e (288 GB/Karte × 72 = 20,7 TB, plausibel; der Red-Hat-Zertifizierungskatalog nennt denselben Wert). In frühen Kanalunterlagen findet sich die 18-TB-Angabe (teilweise noch in Konfigurationsstrings dieser Datenbank). Maßgeblich sind die offiziellen 20 TB; bei Anfrage und Vertrag darauf achten, bei der Abnahme zählt der gemessene Wert des Tray-Firmware-Reports.
Nein – auf Rack-Ebene gilt ein eigenes Abnahmeschema: Power-on-Selbsttest (18+9 Trays einzeln als erkannt melden), Kalibrierung der Flüssigkeitskühlung (CDU-Durchfluss/Temperaturdifferenz/Leckageerkennung ohne Alarm), Gesamtleistungsaufnahme (Volllast im 132–142-kW-Bereich abgleichen), NCCL-Gesamtsystemtest (72 GPUs, all_reduce gegen die NVLink5-Nennwerte), RAS-Ereigniszähler (keine unkorrigierten ECC-Fehler und Interrupts). Die Seriennummer-Verifikation jedes einzelnen Trays ist die minimale Vertrauenseinheit bei der Rack-Abnahme (siehe „Wie abnehmen“).
Verwandte EinträgeSEE ALSO
Modellvergleich & AuswahlCOMPARE
QuellenREFERENCES
- NVIDIA-Website – GB300 NVL72 Produktseite (Spezifikationsreferenz, verifiziert 2026-10) https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- NVIDIA – Enterprise Reference Architecture NVL72 AI Factory: Systemkomponenten (Tray/Strom/Flüssigkeitskühlung, verifiziert 2026-10) https://docs.nvidia.com/enterprise-reference-architectures/n…
- NVIDIA Newsroom – NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning (Pressemitteilung 2025-03-18: 1,5×/H2 2025/16 Partner/CX-8 800G) https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Supermicro – SRS-GB300-NVL72 offizielle Seite (132 kW / CDU 250 kW / Maße) https://www.supermicro.com/en/products/rack/srs-gb300-nvl72
- Red Hat Zertifizierungskatalog – GB300 NVL72 (1,1 ExaFLOPS / 20,7 TB HBM3e, Partnerkatalog-Angaben) https://catalog.redhat.com/en/hardware/system/detail/307917
- NVIDIA offizieller Blog – Vera Rubin NVL72 MLPerf-Debüt, Qwen3-VL bis zu 3,7× gegenüber GB300 (2026-09-16) https://blogs.nvidia.com
- MLCommons – MLPerf Inference v6.1 Ergebnisse (GB300 NVL72 Debüt, bis zu 2,5× bei MoE, 2026-09-17) https://mlcommons.org
- CoreWeave – GB300 NVL72 Cloud-Instanzen GA (Changelog 2025-08-19) und Q3-2025-Quartalsbericht „First to deploy“ https://docs.coreweave.com
- Forbes – GB200 NVL72 ca. $3 Mio. pro Rack (2025-12-23, Preisanker der Vorgängergeneration) https://www.forbes.com
- CNBC / USA – Exportkontrollen für China und neue BIS-Regelung 2026-01 (öffentliche Berichterstattung) https://www.cnbc.com
- Pegatron NVIDIA GB300 NVL72 and More at NVIDIA GTC 2025 (Fotoaufnahmen der Compute Trays) https://www.servethehome.com/pegatron-nvidia-gb300-nvl72-and…
- Supermicro NVIDIA B300 und AI Factory Rundgang (Supermicro-Fotos des GB300 NVL72 Racks) https://www.servethehome.com/checking-out-the-supermicro-nvi…
- Marktdatenband — AIXX Exchange (angebotene Preise und eingeholte Kanalbereiche dieser Plattform, täglich aktualisiert) /hall.html