SECTIONS
EDITIONS
NETWORK
Ficha técnica SPEC CARD
NVIDIA L4
Placa de inferência de baixo consumo, principal opção na categoria B, com grande disponibilidade de estoque no mercado doméstico chinês
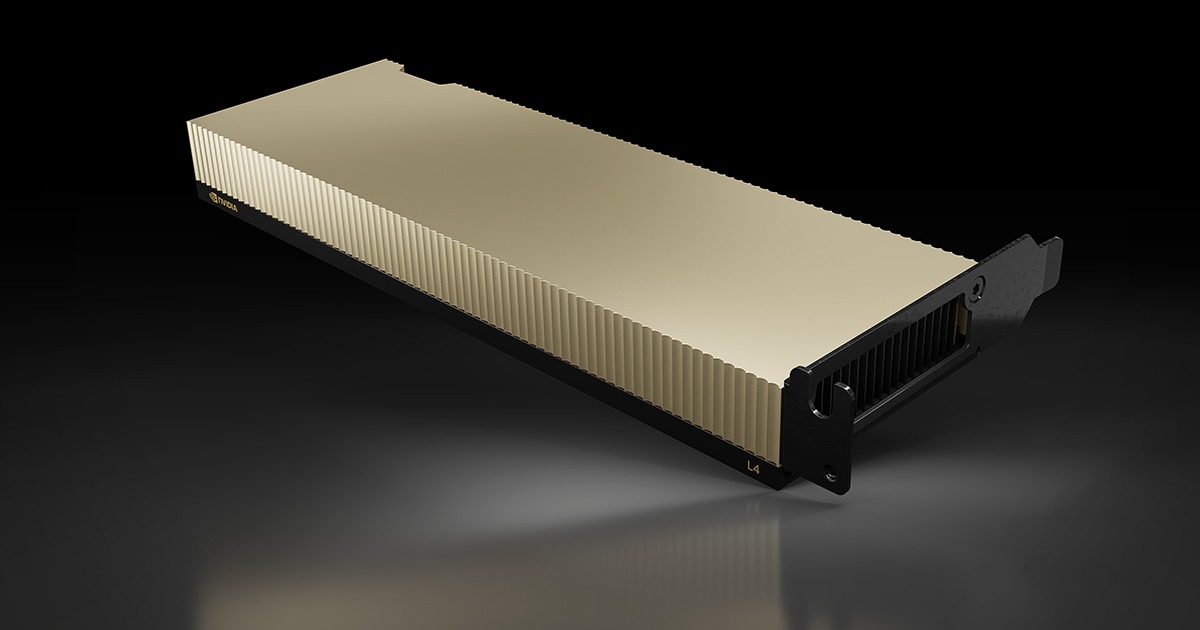
Imagem oficial do fabricante NVIDIA
Foto real
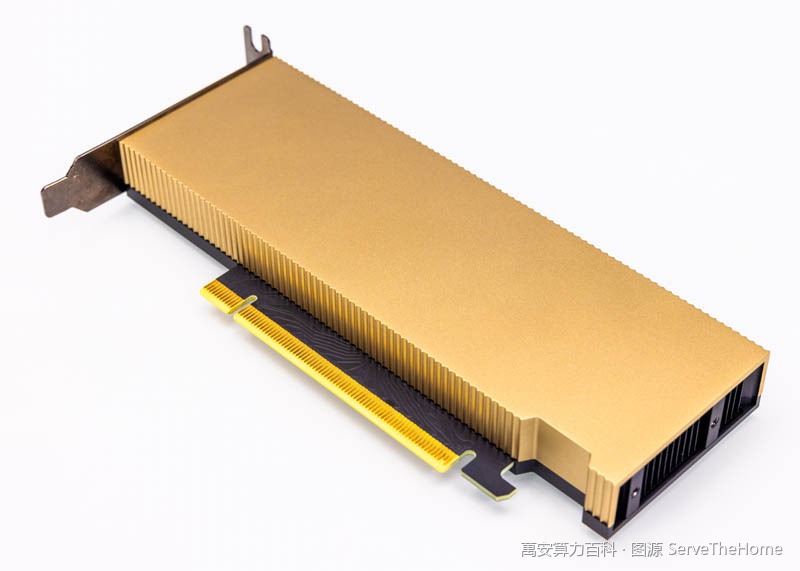
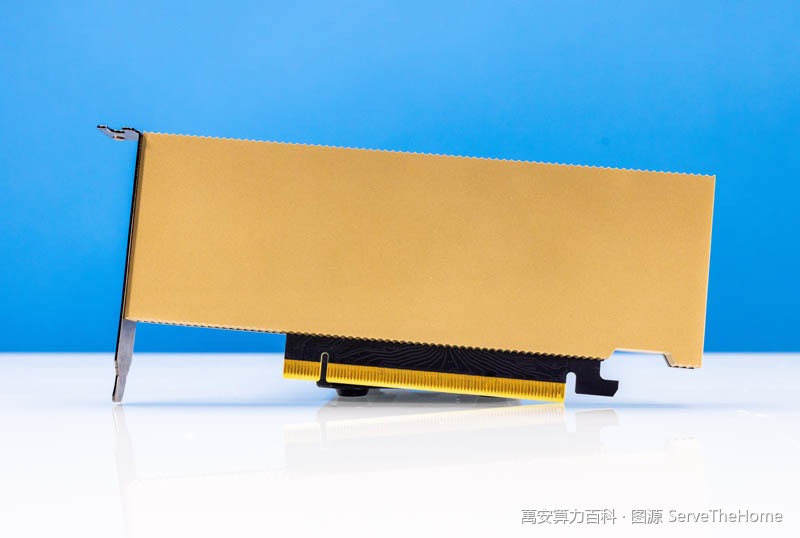
Fotografia real
Visão geral
NVIDIA L4 é uma GPU de data center de baixo consumo voltada a cenários de inferência, baseada no chip AD104 e no formato low-profile de slot único com interface PCIe. Conta com 24 GB de memória de vídeo, bandwidth de 300 GB/s, desempenho FP32 de 30,3 teraFLOPs e até 485 teraFLOPS em FP8 Tensor Core. Com um TDP de apenas 72 W, pode ser implantada em larga escala em servidores convencionais, sendo frequentemente usada em cargas de trabalho sensíveis à eficiência energética, como inferência de grandes modelos de linguagem e processamento de imagem e vídeo.
Especificações principais
| Memória | 24 GB GDDR6 |
| Largura de banda de memória | 300 GB/s |
| Desempenho FP32 | 30.3 teraFLOPS |
| Desempenho FP8 | 485 teraFLOPS |
| Consumo TDP | 72 W |
| Interconexão | PCIe Gen4 x16 |
| Forma | 1-slot low-profile |
| Codecs | NVENC 2 | NVDEC 4 | JPEG 4 |
Especificações verificadas com base em documentação oficial ( Benchmarks oficiais , atualizado em 2026-10-09) · O preço real está sujeito à cotação do vendedor
Cenários de uso
- Inferência de grandes modelos de linguagem: os 24 GB de memória permitem implantação multi-instância de modelos de porte médio, e os Tensor Core FP8/INT8 oferecem alto throughput de inferência com quantização
- Transcodificação de vídeo e processamento de imagem: integra 2 NVENC, 4 NVDEC e 4 decodificadores JPEG, ideal para video on demand, transcodificação de streaming e processamento em lote de imagens
- Implantação de alta densidade e baixo consumo: o TDP de 72 W e o formato low-profile de slot único permitem instalá-la em chasses de servidores convencionais com alimentação e refrigeração limitadas, aumentando a densidade de GPUs por máquina
- Sistemas recomendados e APIs de inferência online: a interconexão PCIe Gen4 x16 (64 GB/s) atende às necessidades de troca de dados em cenários de inferência em servidor único, sendo adequada para construir backends de serviços online
Modelos da mesma família
| Modelo | Memória | Consumo |
|---|---|---|
| NVIDIA T4 Comparar | 16GB GDDR6 com ECC (ativado por padrão) | 70W (potência total da placa, padrão) |
| NVIDIA A100 Comparar | Duas versões: 40GB HBM2 / 80GB HBM2e (a de 80GB anunciada na SC20 em 16/11/2020), com ECC | SXM4 400W (igual para 40GB/80GB); versão PCIe: 40GB 250W / 80GB 300W |
| NVIDIA H20 Comparar | 96GB HBM3 (três fontes consistentes: Flopper/VipraTech/Tencent News) | 400W TDP (três fontes: tabela de especificações Flopper/VipraTech e Tencent News com 'TDP de 400W'; o texto da VipraTech mencionava 350W, valor contraditório descartado) |
| NVIDIA GB300 Comparar | 288GB HBM3e (por encapsulamento de GPU; 576GB no superchip; HGX a nível de placa com 2,1TB / rack com 20TB, coexistindo) | TGP de até 1400W |
| NVIDIA A30 Comparar | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Comparar | 24GB GDDR6X | 450W TGP (média de 315W em jogos, fonte recomendada de 850W) |
Vídeo explicativo VIDEO
Pontos de compra e inspeção
- A L4 tem formato low-profile de slot único PCIe e TDP de 72 W, normalmente dispensando módulos de refrigeração dedicados ou adaptações de alimentação de alta potência, mas ainda é preciso verificar a compatibilidade do chassi do servidor com placas low-profile, além do layout físico dos slots PCIe e do fluxo de ar
- A placa usa interconexão PCIe Gen4 x16 em vez de NVLink e não oferece conectividade direta de alta largura de banda entre múltiplas placas; antes da compra, confirme se a aplicação depende de treinamento multi-GPU interconectado; se o foco for inferência, o impacto é limitado
- Atente para a bandwidth de memória de 300 GB/s, inferior à das placas de data center topo de linha da mesma geração. Ao implantar modelos grandes sensíveis à bandwidth de memória, avalie o throughput por placa considerando o tamanho do modelo e o nível de concorrência, evitando estimar o desempenho real de inferência por extrapolação linear do desempenho FP32
Perguntas frequentes
Quais grandes modelos a NVIDIA L4 consegue rodar para inferência?
A L4 vem com 24 GB de memória, capazes de acomodar integralmente a maioria dos modelos de alguns bilhões de parâmetros, ou modelos maiores por meio de quantização (como FP8/INT8). Para modelos muito grandes, geralmente é necessário recorrer ao paralelismo de tensores distribuído em várias placas, mas a L4 usa interconexão PCIe Gen4 x16 (64 GB/s), cuja bandwidth de comunicação multi-GPU é inferior à de soluções com NVLink, exigindo avaliação da latência real de inferência.
Com apenas 72 W, o desempenho da L4 não fica aquém do necessário?
O TDP de 72 W indica que ela é posicionada como placa de inferência com prioridade em eficiência energética, e não de treinamento. Seu desempenho chega a 485 teraFLOPS em FP8 Tensor Core e 485 TOPs em INT8, e o baixo consumo permite implantação de alta densidade em servidores convencionais. É adequada para inferência e processamento de vídeo, mas não recomendada para treinamento em larga escala.
A L4 pode ser instalada em servidores comuns 1U/2U?
Sim. A L4 adota design low-profile de slot único (1-slot), alimentada e comunicada pela interface PCIe, sem necessidade de cabos de energia externos, com requisitos reduzidos de compatibilidade de chassi. Na implantação, atenção principalmente ao fluxo de ar do slot e se a placa-mãe oferece slot PCIe Gen4 x16 para saturar os 64 GB/s de bandwidth da interface.
Leitura recomendada:L4 Ficha em profundidade · Ficha em profundidadeNVIDIA A10 · Ficha em profundidadeNVIDIA A100 · Ficha em profundidade
Dados atualizados em 2026-10-09 · Ir para a Ficha em profundidade Política editorial fluxo
Resumo da constituição editorial
Toda afirmação com fonteDefeitos sempre mencionados · erratas públicas e registradasEntradas pagas não são aceitasZero elementos de direcionamento e vendas nas entradasDados de mercado apenas como módulo de dados anexadoFonte dos dados de mercado: AIXX Exchange de Cálculo · © 2026 AIXX Pedia · Produzido pela AIXX