SECTIONS
EDITIONS
NETWORK
스펙 카드 SPEC CARD
NVIDIA L4
추론 쪽 주력 저전력 카드, 국내 현물 유통량이 많은 B등급 롱테일 대표 모델
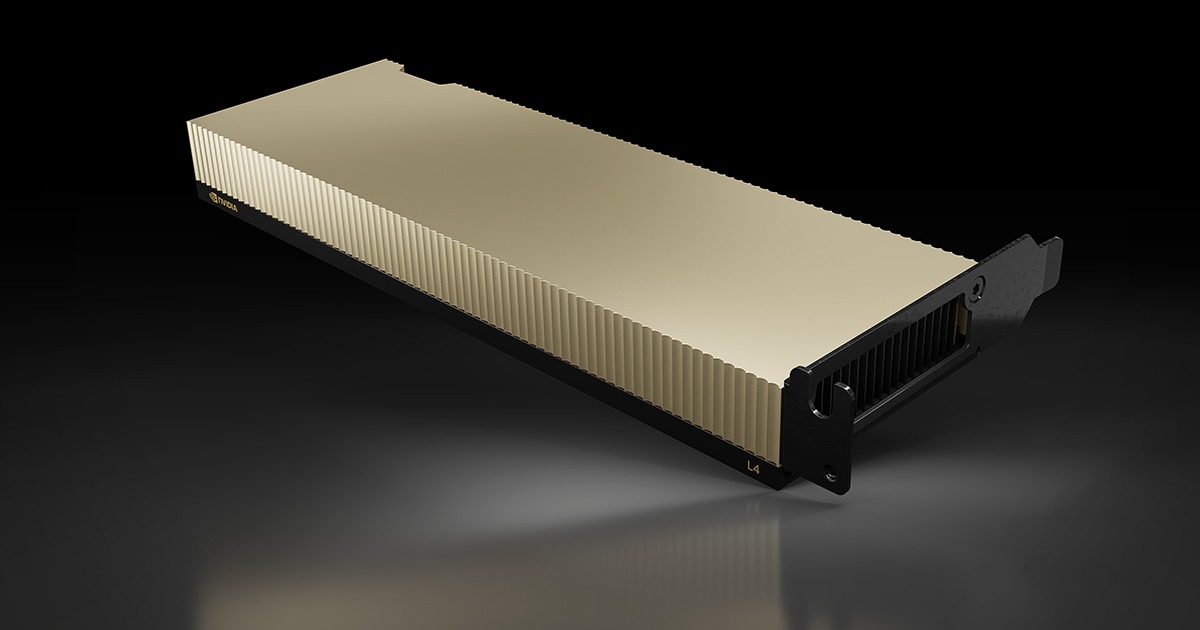
NVIDIA 공식 제조사 이미지
실물 촬영
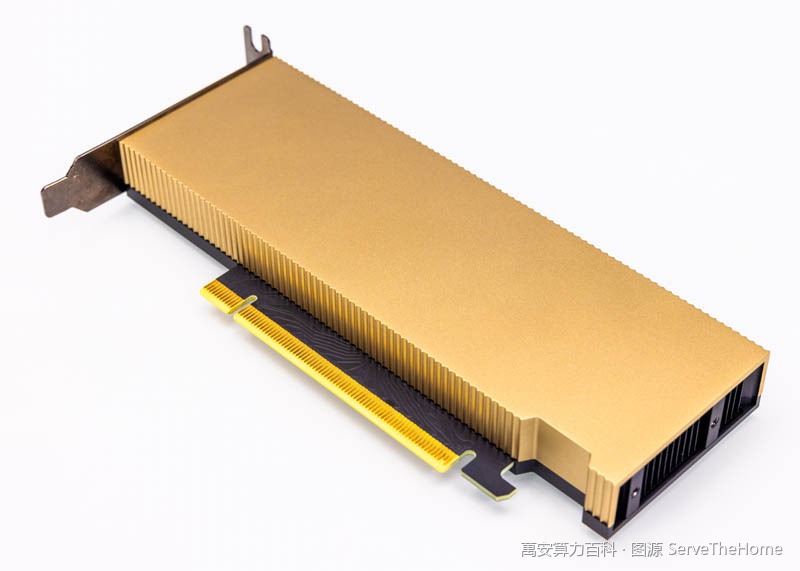
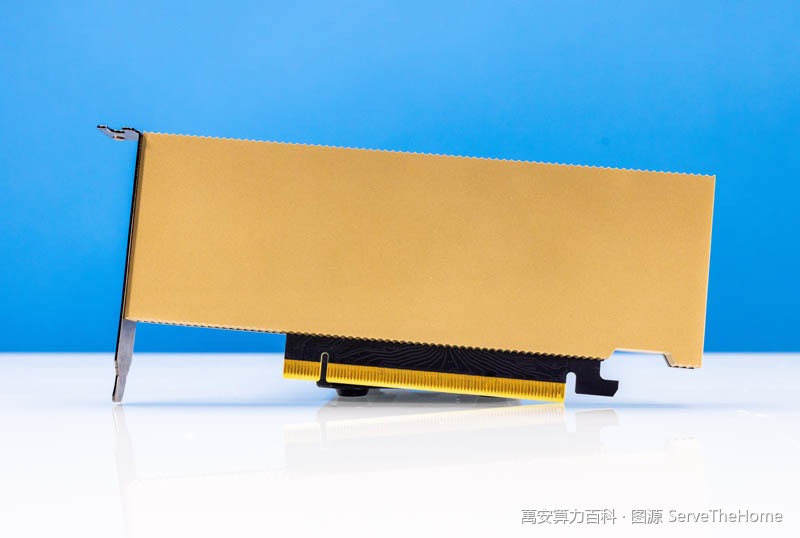
실물 촬영 이미지
개요
NVIDIA L4는 추론 시나리오를 겨냥한 저전력 데이터센터 GPU로, AD104 칩 기반이며 PCIe 인터페이스의 싱글 슬롯 로우프로파일(low-profile) 폼팩터를 채택했습니다. 24GB 메모리를 탑재하고 메모리 대역폭은 300GB/s, FP32 연산 성능은 30.3 teraFLOPs, FP8 Tensor Core 성능은 최대 485 teraFLOPS에 도달합니다. TDP는 72W에 불과해 일반 서버 환경에서 대규모 배치가 가능하며, 대규모 언어 모델 추론, 이미지 및 영상 처리 등 전력 효율에 민감한 워크로드에 널리 사용됩니다.
핵심 스펙
| 메모리 | 24 GB GDDR6 |
| 메모리 대역폭 | 300 GB/s |
| FP32 연산 성능 | 30.3 teraFLOPS |
| FP8 연산 성능 | 485 teraFLOPS |
| 전력 소모 TDP | 72 W |
| 인터커넥트 | PCIe Gen4 x16 |
| 폼팩터 | 1-slot low-profile |
| 코덱 | NVENC 2 | NVDEC 4 | JPEG 4 |
스펙은 공식 자료 기준으로 검증되었습니다(공식 벤치마크,2026-10-09 업데이트)· 실제 가격은 판매자 제시가 기준
적용 시나리오
- 대규모 언어 모델 추론 서비스: 24GB 메모리로 중형 규모 모델의 멀티 인스턴스 배포가 가능하며, FP8/INT8 Tensor Core가 높은 양자화 추론 처리량을 제공
- 영상 트랜스코딩 및 이미지 처리: NVENC 2개, NVDEC 4개, JPEG 디코더 4개 내장으로 VOD, 라이브 트랜스코딩, 이미지 배치 처리에 적합
- 저전력 고밀도 배포: 72W TDP와 싱글 슬롯 로우프로파일 폼팩터 덕분에 전력과 냉각이 제한적인 범용 서버 섀시에 배치하기 적합하며, 서버당 GPU 밀도를 높일 수 있음
- 추천 시스템 및 온라인 추론 API: PCIe Gen4 x16 인터커넥트(64GB/s)가 단일 서버 추론 시나리오의 데이터 교환 수요를 충족하며, 온라인 서비스 백엔드 구축에 적합
동일 계열 모델
| 모델 | 메모리 | 소비 전력 |
|---|---|---|
| NVIDIA T4 비교 | 16GB GDDR6 with ECC (기본 활성화) | 70W (보드 전체 전력, 기본값) |
| NVIDIA A100 비교 | 40GB HBM2 / 80GB HBM2e 듀얼 버전(80GB 버전은 2020-11-16 SC20에서 추가 공개), ECC 탑재 | SXM4 400W(40GB/80GB 공통); PCIe 버전 40GB 250W / 80GB 300W |
| NVIDIA H20 비교 | 96GB HBM3(Flopper/VipraTech/텐센트 뉴스 3개 소스 일치) | 400W TDP(Flopper/VipraTech 사양표/텐센트 뉴스 '열설계전력 400W' 3개 소스; VipraTech 본문의 350W 상충 수치는 기각) |
| NVIDIA GB300 비교 | 288GB HBM3e(단일 GPU 패키지 기준; 슈퍼칩 576GB; HGX 보드 레벨 2.1TB/랙 20TB 병기) | TGP 최대 1400W |
| NVIDIA A30 비교 | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 비교 | 24GB GDDR6X | 450W TGP (평균 게이밍 315W, 권장 시스템 파워 850W) |
영상 해설 VIDEO
구매 및 검수 포인트
- L4는 PCIe 싱글 슬롯 로우프로파일 폼팩터에 TDP 72W로, 전용 냉각 모듈이나 고출력 전원 개조가 대개 필요 없지만, 서버 섀시의 로우프로파일 카드 호환성과 PCIe 슬롯의 물리적 배치 및 공기 흐름 설계는 확인이 필요함
- 이 카드는 NVLink가 아닌 PCIe Gen4 x16 인터커넥트를 사용해 멀티 GPU 고대역폭 직접 연결 기능이 없으므로, 구매 전 업무가 멀티 GPU 인터커넥트 학습에 의존하는지 확인해야 함. 추론 중심이라면 영향은 제한적임
- 메모리 대역폭이 300GB/s로 동세대 고급 데이터센터 카드보다 낮다는 점에 유의해야 함. 메모리 대역폭에 민감한 대형 모델 배포 시에는 모델 규모와 동시성을 고려해 카드당 처리량을 평가하고, FP32 연산 성능으로 실제 추론 성능을 선형적으로 추산하는 일을 피해야 함
자주 묻는 질문
NVIDIA L4는 어느 정도 규모의 대형 모델 추론이 가능한가?
L4는 24GB 메모리를 탑재해 대부분의 수십억 파라미터급 모델을 온전히 수용할 수 있으며, 양자화(예: FP8/INT8)를 통해 더 큰 파라미터 수의 모델도 처리할 수 있습니다. 초대형 모델의 경우 일반적으로 텐서 병렬화로 여러 장에 분할해야 하지만, L4는 PCIe Gen4 x16 인터커넥트(64GB/s)를 사용해 멀티 GPU 협업 시 통신 대역폭이 NVLink 방식보다 낮으므로 실제 추론 지연을 평가해야 합니다.
L4는 72W 소비전력뿐인데 성능이 부족하지 않을까?
72W의 TDP는 이 제품이 학습용이 아닌 전력 효율 우선의 추론 카드로 포지셔닝되어 있음을 의미합니다. FP8 Tensor Core 성능은 최대 485 teraFLOPS, INT8은 485 TOPs에 도달하며, 저전력 덕분에 범용 서버에서 고밀도 배포가 가능합니다. 추론 및 영상 처리 워크로드에 적합하지만 대규모 학습용으로는 부적합합니다.
L4를 일반 1U/2U 서버에 장착할 수 있는가?
가능합니다. L4는 1-slot 로우프로파일 설계로 PCIe 인터페이스로 전원과 통신을 모두 공급받아 별도 전원 케이블이 필요 없으며, 섀시 호환성 요구 수준이 낮습니다. 배포 시에는 해당 슬롯의 냉각 공기 흐름과, 64GB/s 인터페이스 대역폭을 온전히 활용하기 위해 메인보드가 PCIe Gen4 x16 슬롯을 제공하는지를 주로 확인하면 됩니다.
자료 업데이트 2026-10-09 · 심층 항목으로 이동 편집 방침 프로세스