SECTIONS
EDITIONS
NETWORK
スペックカード SPEC CARD
NVIDIA L4
推論向け主力の低消費電力カード。国内在庫の流通量が多く、B級カードのロングテール代表格
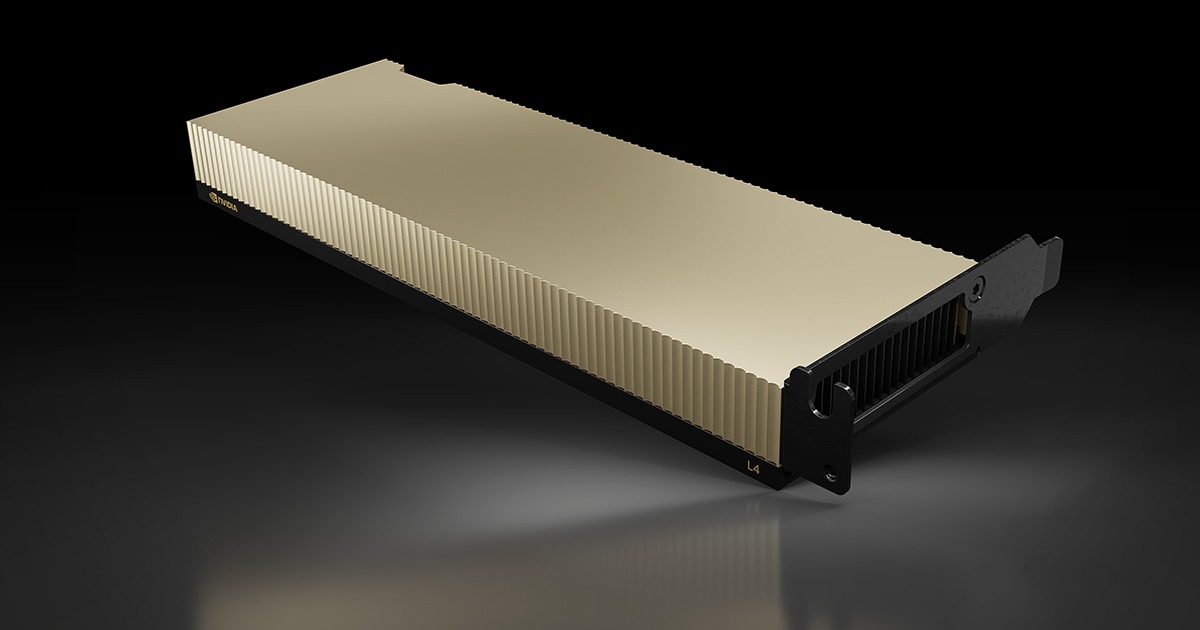
NVIDIA メーカー公式画像
実写
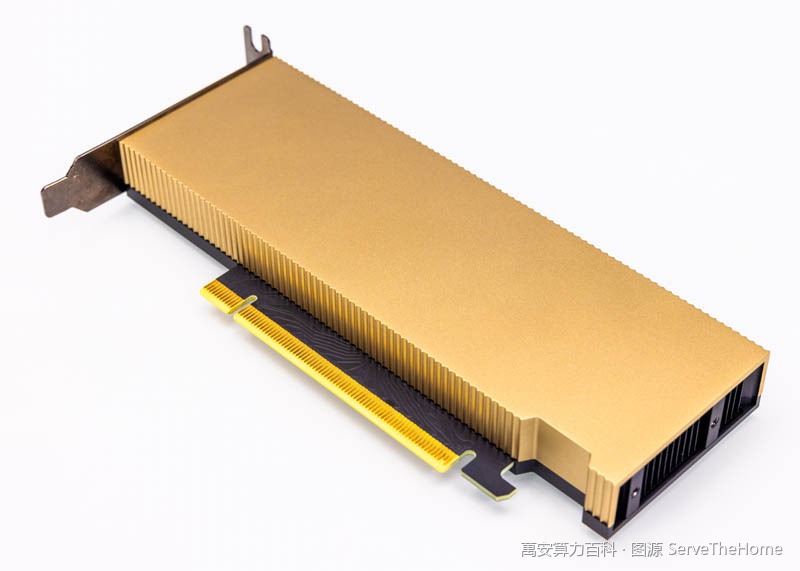
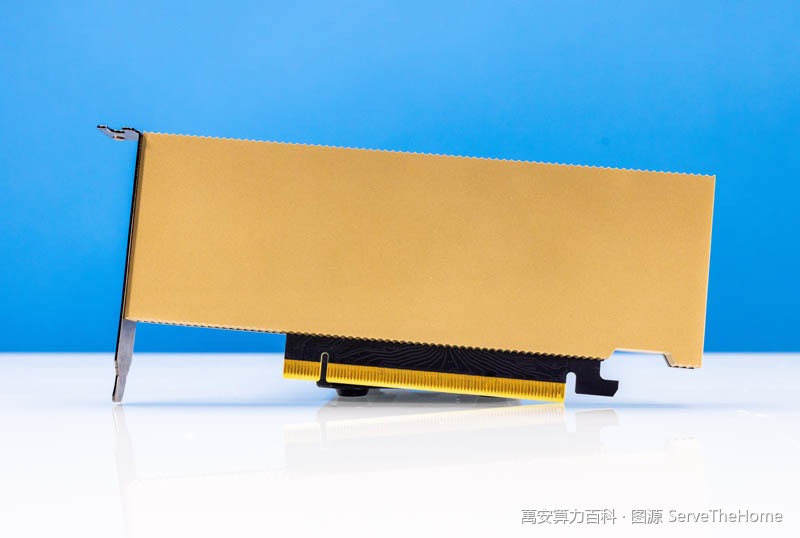
実写画像
概要
NVIDIA L4 は推論シーン向けの低消費電力データセンターGPUで、AD104 チップをベースに、PCIe インターフェースのシングルスロット・ロープロファイル(low-profile)フォームファクタを採用しています。24GB のメモリを搭載し、メモリ帯域は 300GB/s、FP32 演算性能は 30.3 teraFLOPs、FP8 Tensor Core の演算性能は最大 485 teraFLOPS に達します。TDP はわずか 72W で、一般的なサーバー環境に大規模に導入可能であり、大規模言語モデルの推論や画像・動画処理など、電力効率が重視されるワークロードでよく使われます。
主要スペック
| メモリ | 24 GB GDDR6 |
| メモリ帯域幅 | 300 GB/s |
| FP32演算性能 | 30.3 teraFLOPS |
| FP8演算性能 | 485 teraFLOPS |
| 消費電力 TDP | 72 W |
| インターコネクト | PCIe Gen4 x16 |
| フォームファクター | 1-slot low-profile |
| コーデック | NVENC 2 | NVDEC 4 | JPEG 4 |
スペックは公式資料に基づき検証済み(公式ベンチマーク、2026-10-09更新)· 実際の価格は出品者の提示価格によります
適用シーン
- 大規模言語モデル推論サービス:24GB のメモリで中規模モデルのマルチインスタンス運用が可能で、FP8/INT8 Tensor Core により高い量子化推論スループットを提供
- 動画トランスコードと画像処理:NVENC×2、NVDEC×4、JPEG デコーダー×4 を内蔵し、動画オンデマンド、ライブ配信のトランスコード、画像の一括処理に適する
- 低消費電力・高密度導入:72W TDP とシングルスロット・ロープロファイル形状により、電源や冷却に制約のある汎用サーバーシャーシへの搭載に適し、1台あたりのGPU密度を高められる
- 推薦システムとオンライン推論 API:PCIe Gen4 x16 接続(64GB/s)が単体サーバーでの推論におけるデータ交換需要を満たし、オンラインサービスのバックエンド構築に適する
同族モデル
| 型番 | メモリ | 消費電力 |
|---|---|---|
| NVIDIA T4 比較 | 16GB GDDR6 with ECC(デフォルト有効) | 70W(基板全体の消費電力、デフォルト) |
| NVIDIA A100 比較 | 40GB HBM2/80GB HBM2e の2バージョン(80GB版は2020-11-16 SC20で追加発表)、ECC搭載 | SXM4 400W(40GB/80GB共通);PCIe版は40GBが250W/80GBが300W |
| NVIDIA H20 比較 | 96GB HBM3(Flopper/VipraTech/騰訊ニュースの3ソースで一致) | TDP 400W(Flopper/VipraTechスペック表/騰訊ニュースの『熱設計電力400W』で3ソース一致;VipraTech本文には350Wという矛盾する記載があるため不採用) |
| NVIDIA GB300 比較 | 288GB HBM3e(1 GPUパッケージあたり;スーパーチップで576GB;HGX基板レベルで2.1TB/ラックで20TBという表記が併存) | TGP 最大 1400W |
| NVIDIA A30 比較 | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 比較 | 24GB GDDR6X | 450W TGP(平均ゲーム時315W、推奨システム電源850W) |
動画解説 VIDEO
調達・検品のポイント
- L4 は PCIe シングルスロット・ロープロファイル形状で TDP 72W であり、通常は専用放熱モジュールや高出力電源の改造を必要としませんが、サーバーシャーシの low-profile カード対応性、PCIe スロットの物理配置とエアフロー設計は確認が必要です
- 本カードは NVLink ではなく PCIe Gen4 x16 接続を採用しており、複数カード間の高帯域直接接続には対応しません。購入前にマルチGPU接続を前提とした学習処理が必要かどうかを確認すべきです。推論中心の用途であれば影響は限定的です
- メモリ帯域が 300GB/s と同世代のハイエンドデータセンターカードより低い点に注意。帯域に敏感な大規模モデルを運用する場合は、モデル規模と同時実行数を踏まえて1枚あたりのスループットを見極め、FP32 演算性能から実際の推論性能を単純に比例計算しないようにすること
よくある質問
NVIDIA L4 はどの程度の規模の大規模言語モデル推論に対応できますか?
L4 は 24GB のメモリを搭載しており、数十億パラメータ規模のモデルの多くを丸ごと収めるか、量子化(FP8/INT8 など)によってより大規模なモデルを運用できます。超巨大モデルの場合は通常、テンソル並列で複数カードに分割する必要がありますが、L4 は PCIe Gen4 x16 接続(64GB/s)であり、マルチカード連携の通信帯域は NVLink 方式より低いため、実際の推論レイテンシを評価する必要があります。
L4 は消費電力 72W しかないが、性能は十分ではないか?
72W の TDP は、本カードが学習用ではなく電力効率重視の推論用ポジションであることを意味します。FP8 Tensor Core の演算性能は最大 485 teraFLOPS、INT8 は 485 TOPs に達し、低消費電力ゆえに汎用サーバーへの高密度導入が可能です。推論や動画処理のワークロードには適しますが、大規模学習には不向きです。
L4 は一般的な 1U/2U サーバーに搭載できるか?
可能です。L4 は 1-slot low-profile のシングルスロット・ロープロファイル設計で、PCIe インターフェースから電力と通信をまかなうため外付け電源ケーブルが不要で、シャーシの互換性要件は低めです。導入時は主に、当該スロットの冷却エアフロー、および 64GB/s のインターフェース帯域を引き出すための PCIe Gen4 x16 スロットがマザーボードに備わっているかを確認する必要があります。
資料更新 2026-10-09 · 深掘り項目を見る 編集ポリシー 手順