SECTIONS
EDITIONS
NETWORK
Fiche technique SPEC CARD
NVIDIA L4
Carte basse consommation vedette de l'inférence, forte disponibilité sur le marché domestique, valeur sûre de l'occasion
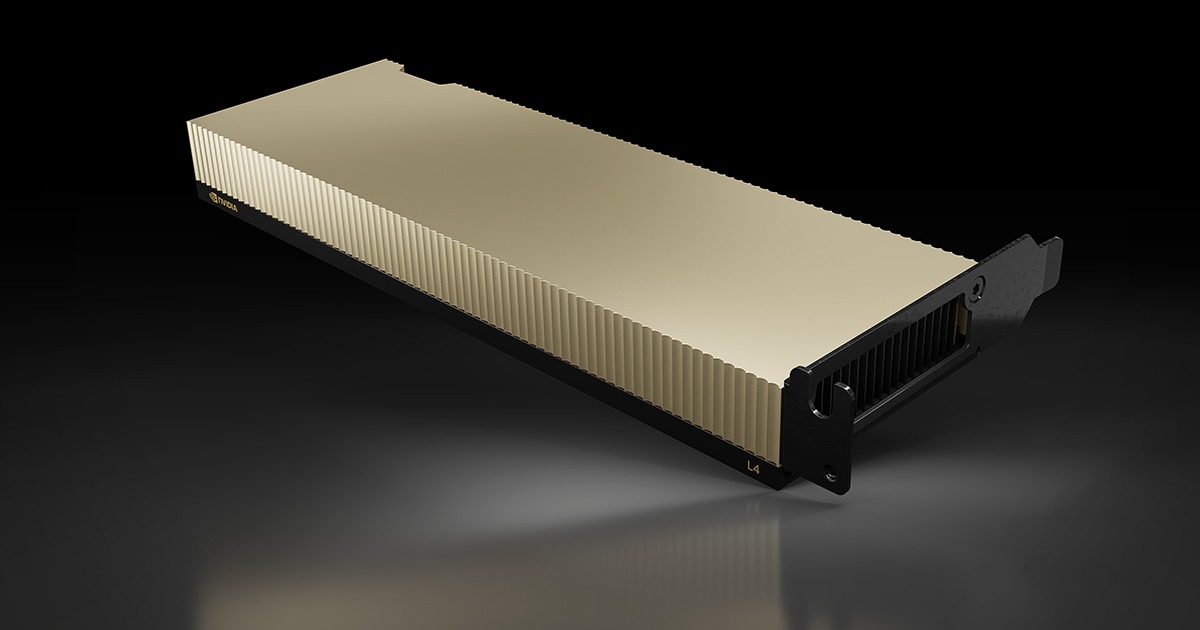
Image officielle du fabricant NVIDIA
Photo réelle
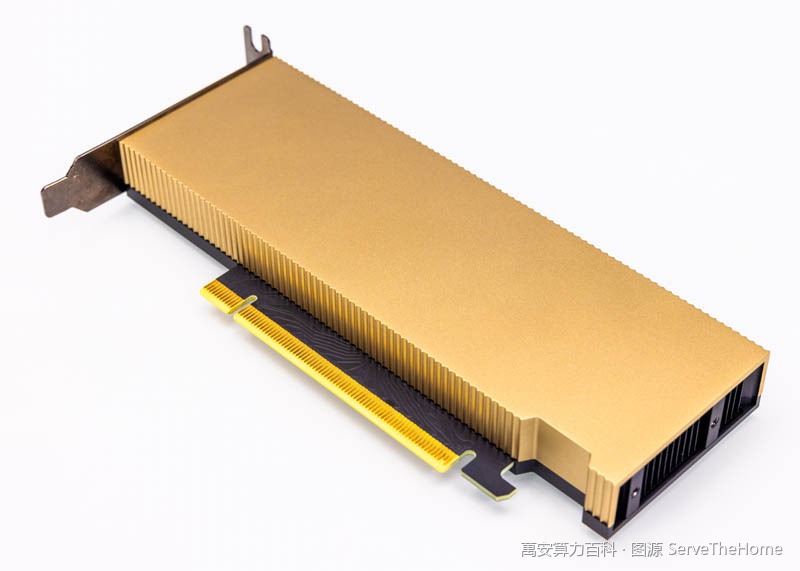
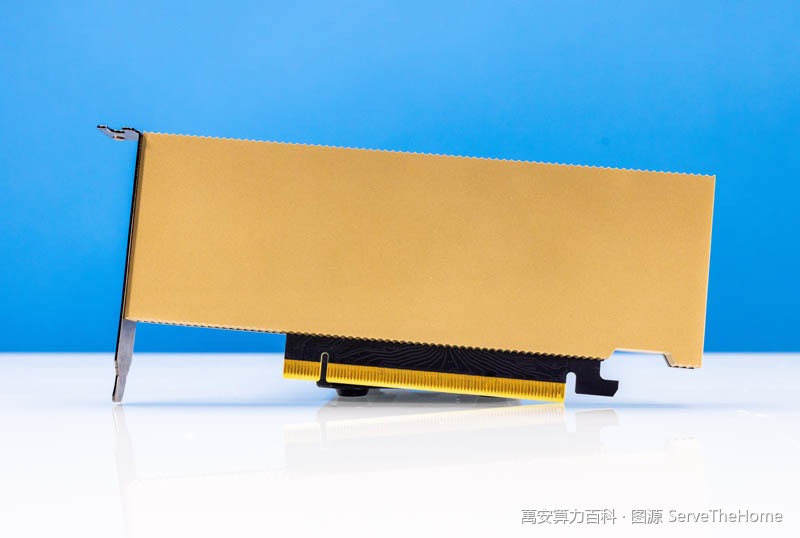
Photos réelles
Vue d'ensemble
NVIDIA L4 est un GPU datacenter basse consommation conçu pour les scénarios d'inférence, basé sur la puce AD104 et au format single-slot low-profile avec interface PCIe. Il embarque 24 Go de mémoire avec une bande passante de 300 Go/s, une puissance FP32 de 30,3 teraFLOPs et une puissance FP8 Tensor Core pouvant atteindre 485 teraFLOPS. Avec un TDP de seulement 72 W, il se déploie massivement dans des environnements serveurs classiques et convient aux charges sensibles à l'efficacité énergétique comme l'inférence de grands modèles de langage ou le traitement d'images et de vidéos.
Spécifications clés
| Mémoire vidéo | 24 GB GDDR6 |
| Bande passante mémoire | 300 GB/s |
| Puissance FP32 | 30.3 teraFLOPS |
| Puissance de calcul FP8 | 485 teraFLOPS |
| Consommation TDP | 72 W |
| Interconnexion | PCIe Gen4 x16 |
| Format | 1-slot low-profile |
| Codecs | NVENC 2 | NVDEC 4 | JPEG 4 |
Spécifications vérifiées contre les sources officielles ( benchmarks officiels , mise à jour le 2026-10-09) · Le prix réel est soumis au devis du vendeur
Cas d'usage
- Services d'inférence de grands modèles de langage : les 24 Go de mémoire permettent le déploiement multi-instances de modèles de taille moyenne, les Tensor Core FP8/INT8 offrant un débit d'inférence quantifiée élevé
- Transcodage vidéo et traitement d'images : 2 NVENC, 4 NVDEC et 4 décodeurs JPEG intégrés, adaptés à la vidéo à la demande, au transcodage de flux en direct et au traitement d'images par lots
- Déploiement haute densité basse consommation : le TDP de 72 W et le format single-slot low-profile s'adaptent aux châssis serveurs standards limités en alimentation et en refroidissement, augmentant la densité GPU par machine
- Systèmes de recommandation et API d'inférence en ligne : l'interconnexion PCIe Gen4 x16 (64 Go/s) couvre les besoins d'échange de données en inférence mono-serveur, idéal pour construire des backends de services en ligne
Modèles de la même famille
| Modèle | Mémoire vidéo | TDP |
|---|---|---|
| NVIDIA T4 Comparer | 16 Go GDDR6 avec ECC (activé par défaut) | 70 W (puissance totale de la carte, par défaut) |
| NVIDIA A100 Comparer | Double version 40 Go HBM2 / 80 Go HBM2e (version 80 Go annoncée le 2020-11-16 à SC20), avec ECC | SXM4 400 W (identique en 40 Go et 80 Go) ; version PCIe : 40 Go 250 W / 80 Go 300 W |
| NVIDIA H20 Comparer | 96 Go HBM3 (concordance Flopper/VipraTech/Tencent News) | 400 W TDP (Flopper/tableau VipraTech/'400 W TDP' Tencent News, triple concordance ; les 350 W mentionnés dans le corps du texte de VipraTech, contradictoires, ont été écartés) |
| NVIDIA GB300 Comparer | 288 Go HBM3e (par cœur GPU ; 576 Go pour la superpuce ; 2,1 To au niveau carte HGX / 20 To par baie, deux chiffres coexistant) | TGP jusqu'à 1400 W |
| NVIDIA A30 Comparer | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Comparer | 24GB GDDR6X | 450 W TGP (335 W en jeu en moyenne, alimentation système recommandée 850 W) |
Présentation vidéo VIDEO
Points d'achat et de vérification
- La L4 est au format single-slot low-profile PCIe avec un TDP de 72 W, ne nécessitant généralement ni module de refroidissement dédié ni adaptation de l'alimentation, mais il faut vérifier la compatibilité du châssis avec les cartes low-profile ainsi que la disposition physique des slots PCIe et la conception du flux d'air
- La carte utilise une interconnexion PCIe Gen4 x16 et non NVLink, sans capacité de liaison directe haut débit multi-GPU ; avant l'achat, vérifiez si votre activité dépend d'un entraînement multi-GPU ; pour l'inférence, l'impact reste limité
- Attention, sa bande passante mémoire de 300 Go/s est inférieure à celle des cartes datacenter haut de gamme de la même génération ; pour déployer de grands modèles sensibles à la bande passante mémoire, évaluez le débit par carte selon la taille du modèle et la concurrence d'accès, sans extrapoler les performances réelles d'inférence à partir de la puissance FP32
FAQ
Quelle taille de grands modèles la NVIDIA L4 peut-elle faire tourner en inférence ?
La L4 embarque 24 Go de mémoire, pouvant accueillir intégralement la plupart des modèles de quelques milliards de paramètres, ou des modèles plus grands via quantification (FP8/INT8). Pour les très grands modèles, un partitionnement en parallélisme de tenseurs sur plusieurs cartes est généralement nécessaire, mais l'interconnexion PCIe Gen4 x16 de la L4 (64 Go/s) offre une bande passante de communication inférieure au NVLink, ce qui impose d'évaluer la latence d'inférence réelle.
Avec seulement 72 W, les performances de la L4 sont-elles suffisantes ?
Un TDP de 72 W signifie qu'elle est positionnée comme une carte d'inférence privilégiant l'efficacité énergétique, non l'entraînement. Sa puissance FP8 Tensor Core atteint 485 teraFLOPS et 485 TOPs en INT8, permettant un déploiement haute densité dans des serveurs standards grâce à sa faible consommation. Elle convient à l'inférence et au traitement vidéo, mais pas à l'entraînement à grande échelle.
La L4 peut-elle s'installer dans un serveur 1U/2U standard ?
Oui. La L4 adopte une conception single-slot low-profile, alimentée et communiquant via le slot PCIe, sans câble d'alimentation externe, avec des exigences de compatibilité châssis limitées. Au déploiement, il faut surtout veiller au flux d'air du slot concerné et vérifier que la carte mère propose un slot PCIe Gen4 x16 pour exploiter pleinement les 64 Go/s de bande passante de l'interface.
Pour aller plus loin:L4 Fiche approfondie · Fiche approfondieNVIDIA A10 · Fiche approfondieNVIDIA A100 · Fiche approfondie
Données mises à jour le 2026-10-09 · Accéder à la Fiche approfondie Politique éditoriale Démarche
Cette base
Politique éditorialeÀ propos de cette base (déclaration d'intérêts)le canal de correctionsRésumé de la charte éditoriale
Chaque affirmation sourcéeLes défauts obligatoirement mentionnés · Corrections publiques tracéesAucune entrée sponsorisée acceptéeZéro élément de prospection ou de vente dans les entréesDonnées de marché intégrées uniquement comme module de donnéesSource des données de marché : AIXX Exchange · © 2026 AIXX Pedia · Une production AIXX