SECTIONS
EDITIONS
NETWORK
Ficha técnica SPEC CARD
NVIDIA L4
GPU de bajo consumo centrada en inferencia, gran disponibilidad de stock en China y representante destacada del segmento de tarjetas B
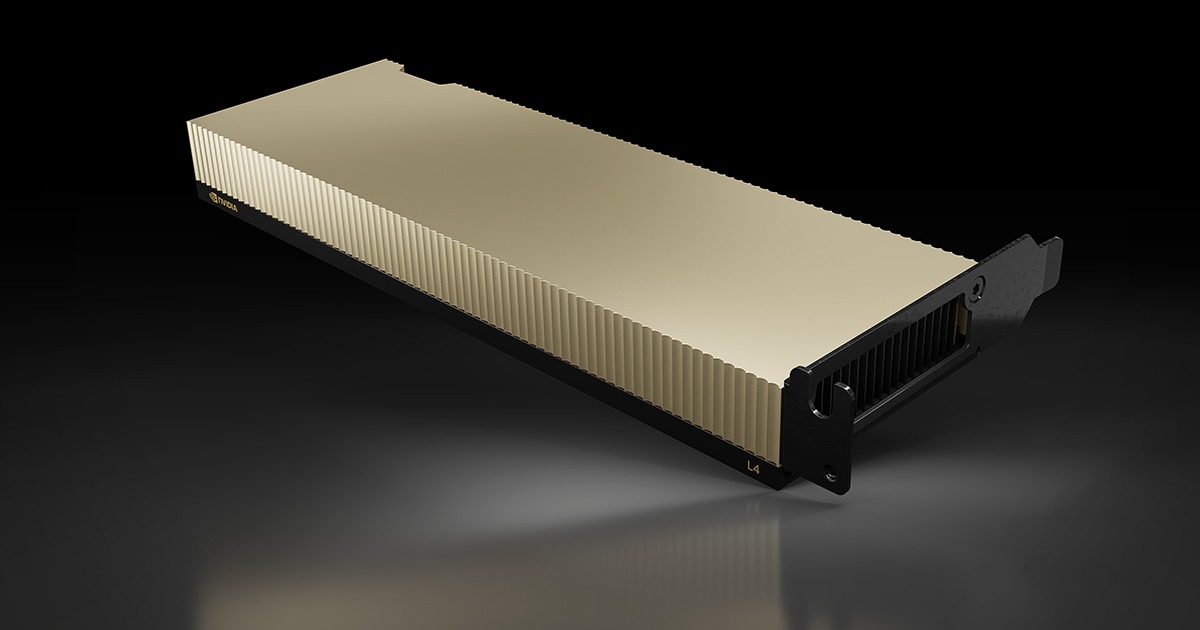
Imagen oficial del fabricante NVIDIA
Fotos reales
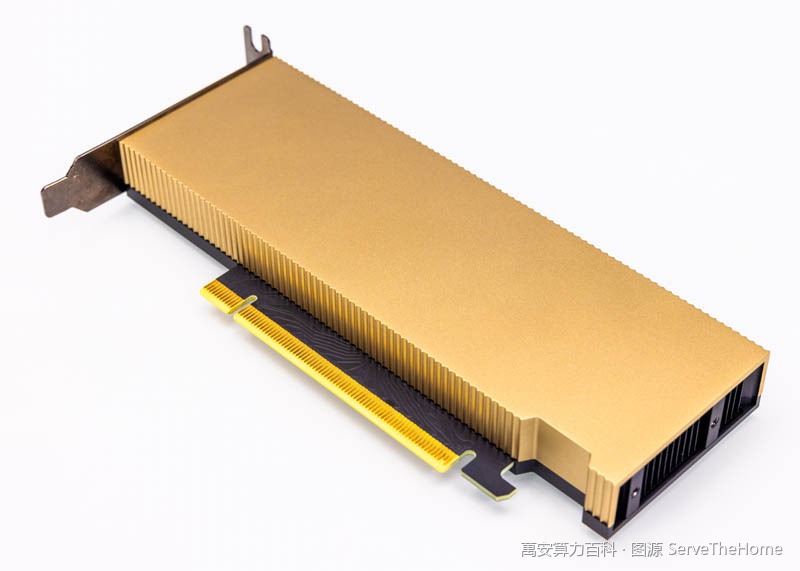
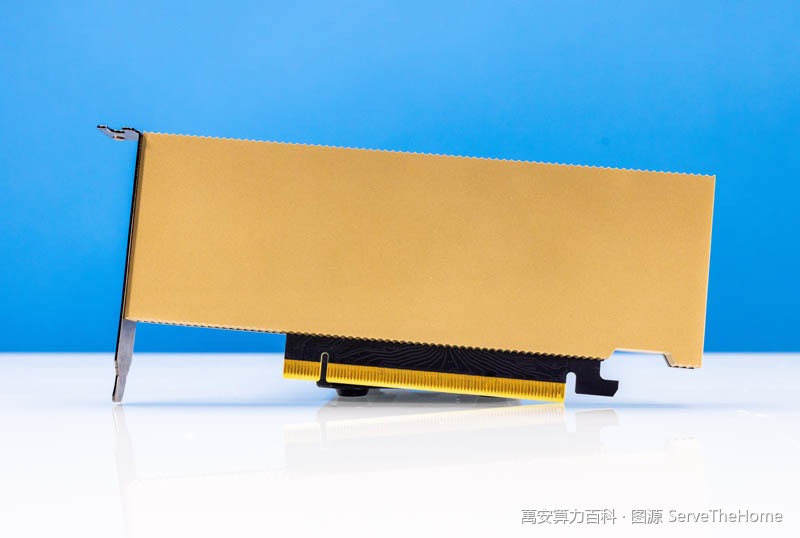
Imágenes reales
Resumen
NVIDIA L4 es una GPU de data center de bajo consumo orientada a la inferencia, basada en el chip AD104 y presentada en formato low-profile de una ranura con interfaz PCIe. Incorpora 24 GB de memoria con un ancho de banda de 300 GB/s, una potencia FP32 de 30.3 teraFLOPs y hasta 485 teraFLOPS en FP8 con Tensor Core. Su TDP es de solo 72 W, lo que permite despliegues a gran escala en servidores convencionales; se utiliza habitualmente en inferencia de grandes modelos de lenguaje y en procesamiento de imagen y vídeo, cargas de trabajo especialmente sensibles a la eficiencia energética.
Especificaciones clave
| Memoria | 24 GB GDDR6 |
| Ancho de banda de memoria | 300 GB/s |
| Rendimiento FP32 | 30.3 teraFLOPS |
| Rendimiento FP8 | 485 teraFLOPS |
| Consumo TDP | 72 W |
| Interconexión | PCIe Gen4 x16 |
| Formato | 1-slot low-profile |
| Códecs | NVENC 2 | NVDEC 4 | JPEG 4 |
Especificaciones verificadas con documentación oficial ( Benchmarks oficiales , actualizado el 2026-10-09) · El precio real está sujeto a la cotización del vendedor
Casos de uso
- Servicios de inferencia de grandes modelos de lenguaje: los 24 GB de memoria permiten despliegues multi-instancia de modelos de tamaño medio, con una alta productividad de inferencia cuantizada gracias a los Tensor Core FP8/INT8
- Transcodificación de vídeo y procesamiento de imagen: incluye 2 unidades NVENC, 4 NVDEC y 4 decodificadores JPEG, ideal para vídeo bajo demanda, transcodificación en directo y procesamiento por lotes de imágenes
- Despliegue de alta densidad y bajo consumo: su TDP de 72 W y su formato low-profile de una ranura son adecuados para chasis de servidor convencionales con alimentación y refrigeración limitadas, aumentando la densidad de GPU por máquina
- Sistemas recomendados e inferencia en línea vía API: el enlace PCIe Gen4 x16 (64 GB/s) cubre las necesidades de intercambio de datos en escenarios de inferencia en un solo nodo, siendo adecuado para backends de servicios en línea
Modelos de la misma familia
| Modelo | Memoria | Consumo |
|---|---|---|
| NVIDIA T4 Comparación | 16GB GDDR6 con ECC (activado por defecto) | 70W (potencia total de la placa, por defecto) |
| NVIDIA A100 Comparación | Doble versión: 40GB HBM2 / 80GB HBM2e (la de 80GB se presentó el 16-11-2020 en la SC20), con ECC | SXM4 400W (igual en 40GB/80GB); versión PCIe: 40GB 250W / 80GB 300W |
| NVIDIA H20 Comparación | 96GB HBM3 (coincidencia en tres fuentes: Flopper/VipraTech/Tencent News) | TDP de 400W (coincidencia en tres fuentes: Flopper/tabla de especificaciones de VipraTech/'TDP de 400W' en Tencent News; se descarta la cifra contradictoria de 350W en el texto de VipraTech) |
| NVIDIA GB300 Comparación | 288GB HBM3e (por paquete de GPU; 576GB en el superchip; coexisten 2,1TB a nivel de placa HGX y 20TB por rack) | TGP de hasta 1400W |
| NVIDIA A30 Comparación | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Comparación | 24GB GDDR6X | TGP de 450W (315W en juegos de media, fuente de alimentación recomendada de 850W) |
Vídeo explicativo VIDEO
Puntos clave de compra e inspección
- La L4 tiene formato low-profile de una ranura PCIe y un TDP de 72 W, por lo que normalmente no requiere módulos de refrigeración dedicados ni modificaciones de alimentación de alta potencia; aun así, conviene verificar la compatibilidad del chasis con tarjetas low-profile, así como la disposición física de las ranuras PCIe y el diseño del flujo de aire
- Esta tarjeta emplea un enlace PCIe Gen4 x16 en lugar de NVLink y carece de conexión directa de gran ancho de banda entre tarjetas; antes de adquirirla debe confirmarse si la carga de trabajo depende del entrenamiento multi-GPU. Si el uso principal es inferencia, el impacto es limitado
- Tenga en cuenta que su ancho de banda de memoria es de 300 GB/s, inferior al de las tarjetas de data center tope de gama de su generación. Al desplegar grandes modelos sensibles al ancho de banda, evalúe la productividad por tarjeta según el tamaño del modelo y la concurrencia, evitando extrapolar linealmente el rendimiento real de inferencia a partir de la potencia FP32
Preguntas frecuentes
¿Qué tamaño de modelo de lenguaje puede ejecutar la NVIDIA L4 en inferencia?
La L4 incorpora 24 GB de memoria, suficientes para alojar íntegramente la mayoría de modelos de varios miles de millones de parámetros, o modelos mayores mediante cuantización (como FP8/INT8). Para modelos de gran tamaño suele ser necesario recurrir al paralelismo de tensores repartido entre varias tarjetas, pero al usar PCIe Gen4 x16 (64 GB/s), el ancho de banda de comunicación multi-GPU es inferior al de las soluciones con NVLink, por lo que conviene evaluar la latencia real de inferencia.
Con solo 72 W de consumo, ¿rendirá lo suficiente la L4?
Un TDP de 72 W indica que se trata de una tarjeta de inferencia que prioriza la eficiencia energética, no de entrenamiento. Su potencia con Tensor Core alcanza los 485 teraFLOPS en FP8 y 485 TOPs en INT8, y su bajo consumo permite despliegues de alta densidad en servidores convencionales. Es adecuada para inferencia y procesamiento de vídeo, pero no recomendable para entrenamiento a gran escala.
¿Puede instalarse la L4 en un servidor 1U/2U estándar?
Sí. La L4 adopta un diseño low-profile de una ranura (1-slot) que se alimenta y comunica a través de PCIe, sin necesidad de cables de alimentación adicionales, con requisitos de compatibilidad de chasis reducidos. Al instalarla, hay que prestar atención principalmente a la refrigeración de la ranura y a que la placa base ofrezca una ranura PCIe Gen4 x16 para aprovechar los 64 GB/s del interfaz.
Lectura recomendada:L4 Ficha a fondo · Ficha a fondoNVIDIA A10 · Ficha a fondoNVIDIA A100 · Ficha a fondo
Datos actualizados el 2026-10-09 · ir a la Ficha a fondo Política editorial Ficha a fondo
Resumen de la constitución editorial
Cada afirmación con fuenteDefectos siempre indicados · correcciones públicas y trazablesNo se aceptan entradas pagadasCero elementos de captación o venta dentro de las entradasLos datos de cotización solo se montan como módulo de datosFuente de datos de cotización: AIXX Exchange · © 2026 AIXX Pedia · una producción de AIXX